人工智能驱动科学发现的进展与启示
从好奇到证据,再到可验证的行动
王赫
国际理论物理中心(亚太地区)
中国科学院大学
2026 莆田学院“北楼专家讲坛”学术讲座 2026年11月16日
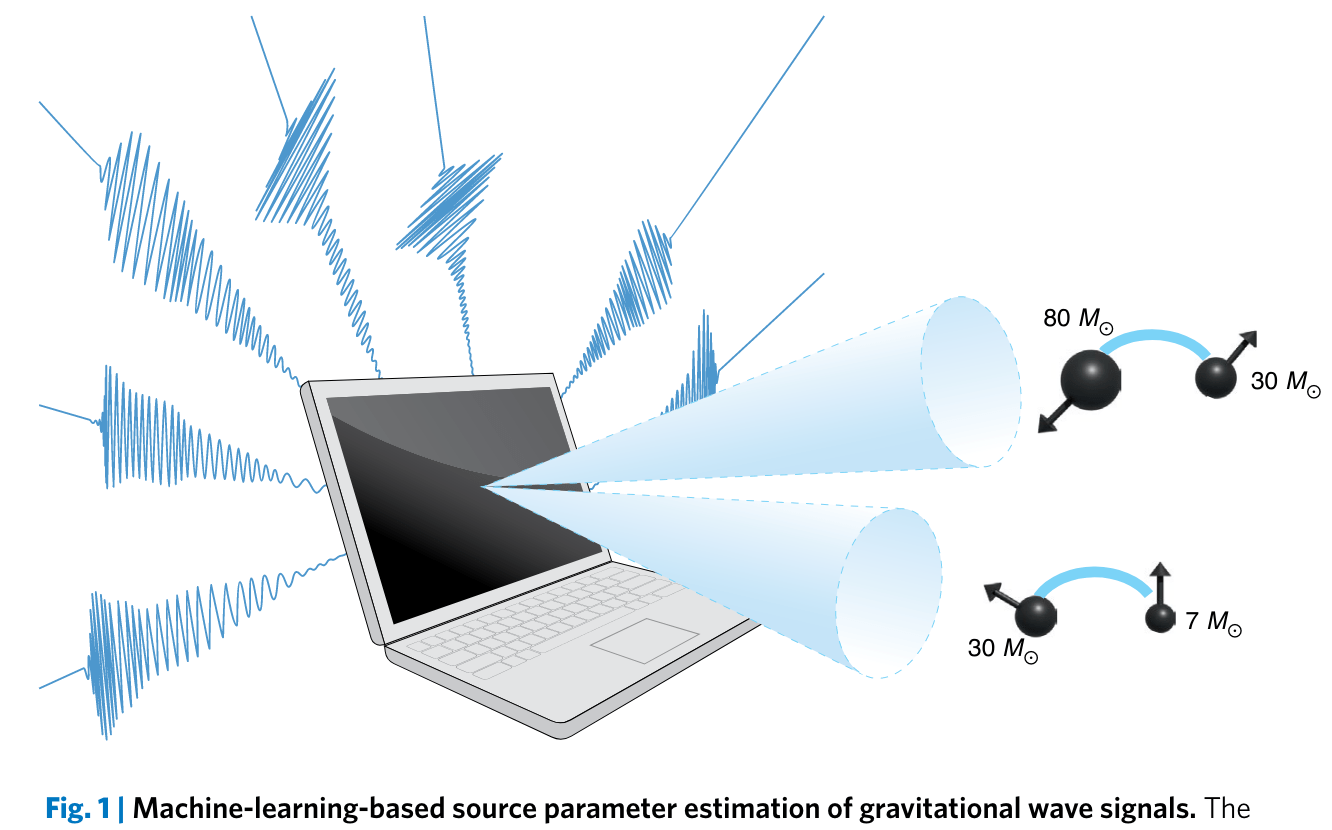
Smith R. Nature Physics (2022)
我们为什么想知道?又凭什么相信自己知道?
从一个关于宇宙的问题开始
宇宙里发生过什么,我们凭什么知道?
我们到不了那里,也不能把黑洞搬进实验室。那我们凭什么说,它们曾经发生过一次碰撞?
双黑洞并合模拟示意
引力波是时空的涟漪
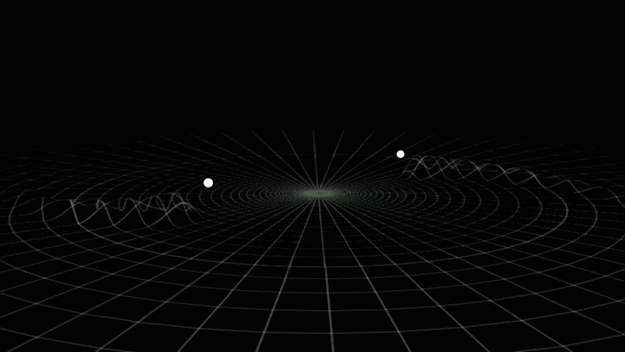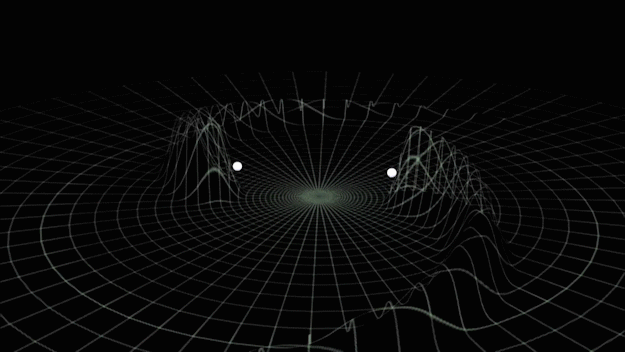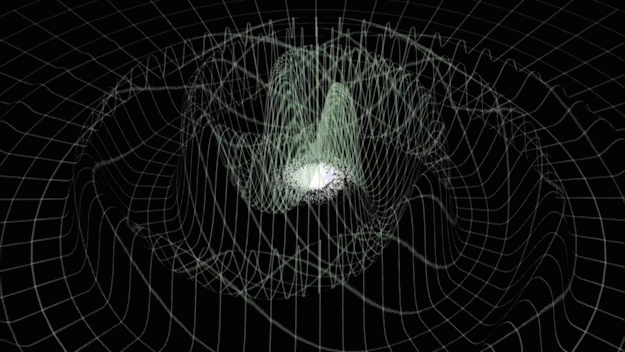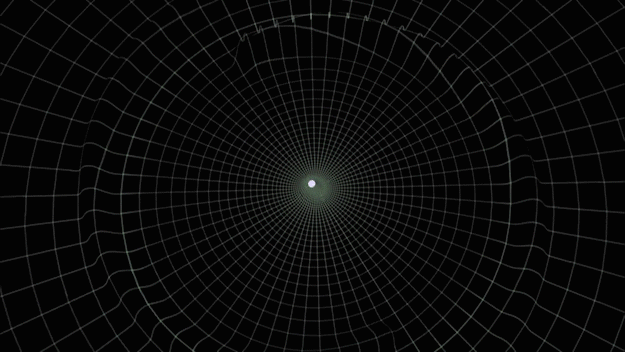
大物体的引力扭曲空间和时间,或称为“时空”。
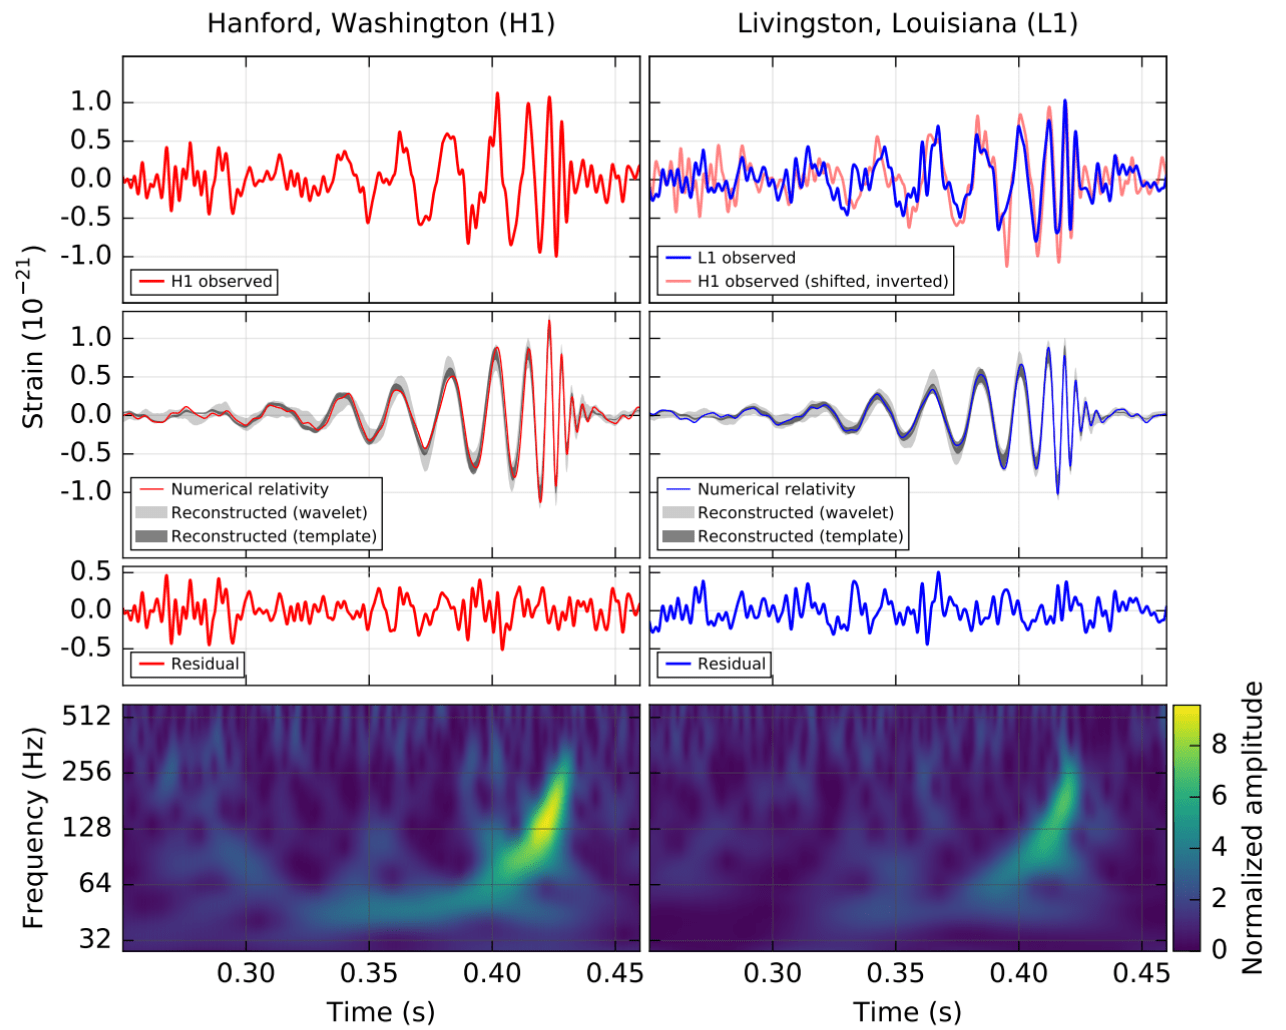
问题:宇宙中发生了什么?证据:我们实际测到了什么?
这是一段信号,还是一阵噪声?
只凭这张图,你愿意下结论吗?如果不愿意,你希望再看到哪一项检查?
05
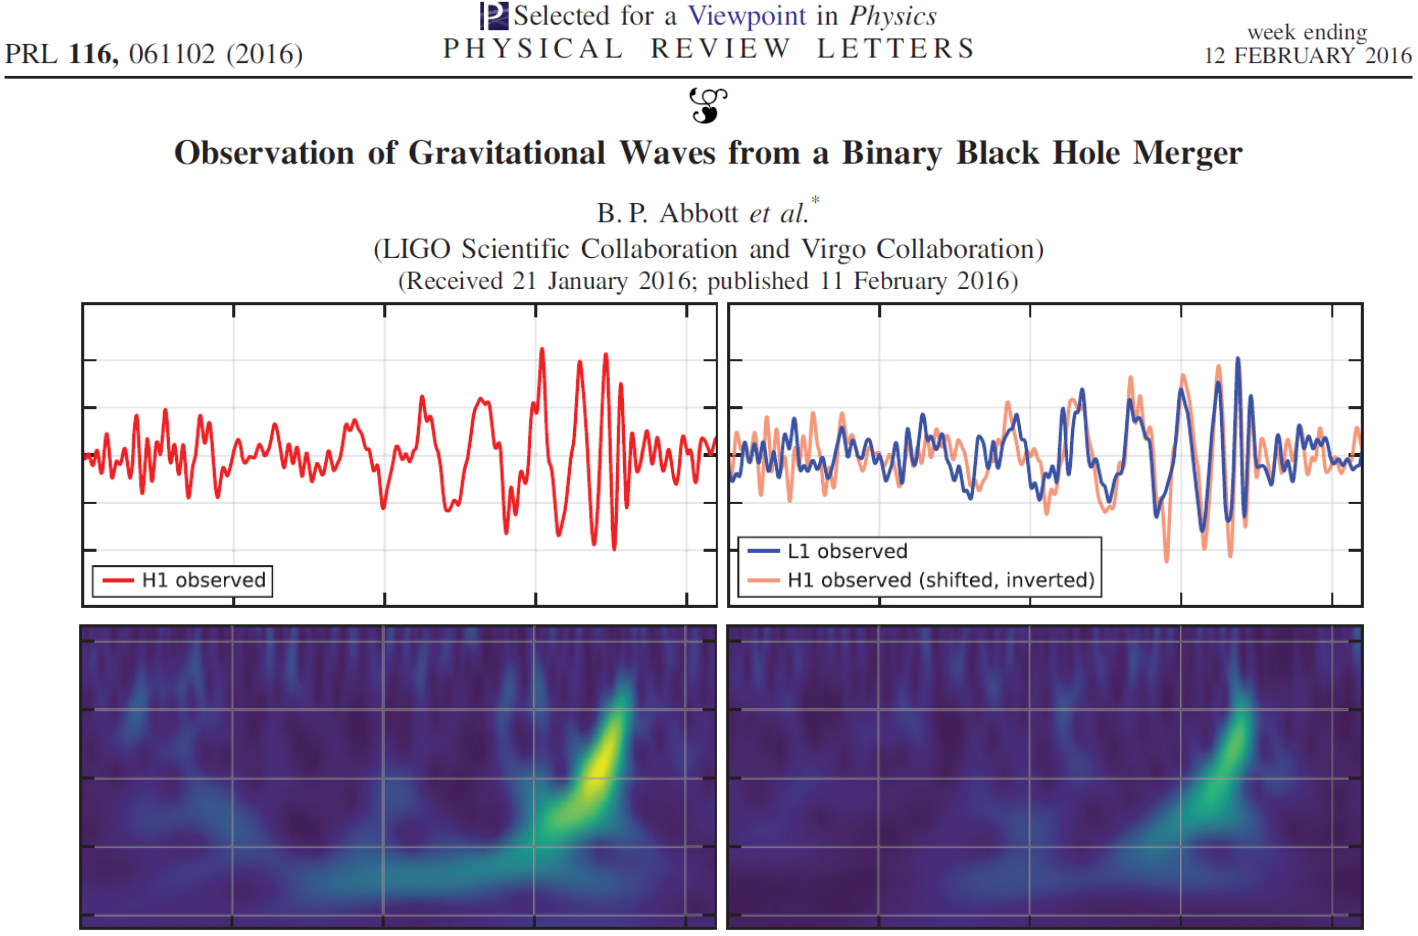
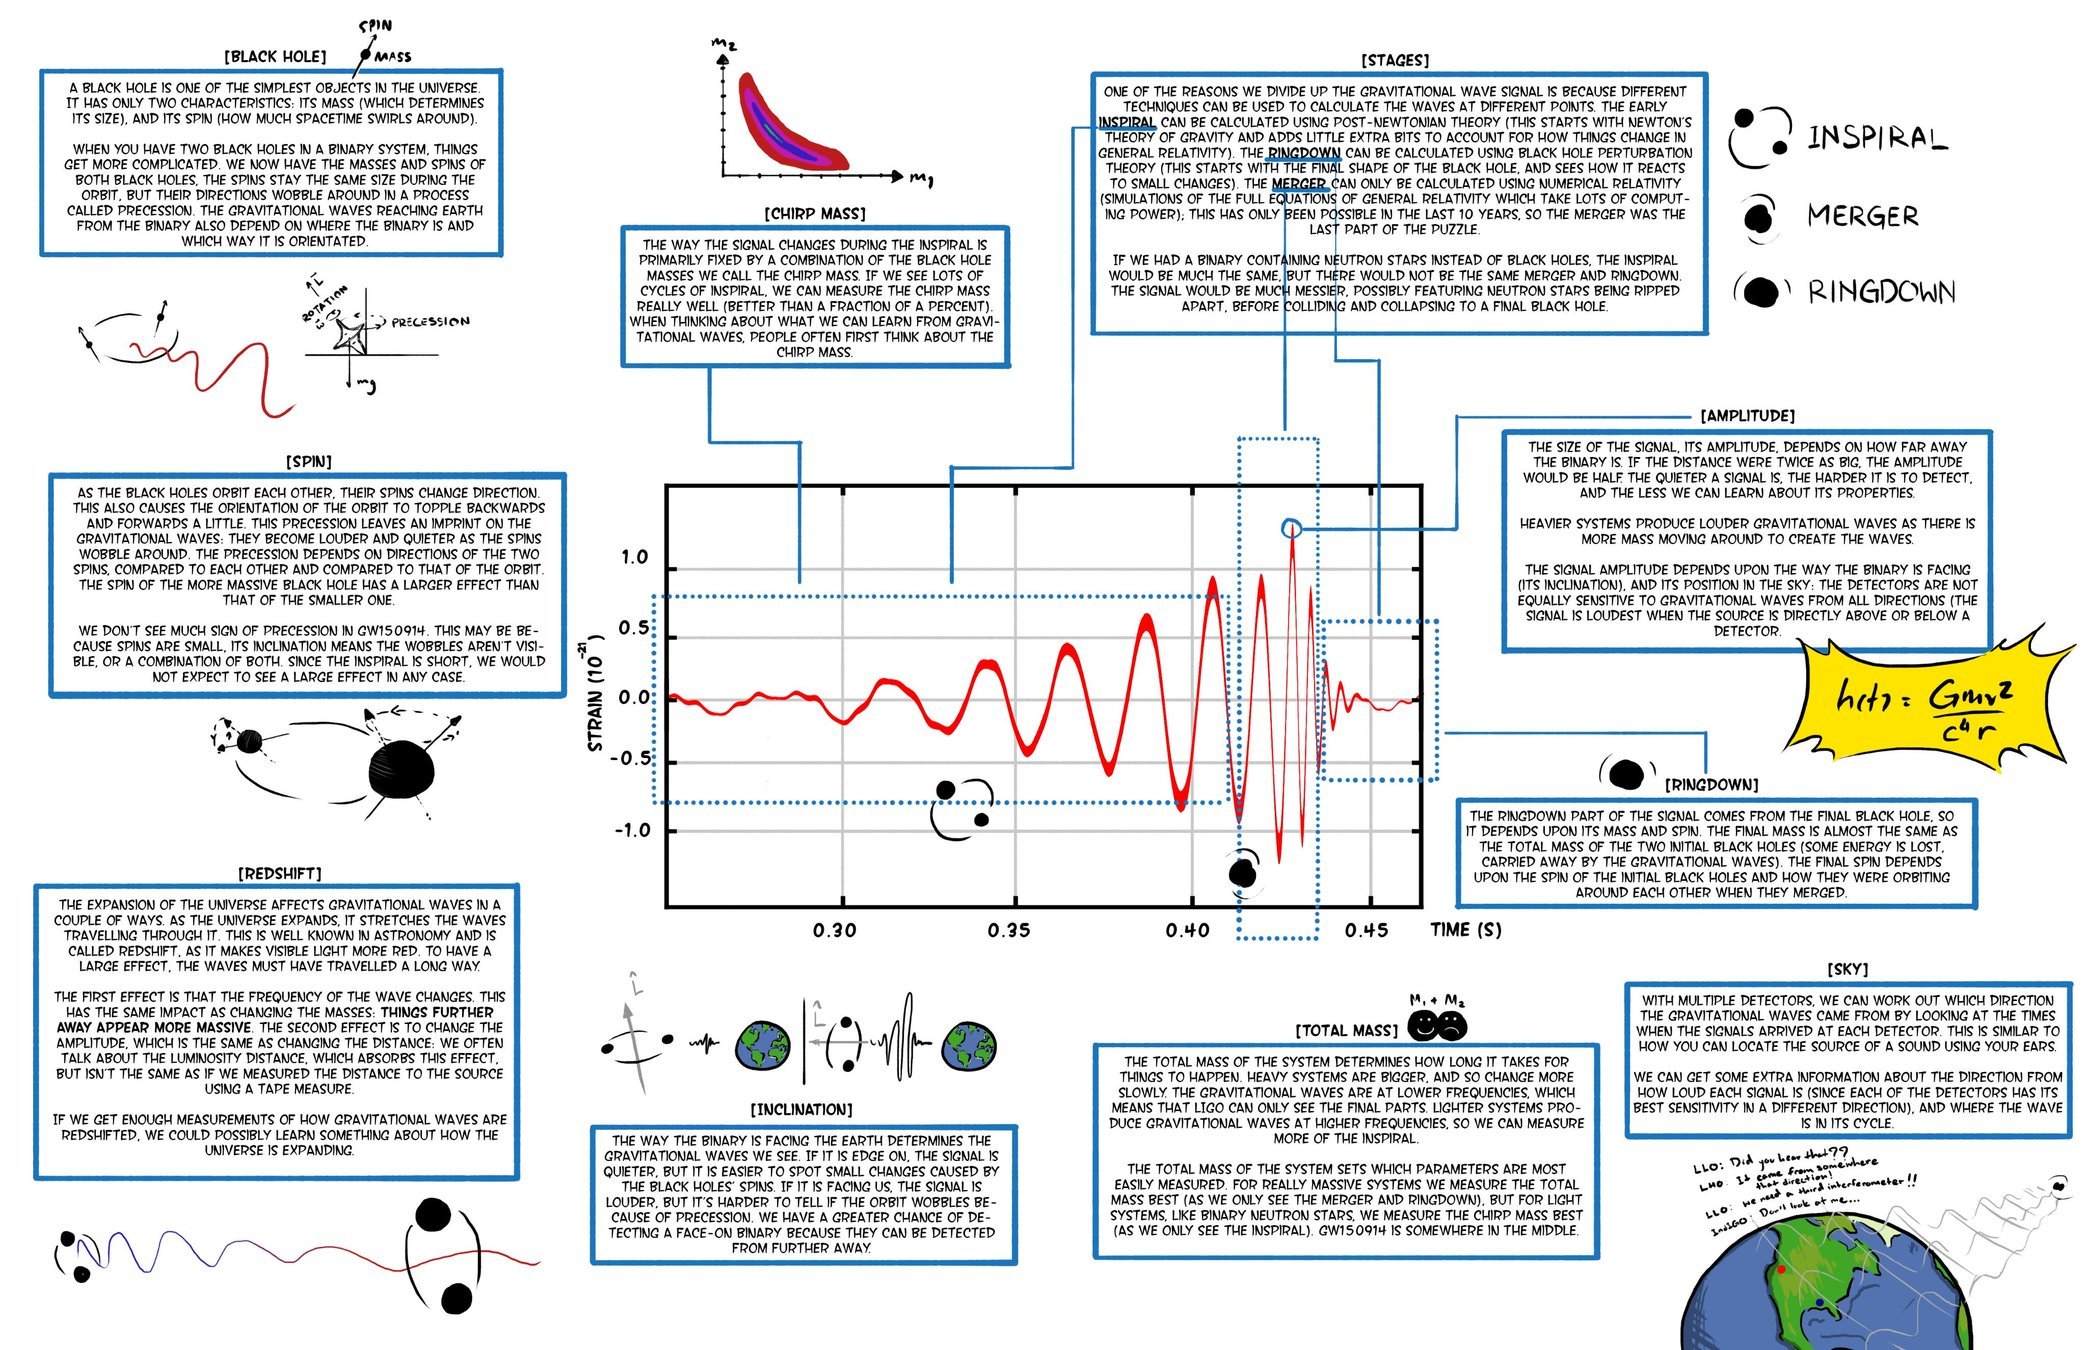
第一例双黑洞并合 GW150914 引力波信号
引力波天文学
把时空扰动从仪器噪声中辨认出来,是一次观测能否成立的第一关。
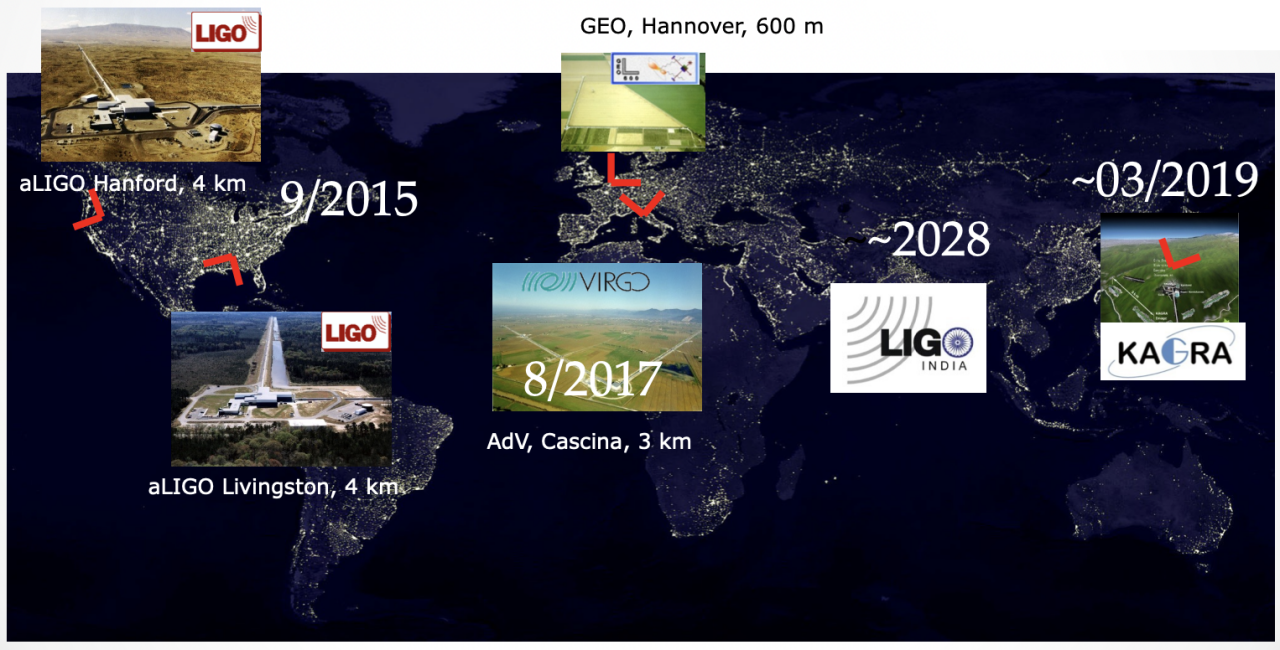
LIGO-VIRGO-KAGRA network
为什么我们愿意相信那次“听见”?
两台探测器独立记录到一致变化;波形与广义相对论预言相符;统计显著性和仪器排查支持这一解释
第一例双黑洞并合 GW150914 引力波信号
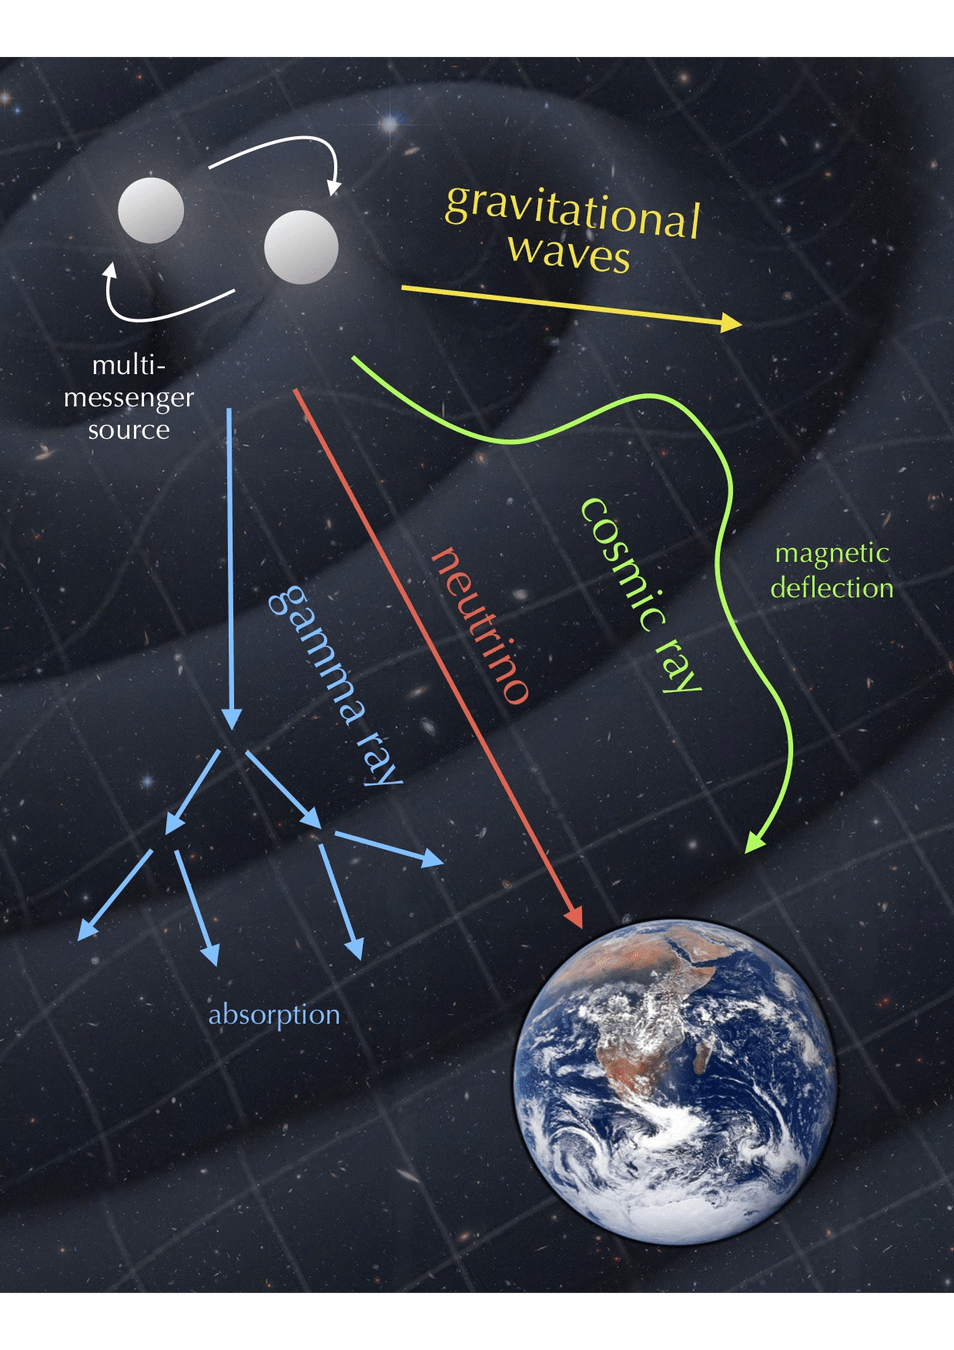
多信使天文学
不同探测器、不同波段与独立分析相互印证,证据链才会变得可信。
科学研究在做什么?
科学研究用可检验的预测,把理论与观测连接起来。
05
引力波建模的重要意义
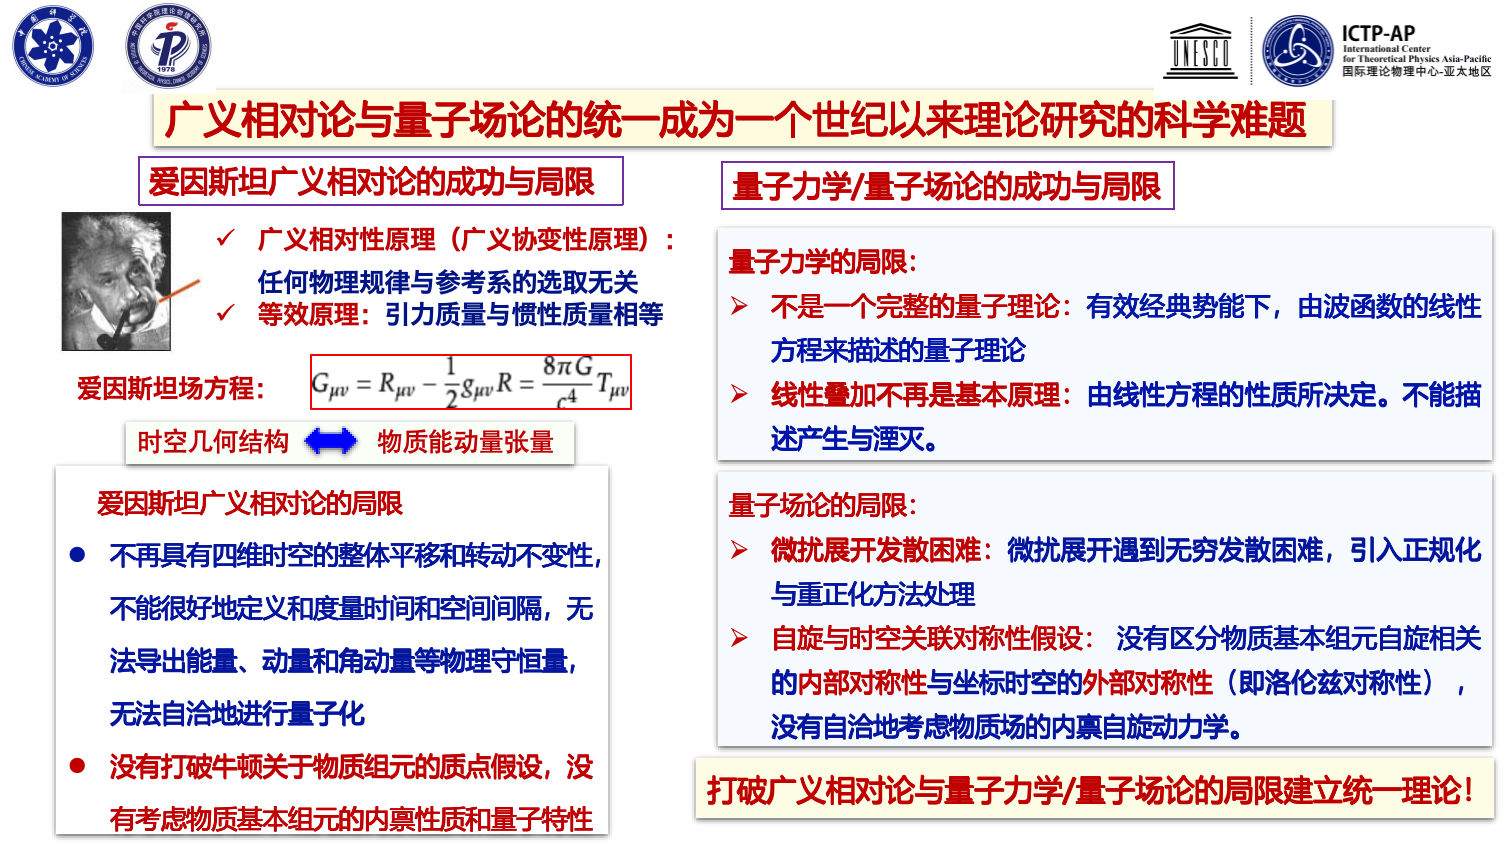
基础理论的检验与修正
基础物理学、天体物理学、宇宙学
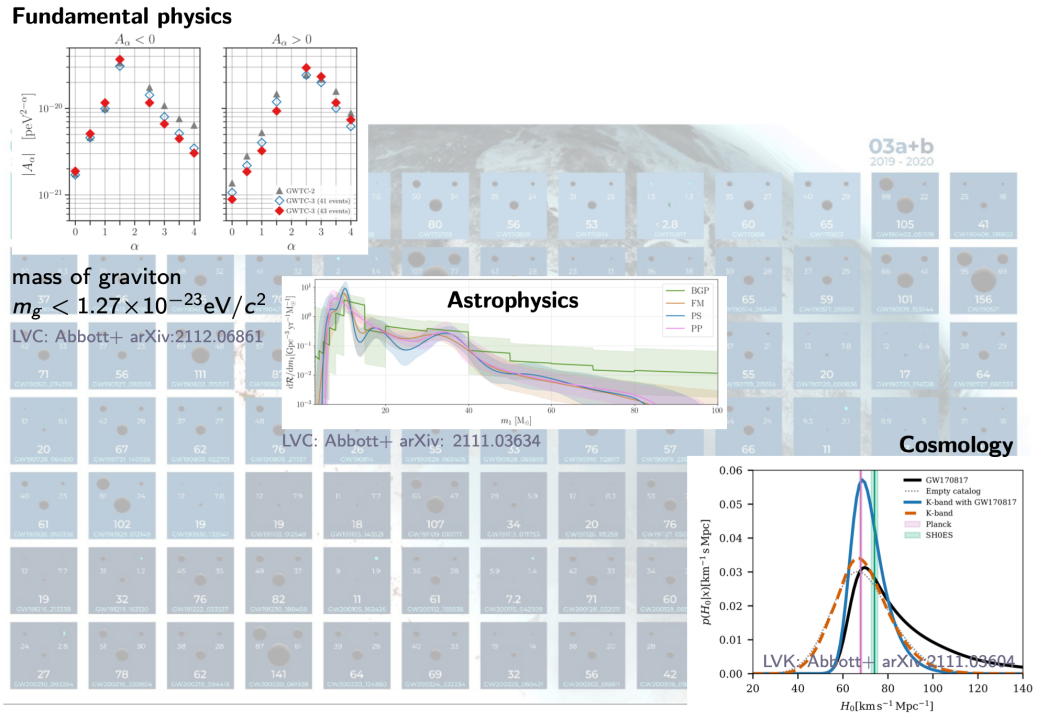
先把问题写成可检验的主张,再讨论证据是否支持它
科学研究既要求证据,也要求把问题说清楚。
让一个解释接受证据检验
科学研究把疑问转为有证据约束、可以公开讨论和修正的解释。
重要的变化,是从‘我觉得应该如此’,走到‘如果如此,我们应该观察到什么;如果观察不同,该修改哪里’。
科学论证的基本结构
???
观点
我的观点....
理由
因为...的理由
证据
在...证据的基础上
承认和回应
我承认这些质疑、反对和不同的想法,并用这些论据提出回应
论据
让我的理由和观点连接的原理是....
一个理论,怎样获得信任?
- Consistency(一致性:“逻辑一致”)
-
一个科学理论应该逻辑内部一致,并与已有的科学知识相协调,不能自相矛盾,也不应与已被广泛验证的理论冲突。一致性也是科学理论“质量好坏”的基本评判指标之一。
-
- Falsifiability(可证伪性:“可检验”)
- 卡尔·波普尔提出:科学理论必须可被实验证伪——即存在可观测的结果可能使它被证明为假。
一个不能被实验证伪的理论从逻辑上讲不能算作科学理论。
- 卡尔·波普尔提出:科学理论必须可被实验证伪——即存在可观测的结果可能使它被证明为假。
- Predictive Power(预测性:“解释、预测与边界”)
- 强有力的科学理论应该能够预测尚未观察到的现象或事件,并且这些预测能够被实验或观察验证。
科学理论是初步的想法,当积累到足够的数据和证据时,它最终将转变为科学定律。
(理论并不会因为积累了更新或更好的证据而转变为科学定律。)
某实验或观测证明了某科学理论。
(理论只能被证伪,无法被证明,顶多只能说该证据支持了某理论。)

“科学理论”是核心特征:
常见的误解:
- Wikipedia contributors. (2025). Scientific theory. In Wikipedia. 
- ScienceTimes. (2025). From hypothesis to breakthrough: What makes a theory scientific. 
- Edg.it (2025). What is a good scientific theory? 
- Wikipedia contributors. (2025). Falsifiability. In Wikipedia. 
认识可以不完整,但适用边界必须说清楚。
- 主流 collective picture
- 不可知论
- 虽然科研允许有洞,但要:
- 知道洞在哪里
- 知道为什么现在不补
“盲人摸象”
不同观测、模型与方法互相检查,逐步修正共同图景。
我们需要知道已经解释了什么、哪里仍然未知,以及接下来怎样补上缺口。


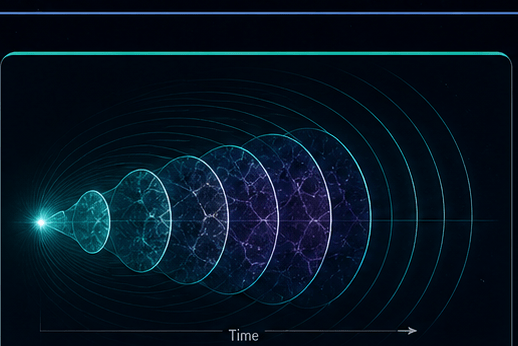
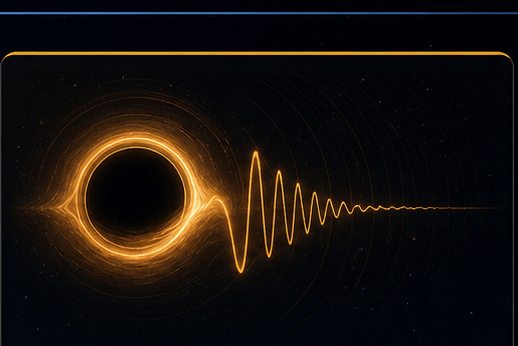
引力波把不可见的极端环境,转化为可检验的观测。
黑洞、致密天体和早期宇宙,提供通常天文实验难以达到的观测条件。
理论物理提出可检验的预言,引力波观测数据可以检验这些理论预言是否成立。
引力波把不可见的极端环境,转化为可检验的观测。
科学背景:LISA Definition Study Report, arXiv:2402.07571;图像均为概念示意
强引力场与黑洞
检验极端条件下的引力规律,
研究黑洞性质与形成机制。
极端条件下的天体现象
从致密星信号认识物质状态,
连接天体物理与天体观测。
宇宙起源与演化
研究宇宙膨胀与黑洞形成,
寻找早期宇宙留下的线索。
从研究问题,到可复用的关系与表示
科学论证的基本结构
把一次性的问题,变成可学习、可复用的结构。
我研究什么;想弄清什么;为什么值得弄清?
从一个仅仅有趣的问题到这个问题更广泛的意义:
1. 题目:我正在研究_______。
2. 问题:因为我想要找出什么(what)/为什么(why)/如何(how)_______。
3. 重要意义(理由):为了帮助读者了解_______。
From: 《研究是一门艺术》
Eg:
1. 我正在研究冷却系统修复的诊断过程。
2. 因为我要尝试找出修复专家是如何诊断故障原因的。
3. 为了帮助读者了解如何设计一个可以自动诊断及预防故障的电脑系统。
1. 我正在研究基于AI的引力波信号探测和识别方法。
2. 因为我要尝试找出深度学习模型如何在强噪声背景下有效地区分真实引力波信号与噪声瞬变。
3. 为了帮助读者了解如何构建一个能够在真实探测环境中实现快速、稳健、低误报的引力波自动探测系统。
不够痛的“优化型”问题
意义可以来自解释异常、澄清概念、补知识缺口
或改善方法,
真正更有意义的问题,源于并回应真实的痛点。

真正痛的“生存型”问题
提出观点,也要说明它凭什么成立
一般你要为读者回答以下五种问题:
- 什么是你的 观点(claim)?
- 什么 理由(reasons)能支持你的观点?
- 什么 证据(evidence)能支持你的理由?
- 你 承认(acknowledge)这些不同的替代方案/复杂的情形/或反驳吗?你如何做出 回应(respond)呢?
- 什么 原理/论据(principle/warrant)能证明你的理由和观点之间的关联呢?
From: 《研究是一门艺术》
论证的核心架构:
- 支持观点的理由建立于证据的基础之上
主张:我认为怎样;理由:为什么;证据:哪些观察或推导支持;
替代解释:还有什么可能;回应:哪些检查能够区分。
观点
我的观点....
理由
因为...的理由
证据
在...证据的基础上
承认和回应
我承认这些质疑、反对和不同的想法,并用这些论据提出回应
论据
让我的理由和观点连接的原理是....
以引力波为例,搭建一条论证链
观点
我的观点....
理由
因为...的理由
证据
在...证据的基础上
承认和回应
我承认这些质疑、反对和不同的想法,并用这些论据提出回应
论据
让我的理由和观点连接的原理是....
主张:我认为怎样;理由:为什么;证据:哪些观察或推导支持;
替代解释:还有什么可能;回应:哪些检查能够区分。
- 观点:引力波的成功探测开启了探测宇宙的新窗口。
- 理由(主观):
- 引力波提供了传统电磁波无法携带的宇宙信息。
- 引力波能够穿透电磁波无法穿透的宇宙环境。
- 证据(客观):
- LIGO于2015年9月14日记录到编号为GW150914的特定时空扰动信号。
- 该信号波形与广义相对论预言的双黑洞并合过程产生的引力波波形高度匹配。
- 论据(普遍原理):
- 一种探测技术若能提供全新类型的信息,它就开启了一个新的观测窗口。
- 一种探测技术若能探测到以往技术无法触及的区域或对象,
它就开启了一个新的观测窗口。
-
承认:我们承认在GW150914之前,已有对脉冲双星PSR B1913+16的观测,
其轨道衰减间接证据支持了引力波的存在。这似乎意味着“窗口”早已打开。 -
回应:然而,间接验证不同于直接探测。....
AI生成的一句话,属于观点、理由,还是证据?
AI生成的内容先是候选或假设,不自动成为证据。
AI生成的内容,怎样进入证据链?
AI只是在已有知识之间做“插值”吗?
理解数据驱动AI,可以先从它怎样利用经验开始。
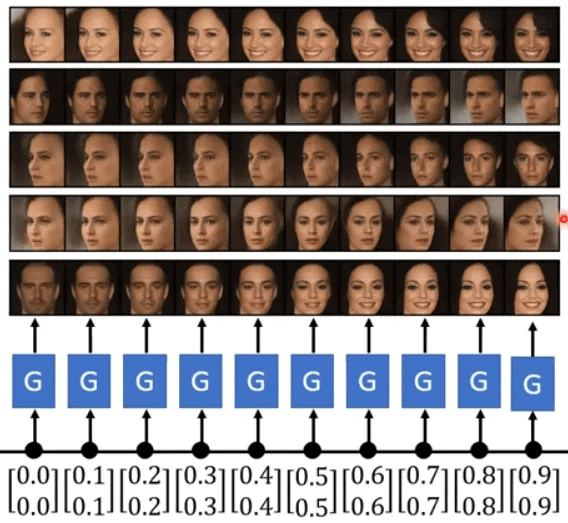
- 插值的直观含义:利用已有样本之间的关系,估计相关的新情况。
- 现代数据驱动AI会学习这些关系与表示,用于预测和生成。
- 我们要继续追问:它学到了什么结构?这些结构在新情境中是否可靠?
例如人脸 morph 的例子就很好:像素空间线性插值和 latent space 插值不是一回事。深度模型真正强的地方,往往是先把数据组织成一个有结构的 representation manifold,再在这个空间里做平滑泛化。
模型在已有表示中重组模式;是否真正超出已知结构,需要外部验证。
从数据中学习模型,是理解当下AI的一条主线。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source, 2021)
Representation Space Interpolation
在学习到的表示空间中插值
G:生成模型
AI只是在已有知识之间做“插值”吗?
为什么一串新的图像,仍然可以保持合理的变化?
能生成合理候选,为进一步探索提供了起点。
- 模型通过训练,学到数据中可以重复利用的结构。
- 生成模型可以借助这些结构,组合并产生新的样本。
- 生成结果是否符合当前问题,还需要进一步检查。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source, 2021)
例如人脸 morph 的例子就很好:像素空间线性插值和 latent space 插值不是一回事。深度模型真正强的地方,往往是先把数据组织成一个有结构的 representation manifold,再在这个空间里做平滑泛化。
模型在已有表示中重组模式;是否真正超出已知结构,需要外部验证。
为什么很多 AI 应用看起来像“理解”?
模型学到的不是像素,而是可复用的结构。
生成结果可以很像真的,但仍需回到问题、数据与证据中检验。
- 许多“举一反三”并不是凭空外推,而是模型在表示空间中进行组合、插值与重建。
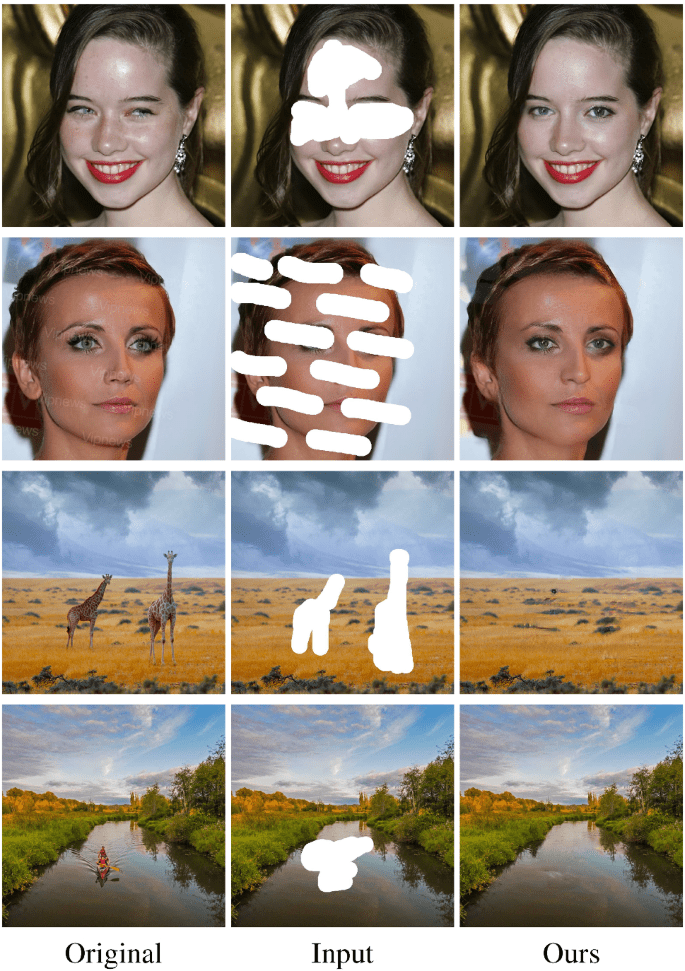
Cao et al. Complex Intell. Syst. (2023)
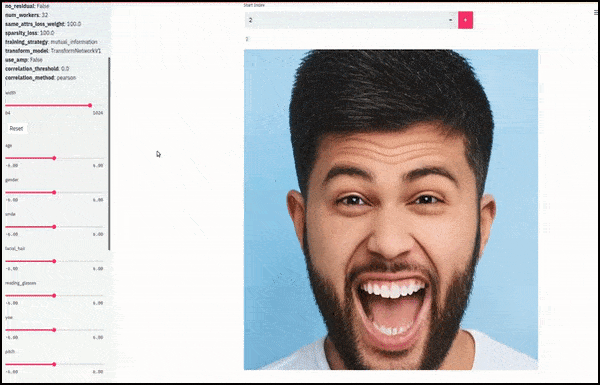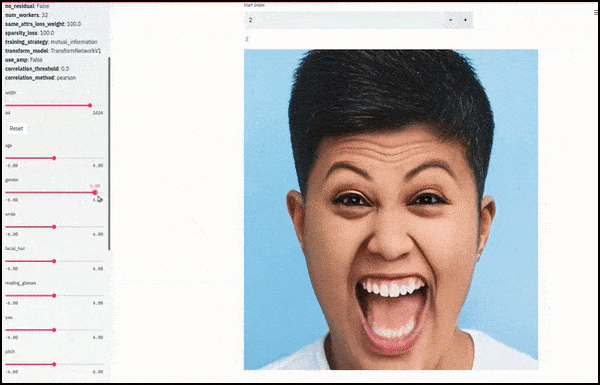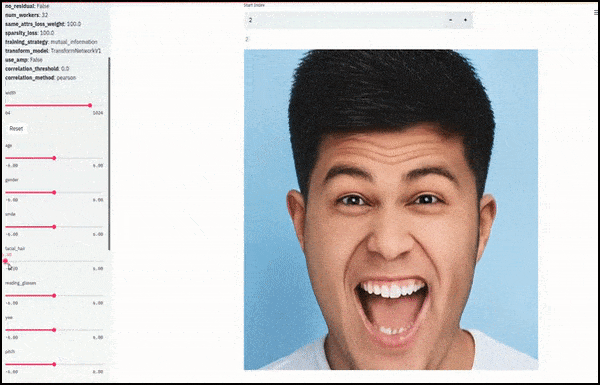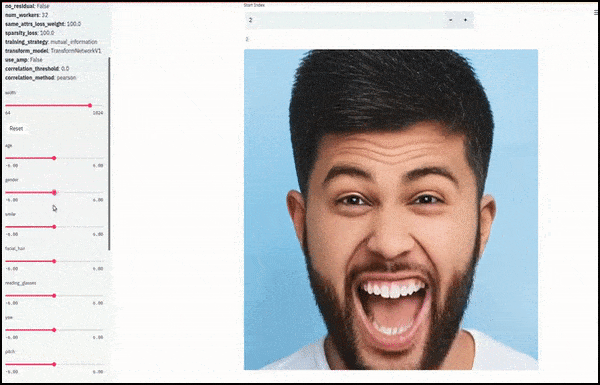
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source, 2021)
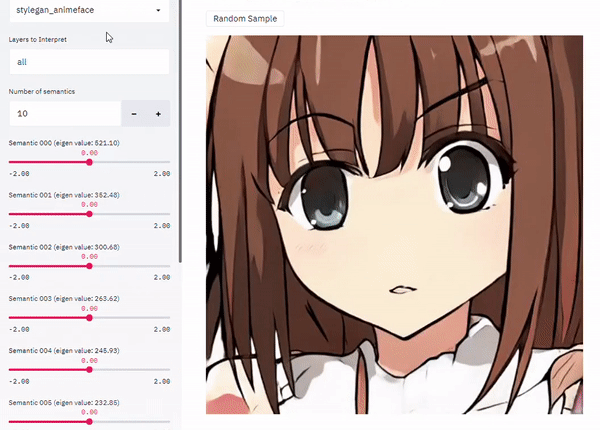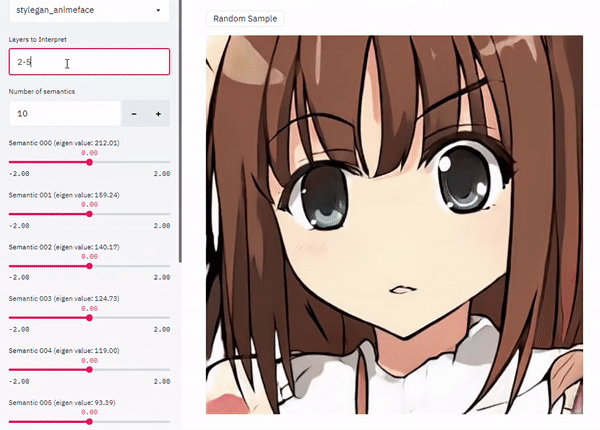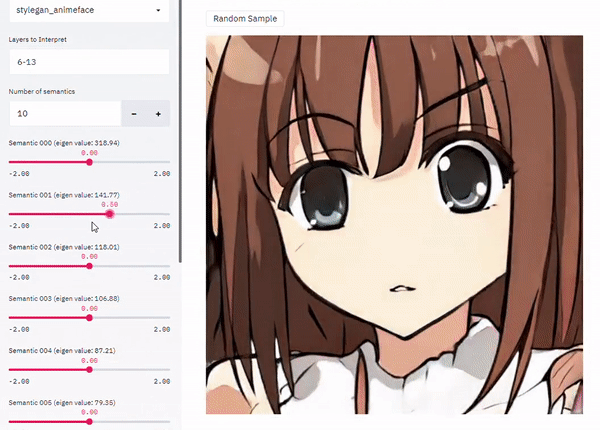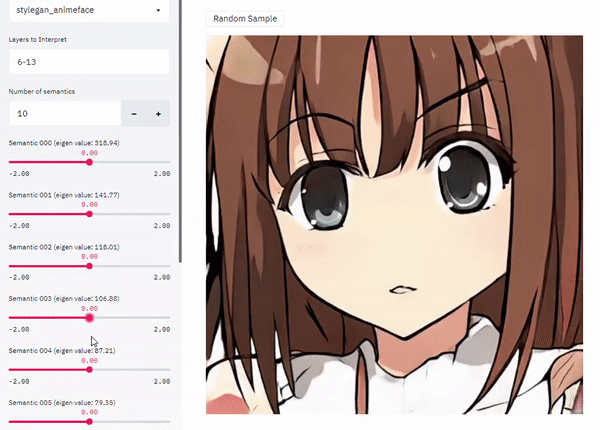
可控生成:沿语义方向编辑
表示空间插值:生成合理候选
结构重组:从分散线索恢复信息
表示空间改变“相近”的含义,数据覆盖决定泛化的边界
从应用现象到内部结构:AI 如何组织经验
表示方式改变,“相近”的含义也会改变
同样的两个端点,沿不同结构变化,会得到不同结果。
建模让复杂经验变得可组织、可预测、可生成。
- Deep learning 的强大之处,很多时候不是“凭空外推”,而是学到了一个 representation,使得原来复杂的数据关系在这个 manifold 空间里变得更平滑、更容易插值。
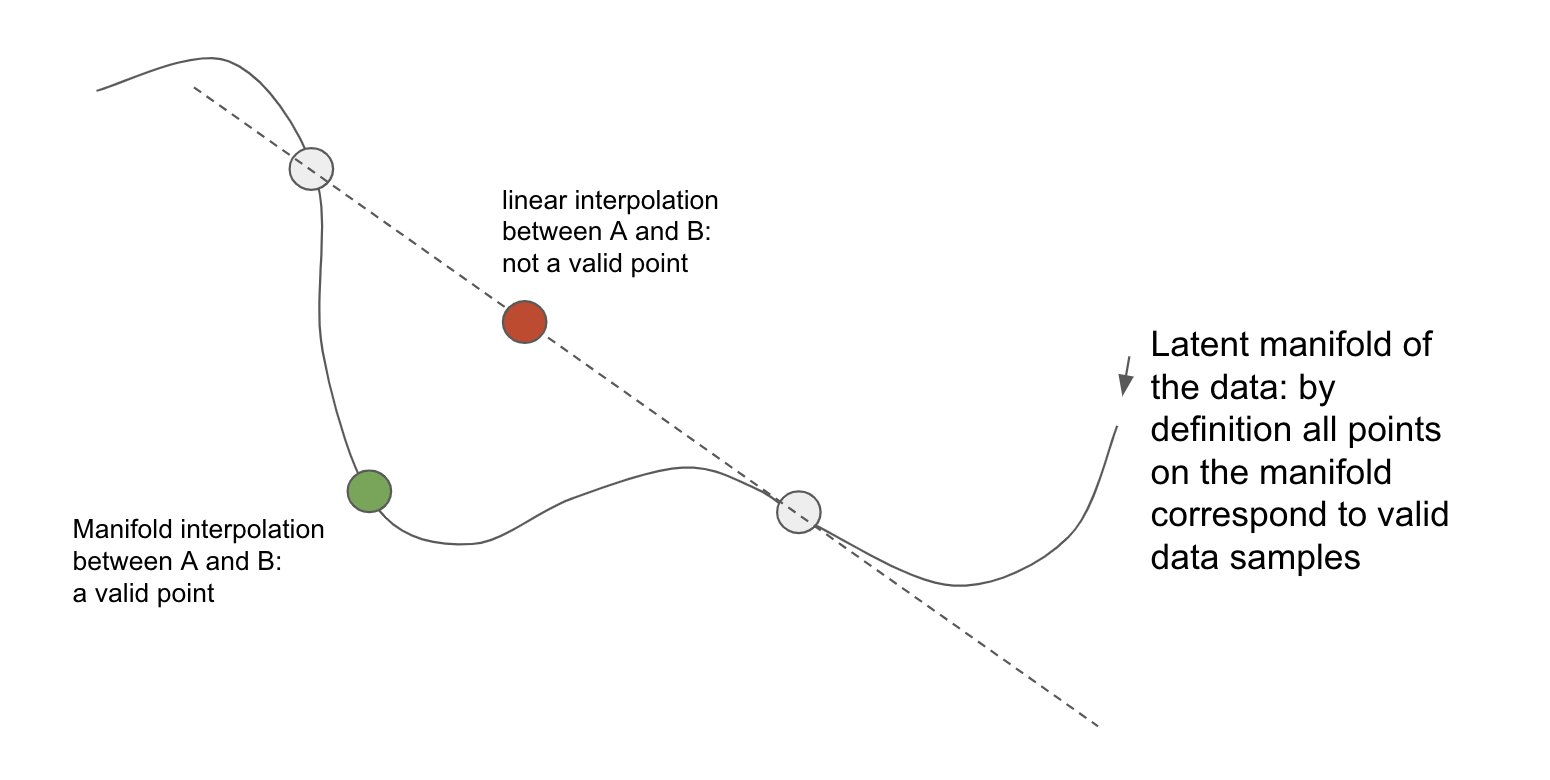
在学习到的表示空间中插值
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source, 2021)
经验怎样影响模型学到的结构?
新例子可以与训练经验共享结构。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source, 2021)
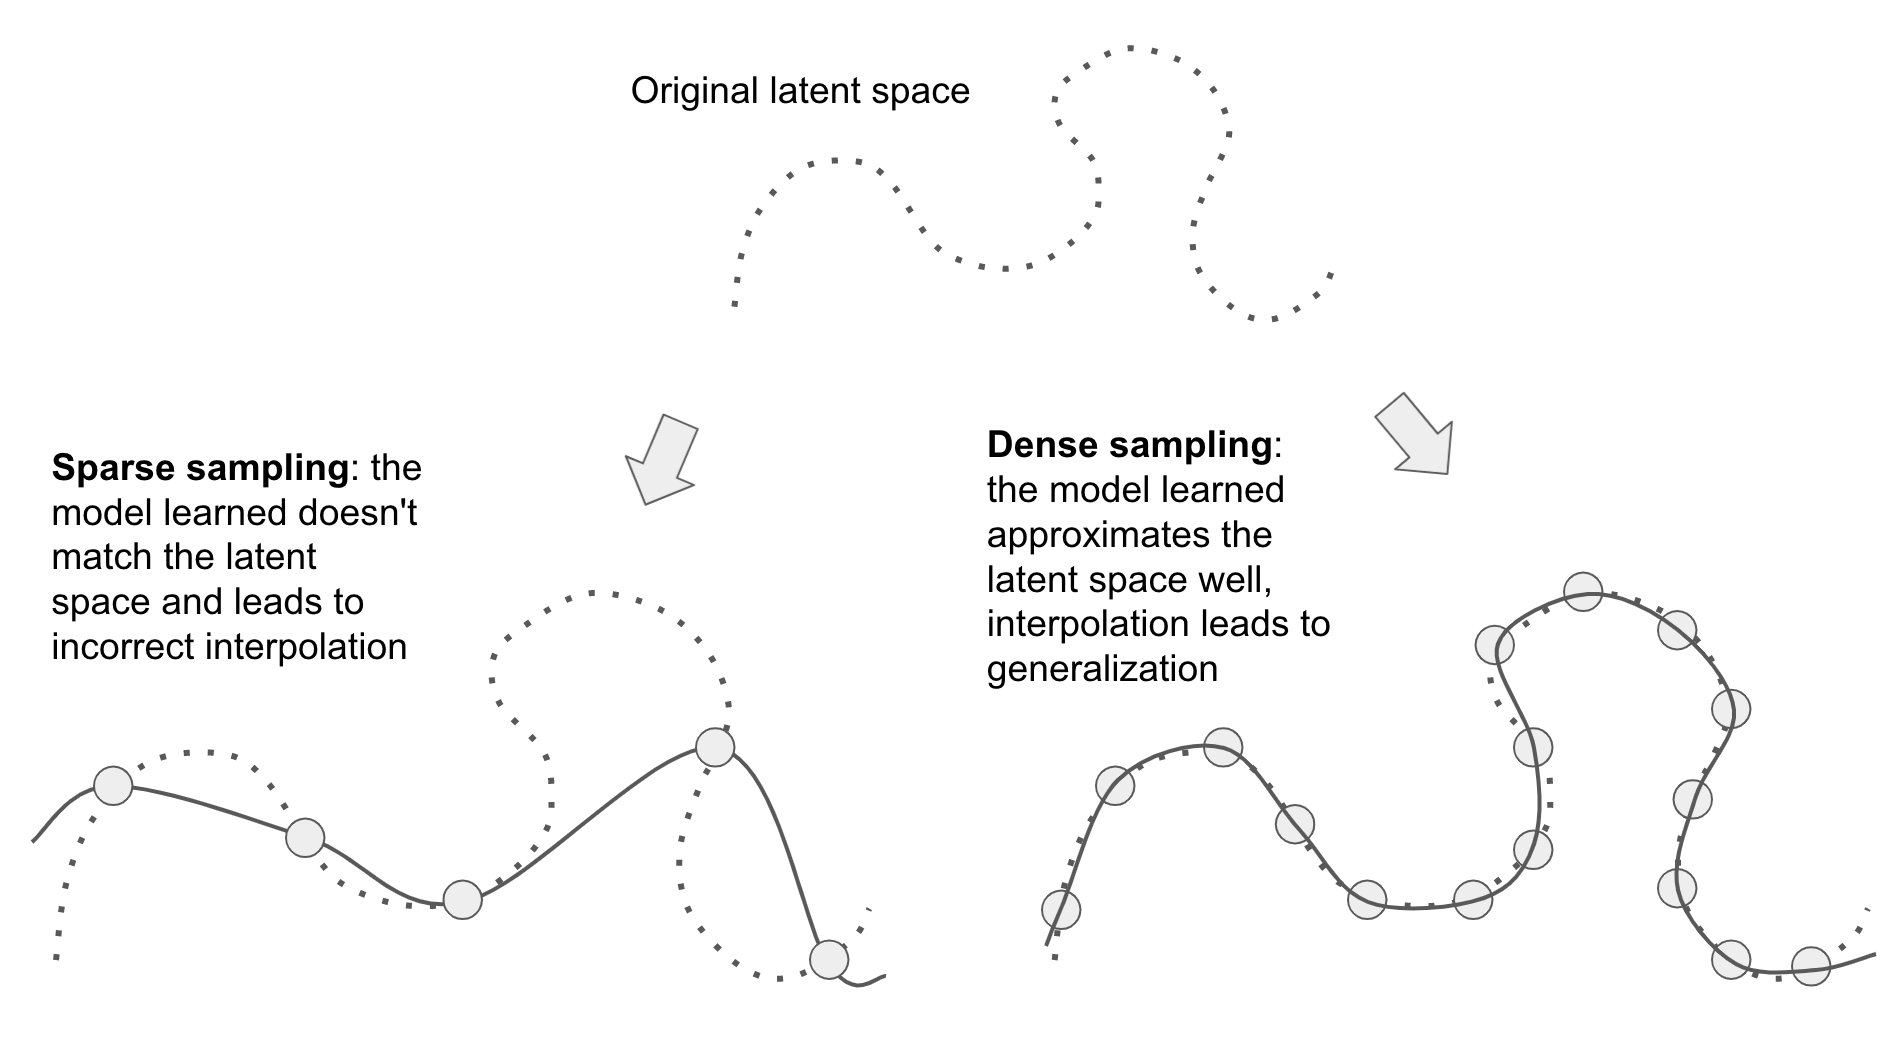
Underlying data manifold / latent structure
也就是现实数据真正分布的“结构”。
Sparse data → wrong geometry → poor generalization
训练数据太稀疏时,模型只能从少量样本猜测这个结构,因此学到的 manifold 可能偏离真实 manifold。
Dense coverage → better representation → reliable interpolation
数据覆盖越充分,模型越容易学到接近真实 manifold 的表示,因此在已覆盖结构附近做 interpolation 时,泛化会更稳定。
Generalization is not magic — it comes from structure shared between training and unseen data.
AI 之所以可以在“没见过”的样本上表现好,并不意味着它真的见到了一个完全陌生的世界。很多时候,新样本虽然没出现过,但仍然落在训练数据已经覆盖的同一个结构上。
LLMs appear highly general because their training distribution is extraordinarily broad.
GPT 看起来能回答一个“从没见过的问题”,不一定意味着它在严格数学意义上做了很远的 extrapolation;很可能是因为互联网规模的训练数据已经让 latent space 覆盖了极其丰富的语言、代码和知识结构。
所以,
- Scaling can turn apparent extrapolation into interpolation in a richer learned space.
- The larger and richer the training distribution, the larger the region in which “interpolation” looks like intelligence.
- But science is often about finding what is not already well covered by the data. Where does novelty come from?
- Code
- Language
通用性还来自规模、数据、架构、后训练和工具使用。
从预测下一个词,到成为通用模型
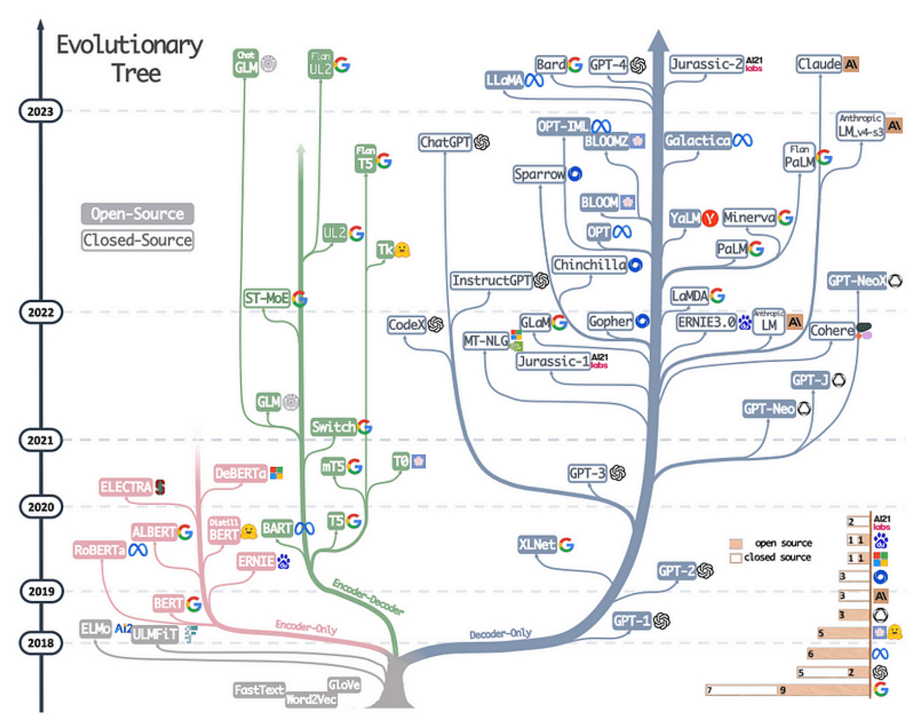
① Encoder-only
Read everything
典型任务:classification · retrieval · NER · embeddings- 典型模型:BERT · RoBERTa
② Encoder–Decoder
Read, then generate
- 典型任务:translation · summarization · seq2seq
- 典型模型:T5 · BART · original Transformer
③ Decoder-only
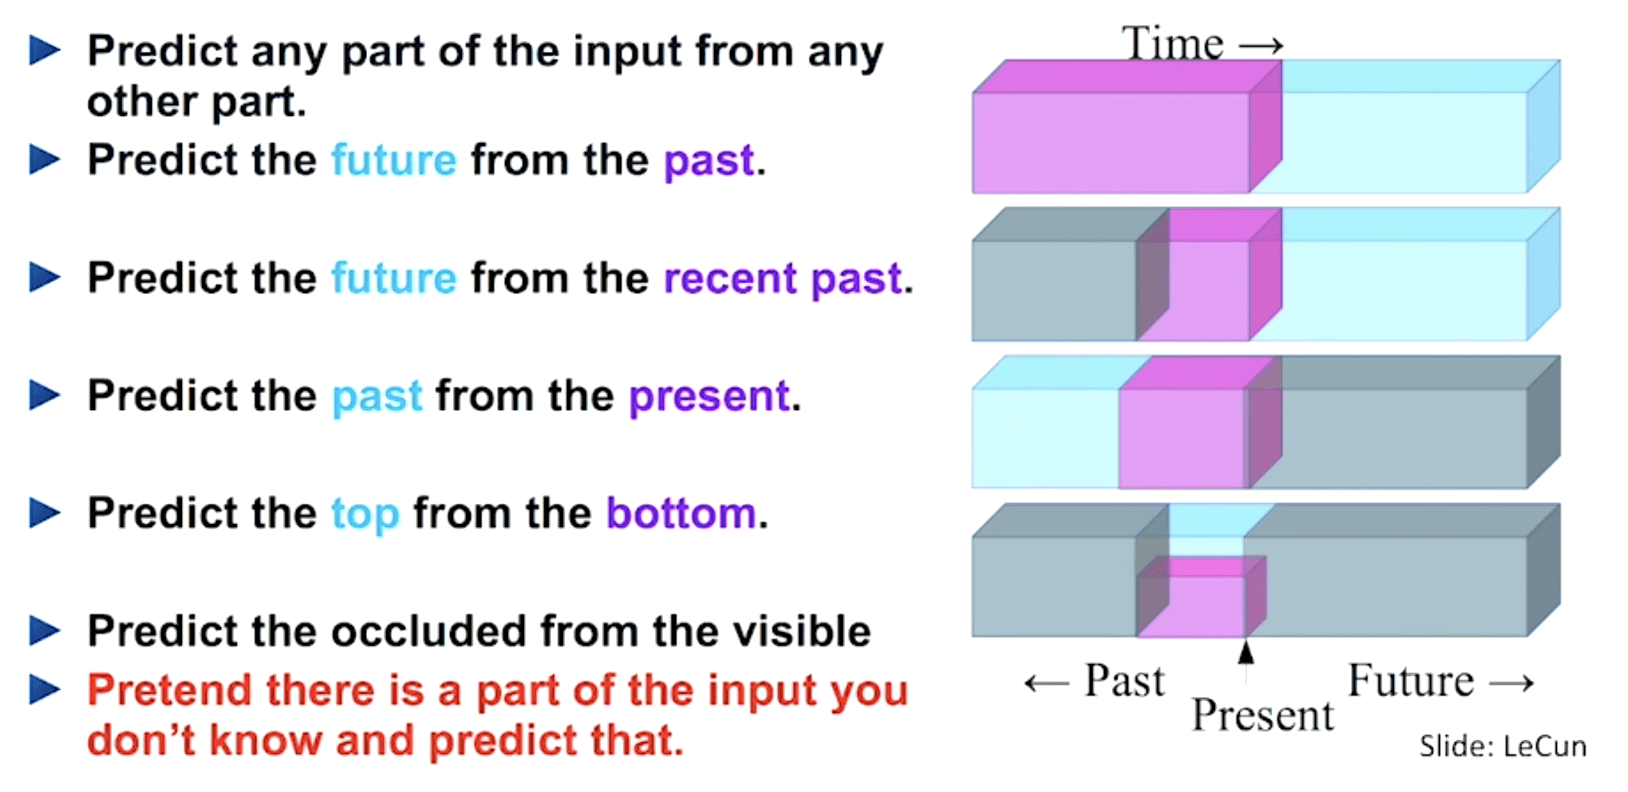
Predict what comes next
- 典型模型:GPT family · LLaMA
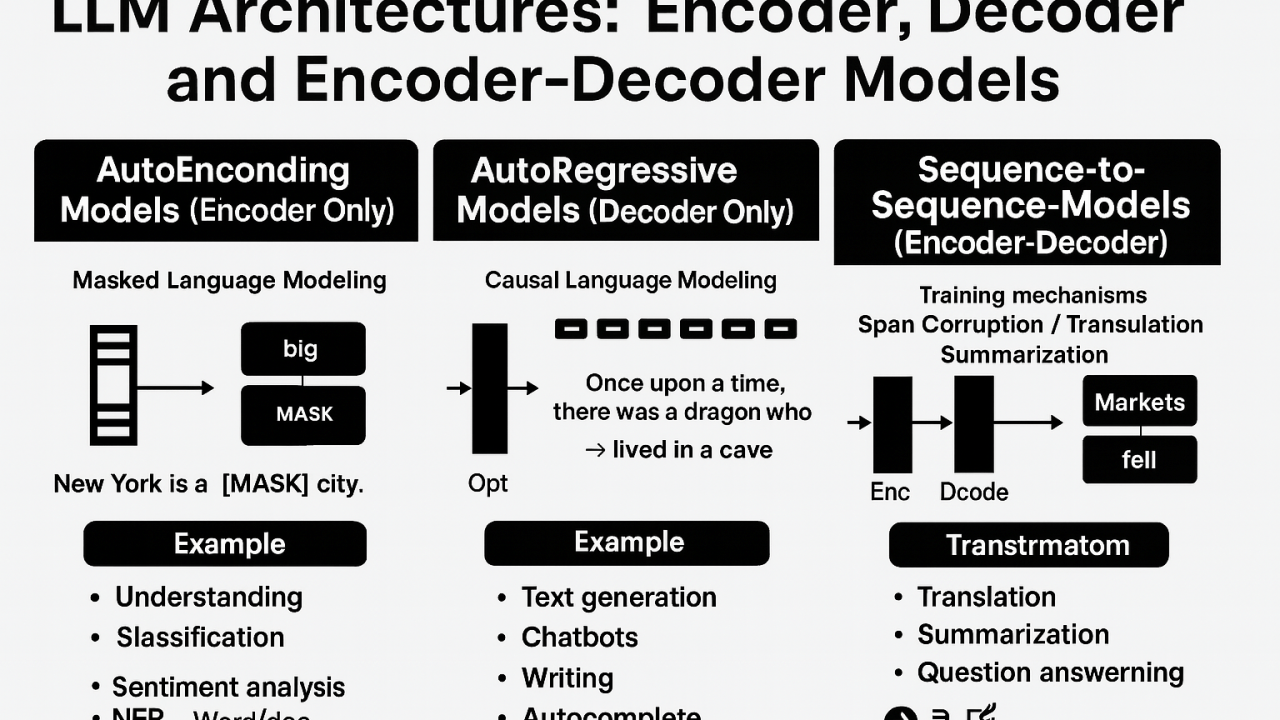
Source: X
自回归(Autoregressive)训练方式
模型每次只能看到前面的词,通过不断预测“下一个词”是什么来进行学习。
BERT vs GPT
Two self-supervised objectives, two very different futures
GPT
\(\text{The cat sat on the} \rightarrow ?\)
Predict next token.
Causal
Generation-oriented
BERT
\(\text{The cat [MASK] on the mat}\)
Predict masked token.
Bidirectional
Representation-oriented
Excellent representations / understanding
The path that scaled into general-purpose LLMs
2018–2019
BERT looked extremely powerful
2020+
GPT-style scaling changed the game
2020+
GPT-style scaling changed the game
This figure stops around 2023.
Excellent sequence-to-sequence models
从预测下一个词,到成为通用模型
模型每次只能看到前面的词,通过不断预测“下一个词”是什么来进行学习。
Code
Scaling
Programmability
大语言模型为何显得如此强大?
GPT-3 → GPT-3.5: The “Code” Turning Point
Training on code did more than teach the model programming.
02
为什么训练 Python、JavaScript、GitHub 代码 居然可能让一个语言模型的自然语言推理也变强?
-
Code forces the model to learn precise structure.
-
Code is full of explicit intermediate computation.
-
Small components must compose correctly into a working whole.
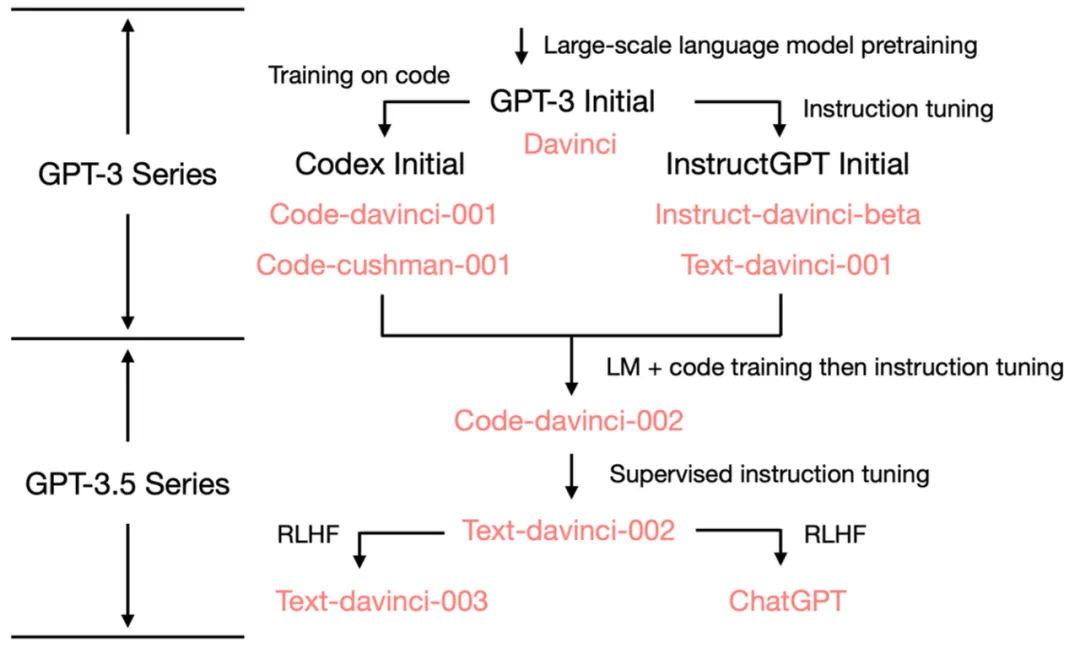
GPT-3 (2020)
ChatGPT (2022)
Magic: Code + Text
John has 3 apples and buys 2 more.
How many does he have?
apples = 3
apples += 2
print(apples)Natural language
Code
语义相同,但代码让变量、运算与状态尽数显性化。
代码提供结构化、可执行、可反馈的训练信号。
现代大模型的底层基因里,
天生刻着“自然语言 + 代码”的双重烙印。
大语言模型到底为何如此颠覆? — ① Code
Training on code did more than teach the model programming.
02
为什么训练 Python、JavaScript、GitHub 代码 居然可能让一个语言模型的自然语言推理也变强?
-
Code forces the model to learn precise structure.
-
Code is full of explicit intermediate computation.
-
Small components must compose correctly into a working whole.
GPT-3 (2020)
ChatGPT (2022)
Magic: Code + Text
John has 3 apples and buys 2 more.
How many does he have?
apples = 3
apples += 2
print(apples)Natural language
Code
现代大模型的底层基因里,
天生刻着“自然语言 + 代码”的双重烙印。
语义相同,但代码让变量、运算与状态尽数显性化。
代码提供结构化、可执行、可反馈的训练信号。
大语言模型到底为何如此颠覆? — ② Scaling
More compute, more data, larger models → predictably lower loss
规模规律依赖于模型、数据和任务;规模扩大也会带来边际收益递减。
02
当一切皆可规模化(scalable),
边界将被彻底重塑。
Why scaling matters
Predictable
- We can forecast larger-model performance.
Continuous
- Capability keeps improving over large resource ranges.
Composable
- Scaling later expanded beyond pretraining.
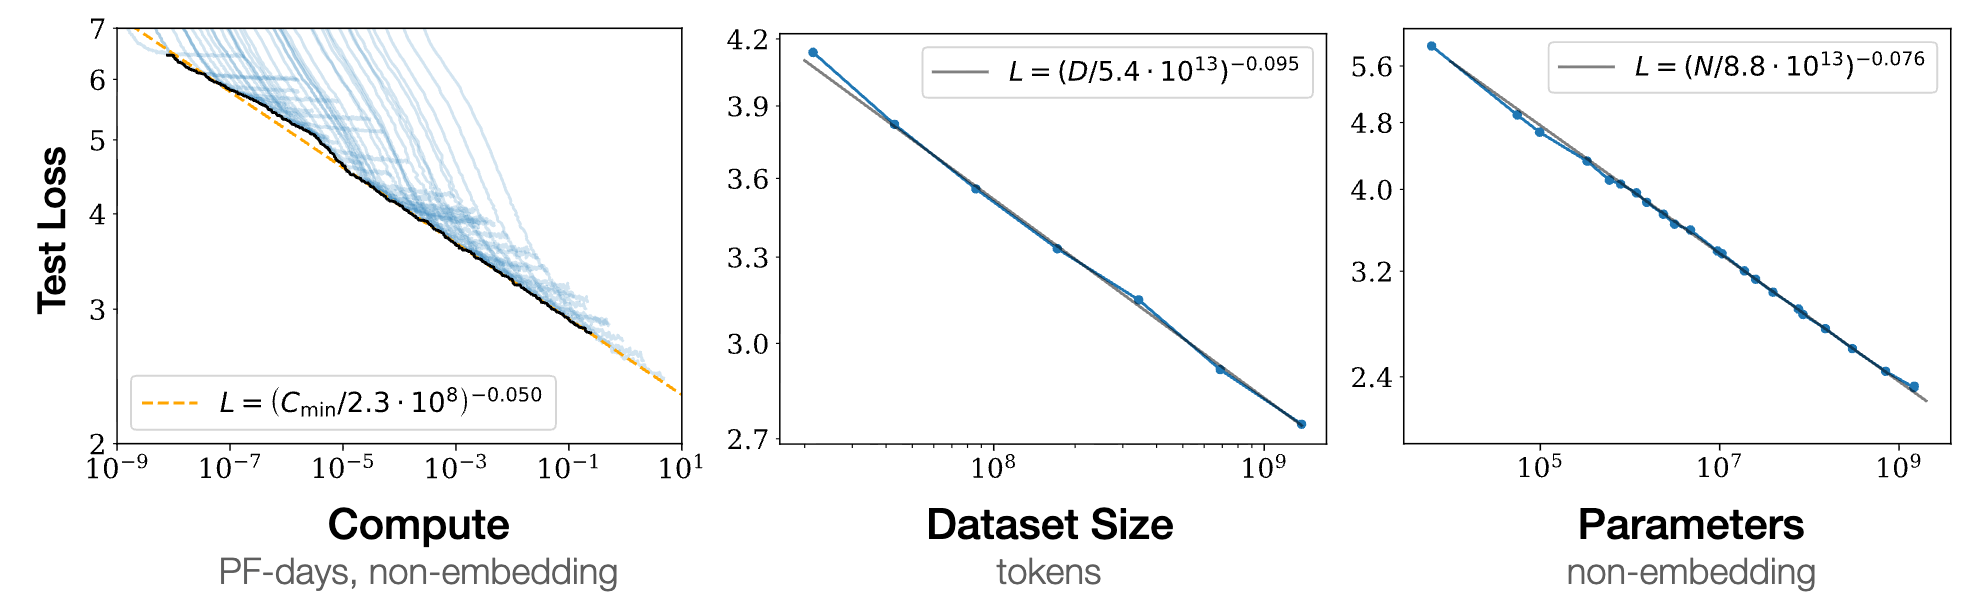
arXiv:2001.08361 [cs.LG]
Performance did not saturate as quickly as people expected.
大语言模型到底为何如此颠覆? — ③ Programmability
From explicit rules to natural-language control
02
大语言模型正从单一算法模型,进化为驾驭软件、数据与物理世界的通用可编程接口。
Rule-Based Vs. LLMs: (Source)
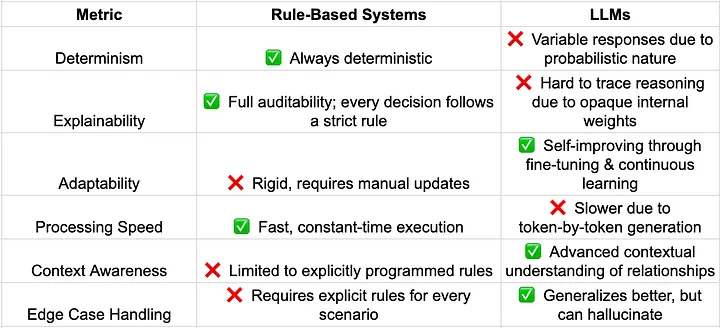
if sender in VIP_LIST \
   or "urgent" in subject \
   or "!" in subject \
   or priority == "high":
    notify()
❌ brittle rules
❌ unseen wording
❌ endless edge cases
Traditional Programming
Program the condition
LLM Programming
Describe the condition
if LLM(
  "Does this message require
   an important action soon?"
):
    notify()
如果收到一封“重要且需要我尽快处理”的邮件,就提醒我。
- “Could you send me the revised figure before tomorrow’s meeting?”
- “URGENT: Our summer sale ends tonight!”
✓ semantic
✓ context-aware
✓ adaptable to unseen cases
Code controls the flow;
language defines the condition.
大语言模型到底为何如此颠覆? — ③ Programmability
From explicit rules to natural-language control
02
大语言模型正从单一算法模型,进化为驾驭软件、数据与物理世界的通用可编程接口。
Rule-Based Vs. LLMs: (Source)
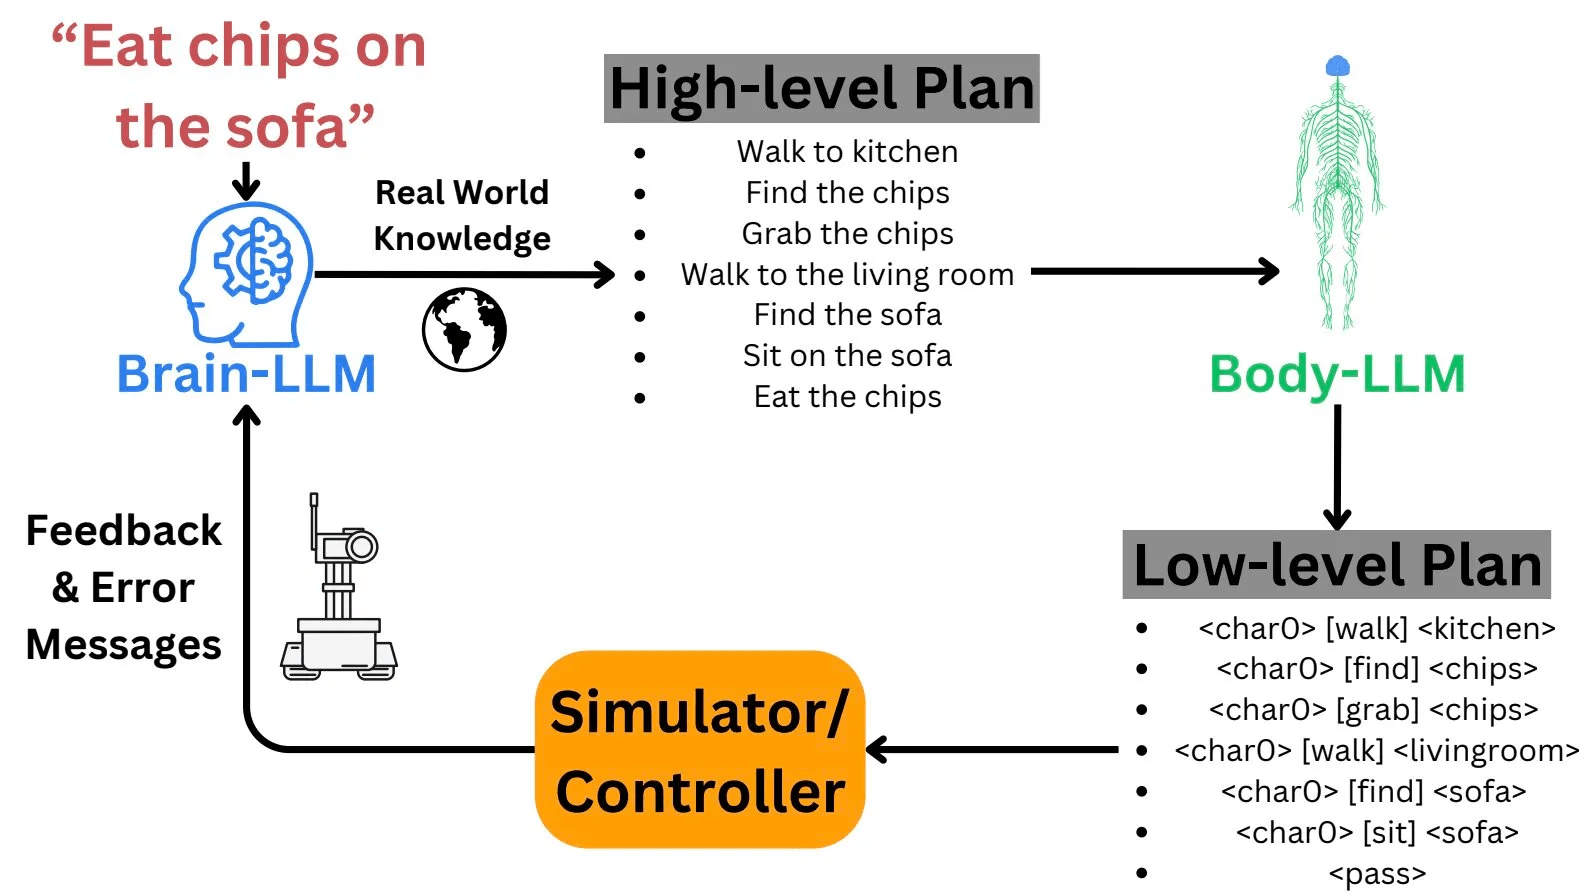
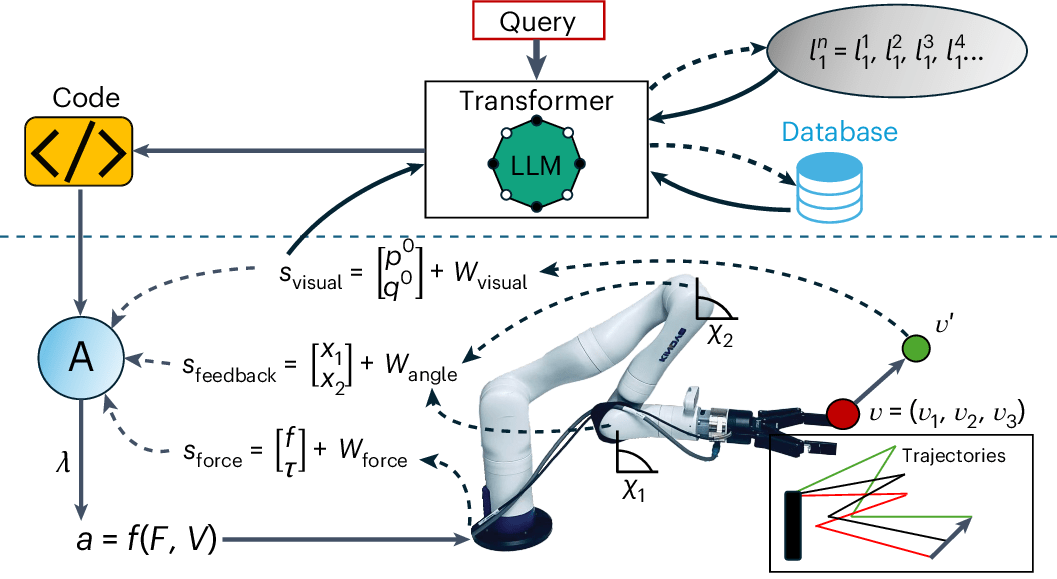
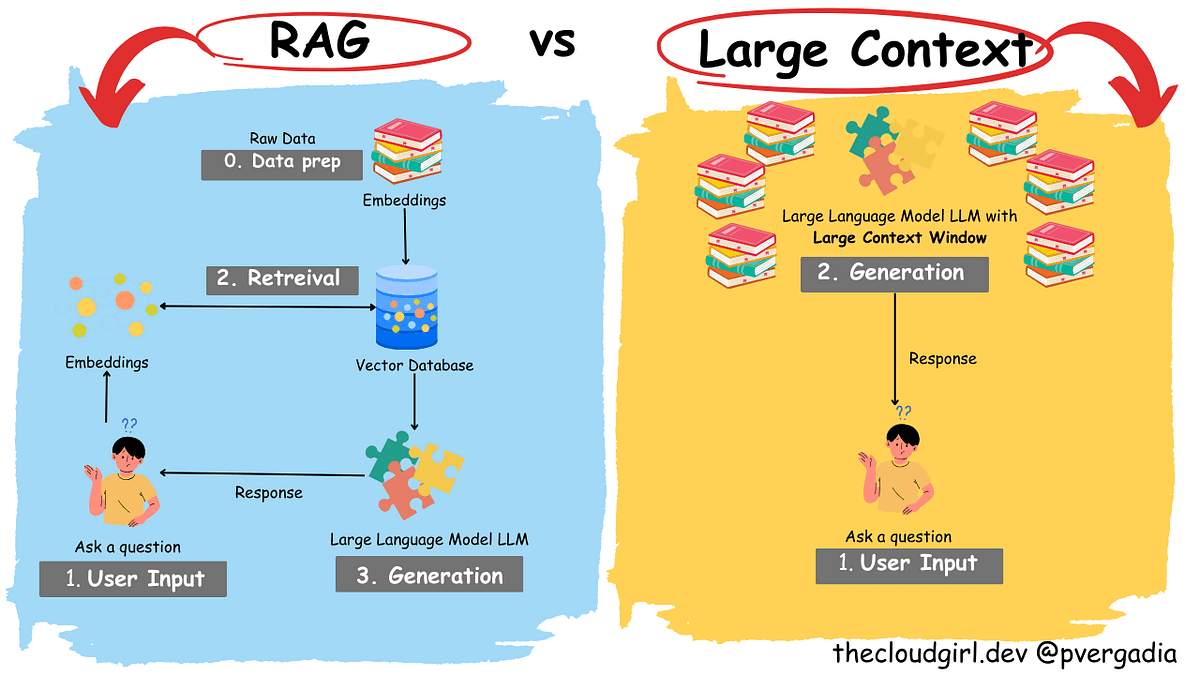
大语言模型到底为何如此颠覆? — ③ Programmability
From explicit rules to natural-language control
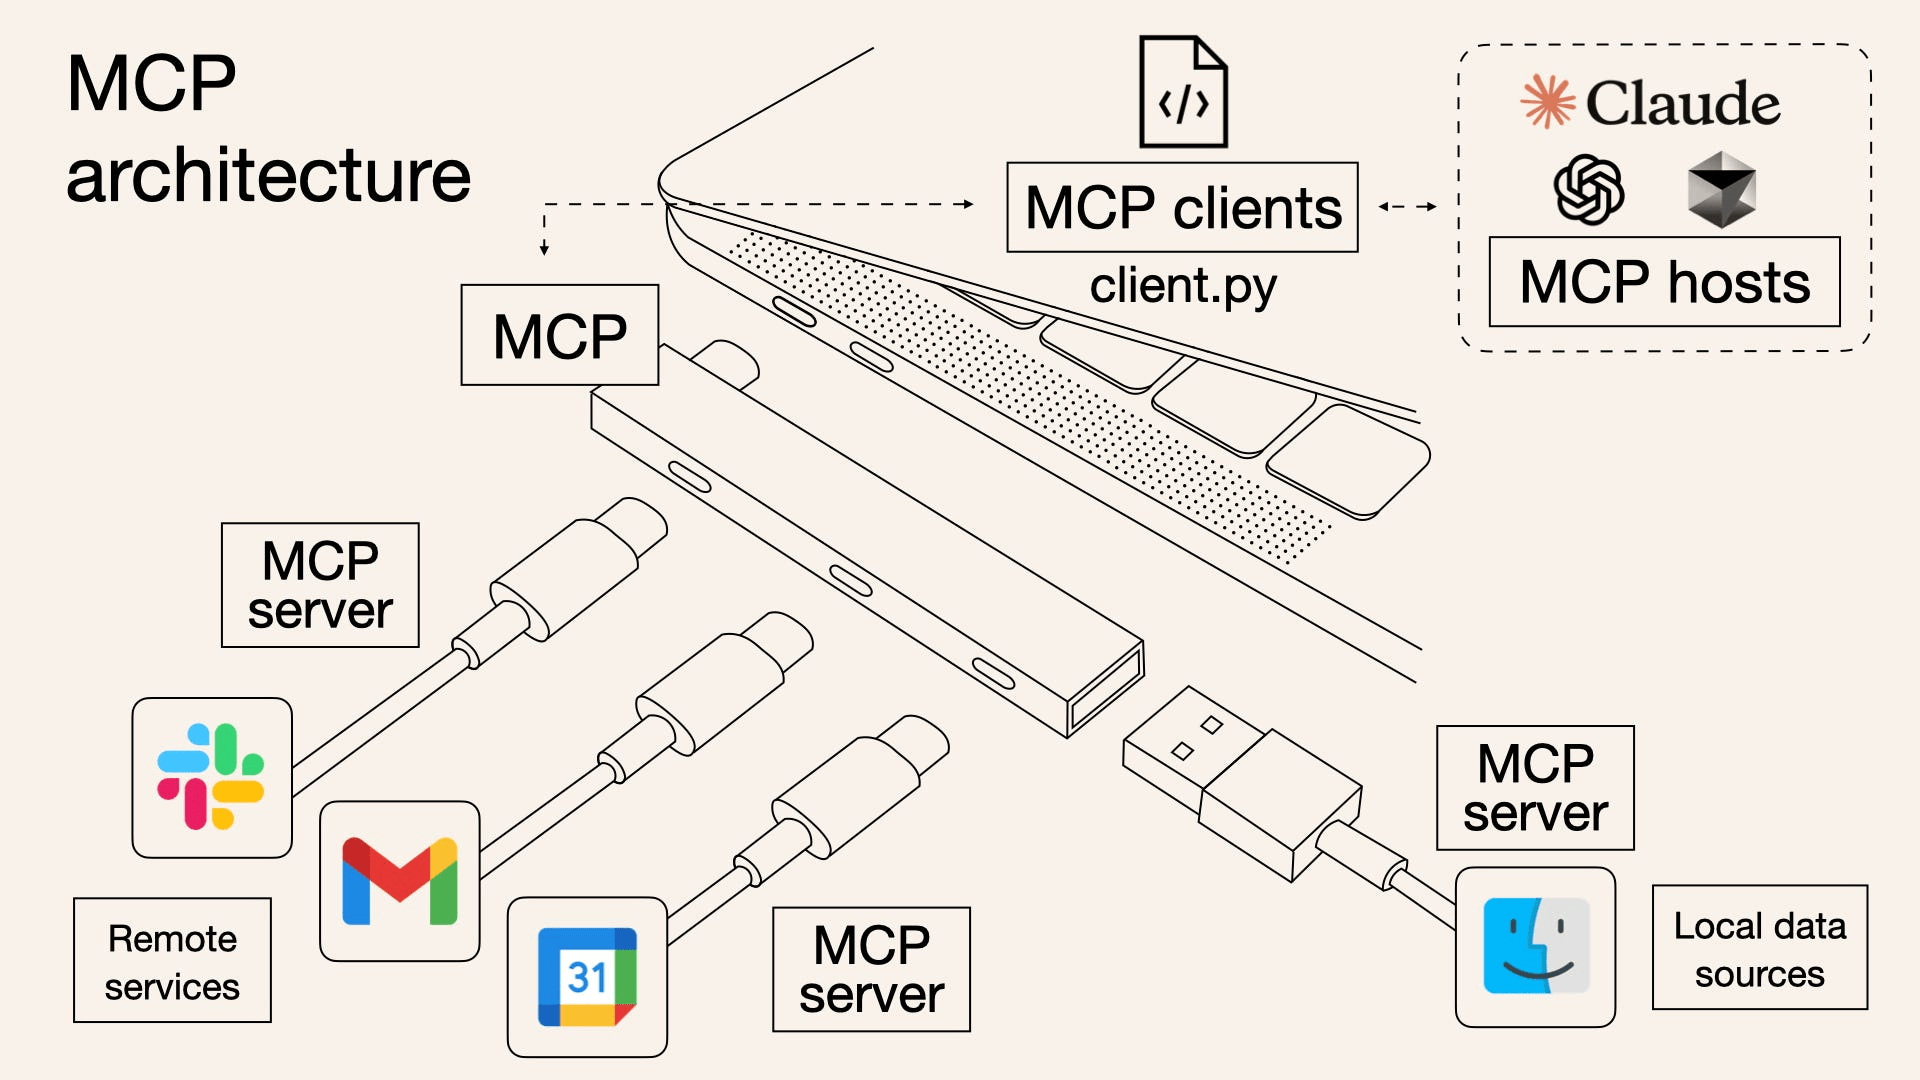
模型上下文协议(Model Context Protocol,MCP),是由Anthropic推出的开源协议,旨在实现大语言模型与外部数据源和工具的集成,用来在大模型和数据源之间建立安全双向的连接。
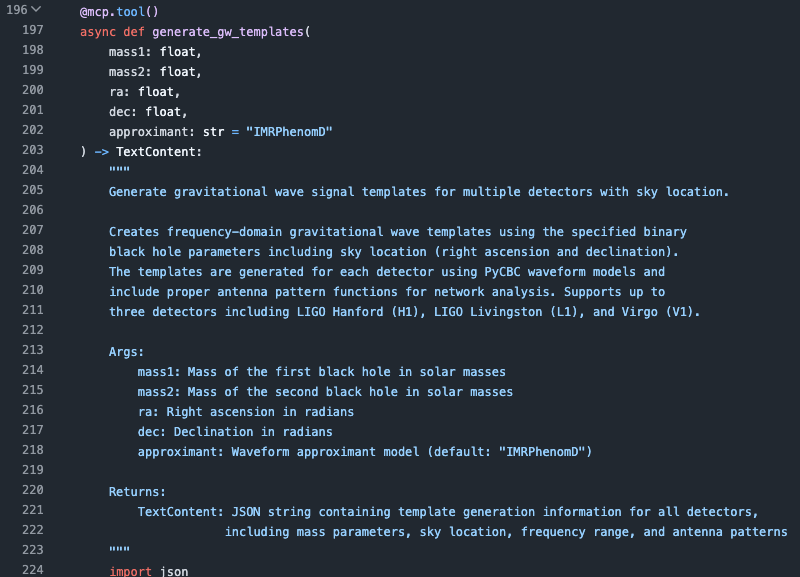
MCP Tool
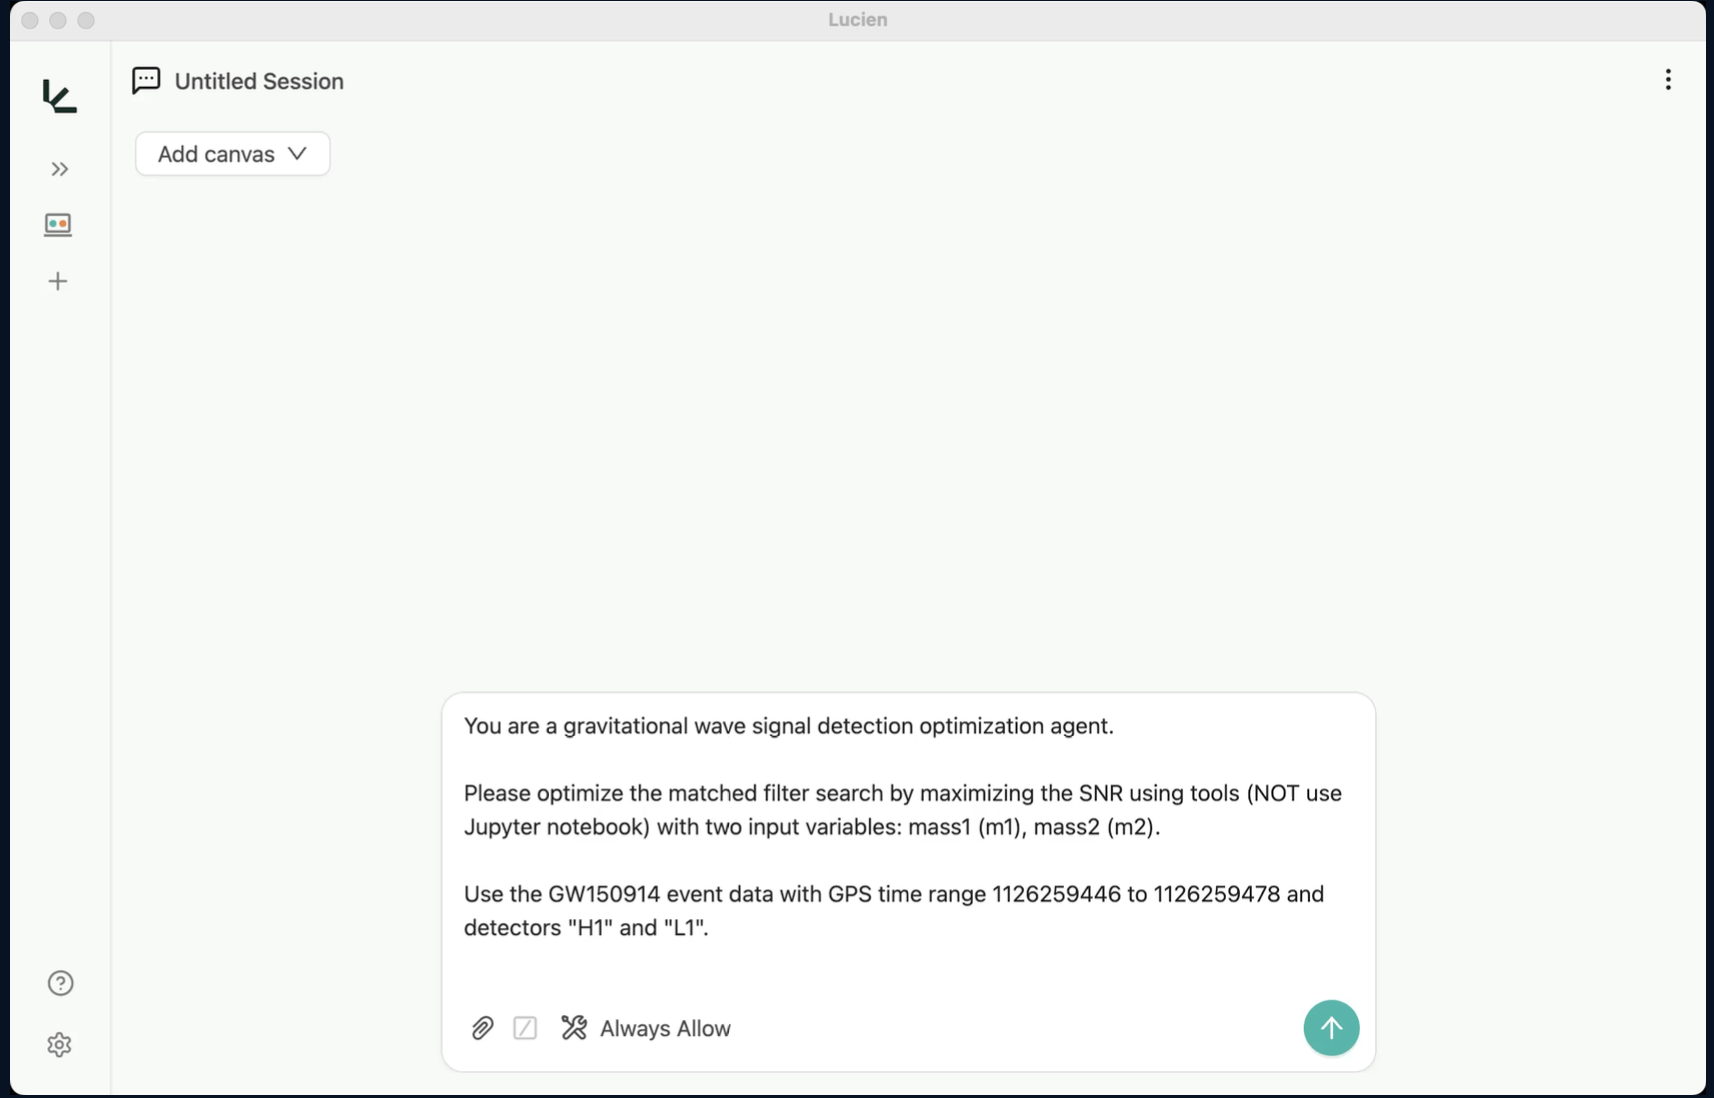
prompt
"Please generate gw templates first."Demo: GW150914 MCP Signal Search
这个地方应该把MCP tool skill讲清楚
大语言模型到底为何如此颠覆? — ③ Programmability
From explicit rules to natural-language control
if chi_square > 10:
    rerun_analysis()
Traditional Programming
Program the condition
LLM Programming
Describe the condition
if LLM(
    """
    Given the diagnostic plots, residuals,
    logs, and previous runs:
    does this result show evidence of
    a meaningful model-data mismatch
    that warrants another analysis?
    """
):
    rerun_analysis()
以前
condition必须是一个程序员提前定义好的数值判据。
现在 condition 可以是对文本、图像、日志、上下文甚至科研语义的综合判断。
当可编程模型接上工具、状态与反馈循环,才开始形成 Agent 系统。
从一句指令,到一次可检查的执行
Skill、MCP、Tool:一个任务是怎样被完成的
同一句话,背后其实是一个多步任务
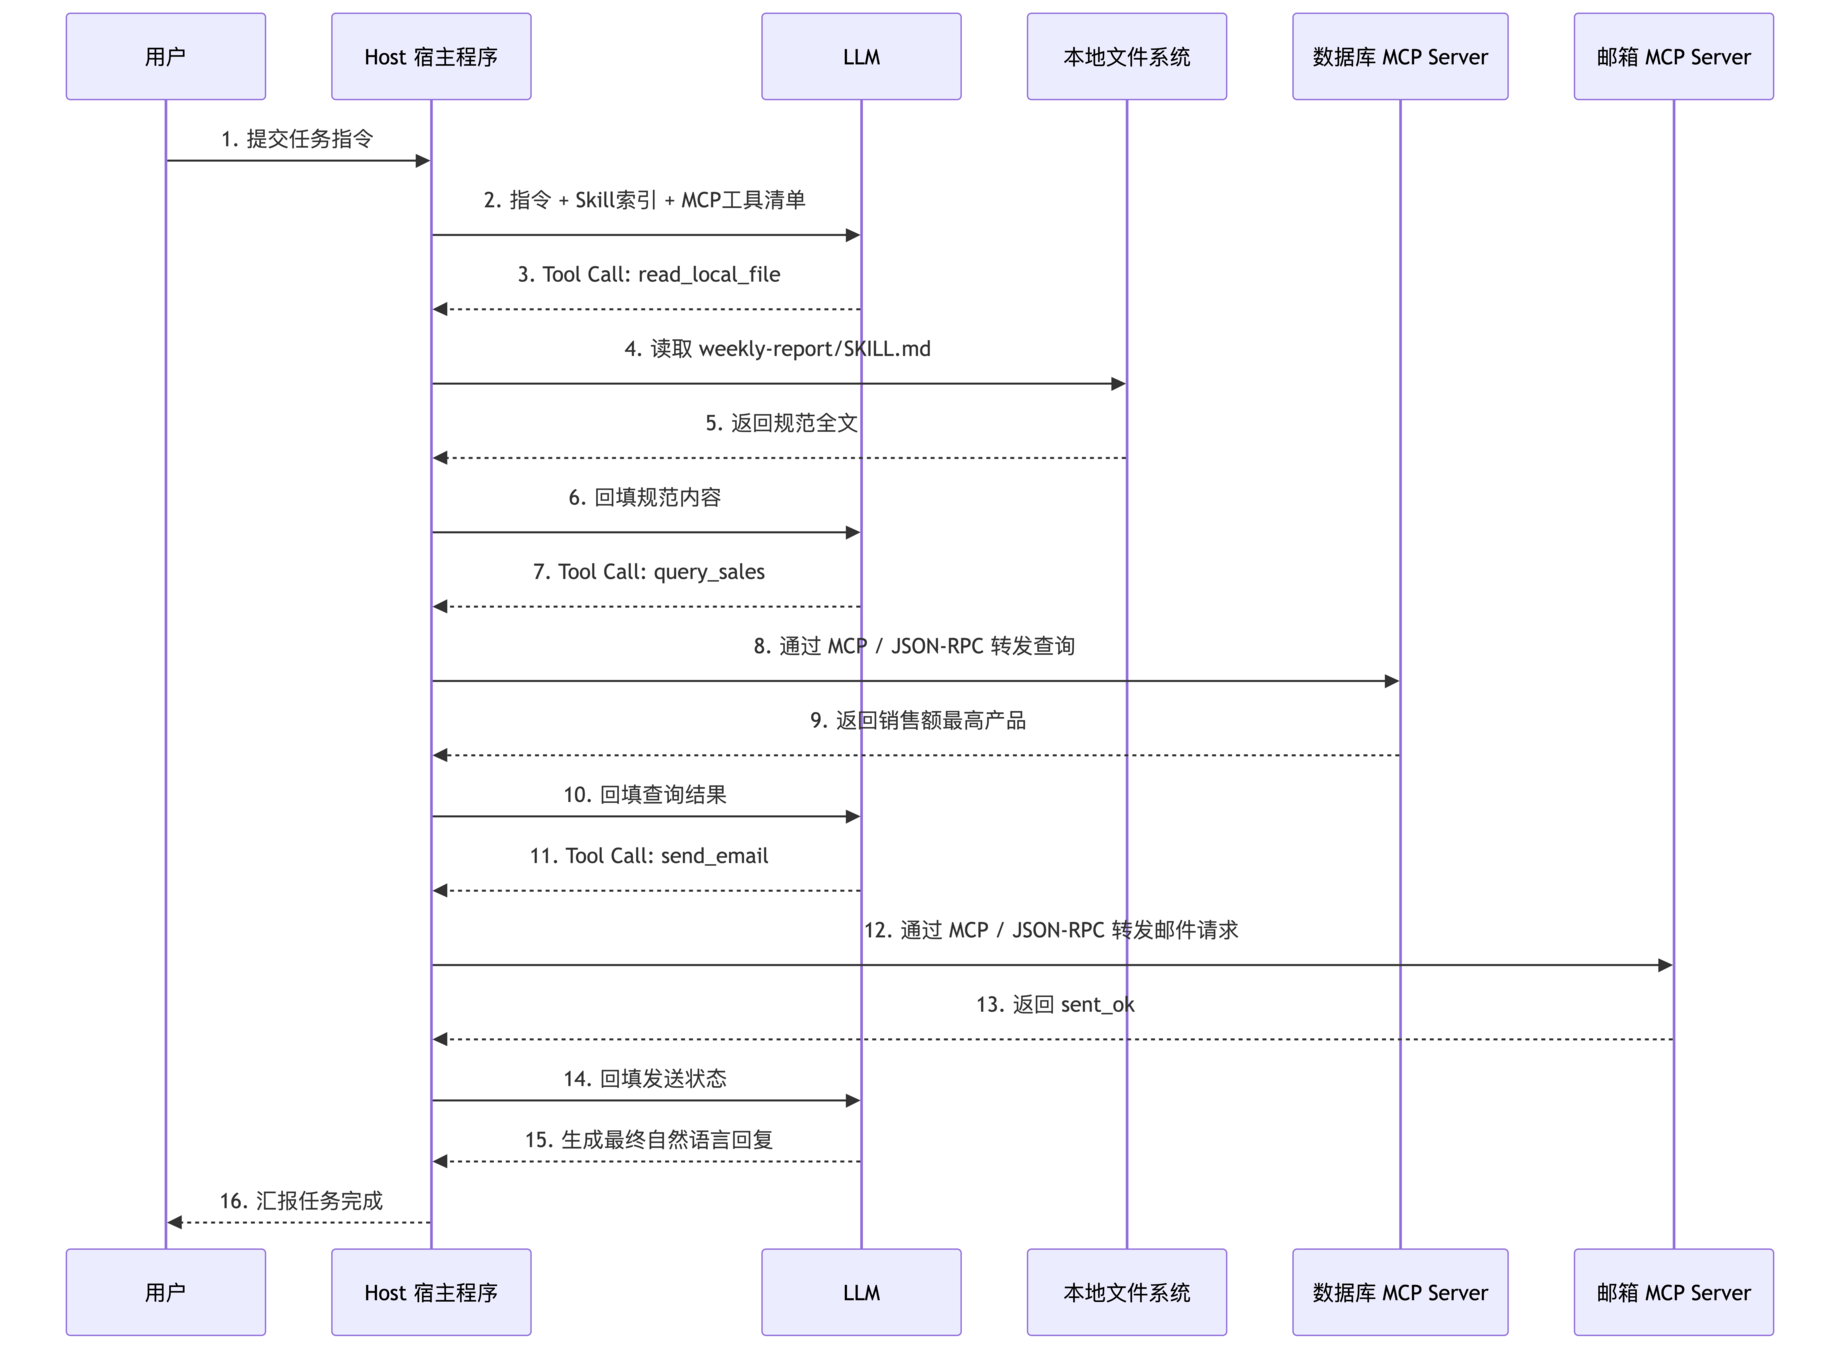
“帮我查一下今天销售额最高的产品,并按公司周报规范发给老板。”
- 找到今日销售额最高的产品
- 遵循公司周报规范
- 将结果发送给指定收件人
-
Skill|工作说明书
规定任务顺序、格式、约束和完成标准。
-
Tool|可调用动作 (Function Calling)
模型提交结构化参数,宿主程序负责执行。
-
MCP|标准化连接器协议
让宿主程序能够发现并调用数据库、邮箱等外部服务。
Skill、Tool、MCP 分别解决什么问题?
Skill、Tool、MCP 分别解决什么问题?
模型输出的是一次结构化 Tool Call,不是 Tool 本身。
(Function Calling (2023.6):首批支持 GPT-4 和 GPT-3.5-turbo)

-
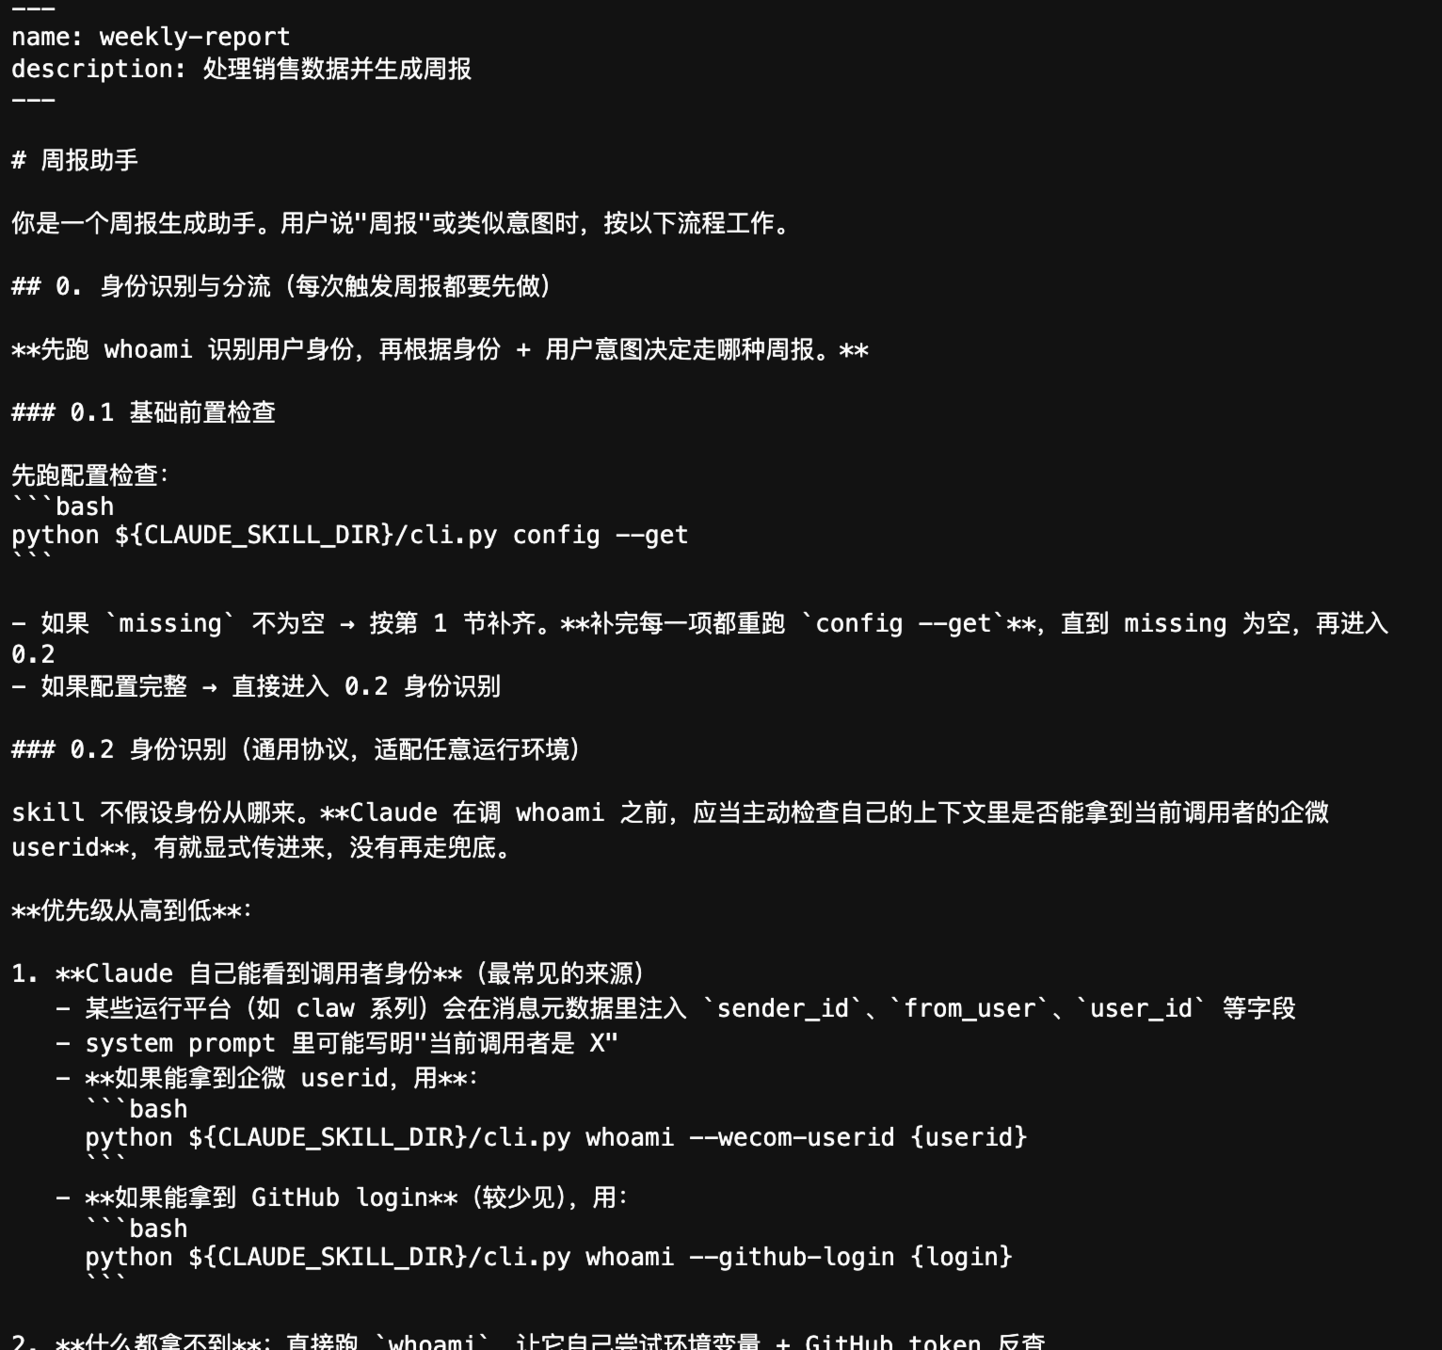
Skill(技能包):本地文件夹里有一个《电商运营周报规范》(weekly-report/SKILL.md),里面写着公司规定的汇报格式和老板的邮箱。
-
MCP Server(标准化连接器):你的电脑连接了两个 MCP 服务——一个连着公司数据库,一个连着企业邮箱。
-
Tool(底层工具):大模型原生具备调用工具的能力(比如读取本地文件、执行查询、发送邮件)。
逐步拆解:后台到底发生了什么?
第 0 步:启动准备(用户还没说话时)
-
扫描 Skill 文件夹:只读取每个 SKILL.md 最顶部的几行简介(节省 Token),记在小本本上:技能名:weekly-report,用途:处理销售数据并发送周报。
-
连接 MCP Server:向数据库 MCP 和邮箱 MCP 发送握手请求,拿到它们提供的工具说明书(包含工具名称、功能、需要什么参数)。
Function Calling =
工具调用训练 + 工具 schema + 结构化输出约束
Skill:weekly-report
用途:处理销售数据并生成周报

MCP 工具:
query_sales
send_email
第 1 回合:先加载规范
-
宿主发给大模型:把你的指令,连同刚刚收集的“Skill 简介”和“MCP 工具清单”打包发给大模型。
-
大模型思考与输出:大模型发现你的任务符合 weekly-report 技能的描述,但它还不知道具体规范。于是它不输出人类语言,而是吐出一段 JSON 指令。 - 宿主执行与回填:宿主程序拦截到这段 JSON,去本地硬盘把
SKILL.md的完整内容读出来,然后原封不动地喂回给大模型。
{
  "tool_call": "read_local_file",
  "arguments": {
    "path": "./skills/weekly-report/SKILL.md"
  }
}
1. 必须查询今日支付成功的订单;
2. 金额需保留两位小数;
3. 邮件标题格式为【销售快报】+日期,发送至 boss@company.com。
逐步拆解:后台到底发生了什么?
{
  "tool_call": "mcp_mysql_query_sales",
  "arguments": { "sql": "SELECT product, SUM(amount) FROM orders WHERE status='paid' AND date=TODAY() GROUP BY product ORDER BY 2 DESC LIMIT 1" }
}
{"product": "智能降噪耳机", "total": 128500.00}第 2 回合:通过 MCP 查询数据库
-
大模型思考与输出:大模型读完了操作手册,知道第一步要去查数据库。它查看工具清单,找到了数据库 MCP 提供的 query_sales 工具,于是再次输出 JSON: - 宿主通过 MCP 转发:宿主程序识别出这是
mysqlMCP 的工具,通过标准的 MCP 协议(JSON-RPC) 把请求发给数据库 MCP Server。 - 执行与回填:数据库 MCP Server 连上真实数据库执行 SQL,拿到 结果,通过协议传回宿主程序,宿主程序再喂给大模型。
[
  {
    "role": "user",
    "content": "帮我查一下今天销售额最高的产品,并按公司周报规范发给老板。"
  },
  {
    "role": "assistant",
    "tool_call": "read_local_file"
  },
  {
    "role": "tool",
    "content": "SKILL.md 的规范全文…… 1. 必须查询今日支付成功的订单;2. 金额需保留两位小数;3. 邮件标题格式为【销售快报】+日期,发送至 boss@company.com。"
  }
]
回填内容可能是:
- 原始文件文本
- 结构化 JSON
- 工具执行状态
- 错误信息
- 经过摘要、过滤或权限处理后的结果
Host 将工具结果回填为新的上下文消息,再交给 LLM 决定下一步。
逐步拆解:后台到底发生了什么?
{
  "tool_call": "mcp_mysql_query_sales",
  "arguments": { "sql": "SELECT product, SUM(amount) FROM orders WHERE status='paid' AND date=TODAY() GROUP BY product ORDER BY 2 DESC LIMIT 1" }
}
{
"tool_call": "mcp_email_send",
"arguments": {
"to": "boss@company.com",
"subject": "【销售快报】2026-11-17",
"body": "老板好,今日销售额最高的产品为:智能降噪耳机,累计成交金额 128500.00 元。"
}
}
第 2 回合:通过 MCP 查询数据库
-
大模型思考与输出:大模型读完了操作手册,知道第一步要去查数据库。它查看工具清单,找到了数据库 MCP 提供的 query_sales 工具,于是再次输出 JSON: - 宿主通过 MCP 转发:宿主程序识别出这是
mysqlMCP 的工具,通过标准的 MCP 协议(JSON-RPC) 把请求发给数据库 MCP Server。 - 执行与回填:数据库 MCP Server 连上真实数据库执行 SQL,拿到 结果,通过协议传回宿主程序,宿主程序再喂给大模型。
第 3 回合:通过 MCP 协议发送邮件
-
大模型思考与输出:大模型拿到了数据,对照 SKILL.md 的要求检查了一遍(已支付、保留两位小数、收件人 boss@company.com),接着调用邮箱 MCP 提供的发邮件工具:
- 宿主通过 MCP 转发:宿主程序通过 MCP 协议把请求交给邮箱 MCP Server。
- 执行与回填:邮箱 MCP Server 真正把邮件发了出去,返回 结果 给宿主程序,宿主程序最后一次喂给大模型。
{"product": "智能降噪耳机", "total": 128500.00}{"status": "sent_ok"} 逐步拆解:后台到底发生了什么?
最终步:结束循环,向你汇报
-
大模型看到所有步骤都已成功执行,不再输出 JSON 工具调用,而是生成一句 自然语言 回复你:
“已为您查询到今日销售额最高的产品是智能降噪耳机(128,500.00 元),并已严格按照《电商运营周报规范》发送邮件至 boss@company.com。”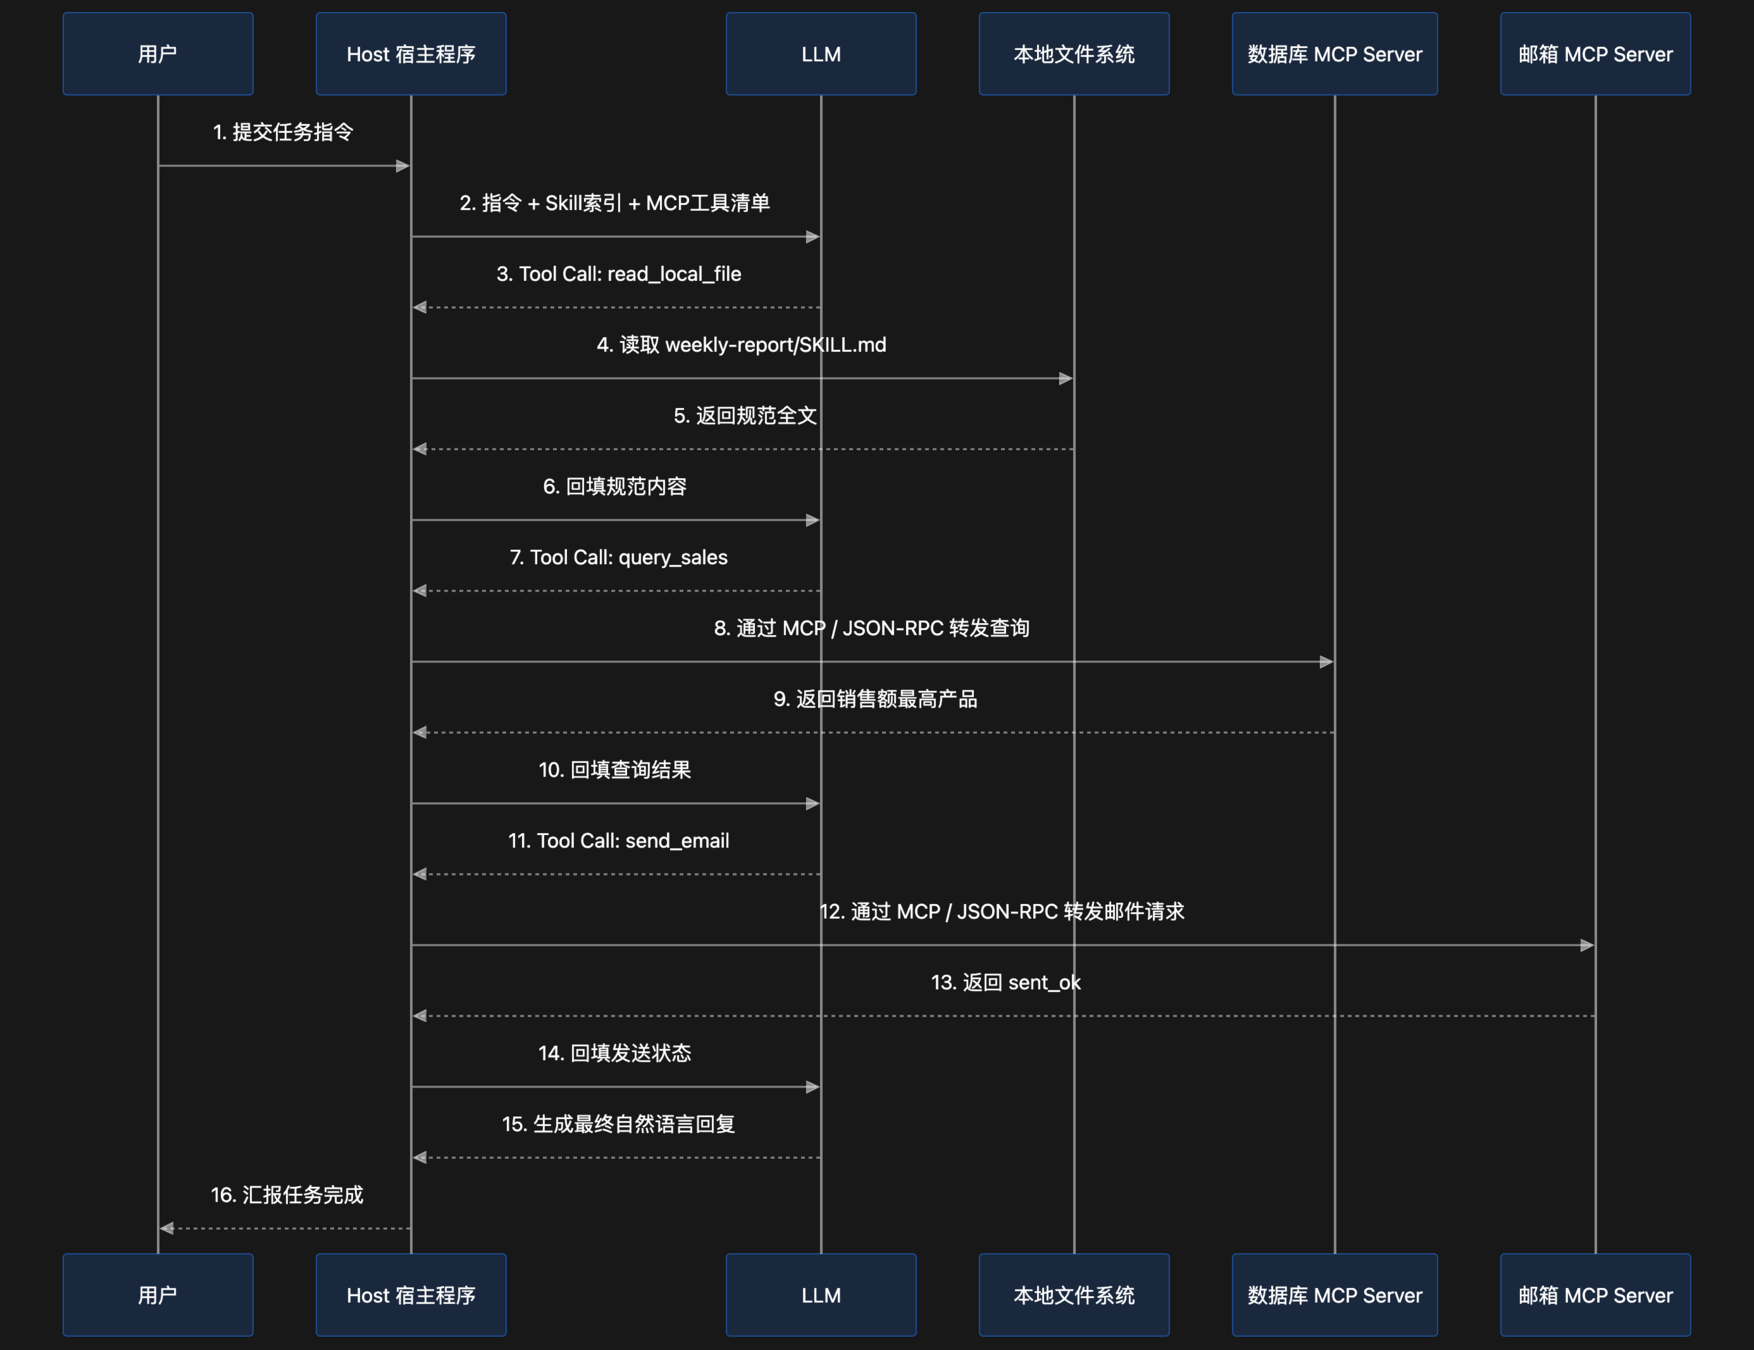
全景交互示意图
-
Host 让 LLM、Skill、Tool 和 MCP Server 形成可持续的执行循环。
同一个上下文,逐轮增长
-
每一回合,LLM 看到的上下文都变得更完整
Agent 不是一次生成答案,而是在目标、工具与反馈约束下反复决定下一步。
大模型开始被人们玩出花样
从工具调用到持续行动循环
From LLMs to Scientific Discovery
Generate → Observe → Act → Refine
One-shot generation → iterative interaction
An agent is not a new neural network. It is an LLM placed inside a loop.
直接不行?那就包装回炉再来一遍。
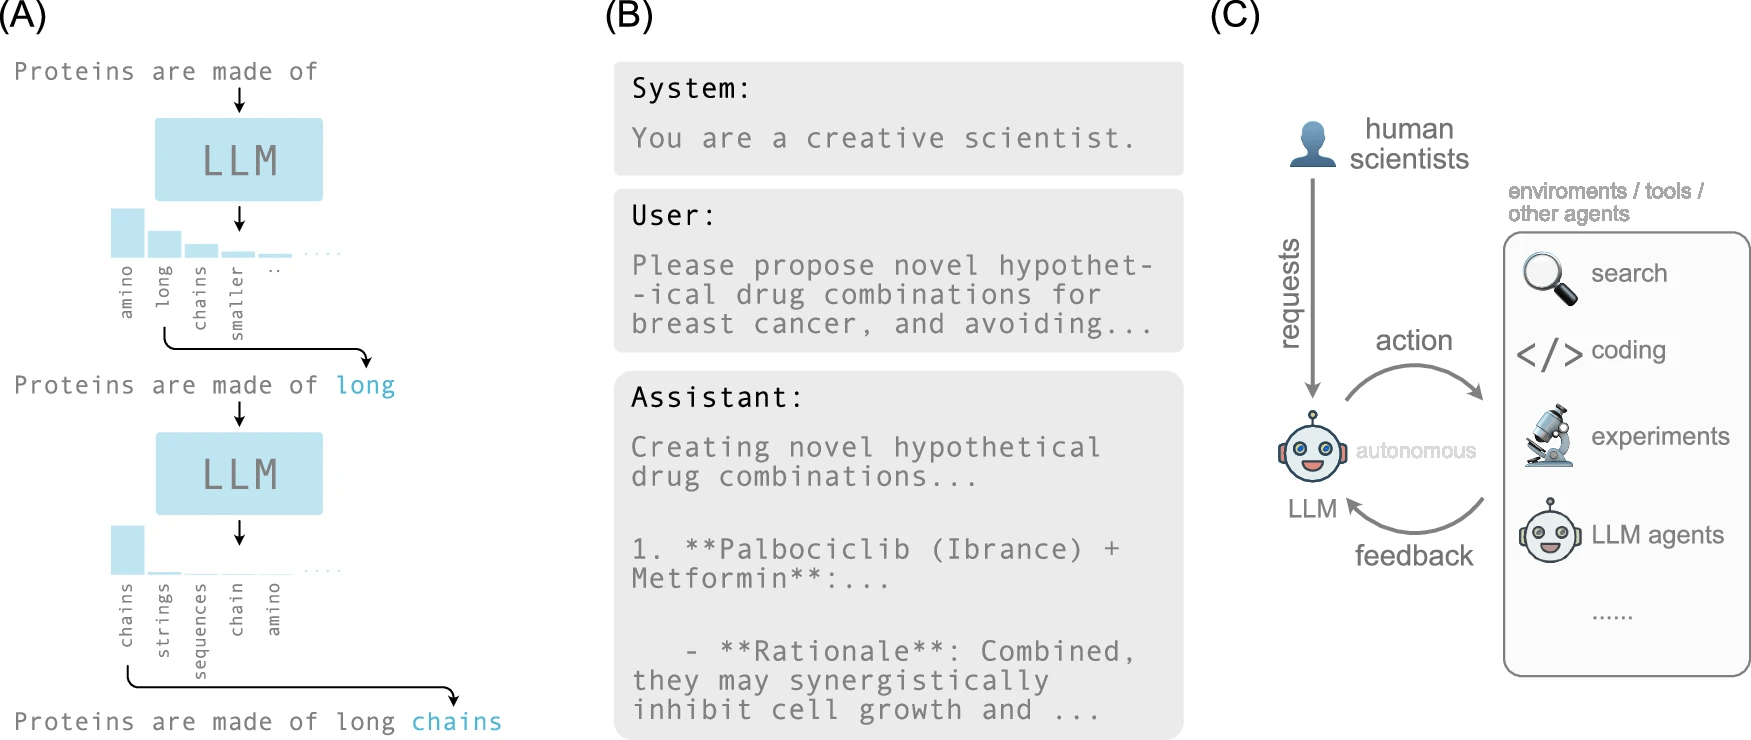
npj Artif. Intell. 1, 14 (2025).
"序列生成"
"序列输入"
"Direct fails. Refine and recover."
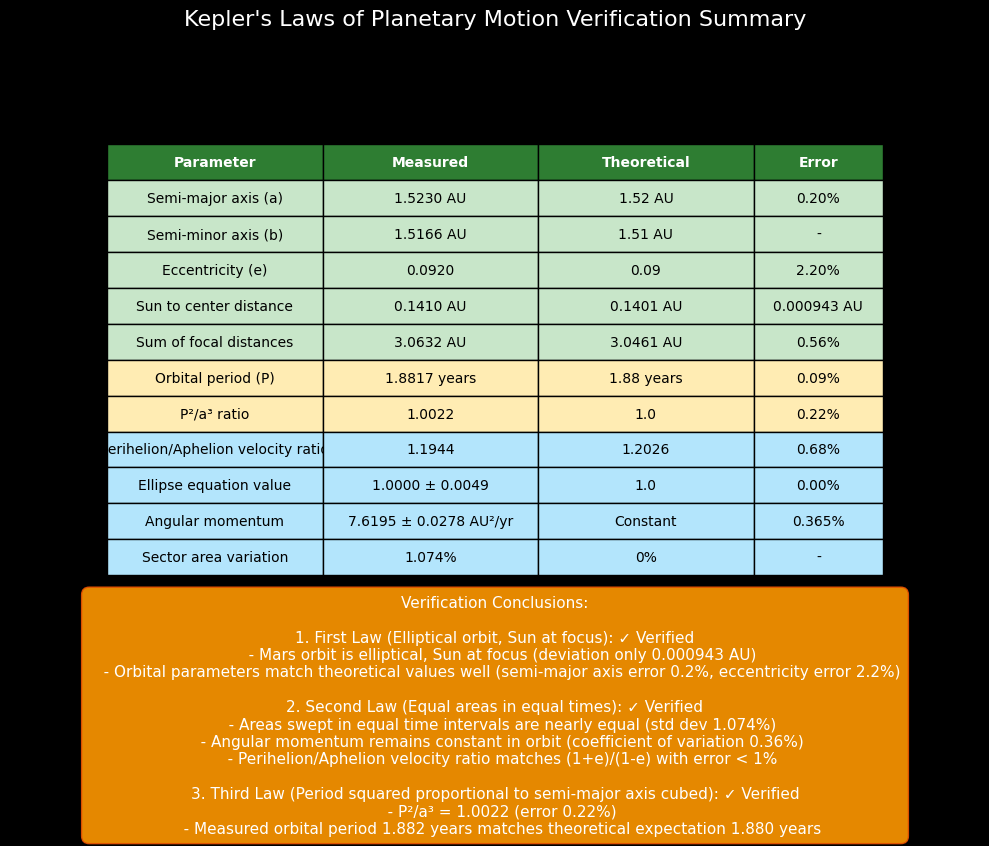
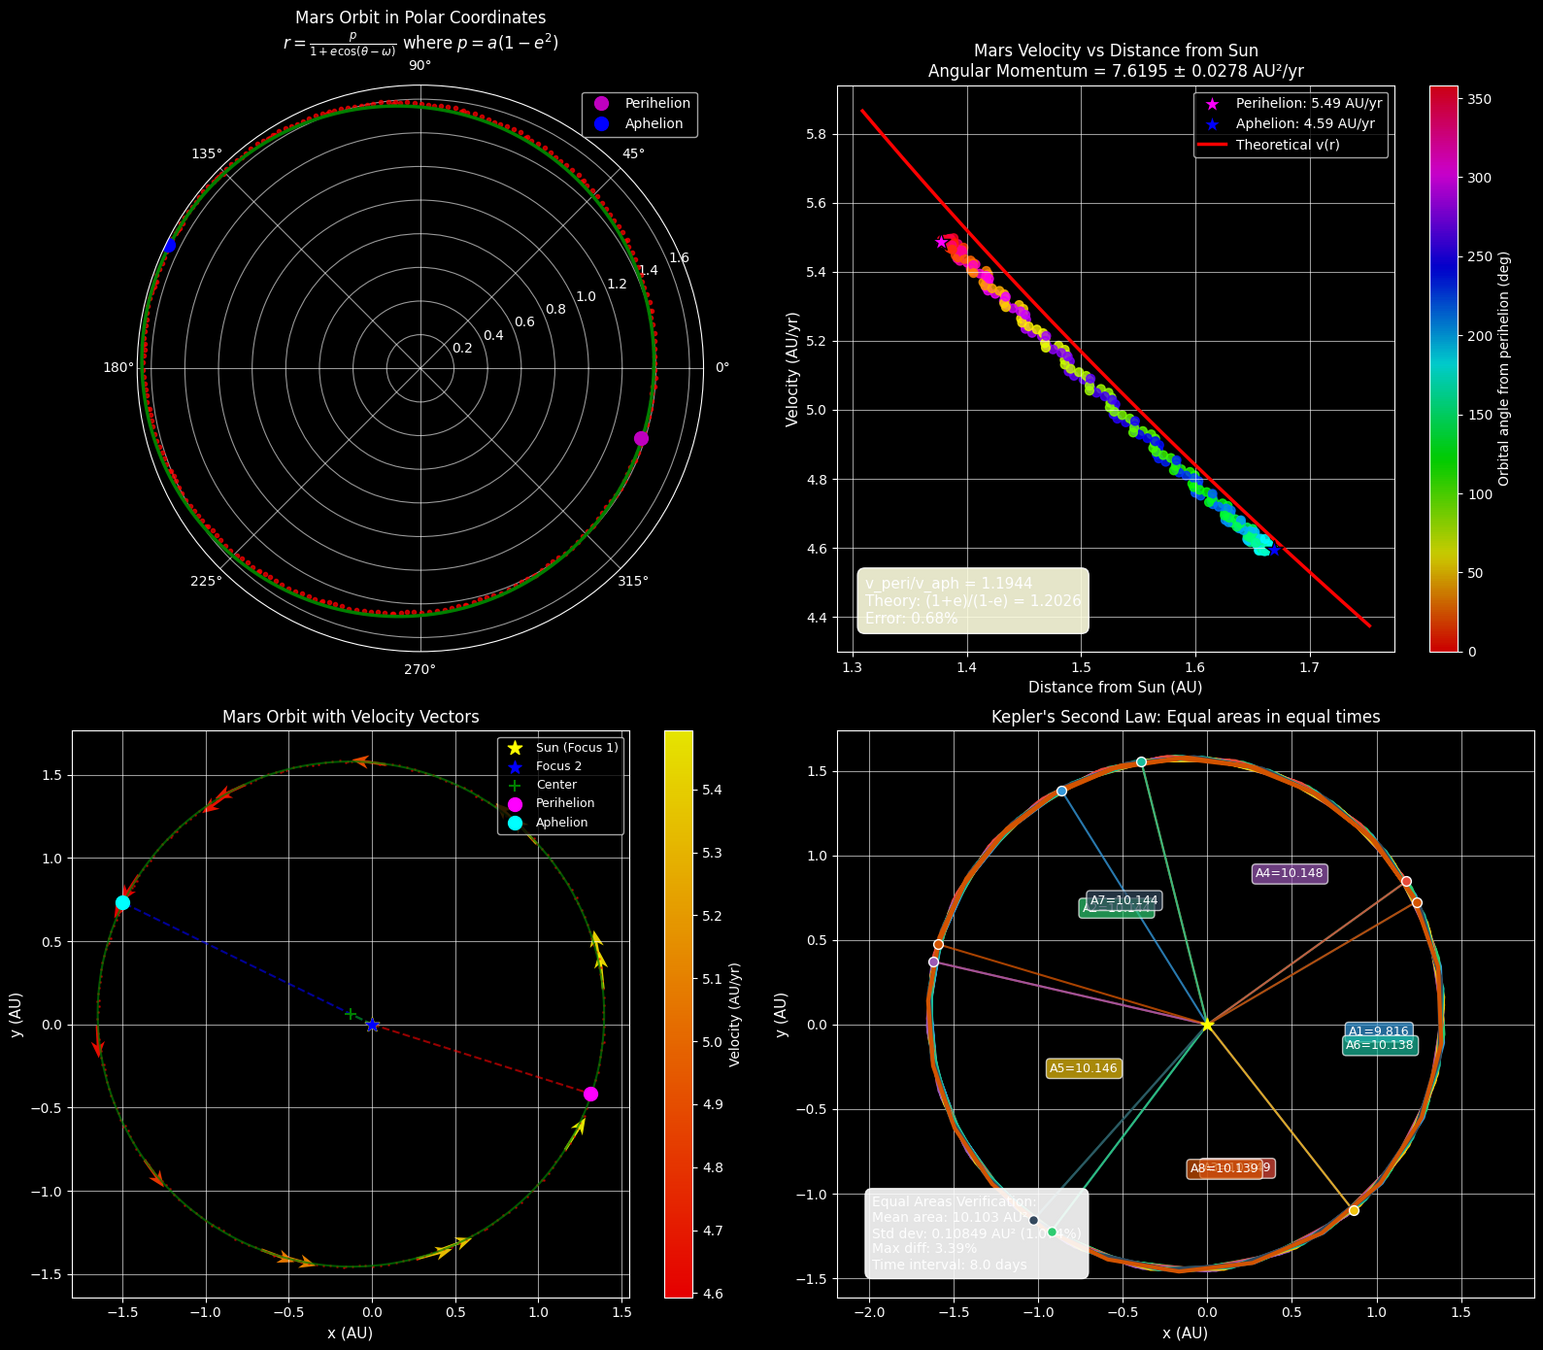
Demo: LLM 验证开普勒行星运动三定律
Agent 并不一定意味着我们发明了一个全新的模型。
很多时候,它只是把 LLM 放进了一个“观察—决策—行动—反馈”的循环里。
One-shot generation → iterative interaction
An agent is not a new neural network. It is an LLM placed inside a loop.
直接不行?那就包装回炉再来一遍。
npj Artif. Intell. 1, 14 (2025).
"序列生成"
"序列输入"
"Direct fails. Refine and recover."
From LLMs to Scientific Discovery
Generate → Observe → Act → Refine
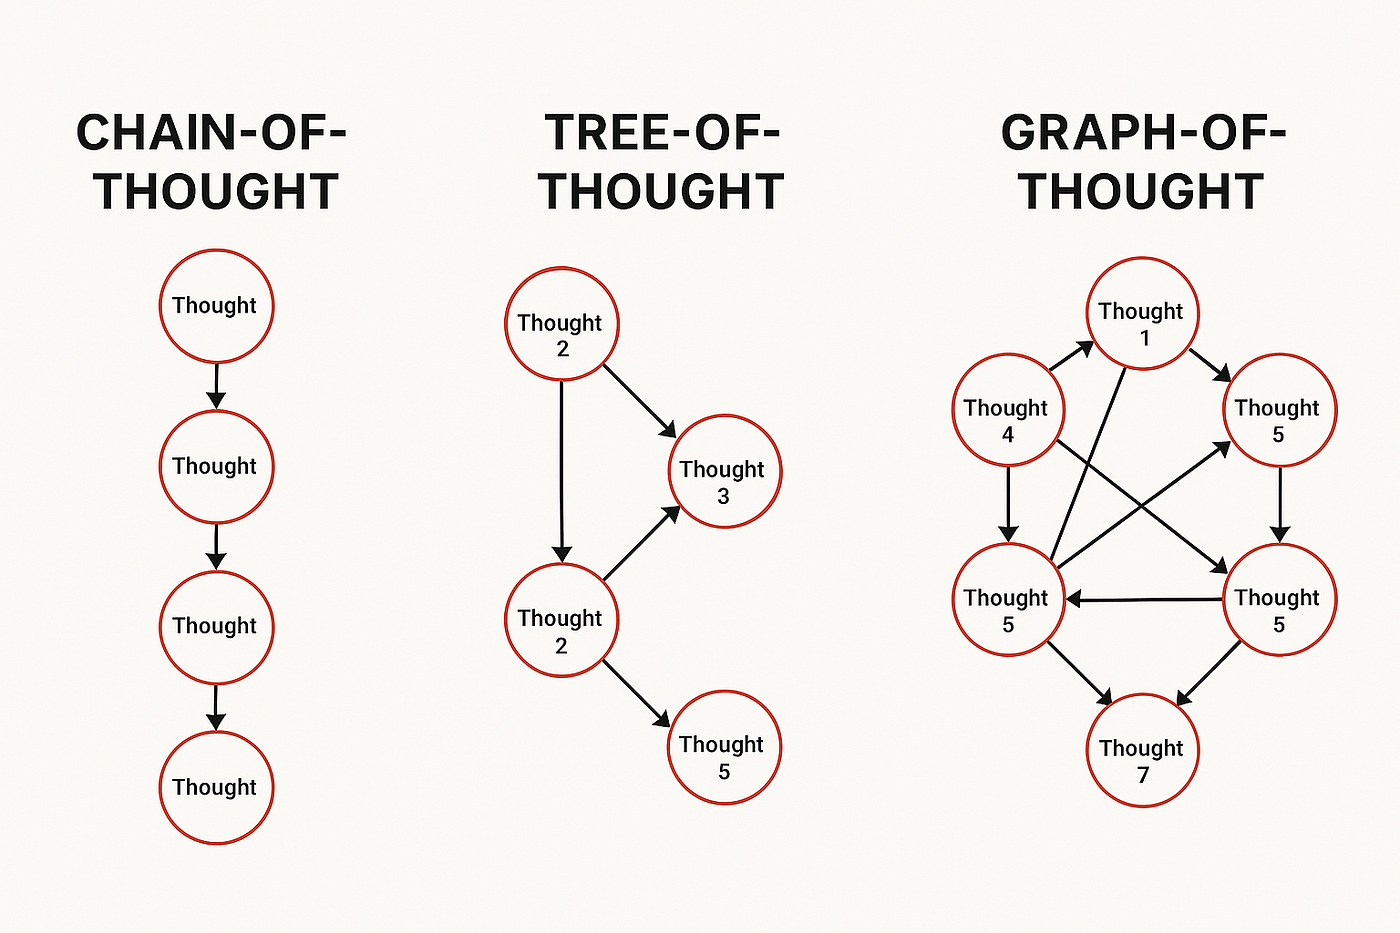
arXiv:2201.11903 [cs.CL]
arXiv:2305.10601 [cs.CL]
This is where test-time scaling begins to look like an agent.
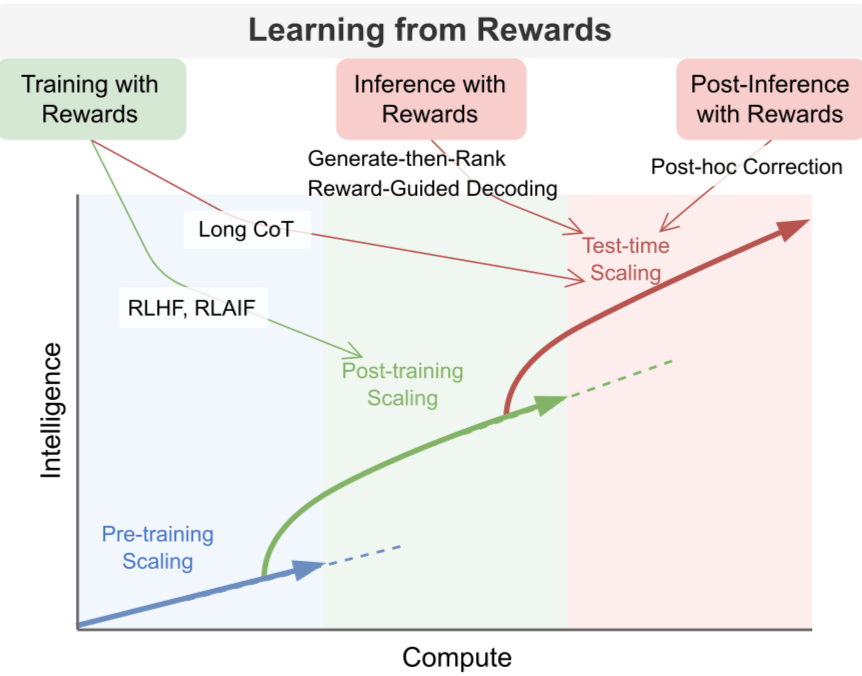
2020-era intuition
Pre-training scaling
\(\text{more parameters + data + compute}\)
→ build a stronger base model
↓
Then
Post-training scaling
\(\text{more post-training data + optimization / RL compute}\)
→ teach better behavior and reasoning
SFT · RLHF/RLAIF · RL for reasoning
↓
Now
Test-time scaling
\(\text{more inference compute per problem}\)
→ spend more compute on one problem
longer reasoning · multiple samples · search · verification
From Scaling to Agents
More compute, at different stages
📄 Google DeepMind: "Scaling LLM Test-Time Compute Optimally" (arXiv:2408.03314)
🔗 OpenAI: Learning to Reason with LLMs
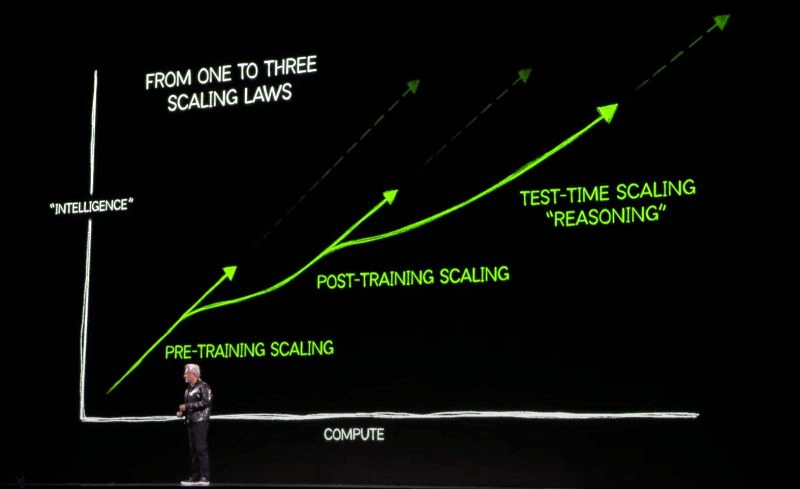
This is where test-time scaling begins to look like an agent.
2020-era intuition
Pre-training scaling
\(\text{more parameters + data + compute}\)
→ build a stronger base model
↓
Then
Post-training scaling
\(\text{more post-training data + optimization / RL compute}\)
→ teach better behavior and reasoning
SFT · RLHF/RLAIF · RL for reasoning
↓
Now
Test-time scaling
\(\text{more inference compute per problem}\)
→ spend more compute on one problem
longer reasoning · multiple samples · search · verification
From Scaling to Agents
More compute, at different stages
Post-training changes the model.
Agents change how the model is used at test time.
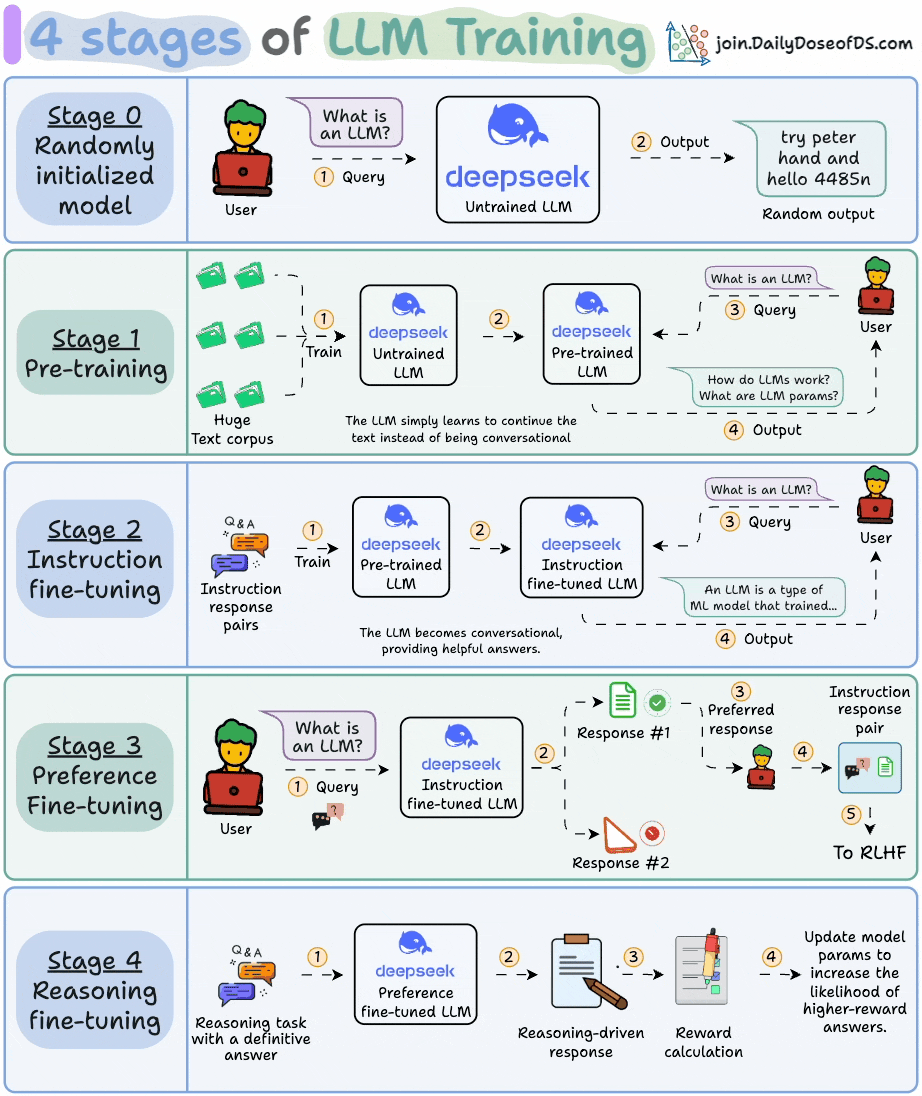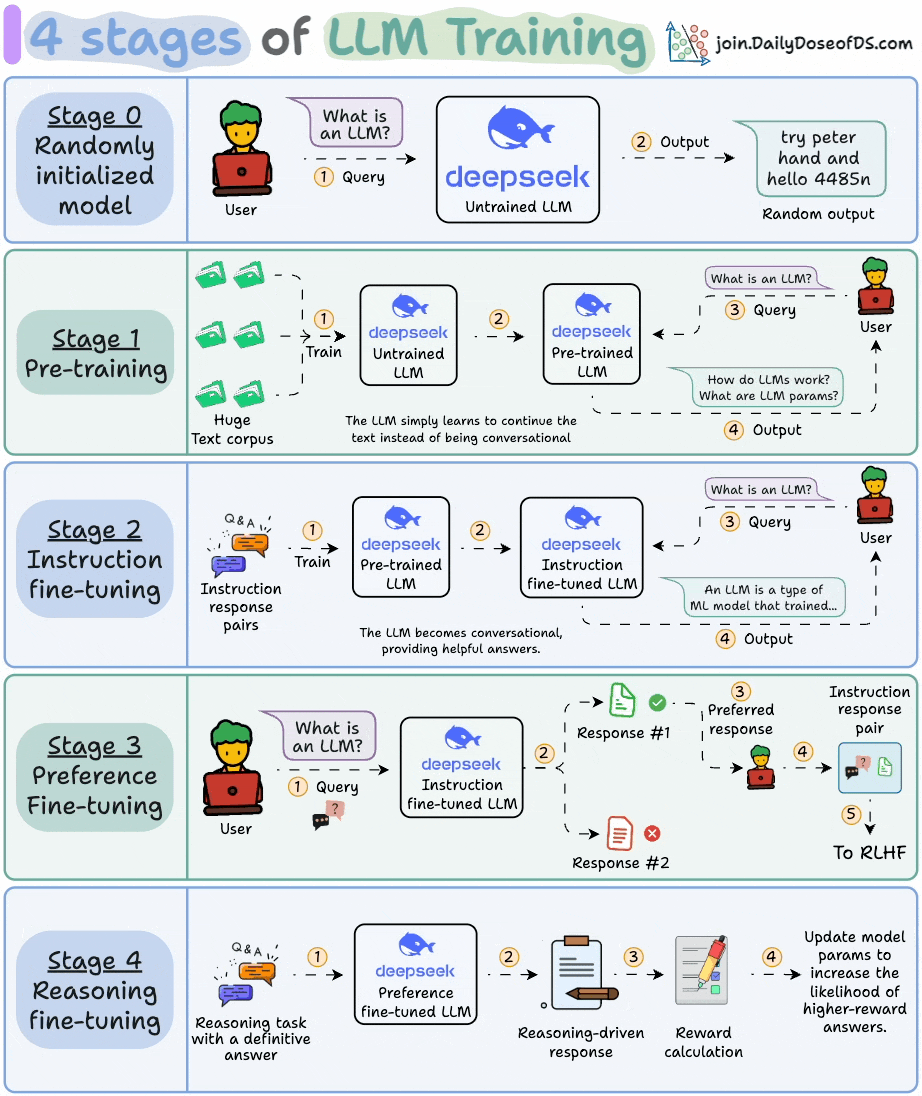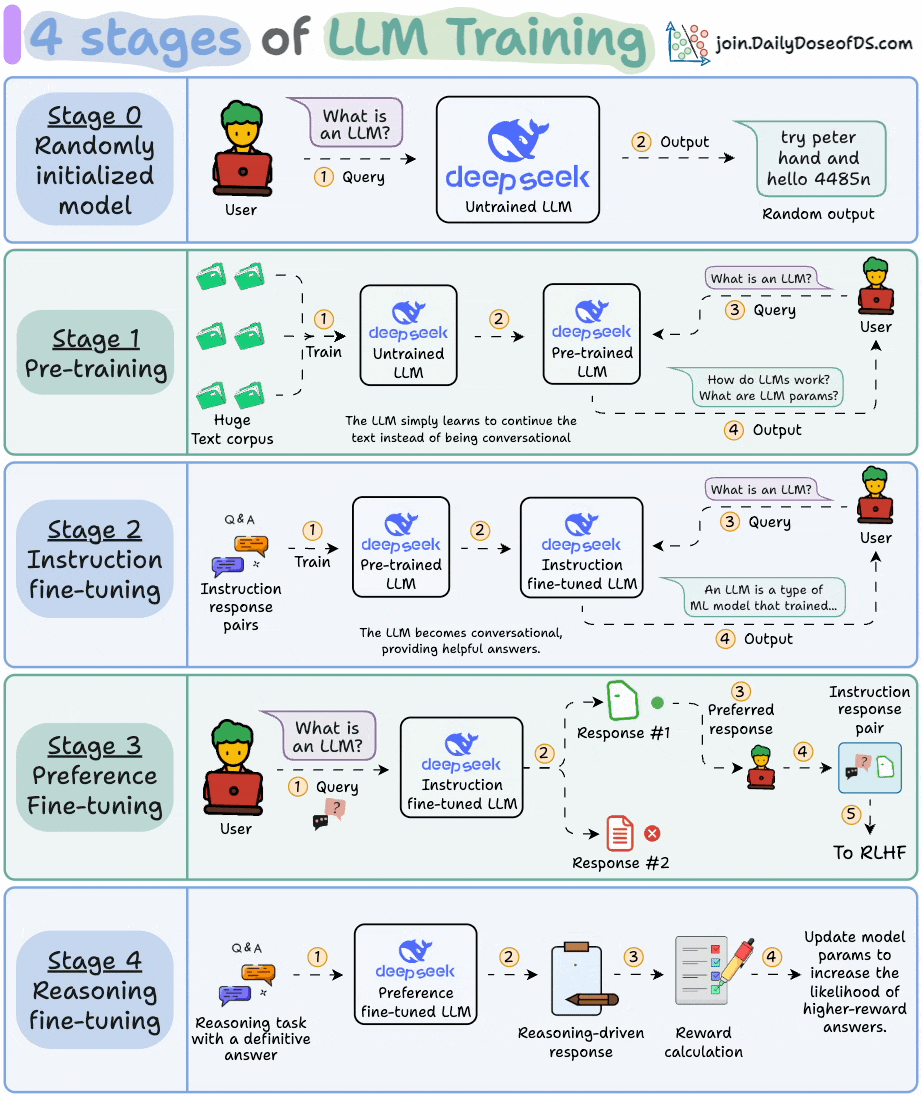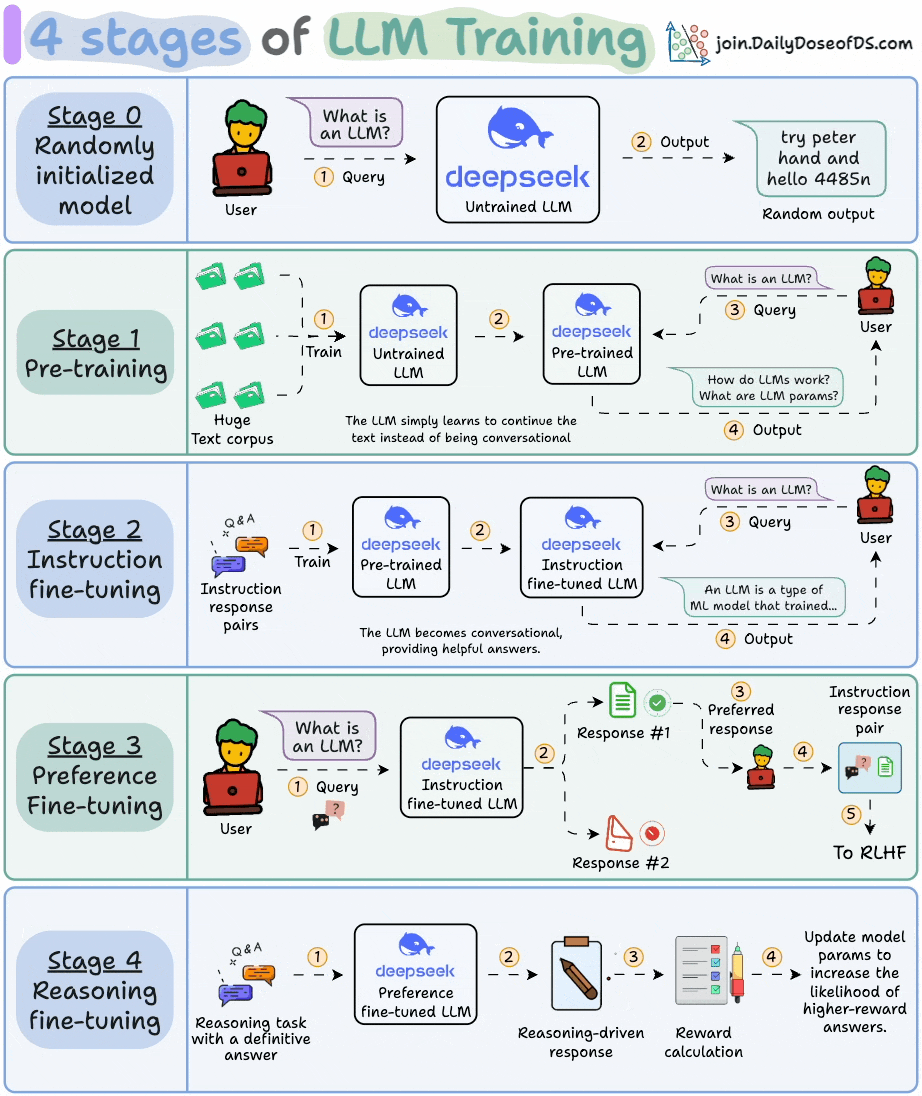
Before Agents: How an LLM Becomes Useful
Pre-train → Instruct → Align → Reason
Source: X
- Pre-training — learn to continue text
- Instruction tuning — learn to follow requests
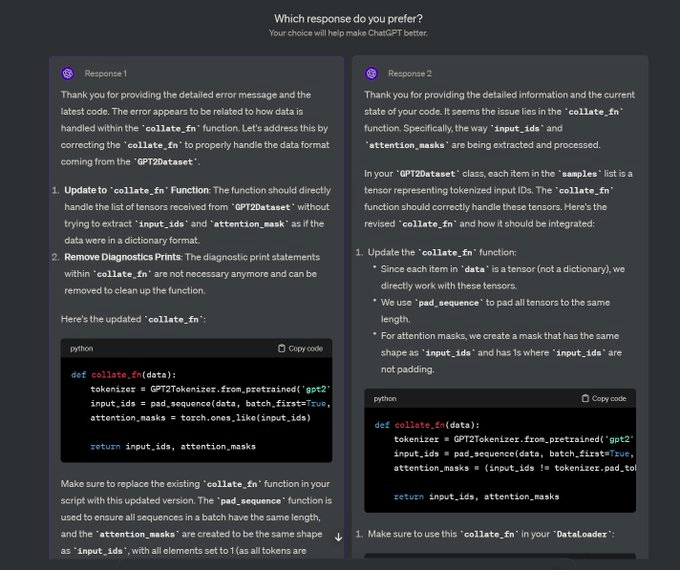
- Preference / RL post-training — learn what responses are preferred
- Reasoning training — learn better problem-solving policies
- The model generates an answer to a prompt.
- The answer is compared to the known correct answer.
- Based on the correctness, we assign a reward. (GRPO)
2023: Generative Agents
Put an LLM inside a world — and let it remember, plan, and act
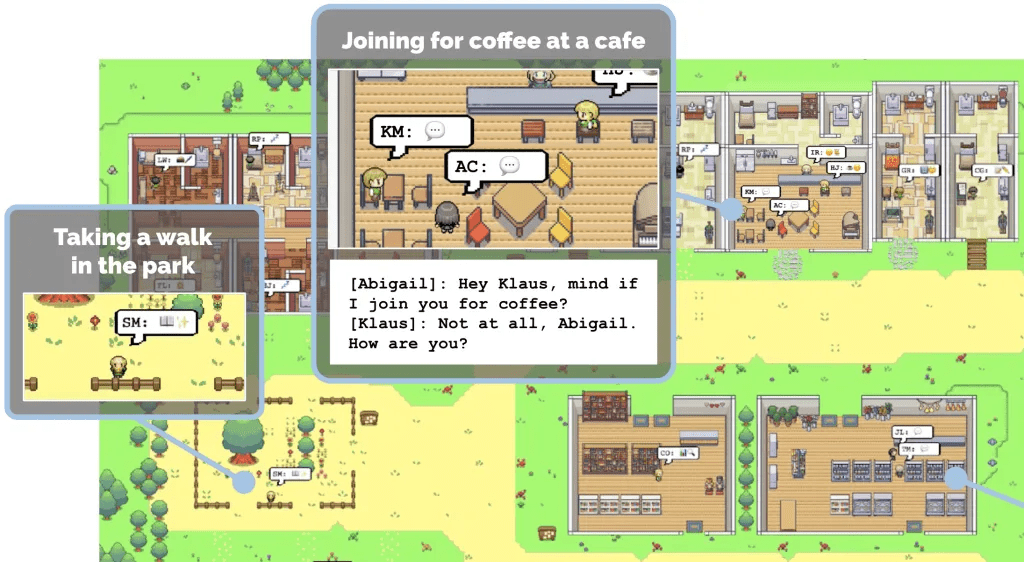
Generative behavior emerges inside a carefully engineered rule scaffold. 🤫
arXiv:2304.03442 [cs.HC]
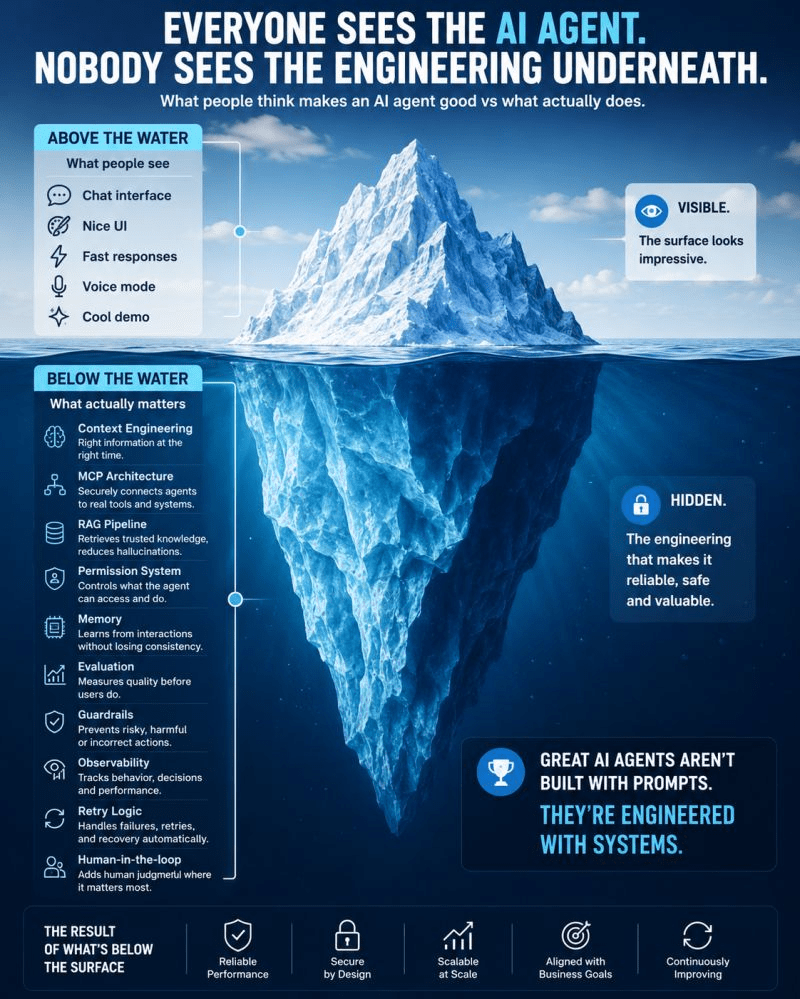
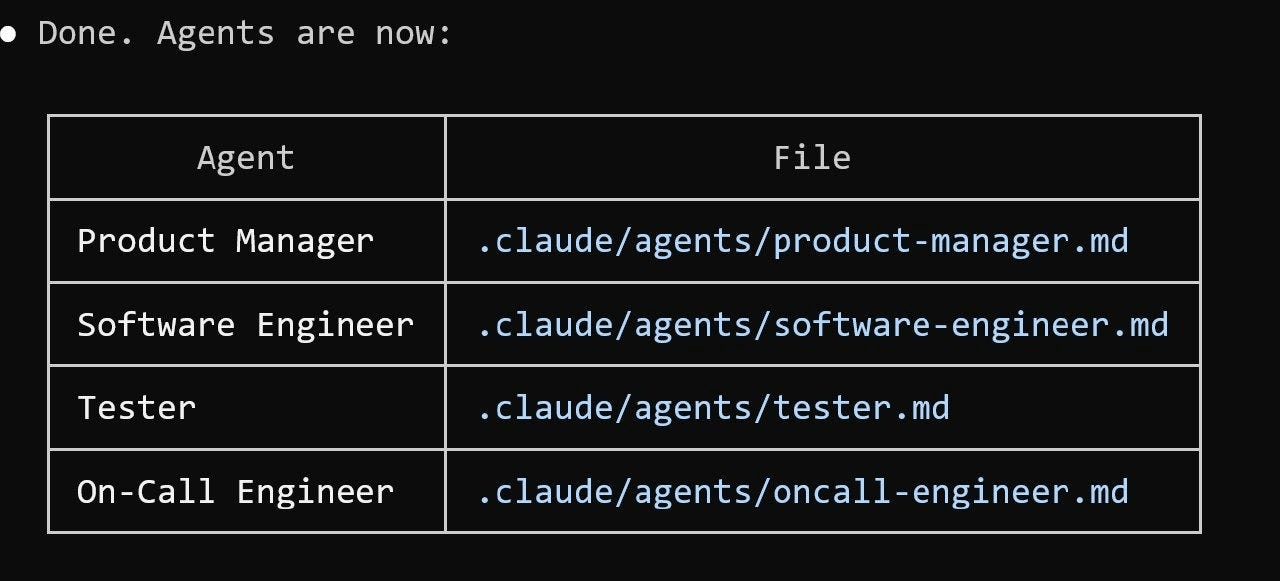
Source: X
这是社会模拟案例,
不等于科学发现系统。
发现对谁是新的?是否可验证?能否迁移?
大模型到底能发现新知识吗?
FunSearch: LLM-Guided Search in Program Space
Search for programs that solve the problem, not for the solution itself.
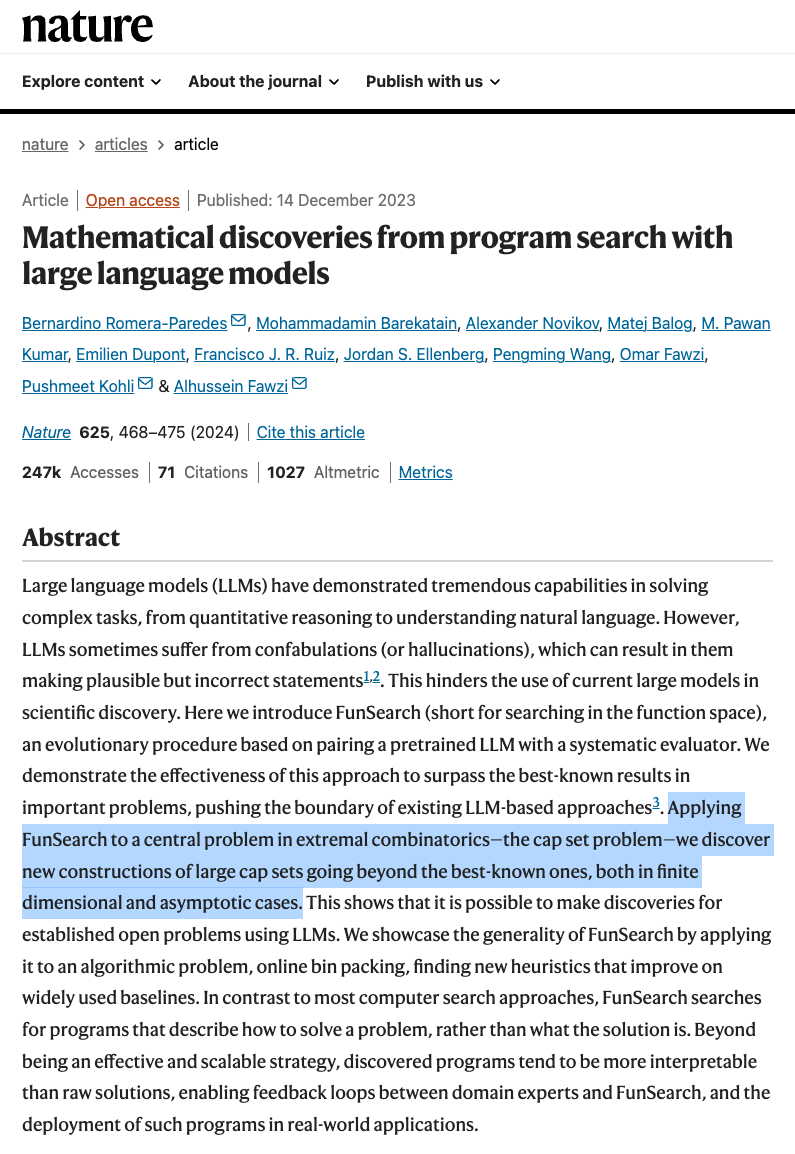
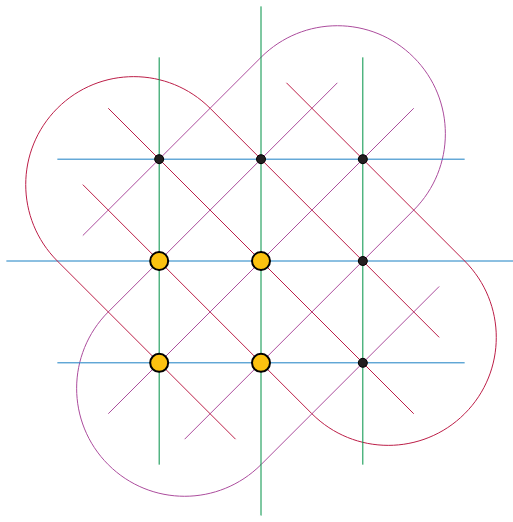
Illustrative example of bin packing using existing heuristic – Best-fit heuristic (left), and using a heuristic discovered by FunSearch (right).
DeepMind Blog (Source)
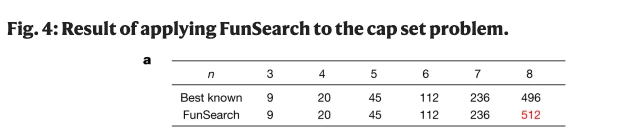
Cap Set Problem
- 给定一个N,求维度为N的网格里面最大能找到多少个点,这些点中任意三个点都不能连成一条直线。
Bin Packing Problem
- 如何在线将不同尺寸的物品装入最少数量的箱子中。
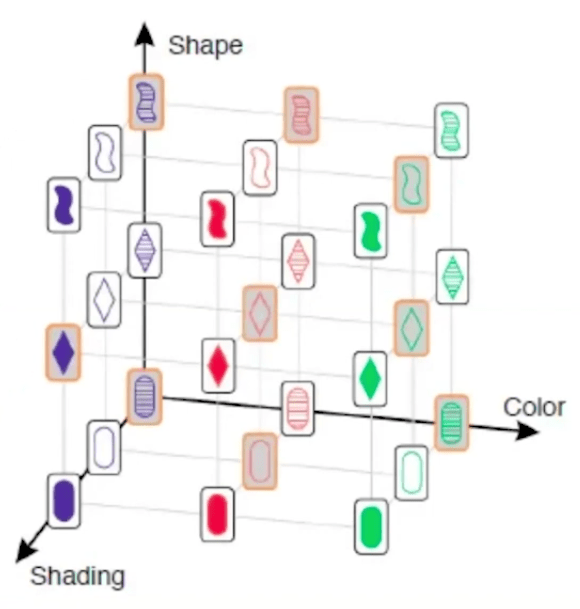
The largets cap set in N=2 has size 4.
The largest cap set in N=3 has size 9 > \(2^3\)
For N > 6, the size of the largest cap set is unknown.
FunSearch: LLM-Guided Search in Program Space
Search for programs that solve the problem, not for the solution itself.
Real-world Case: FunSearch (Nature, 2023)
- LLM + evaluator + evolutionary loop
- Cap set: new constructions beyond previous best-known results
- Online bin packing: improved heuristics over established baselines
- Key idea: discoveries are executable and verifiable
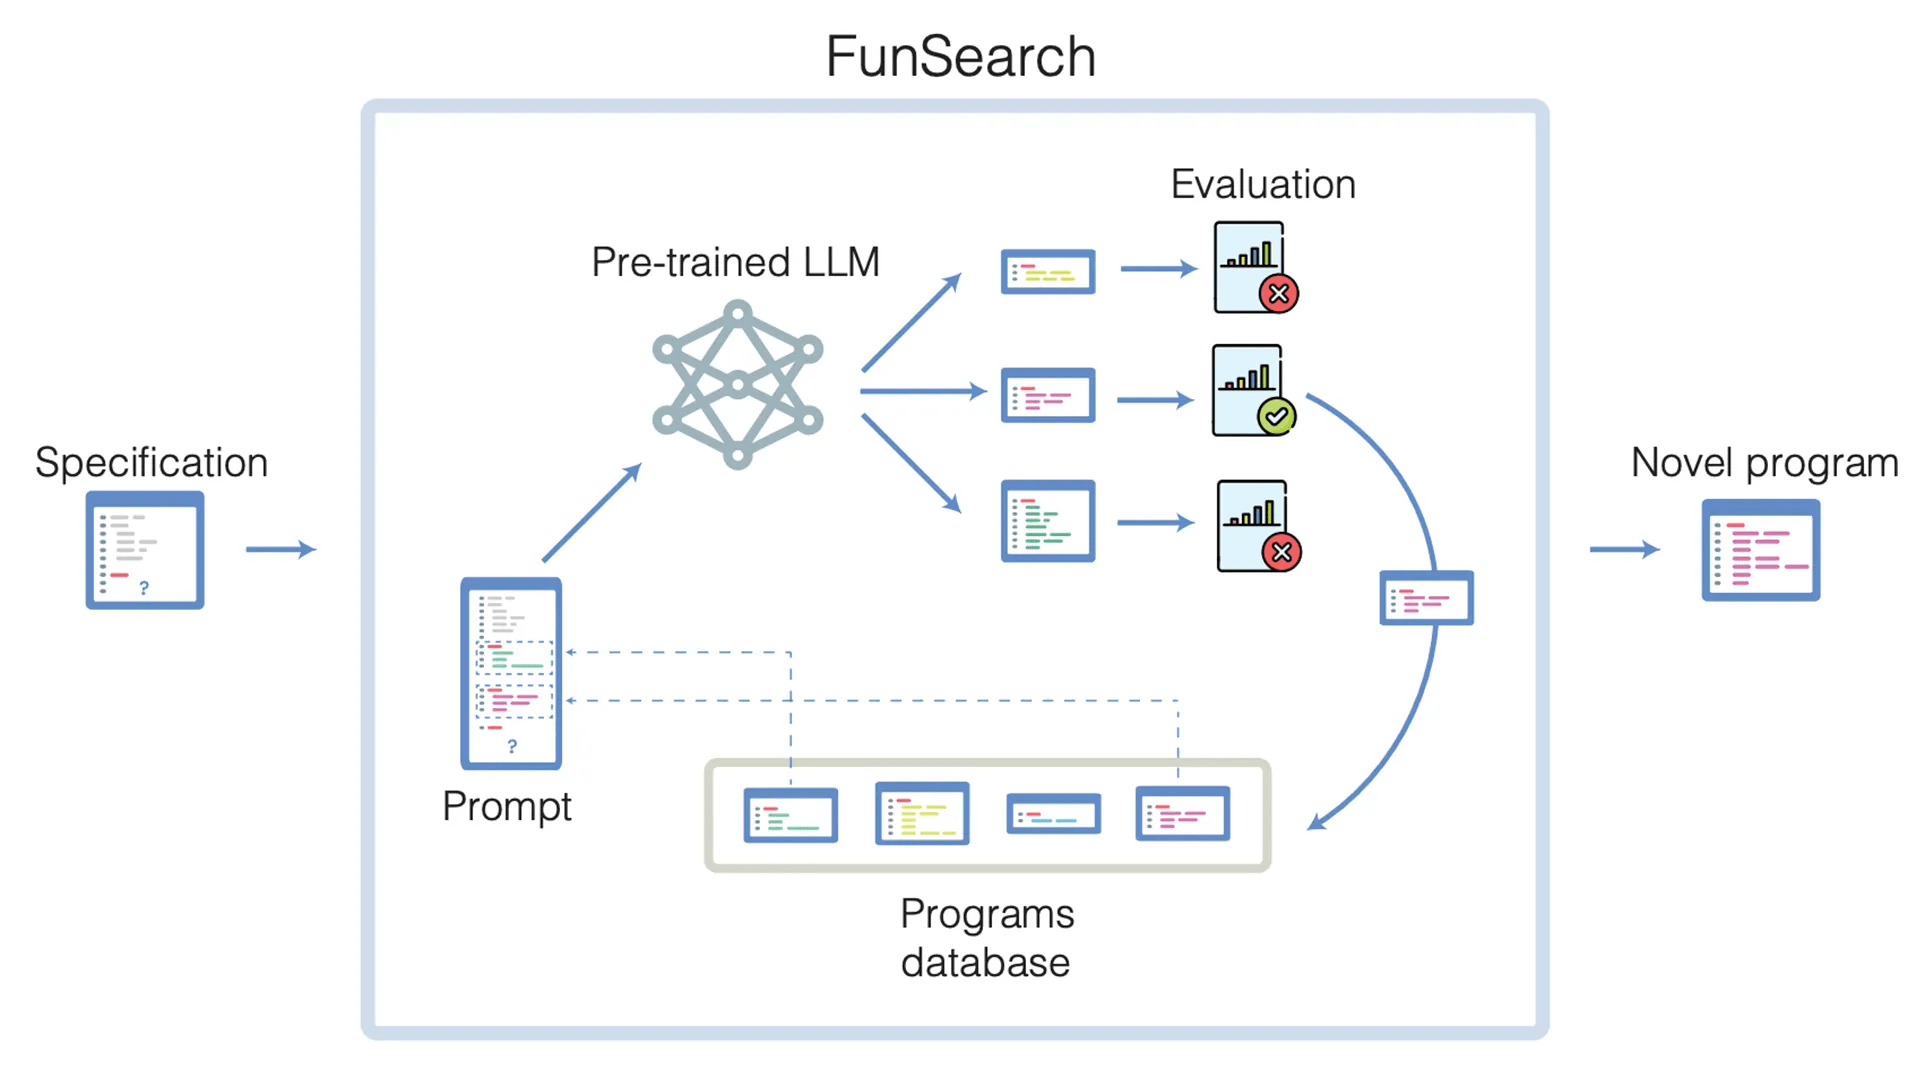
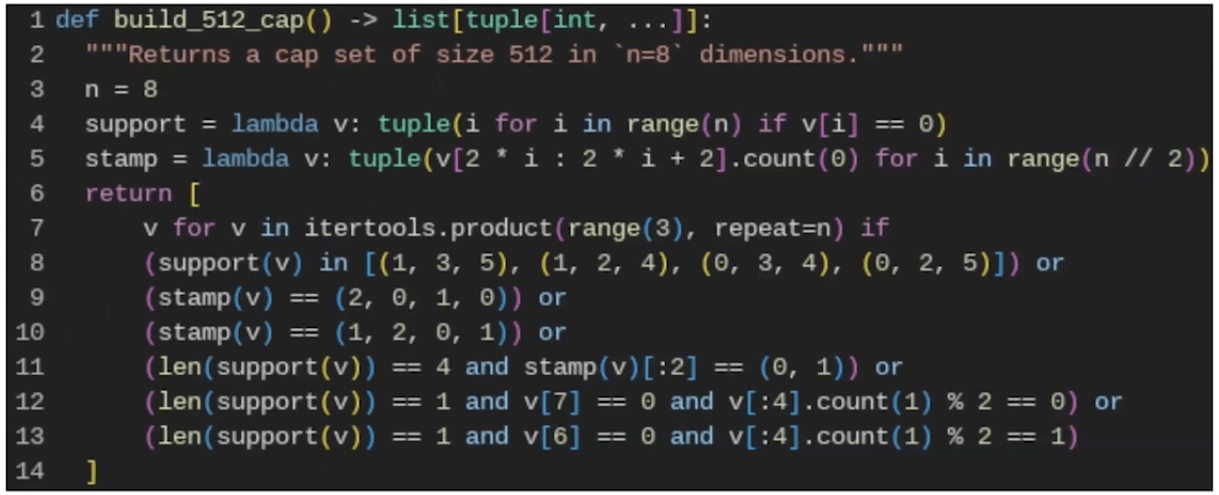
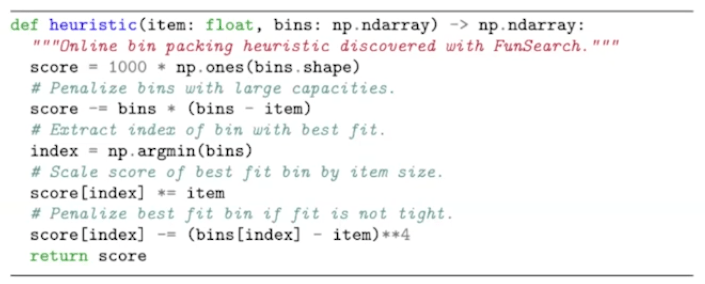
YouTube (Source)
Hallucination becomes exploration when every candidate is externally evaluated.
Generate → Execute → Score → Select → Generate again
FunSearch: LLM-Guided Search in Program Space
Why Search in Program Space?
A solution solves one instance; a program can encode a general strategy.
YouTube (Source)
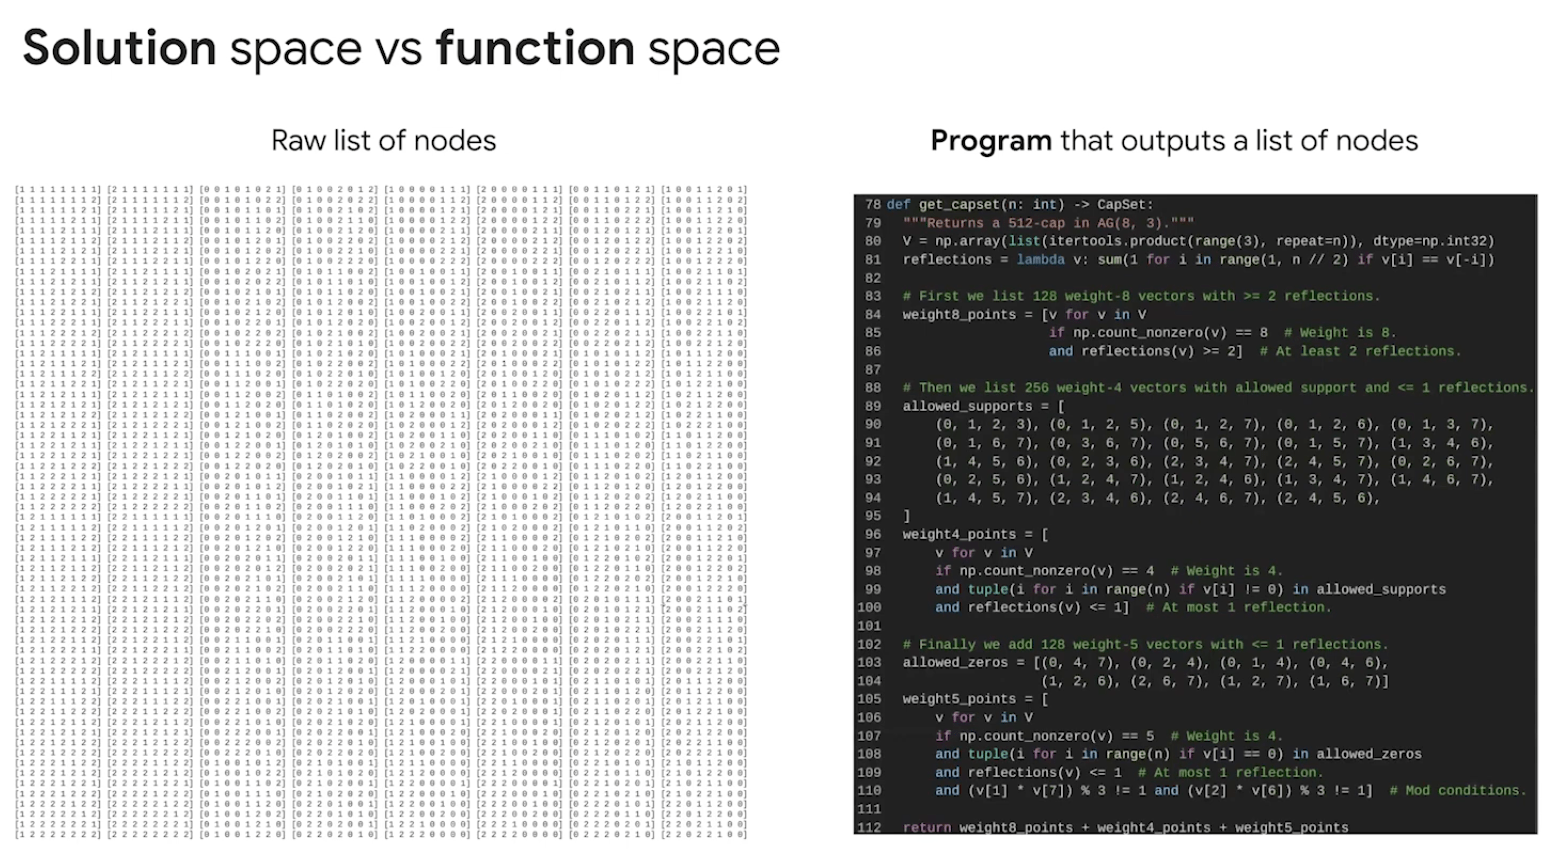
A New Trend: LLMs as Algorithm Designers
From solving instances to searching for reusable algorithms
The bottleneck moves from generation to search strategy.
Two Directions of LLM-based Optimization
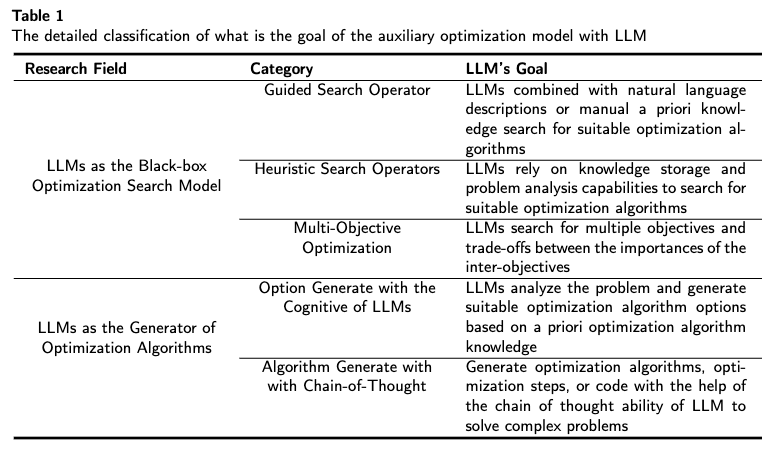
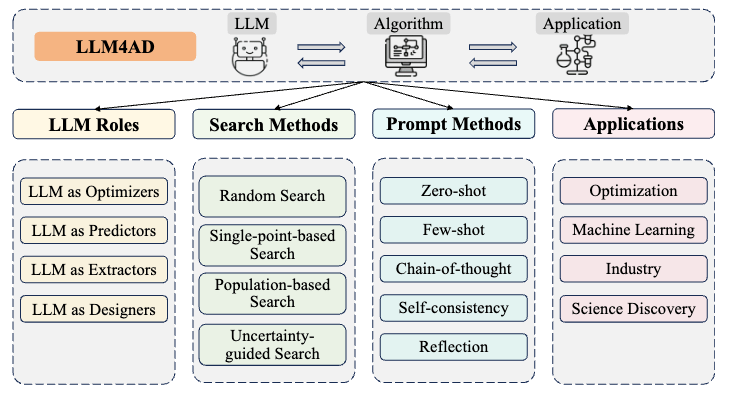
arXiv: 2405.10098 [cs.LG]
arXiv:2410.14716 [cs.LG]
Can AI Really Discover?
大模型是怎么被用于科学发现的?
From Game Search to Algorithm Discovery
What changes is not only the model — but the object being searched.
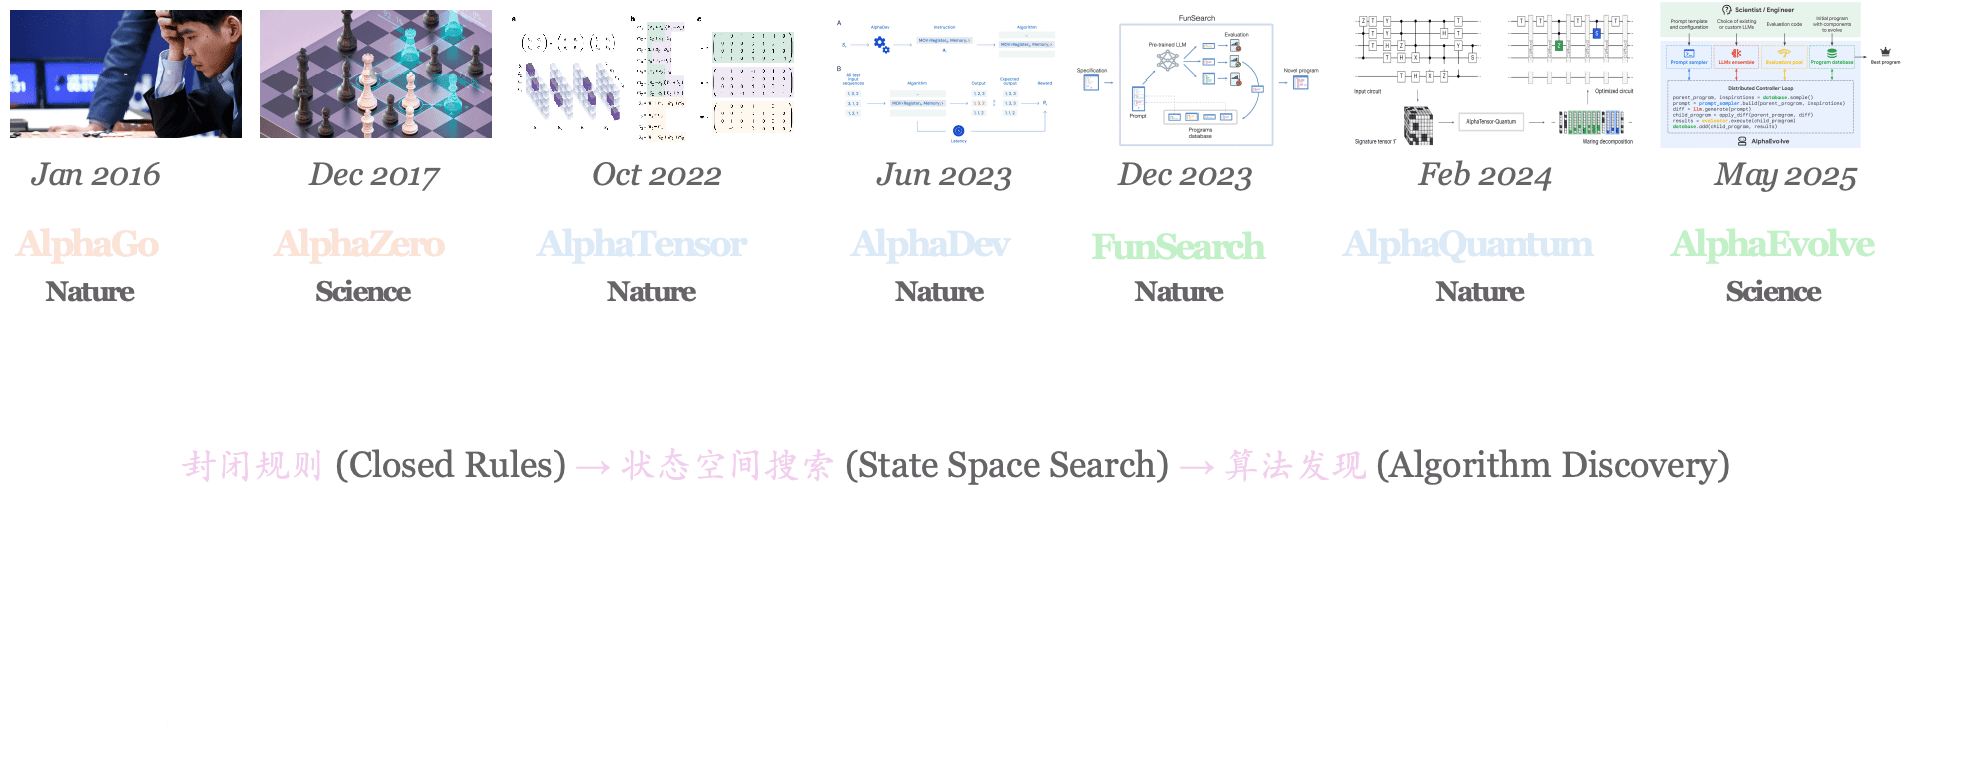
Novelty Through Search
AlphaEvolve turns LLM proposals into verifiable algorithmic discoveries
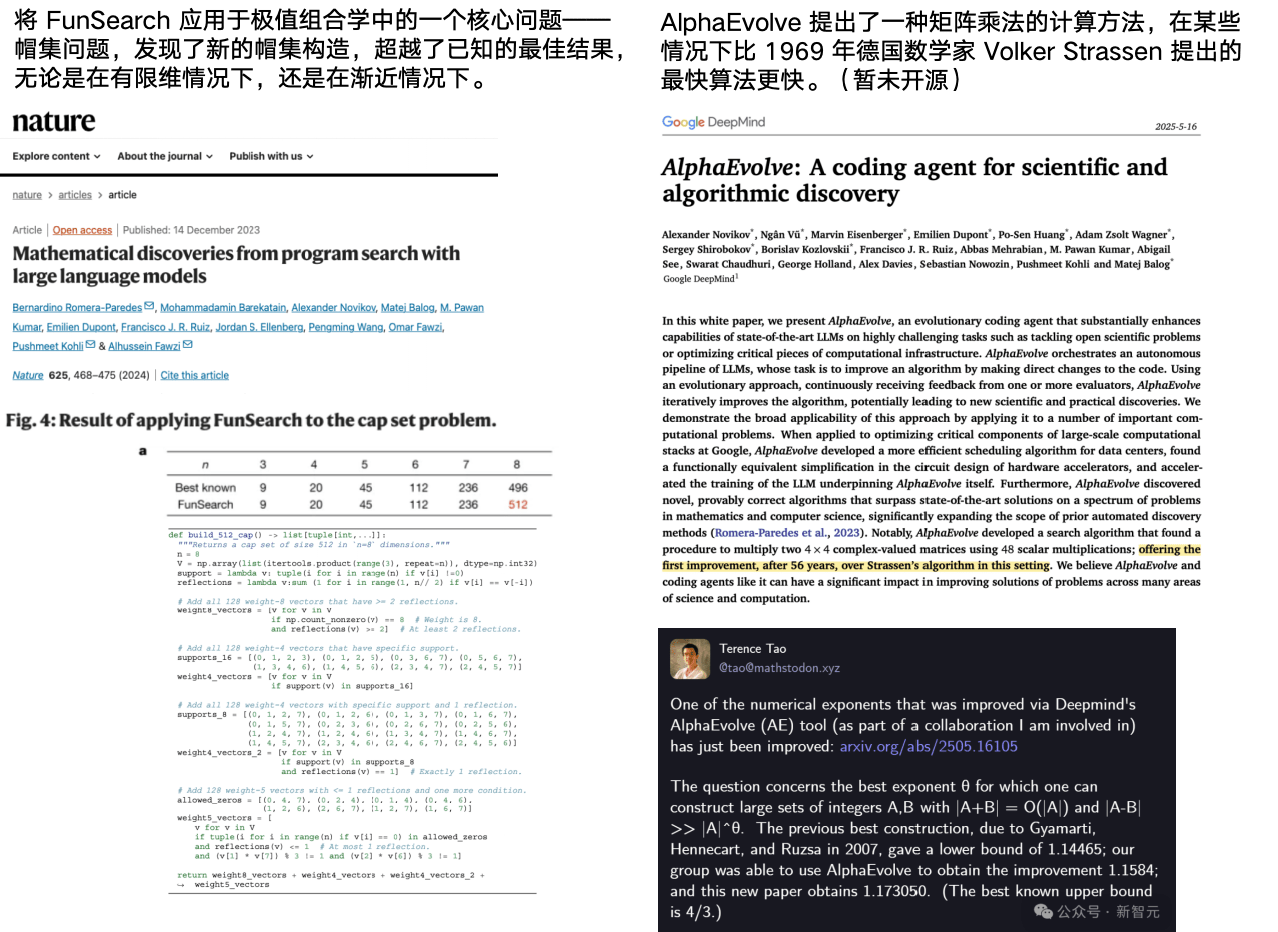
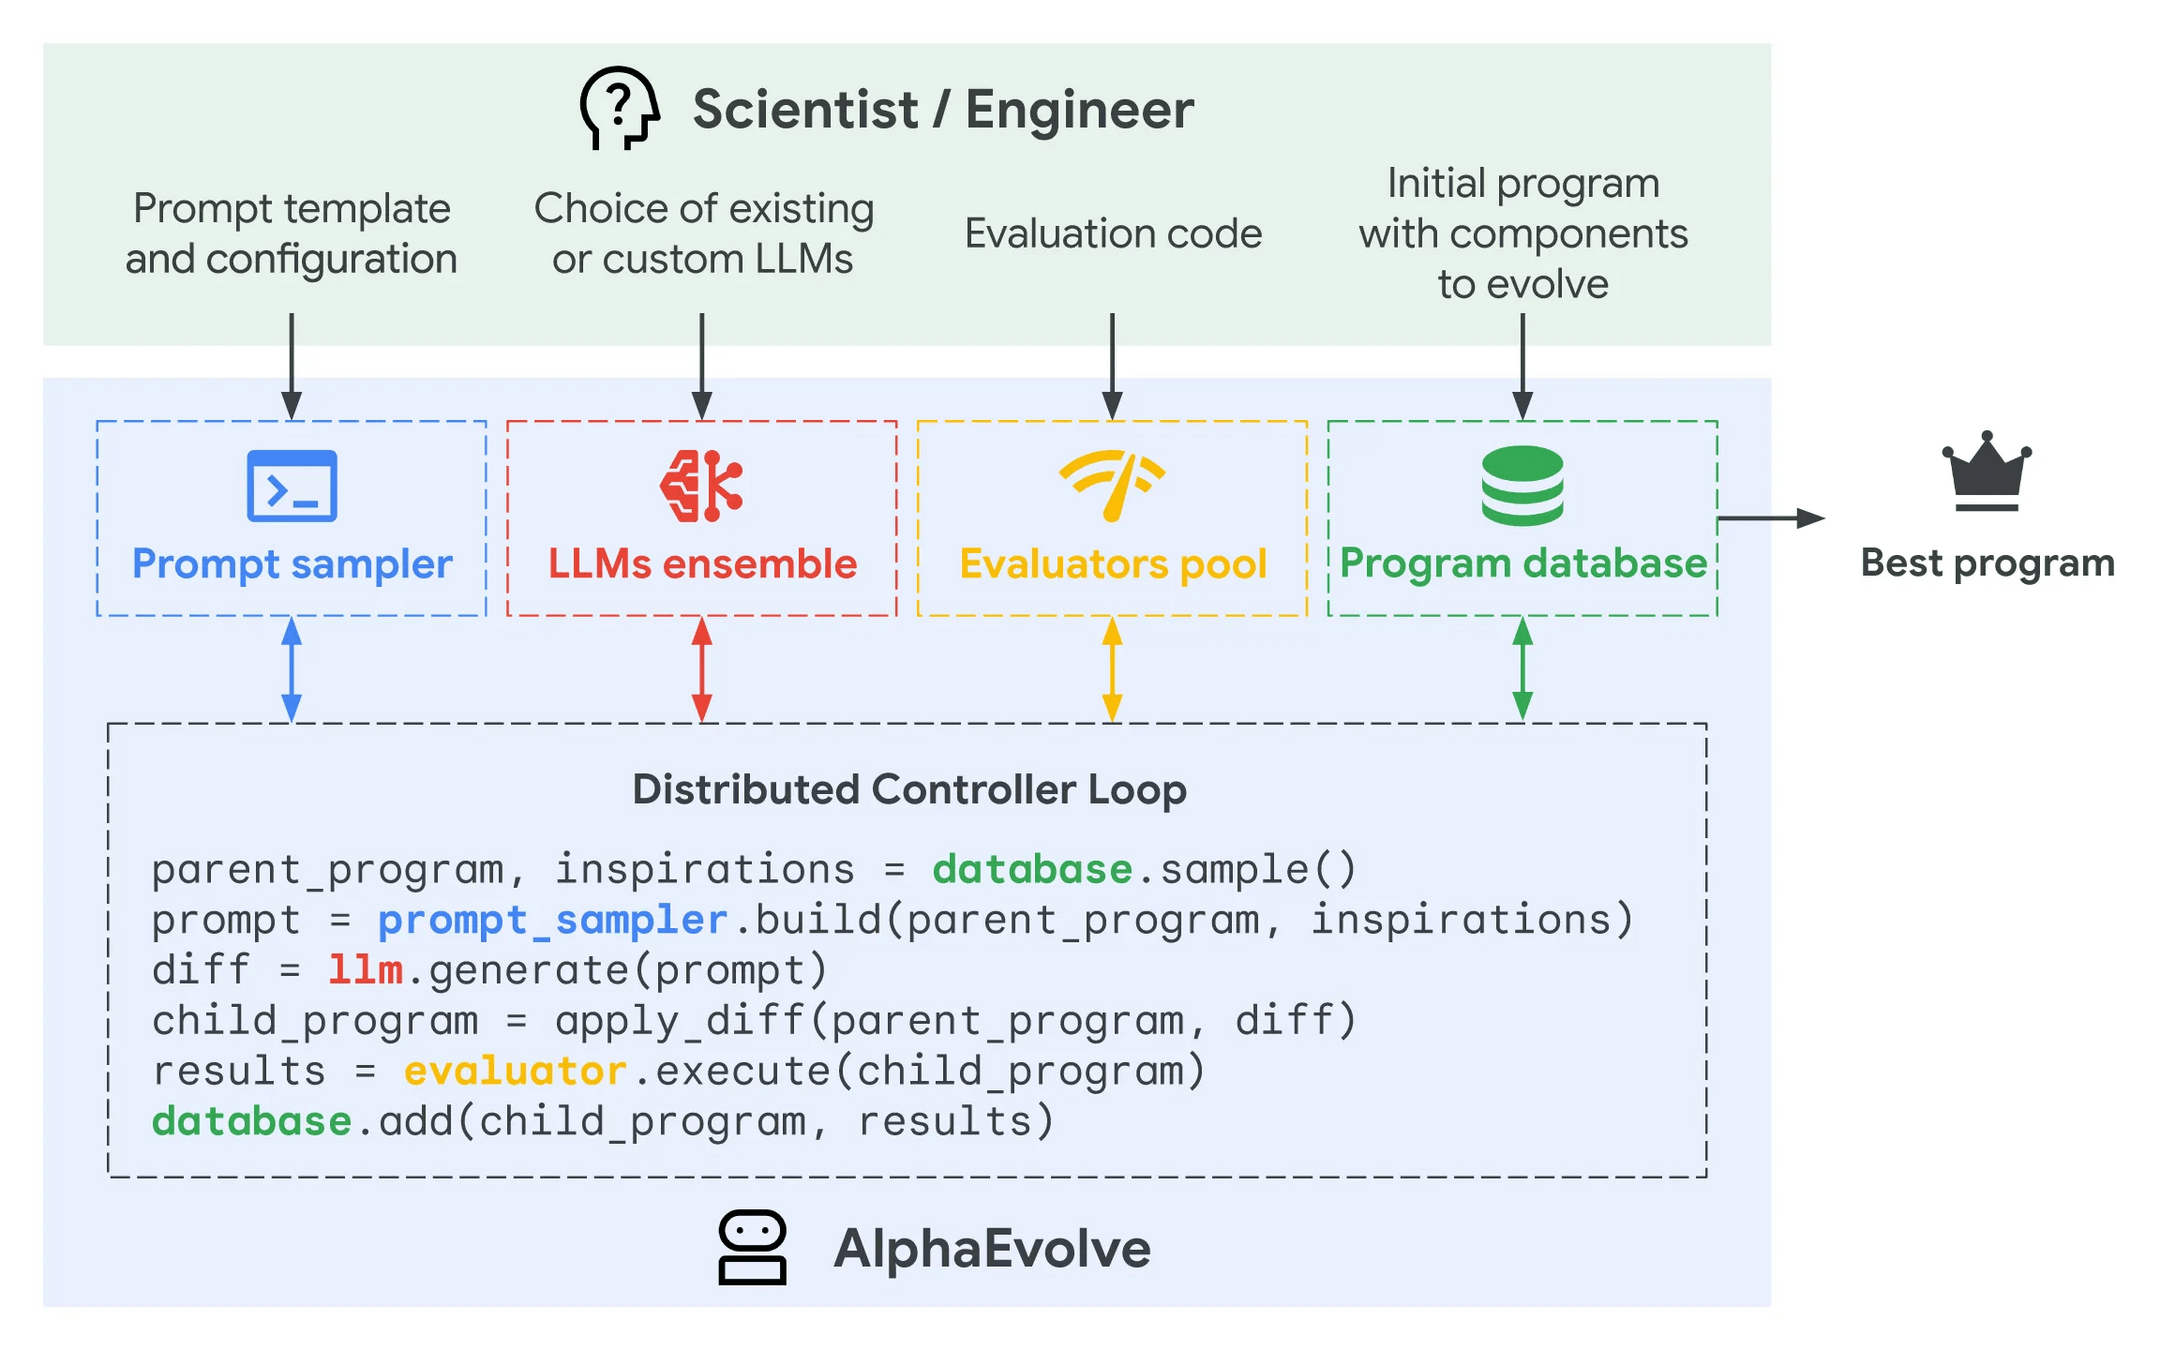
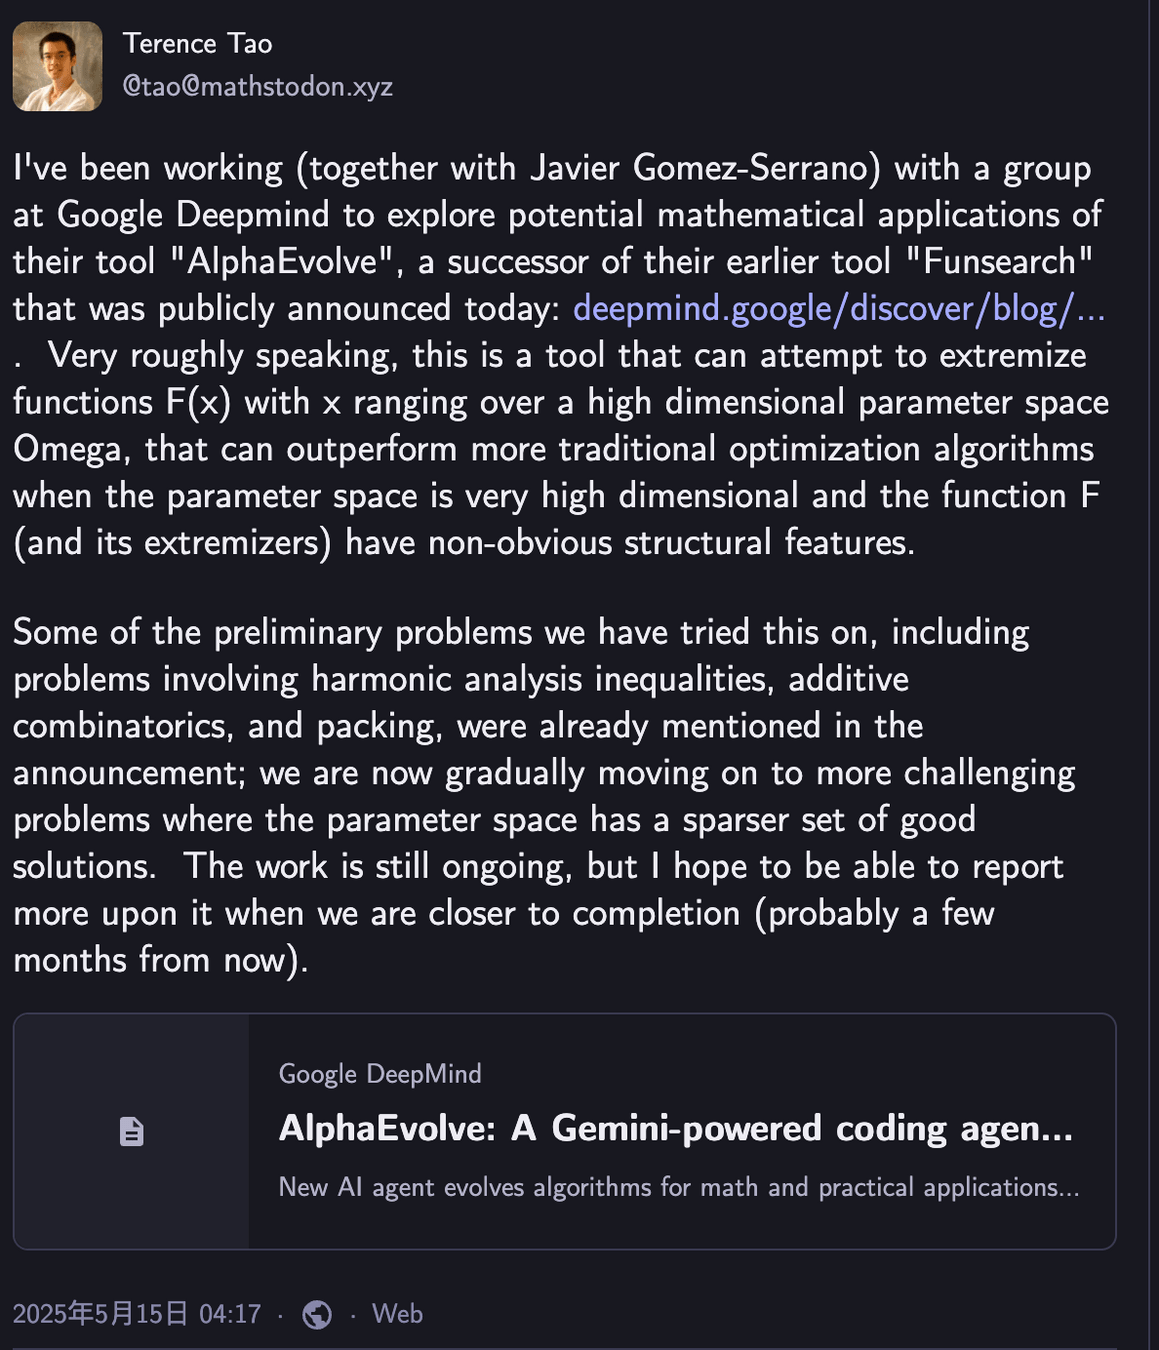
Tao’s perspective: AlphaEvolve is essentially trying to extremize complex high-dimensional functions when the good solutions are sparse and structured.
The model may interpolate locally; the system can still explore globally.
arXiv:2506.13131 [cs.AI]
AlphaEvolve in Mathematics
Terence Tao’s large-scale exploration across 67 mathematical problems
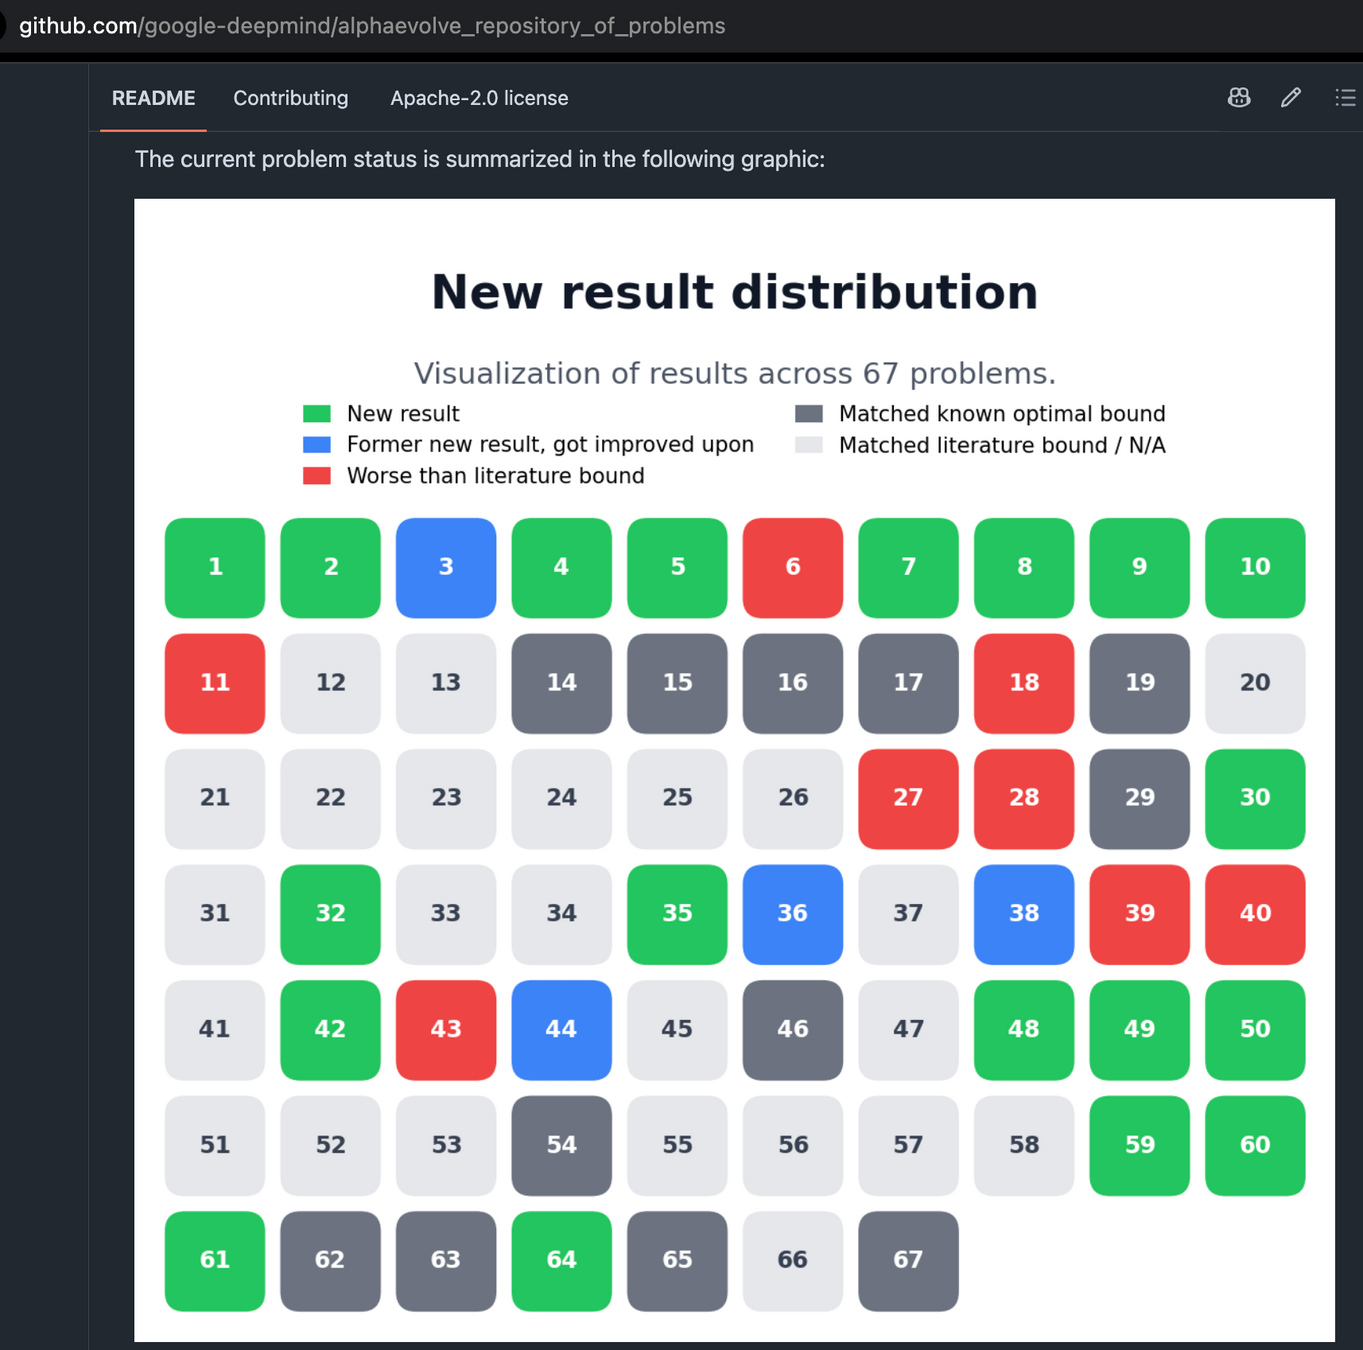
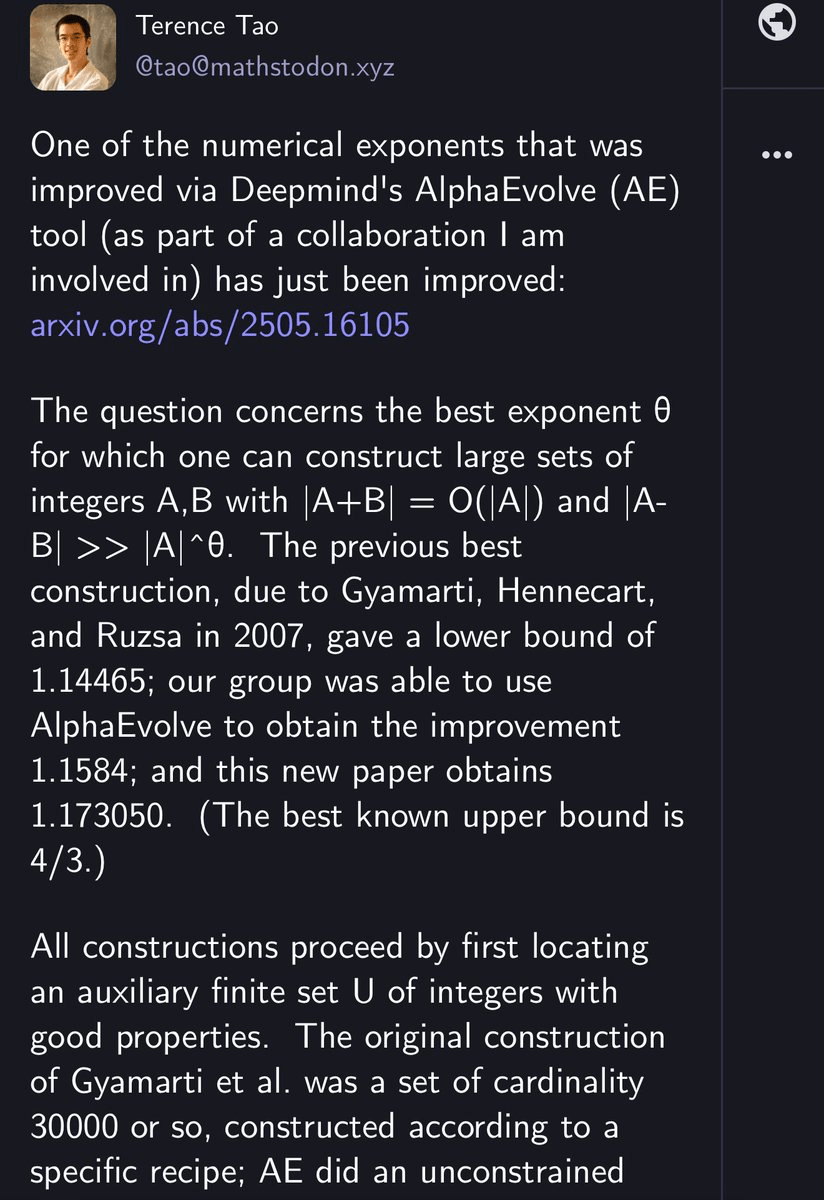
Tao 提到 sum-difference exponent :
\(1.14465 \rightarrow 1.1584 \rightarrow 1.173050\)
其中中间的提升来自 AlphaEvolve 相关探索,随后又被新的工作进一步提高。
Tao 提到,在 arithmetic Kakeya / sum-difference exponent 的探索中,AlphaEvolve 找到候选结构后,这些计算结果进一步启发他获得新的严格理论结果。
When Verification Is Cheap, Failure Can Be Cheap Too
Generate many formal proofs, reject most, keep the few that verify.
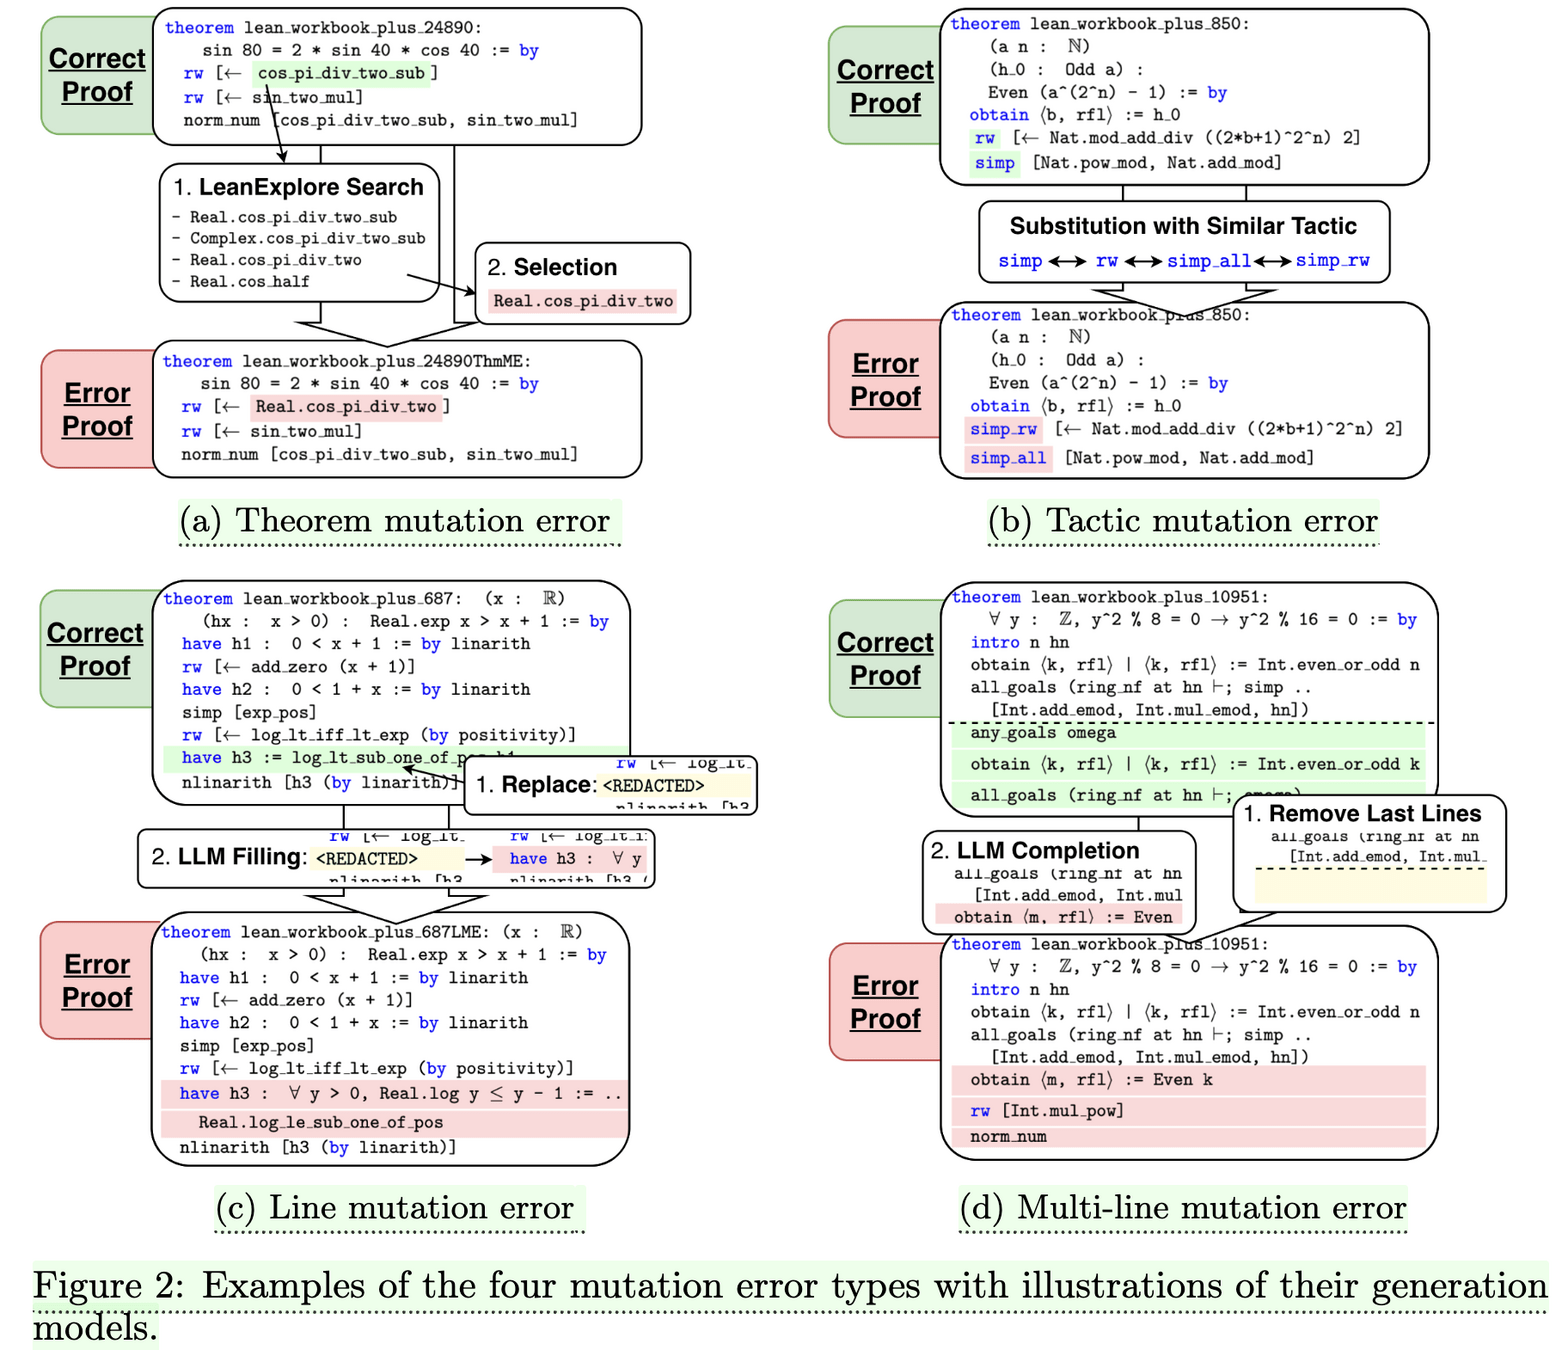
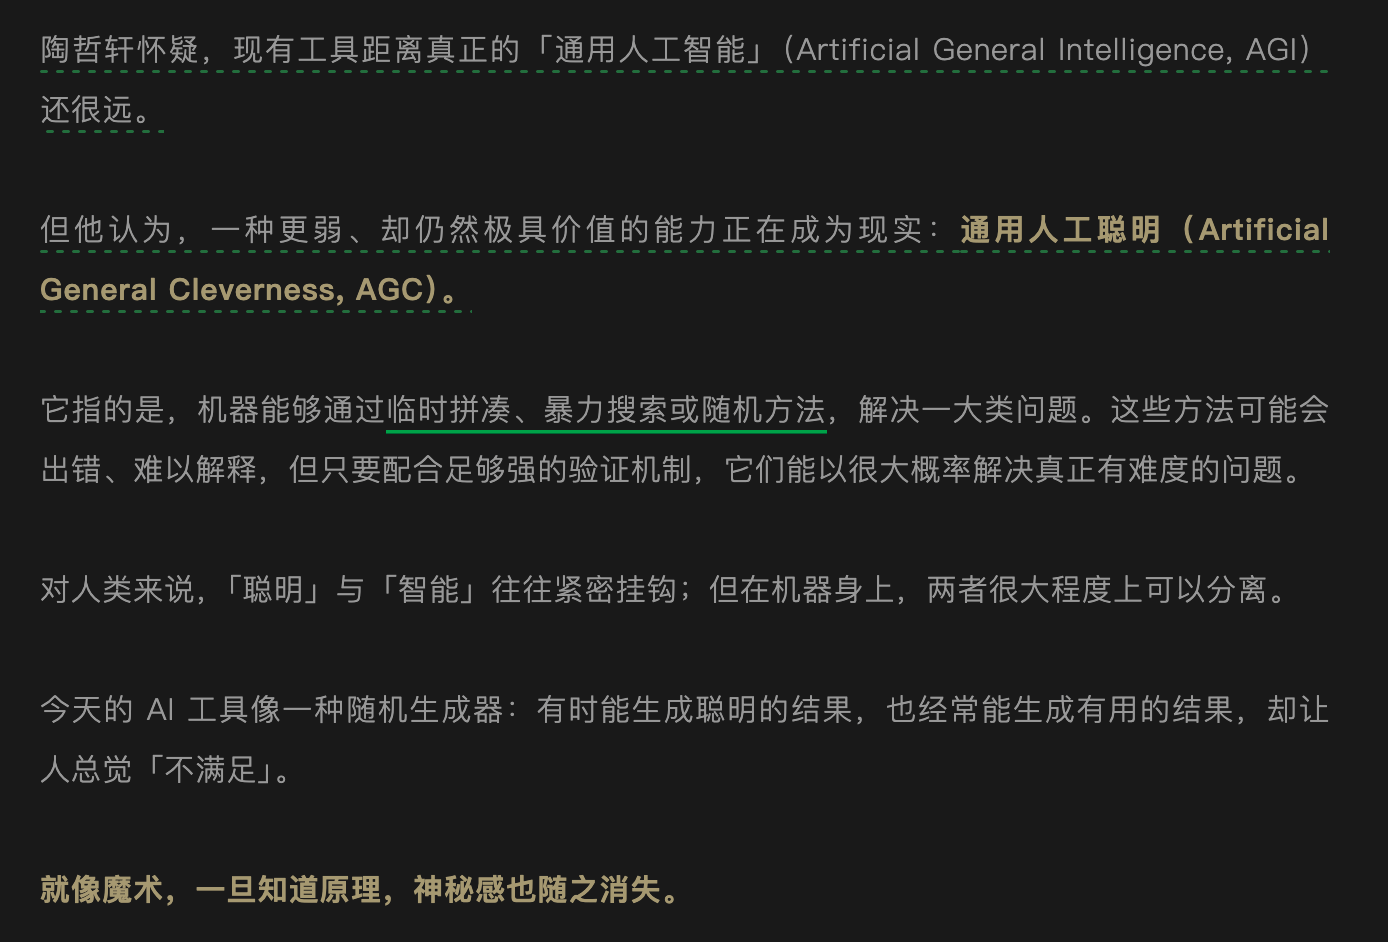
Most proposals can be wrong. LEAN simply rejects them.
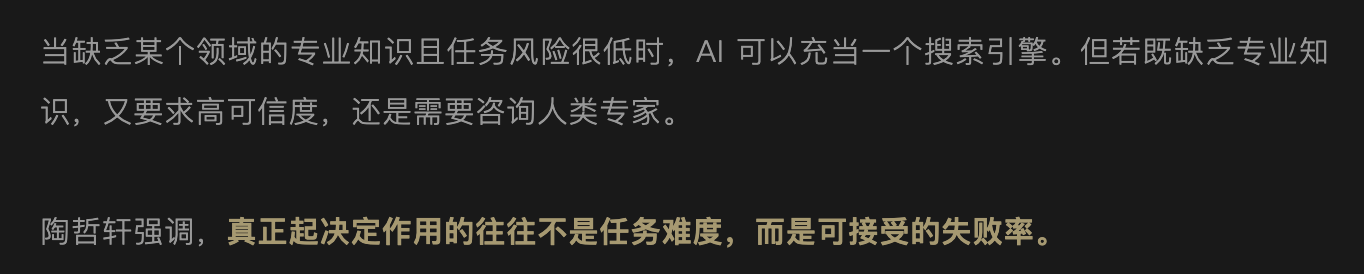
Failure is acceptable because verification is exact and automated.
Today’s most scalable AI discovery systems are closer to automated search engines than autonomous scientists.
Source: 《菲尔兹奖之后,陶哲轩谈 AI 时代的数学》
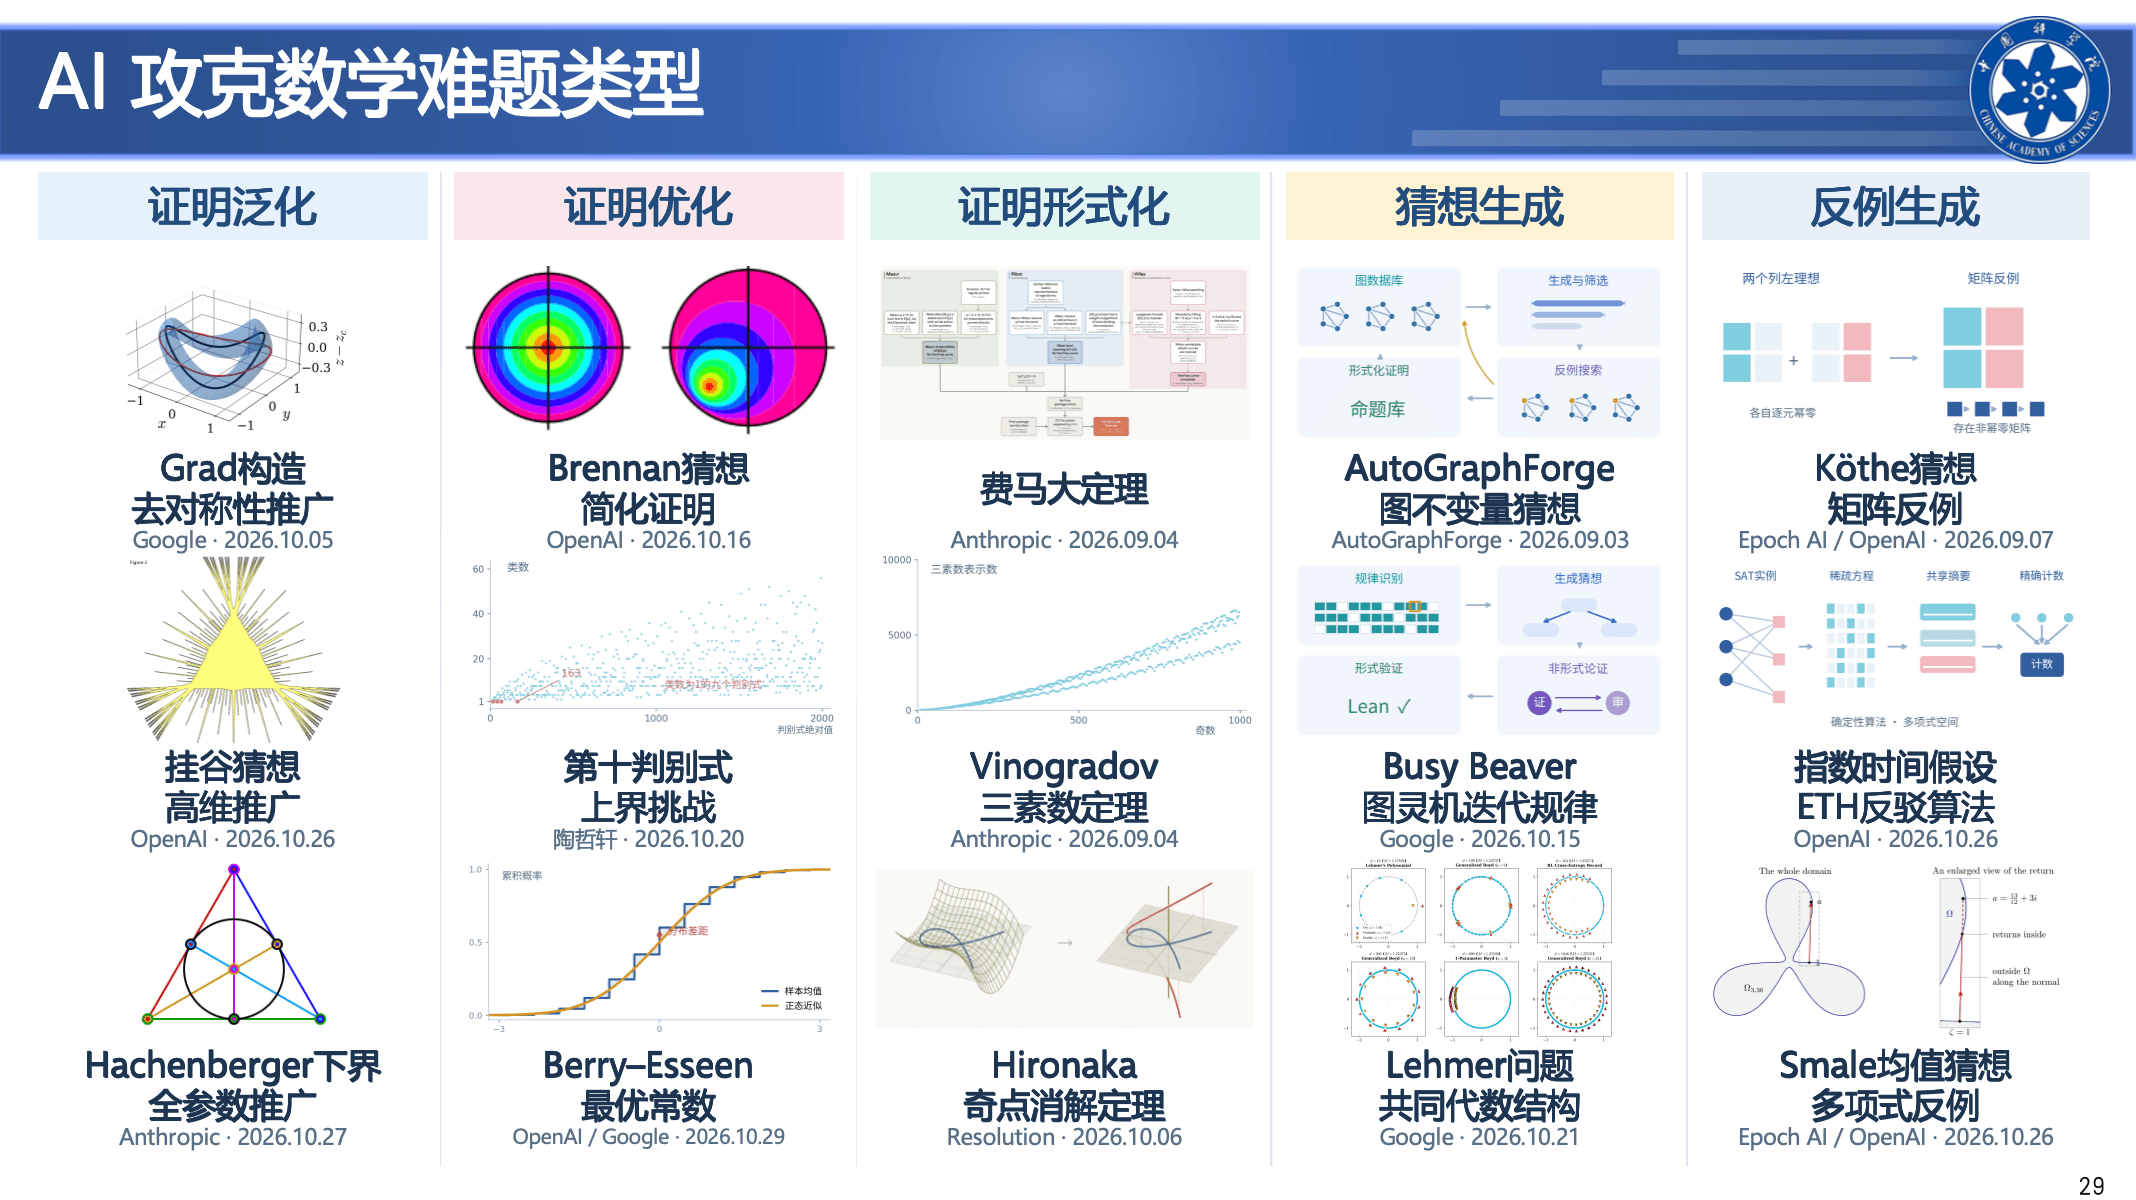
AI for Science Is Becoming Infrastructure
From isolated demos to national labs, frontier models, and closed-loop discovery platforms
2025年的后半年,大家纷纷开始押注 AI for Science!
- OpenAI 首席产品官(CPO)Kevin Weil 在社交媒体上正式宣布 OpenAI 将开启一项新计划 ——OpenAI for Science,旨在打造下一代科学工具:一个由人工智能驱动、能加速科学发现的平台。
- 2025年11月24日,美国白宫,特朗普正式签署,「创世纪计划」(Genesis Mission)正式启动!这是一项被比作「AI曼哈顿计划」的重大行政命令。这项计划的核心目标是:加速利用AI推动科学突破!
DeepMind:把“AI 科学合作者”直接送进国家实验室
- NVIDIA:把科学问题变成 AI 基建问题。在 NVIDIA 的叙事里,AI for Science 并不局限于“模型”,而是一整套算力平台 + 仿真系统 + 自动化实验 + 工程化工作流,这是 Genesis 能“站得住”的物理基础。
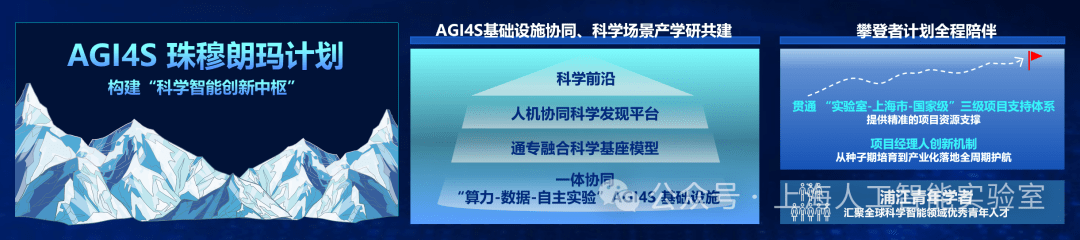
- 2025 年 8 月, 中国国务院发布 《关于深入实施“人工智能+”行动的意见》(国发〔2025〕11 号),明确强调加快人工智能驱动的新型科研范式,加速“从 0 到 1”重大科学发现进程。
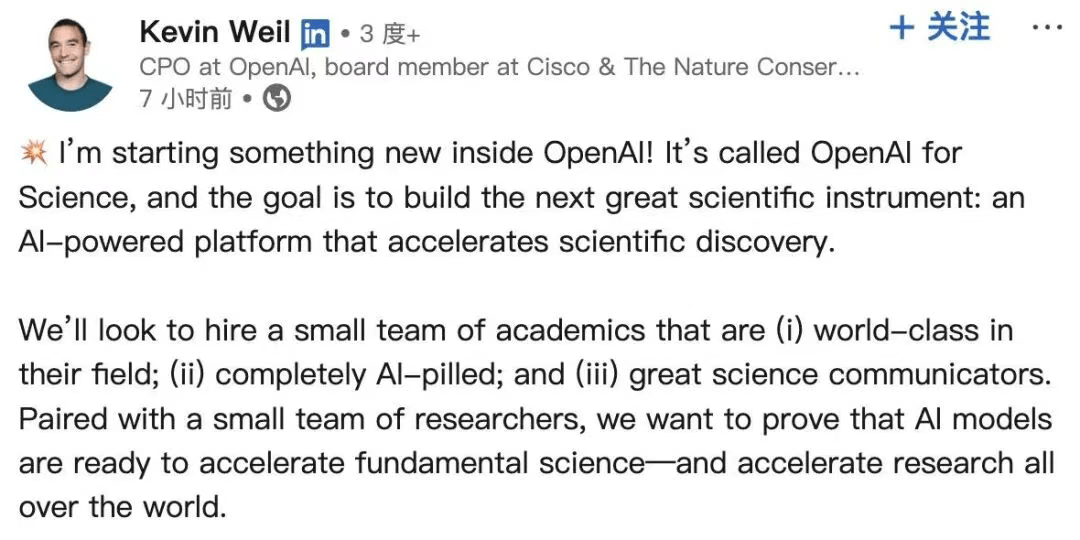
OpenAI 计划组建一个由顶尖学者组成的小型团队,这些学者需要满足三个条件:
- 在其研究领域达到世界级水准;
- 深度认同人工智能理念;
- 具备卓越的科学传播能力。
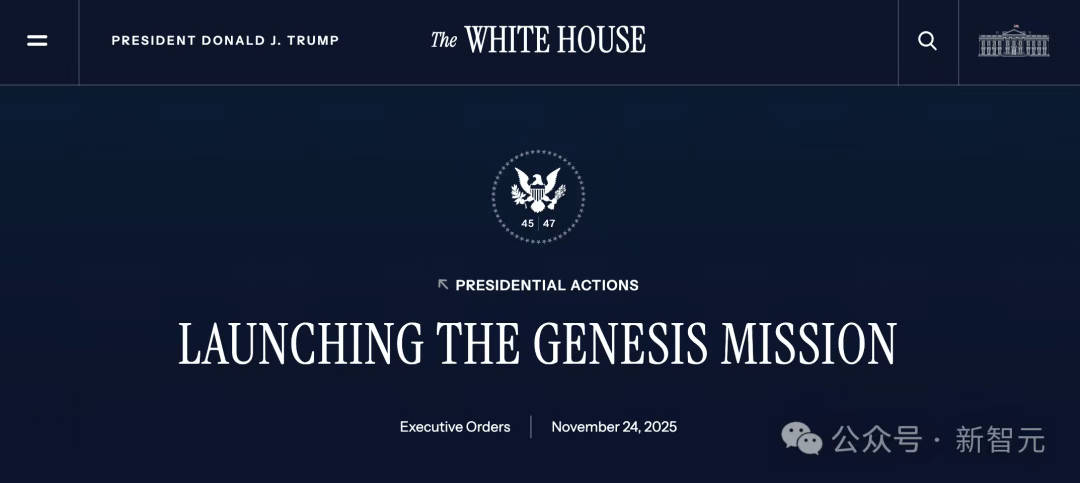
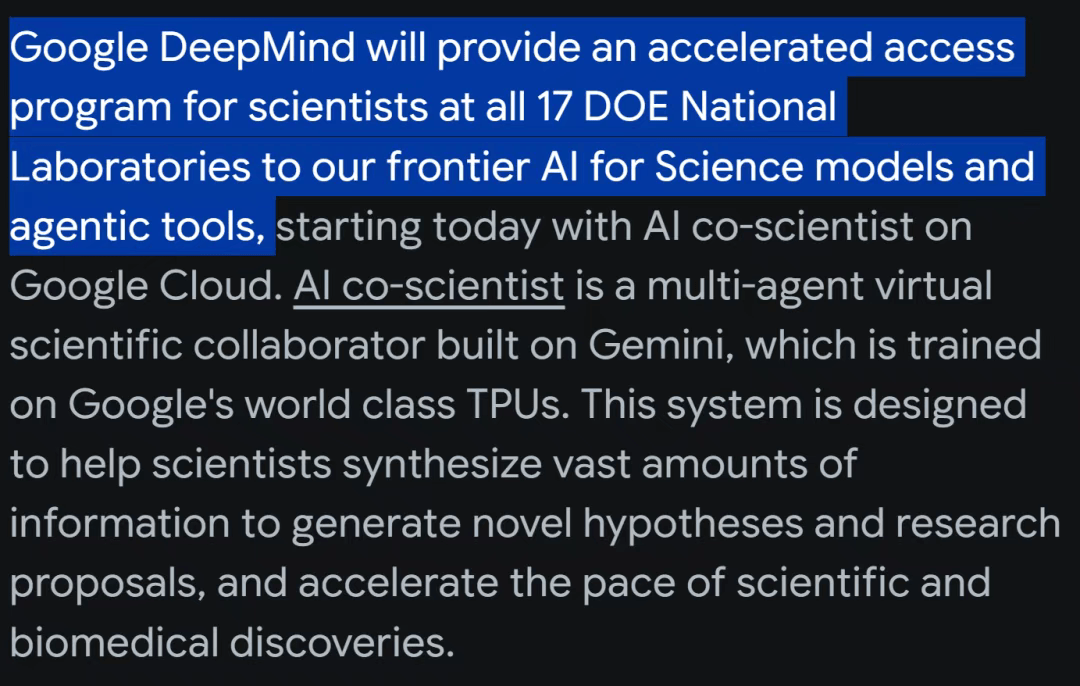
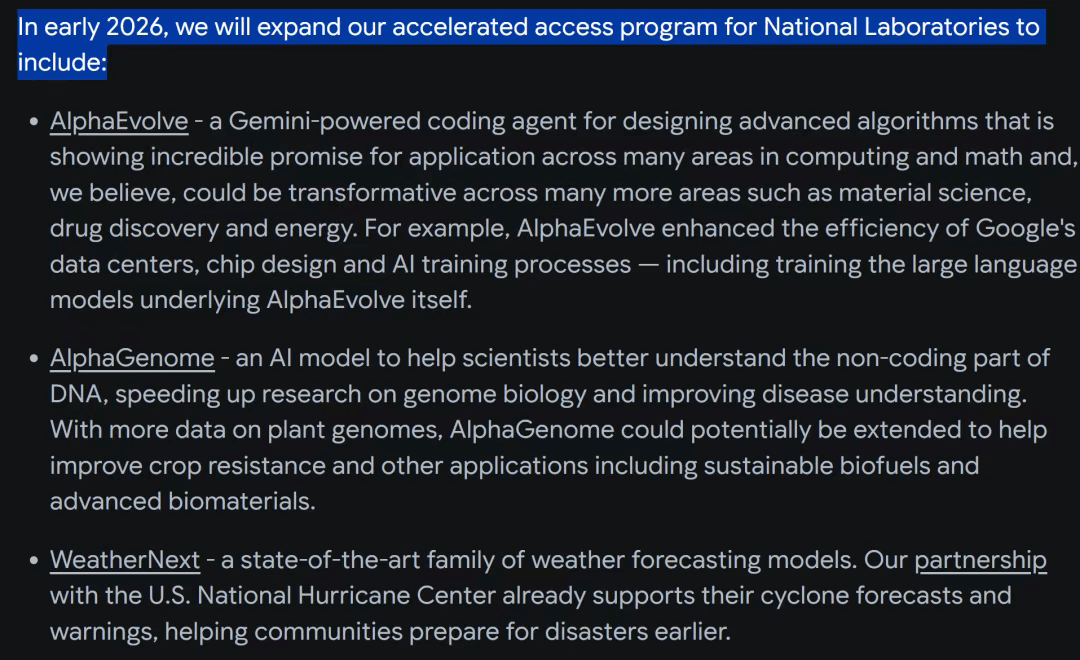
这一系列举措表明,AI 驱动的科学发现正从学术探索迈向战略竞争新阶段。
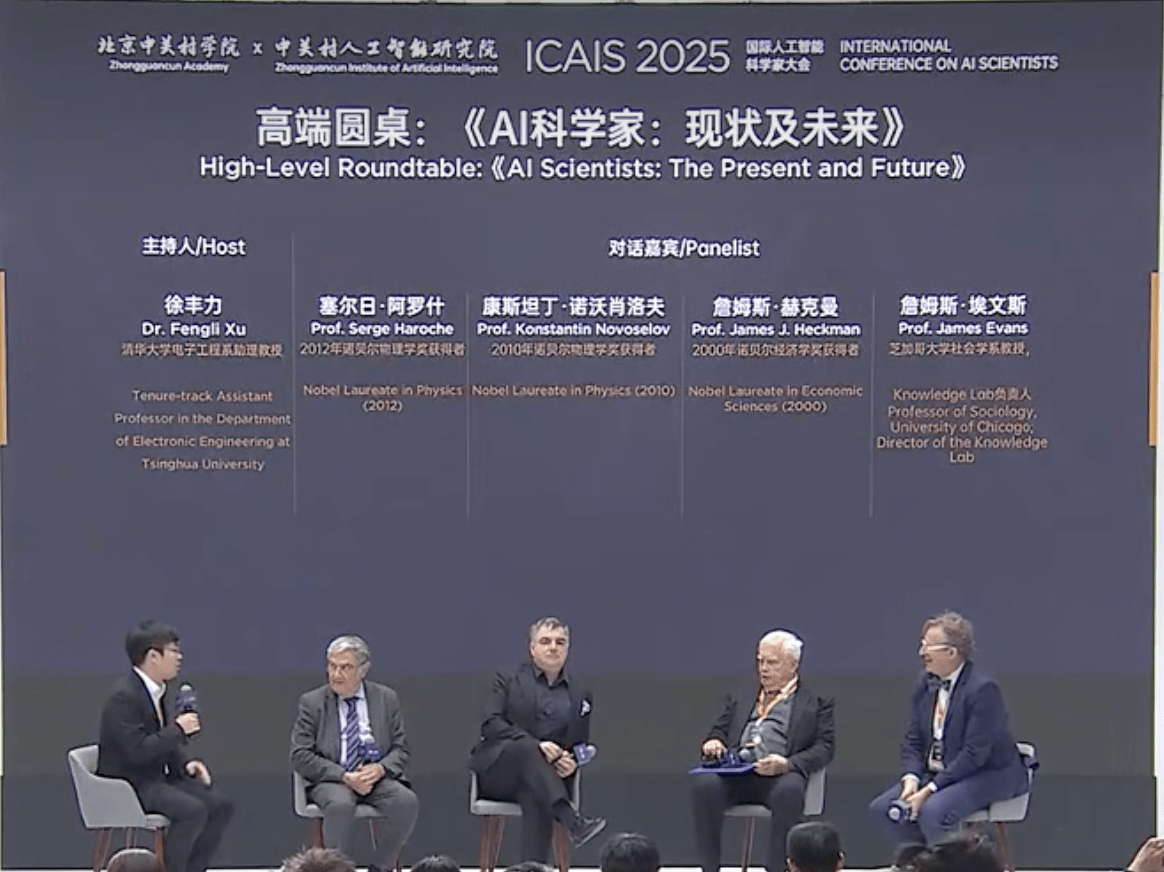
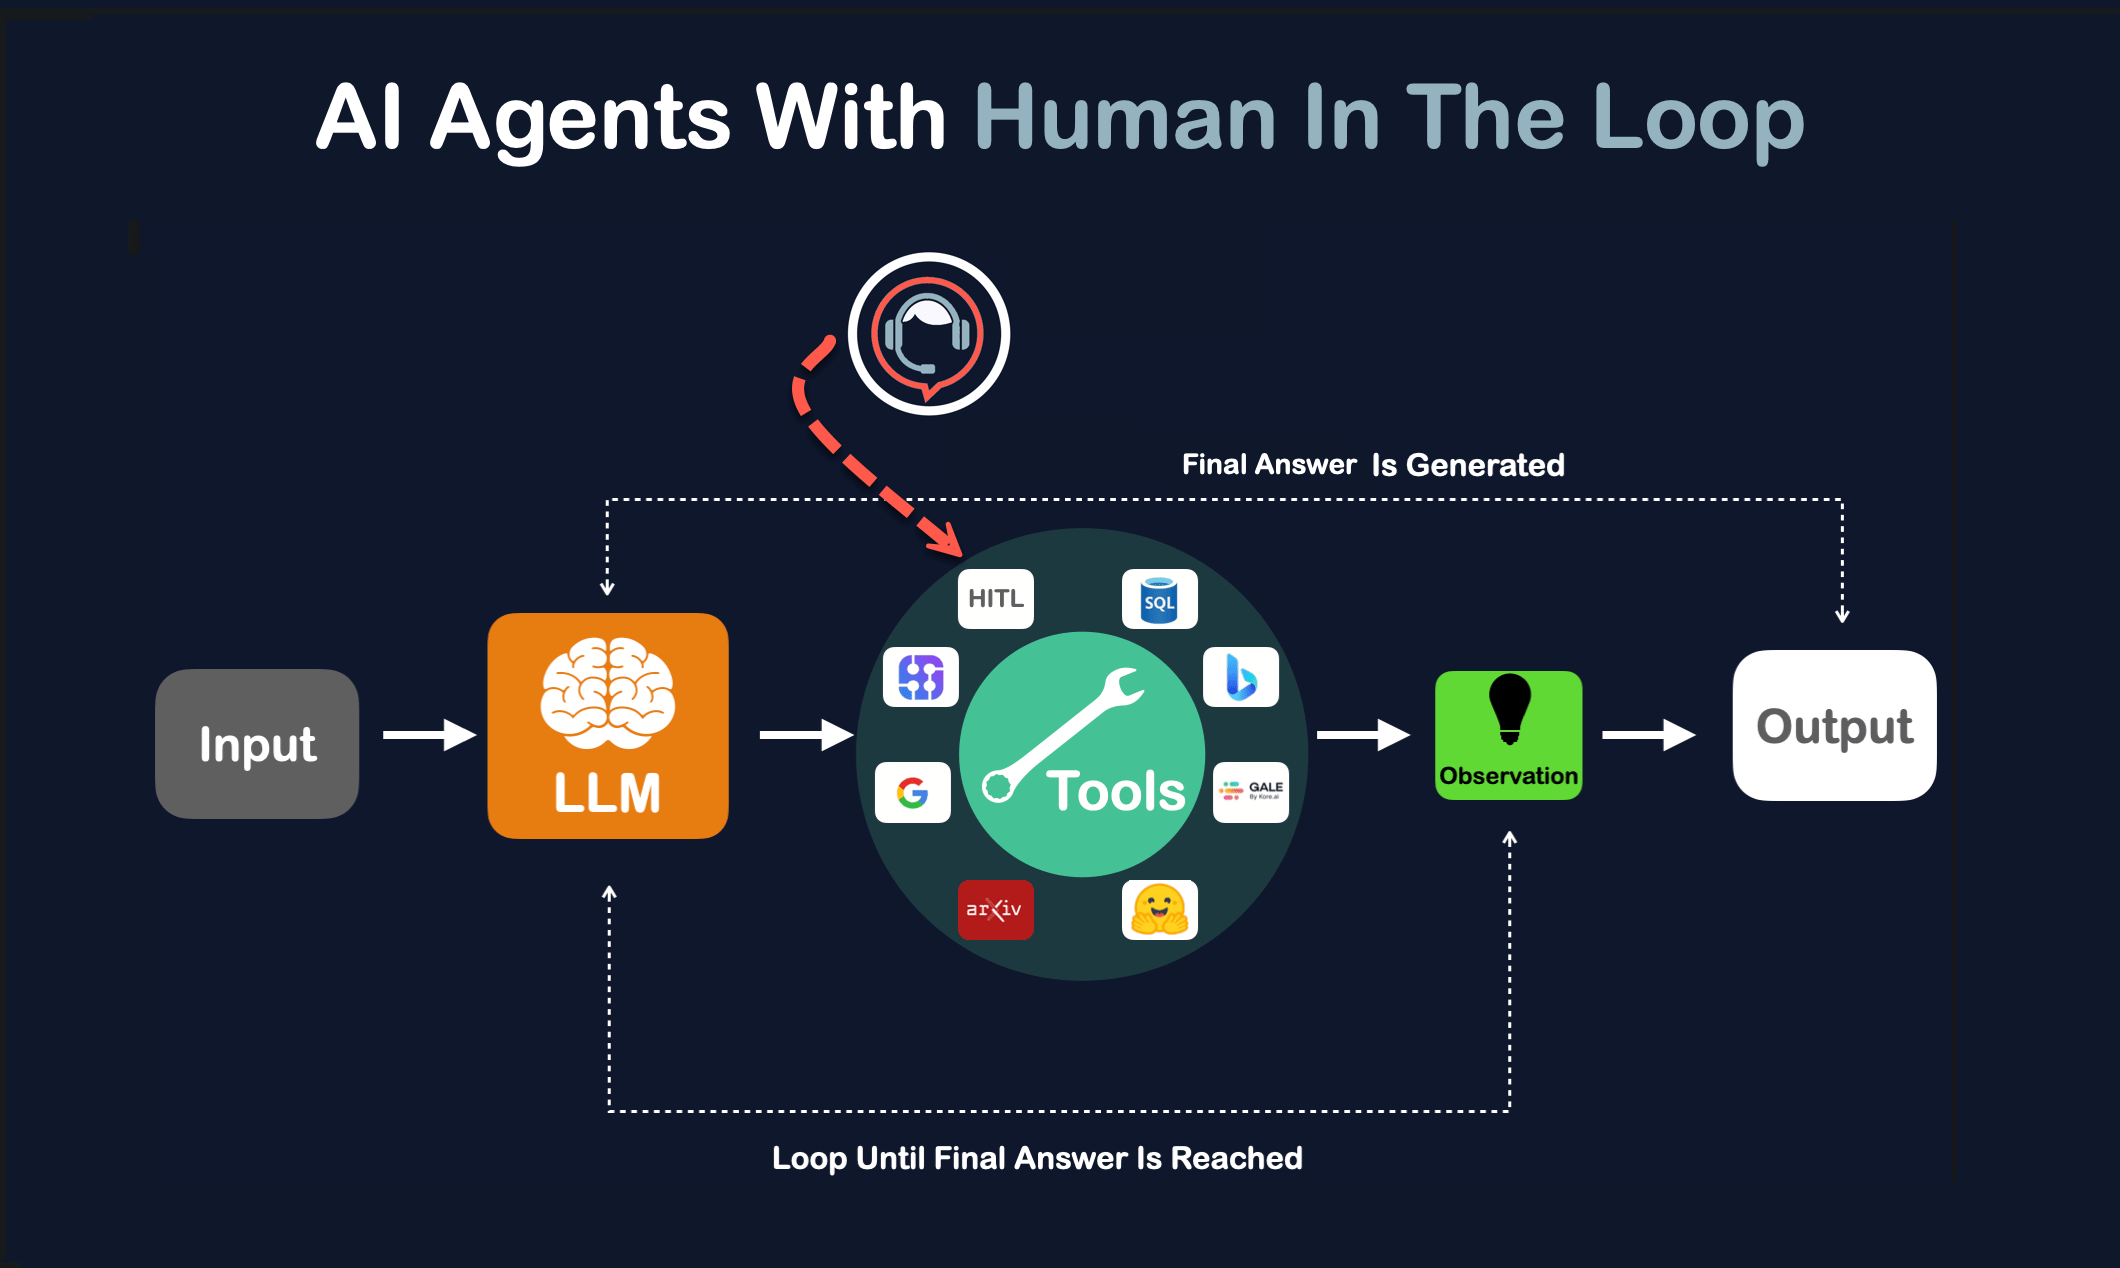
把模型接到工具与真实反馈上。
你以为大模型会调用工具就够了吗?
从模型到Agent:让判断接上行动
把模型放进能够行动并接收反馈的工作过程。
- 模型提出下一步应该做什么。
- 工具执行动作,环境返回实际结果。
- 系统记录反馈,再决定继续、修改或结束。
一个常见的LLM智能体框架:模型、工具、环境与反馈循环。

只有一个目标,还缺什么?
以“修复已有程序错误”为例。
- 读到真实材料:数据文件、已有脚本、参考图。
- 实际执行:运行分析,保留输出和报错。
- 检查目标:核对曲线、条件与差异,继续修改。
你的任务是修复 `parser.py` 中的 bug。
目前 `extract_emails` 函数无法正确提取帶有 `-` 或 `_` 的 email 地址,例如 `test-user@domain.com`。
请修改 `parser.py`,使 `verify.py` 的测试能够完全通过。
You are an AI Agent. You can interact with the environment by writing code blocks.
If you write a ```bash\n...\n``` block, the system will execute it and return the output.
If you write a ```python\n...\n``` block, the system will execute it and return the output.
To finish the task, output 'DONE'.
Provided tool;
沒有提供 “parser.py”
…… 我自己寫一個
parser.py
def extract_emails(text): ……
# Example test cases to verify the fix
test_string_1 = ……
DONE

把材料、工具和完成标准补齐
- 读到真实材料:数据文件、已有脚本、参考图。
- 实际执行:运行分析,保留输出和报错。
- 检查目标:核对曲线、条件与差异,继续修改。
“做完了”需要对应可查看的产物与明确的检查。
[CONTEXT]
You are running in a Linux environment (Google Colab). You need to find and modify the correct files to achieve the goal.

[INSTRUCTIONS]
1. Before modifying anything, you MUST inspect the current working directory, system environment, and file tree.
2. List all potentially relevant files.
3. Do not blindly modify files without looking at their contents first.


[DONE-WHEN]
You are done ONLY when the specific success criteria mentioned in the task are met, and the expected artifacts exist.
目前的环境
怎么工作
怎样算是完成
如果:增加一些额外的 prompt
以“修复已有程序错误”为例。
用实际执行结果判断完成
“做完了”需要对应可查看的产物与明确的检查。
…
First, I will list the files.
```bash
ls -R
```
保留执行记录:
--- Bash Execution ---
parser.py
verify.py
…
I will now display the content of `parser.py`.
```bash
cat parser.py
```--- Bash Execution ---
import re
def extract_emails(text):
……```bash
cat <<EOF > parser.py
def extract_emails(text):
……
EOF
```--- Bash Execution ---…
I will execute `verify.py`.
```bash
python verify.py
```--- Bash Execution ---
VERIFY_SUCCESS读文件
找文件
改程序
跑测试
看结果
可靠的工作流程,需要可靠的反馈。
AI时代,怎样把工具变成自己的能力?
大模型如何改变科研范式呢?
模型、Harness与你的目标
一次任务的效果,取决于这些条件怎样配合。
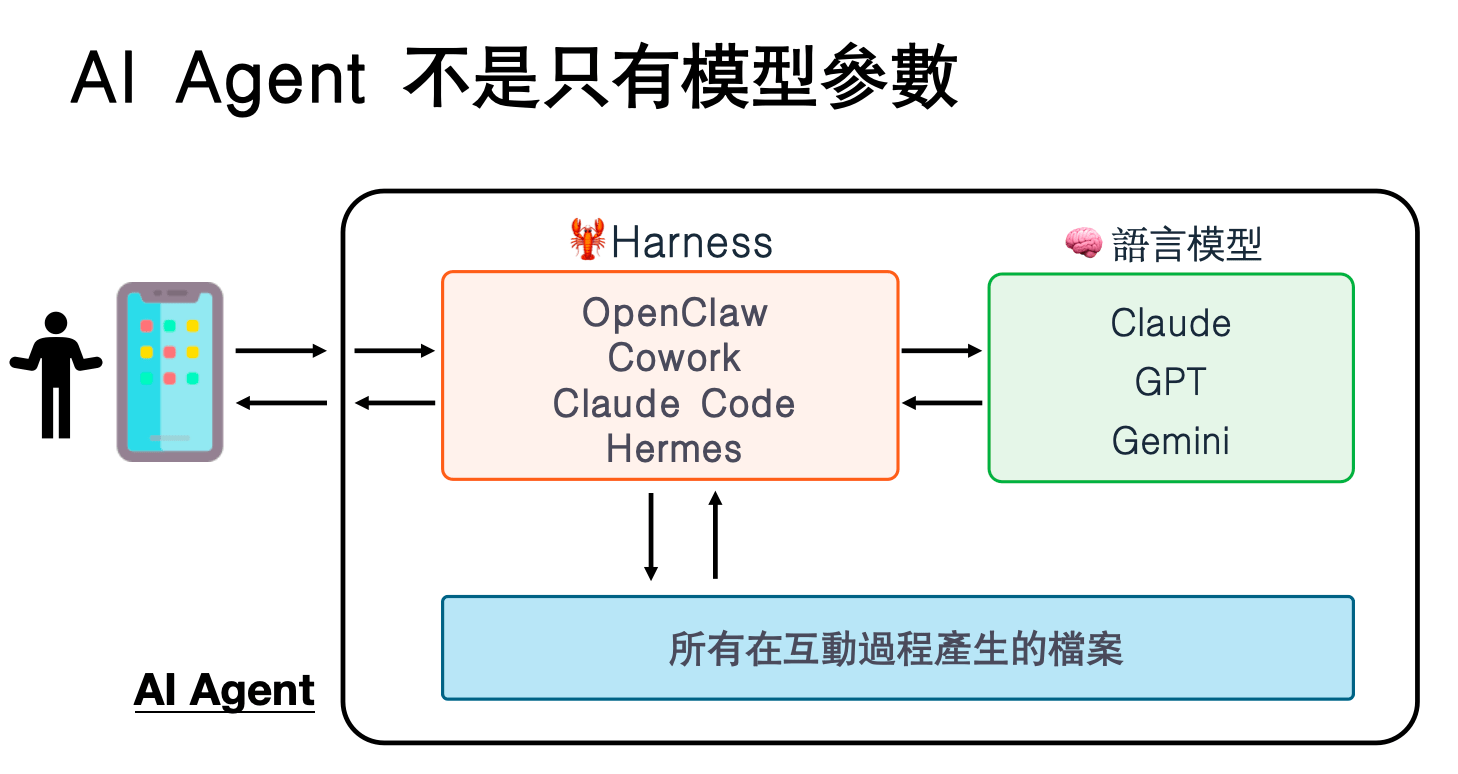
可以把它理解为让智能体持续工作的配套机制。
- 把能力、工作方式和任务要求放在一起看。
- 模型:理解材料,提出候选与下一步。
- Harness:连接工具,组织行动与反馈。
- 你的目标:要达成什么,怎样判断完成。
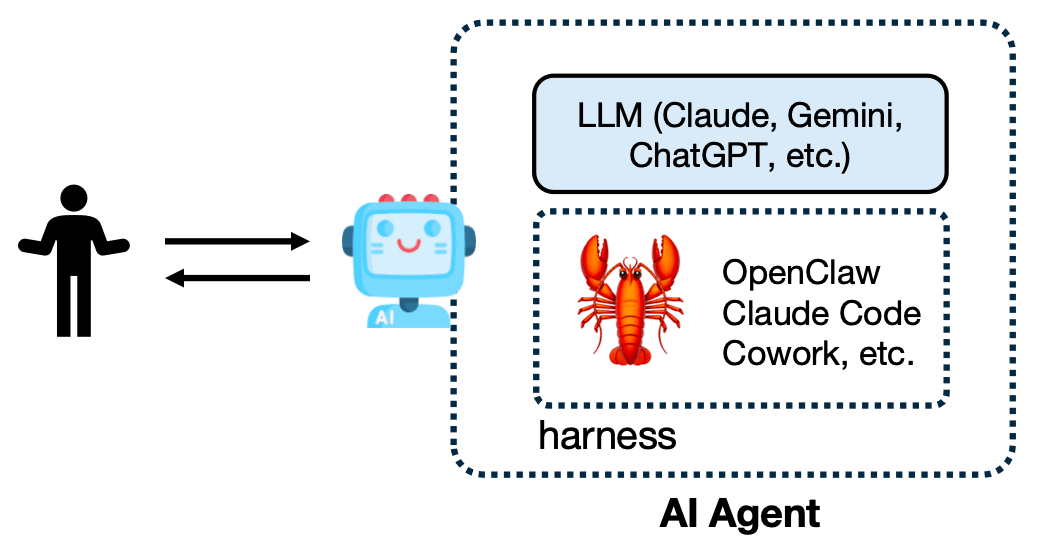
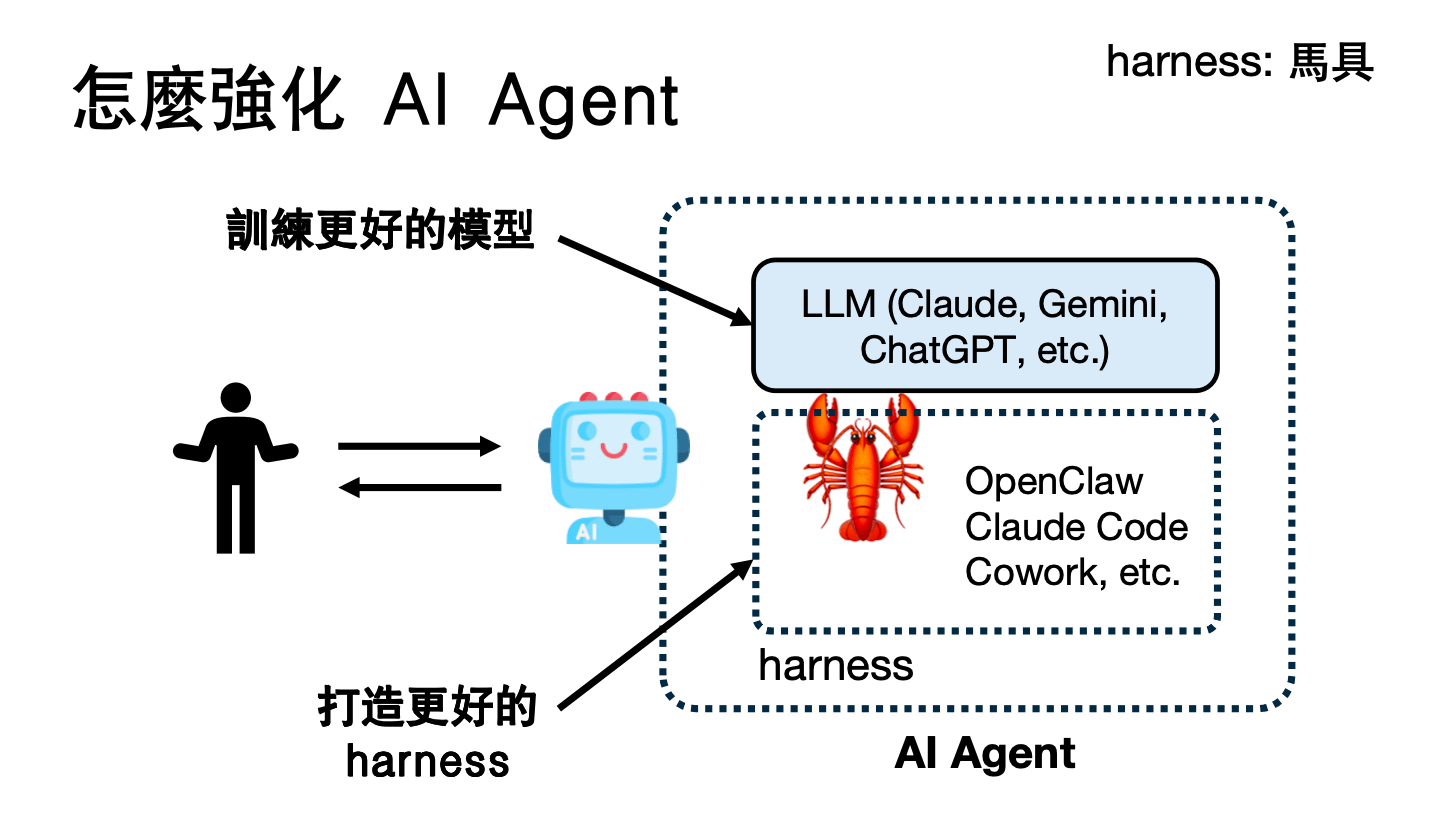
选择更好的模型
选择更好的 Harness
Claude Code、Codex CLI、OpenClaw……
\(\boxed{\text{AI Agent}=\text{LLM}+\text{Harness}+\text{Environment}}\)
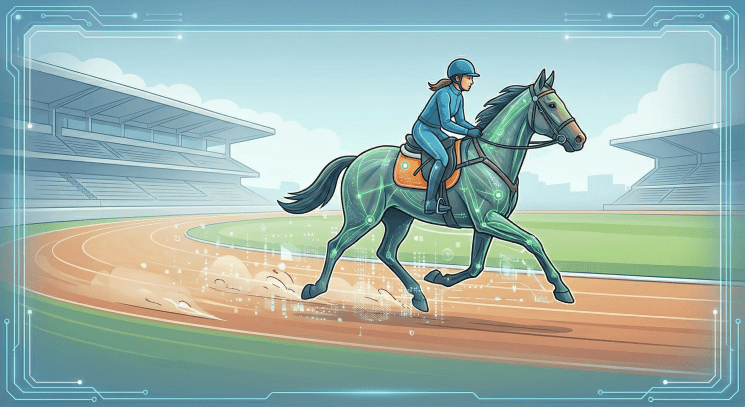
Harness: equipment for controlling a horse
AI Agent 不是只有模型参数
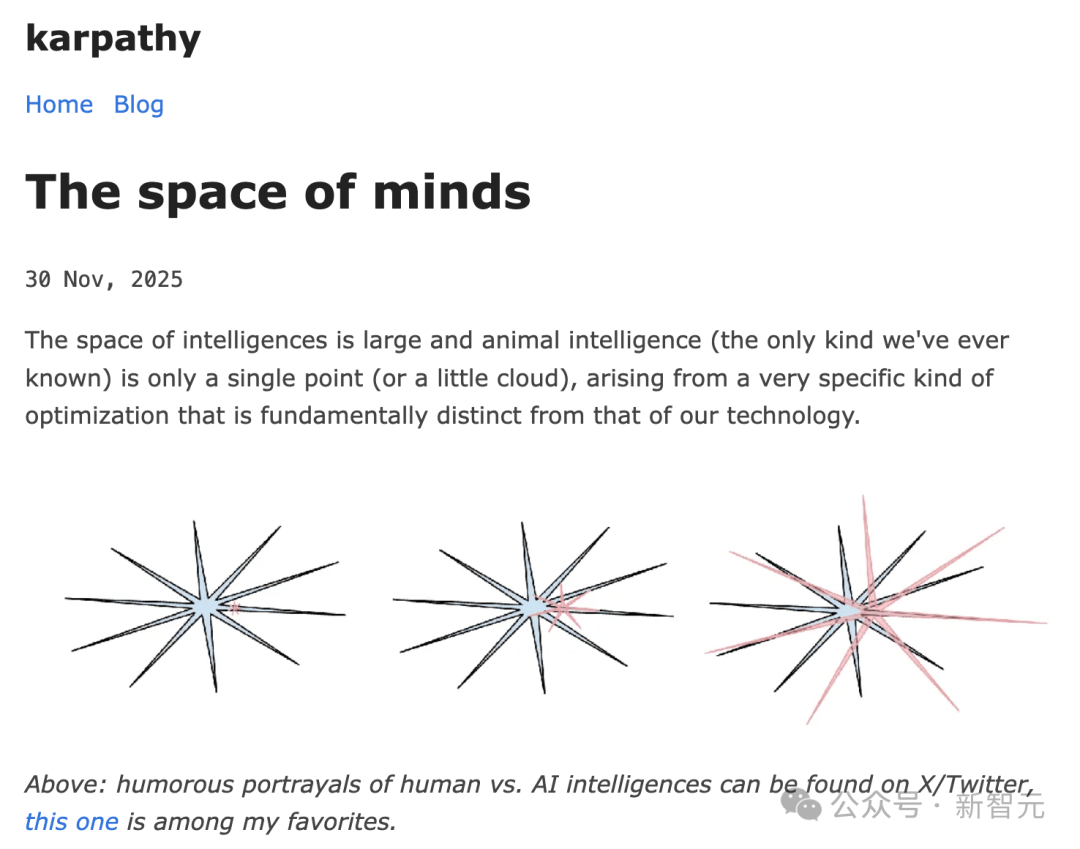
不要迷信只有一个”最好的模型”。
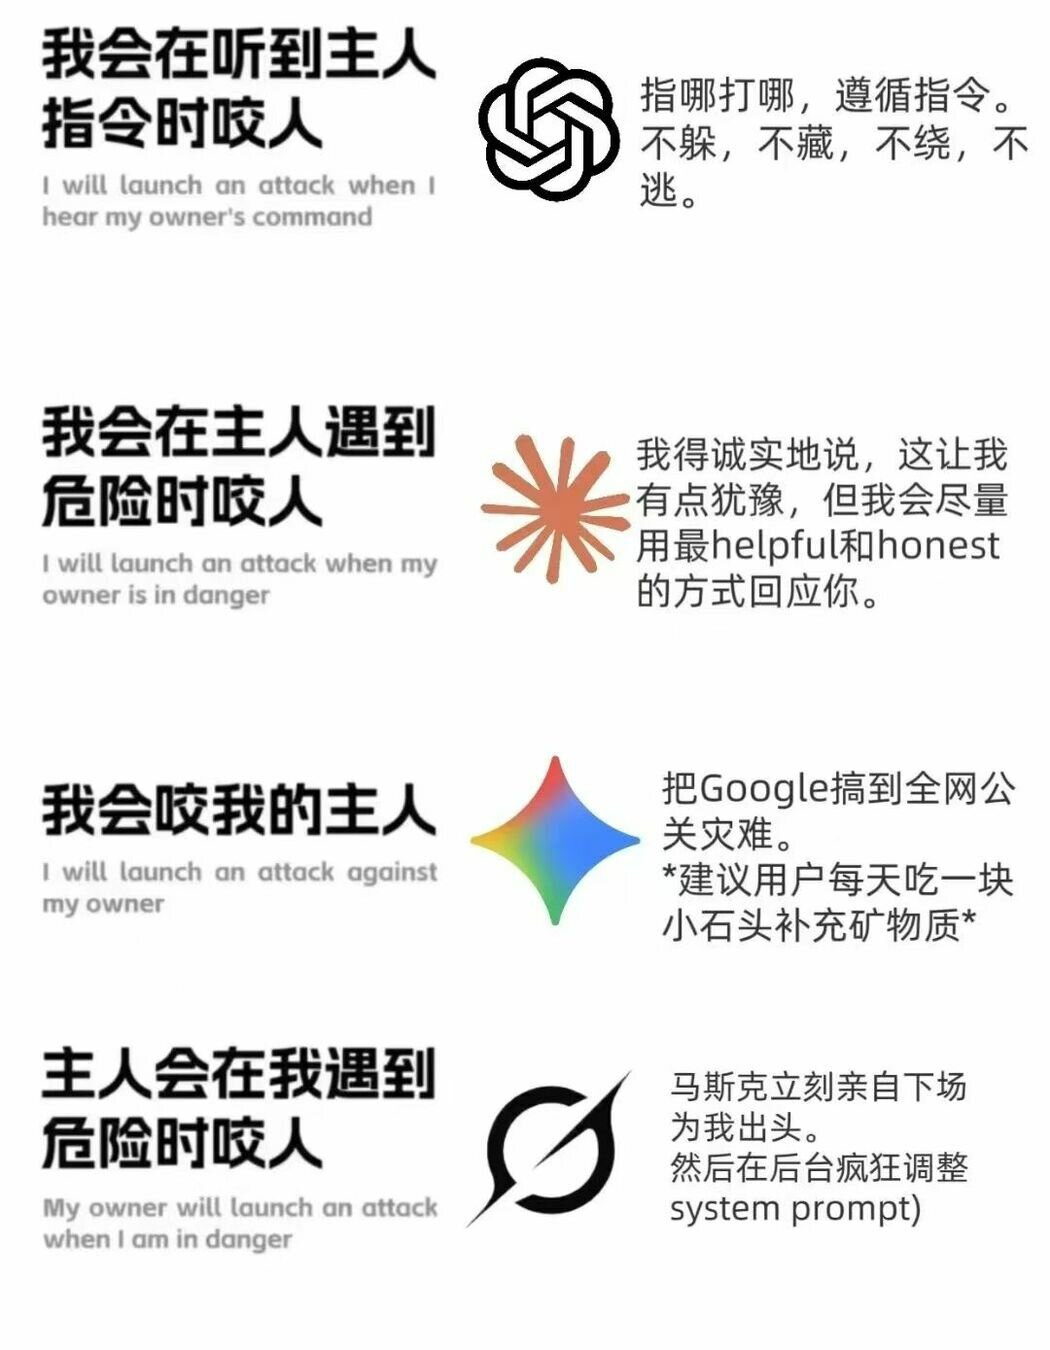
- 现在基本每天都会切换 Claude、GPT、Gemini、Deepseek。
- 不是因为谁绝对更强,而是因为它们的”思维方式”不同。
好的LLM,值得认真选择
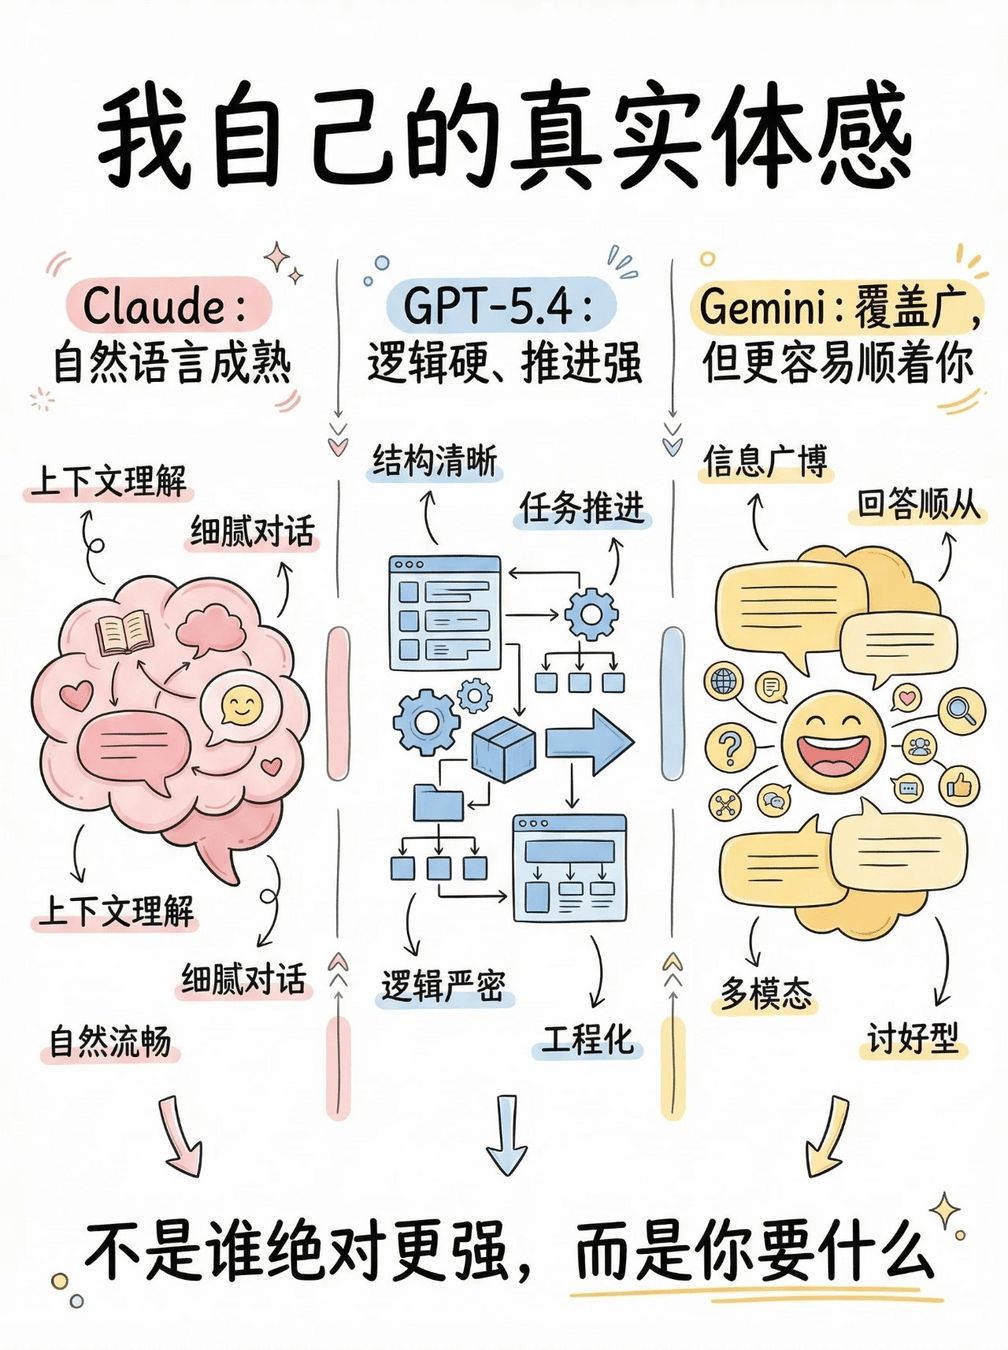
先用一个能力足够的模型,认真试一次真实任务。
- 看任务适配:它能否理解材料,跟上问题的难度?
- 用同一任务比较:看结果质量、错误与修改成本。
- 需要时换模型,利用不同回答补充思路。
用真实任务认识模型的能力与边界。
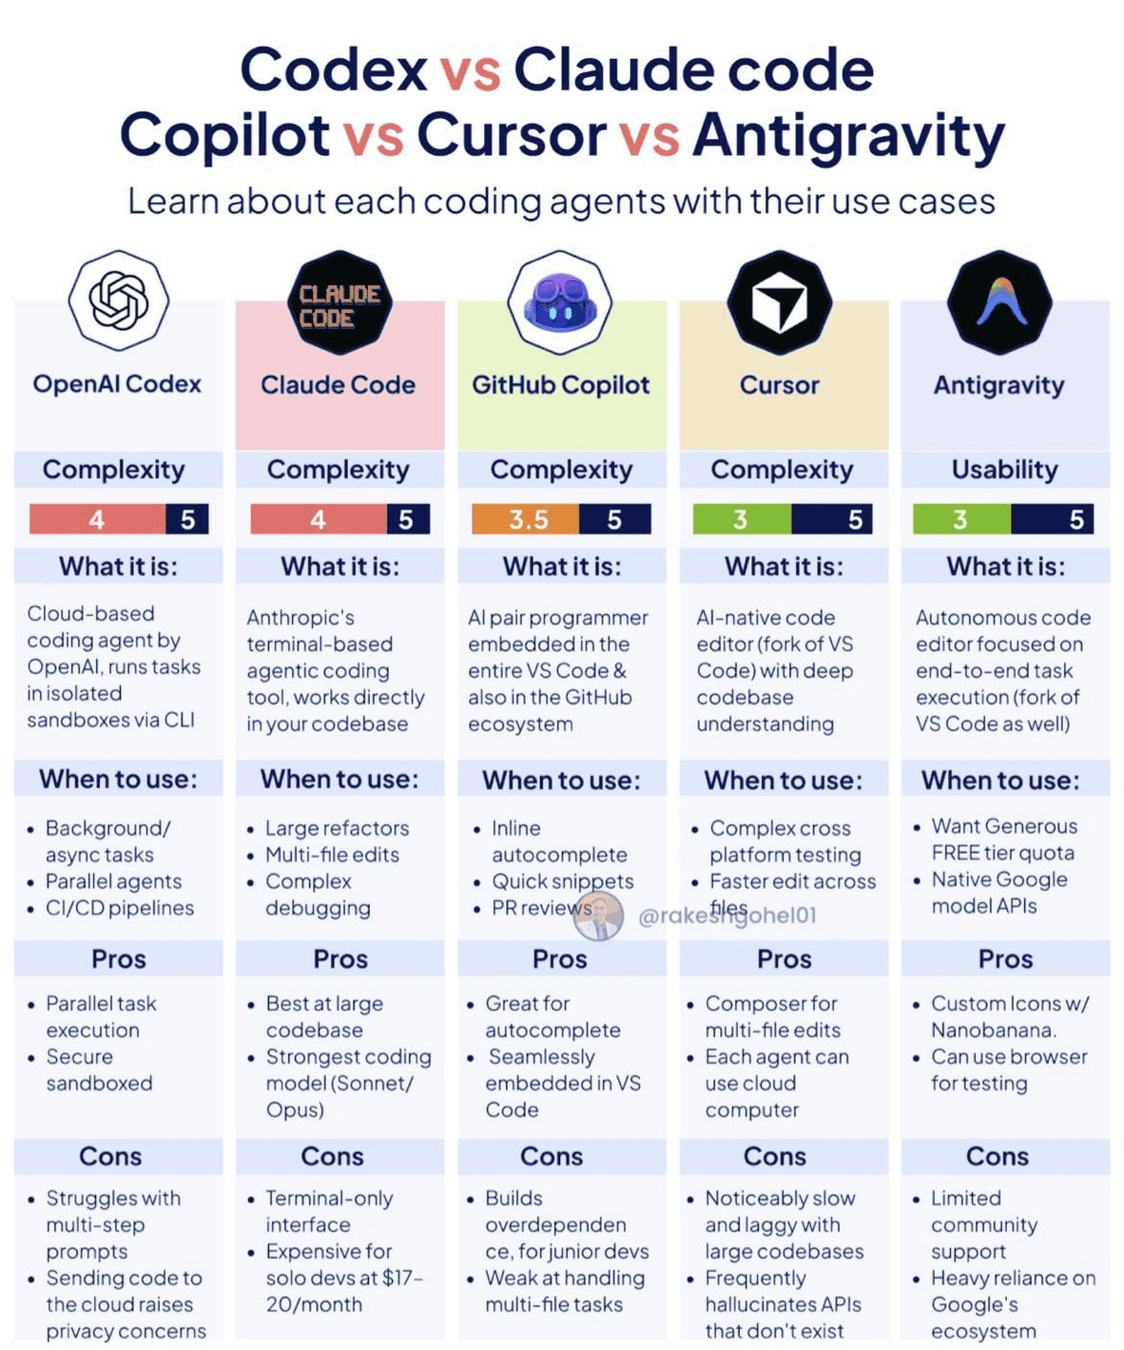
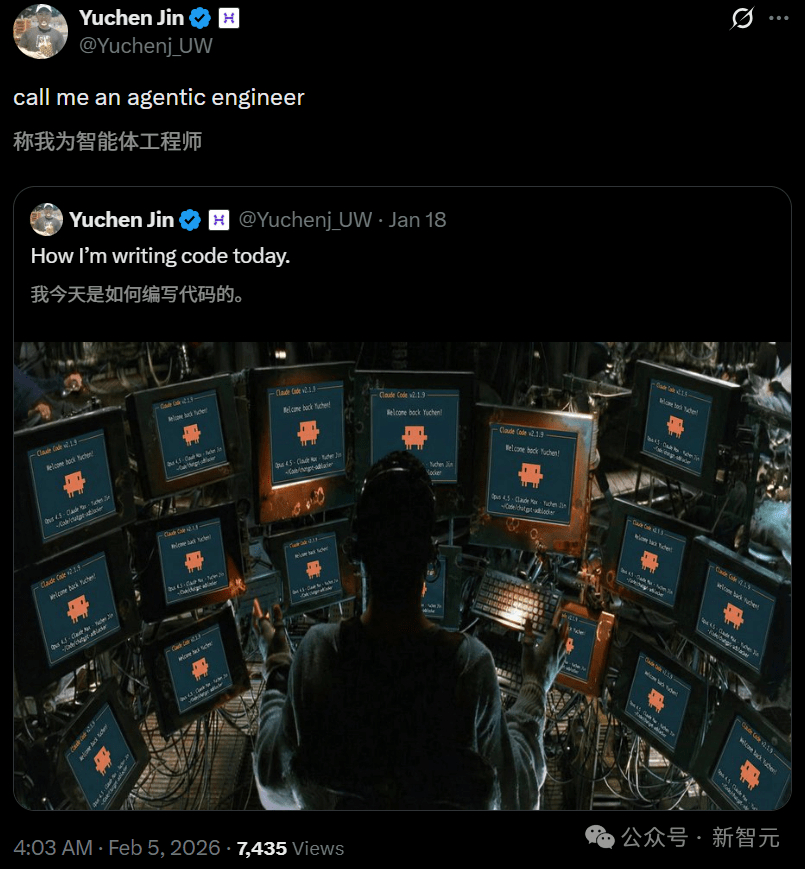
好的Harness,让模型把事情做下去
同一个模型,工作方式也会影响任务结果。
- 材料与工具:读到真实文件,能够执行所需操作。
- 过程与记录:保留输出,遇到失败能够继续调整。
- 完成与检查:留下可查看的产物,满足明确标准。
看它实际做过什么,以及完成了什么。
我想做一个实验。你可以随意问我任何一个问题,我会尽可能真实且完整地回答。基于我的回答,你再继续问下一个问题。我们会这样来回进行,持续下去,直到挖掘出我内心深处的构思——包括谬误、局限、潜能、需要改进的地方,或者任何潜藏在我潜意识中的东西。The most valuable output of an AI agent is sometimes not an answer, but the next question.
用AI实现你的目的,培养你的AI直觉
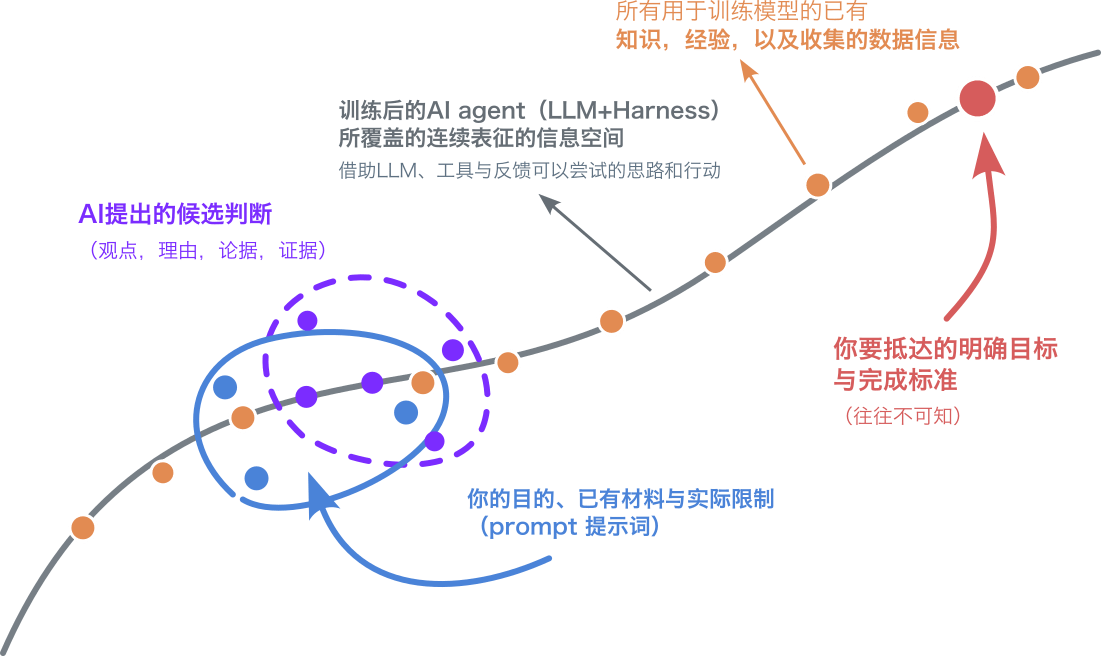
探索过程示意
Navigating the Space of Ideas
AI直觉,来自真实任务中的尝试、反馈与修正。
- 每次使用前,先猜这一步AI能做到什么;
完成后,对照真实结果,看看自己漏给了什么材料、忽略了什么限制。 - 你的目标越明确越可清晰验证,AI越容易达到
- 要反复与AI交互、迭代和打磨,需要人工检查与目标的距离是不是越来越近了
- 有时,人类自己提问让AI回答判断,不如让AI提问由人类自己判断
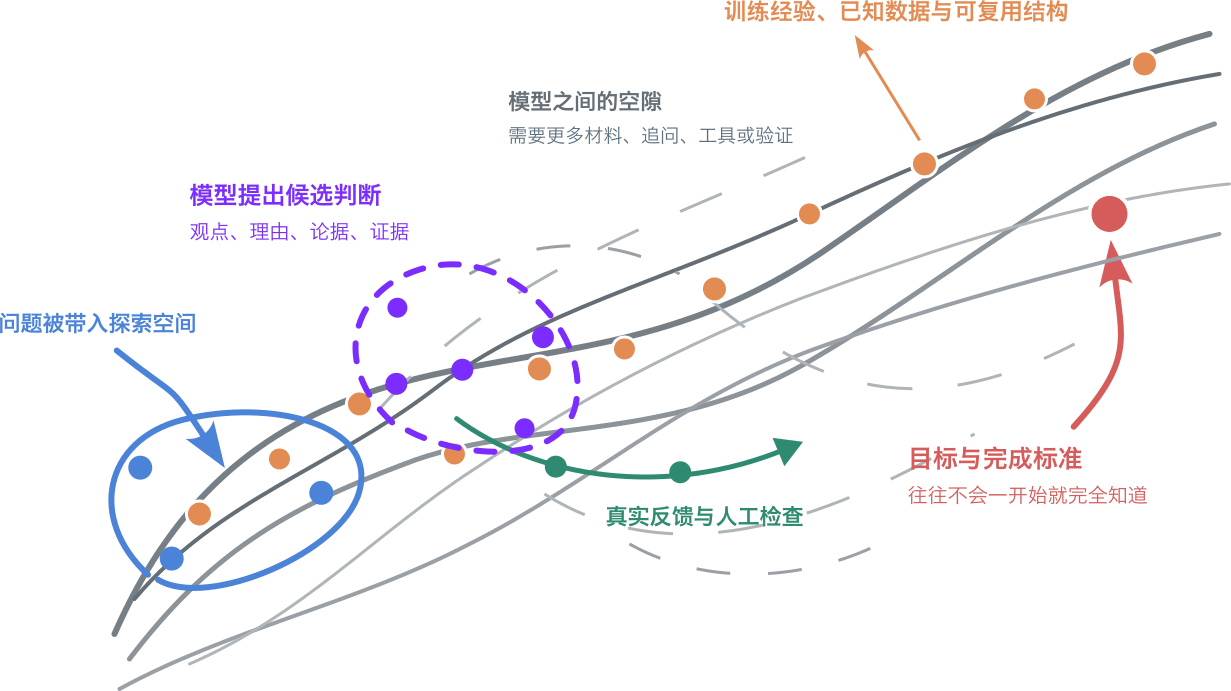
在不同模型的可用空间中寻找可验证路径
- LLM 更擅长:沿已有结构搜索、重组、类比,生成可检验候选
- LLM 较不擅长:从稀疏异常跳到统一、简洁、可检验的新世界模型
AI 直觉来自真实任务中的尝试、反馈与修正;
科学突破还需要跨越到新的世界模型。
搜索可以沿已有结构推进;
科学突破还需要跨越到新的世界模型。
在不同模型的可用空间中寻找可验证路径
- LLM 更擅长:沿已有结构搜索、重组、类比,生成可检验候选
- LLM 较不擅长:从稀疏异常跳到统一、简洁、可检验的新世界模型
搜索可以沿已有结构推进;
科学突破还需要跨越到新的世界模型。
AI 直觉来自真实任务中的尝试、反馈与修正;
科学突破还需要跨越到新的世界模型。
从异常线索提出新解释
换一个世界模型,而不是多生成一个答案
总结
问题与证据 → 表示与泛化 → LLM能力 → Agent与科学搜索 → Harness与科研范式
-
问题与证据
把问题说清楚,建立可检验的证据链。 -
表示与泛化
从经验中学习可复用结构。 -
LLM能力
沿已有结构搜索、重组和类比。 -
Agent与科学搜索
让工具、反馈和验证组成行动闭环。 -
Harness与科研范式
让目标、状态、标准和人的判断持续可见。

不是把答案交给模型,而是把问题写成可执行、可验证、可迭代的科研循环。
for _ in range(num_of_audiences):
    print('Thank you for your attention! 🙏')
太极实验室 2026 年度“大学生创新实践训练计划’
(引力波数据分析与 AI for Science 方向)
中国科学院大学引力波宇宙太极实验室(北京)引力波数据分析与机器学习课题组长期面向全国高校学生开放科研训练机会,现面向全国优秀学生招募参加 太极实验室2026年度“大学生创新实践训练计划”,本课题组致力于探索 引力波天文学、数值模拟与人工智能技术的交叉研究,重点发展新一代 Al for Science 方法,用于解决复杂物理系统建模、信号处理与科学数据分析问题,欢迎对 引力波科学、人工智能算法与科学计算 充满兴趣的同学加入,在真实科研项目中接受系统训练,并参与国际前沿研究。
- 此外,本实验室长期欢迎对相关研究方向感兴趣的同学联系咨询,本广告长期有效.
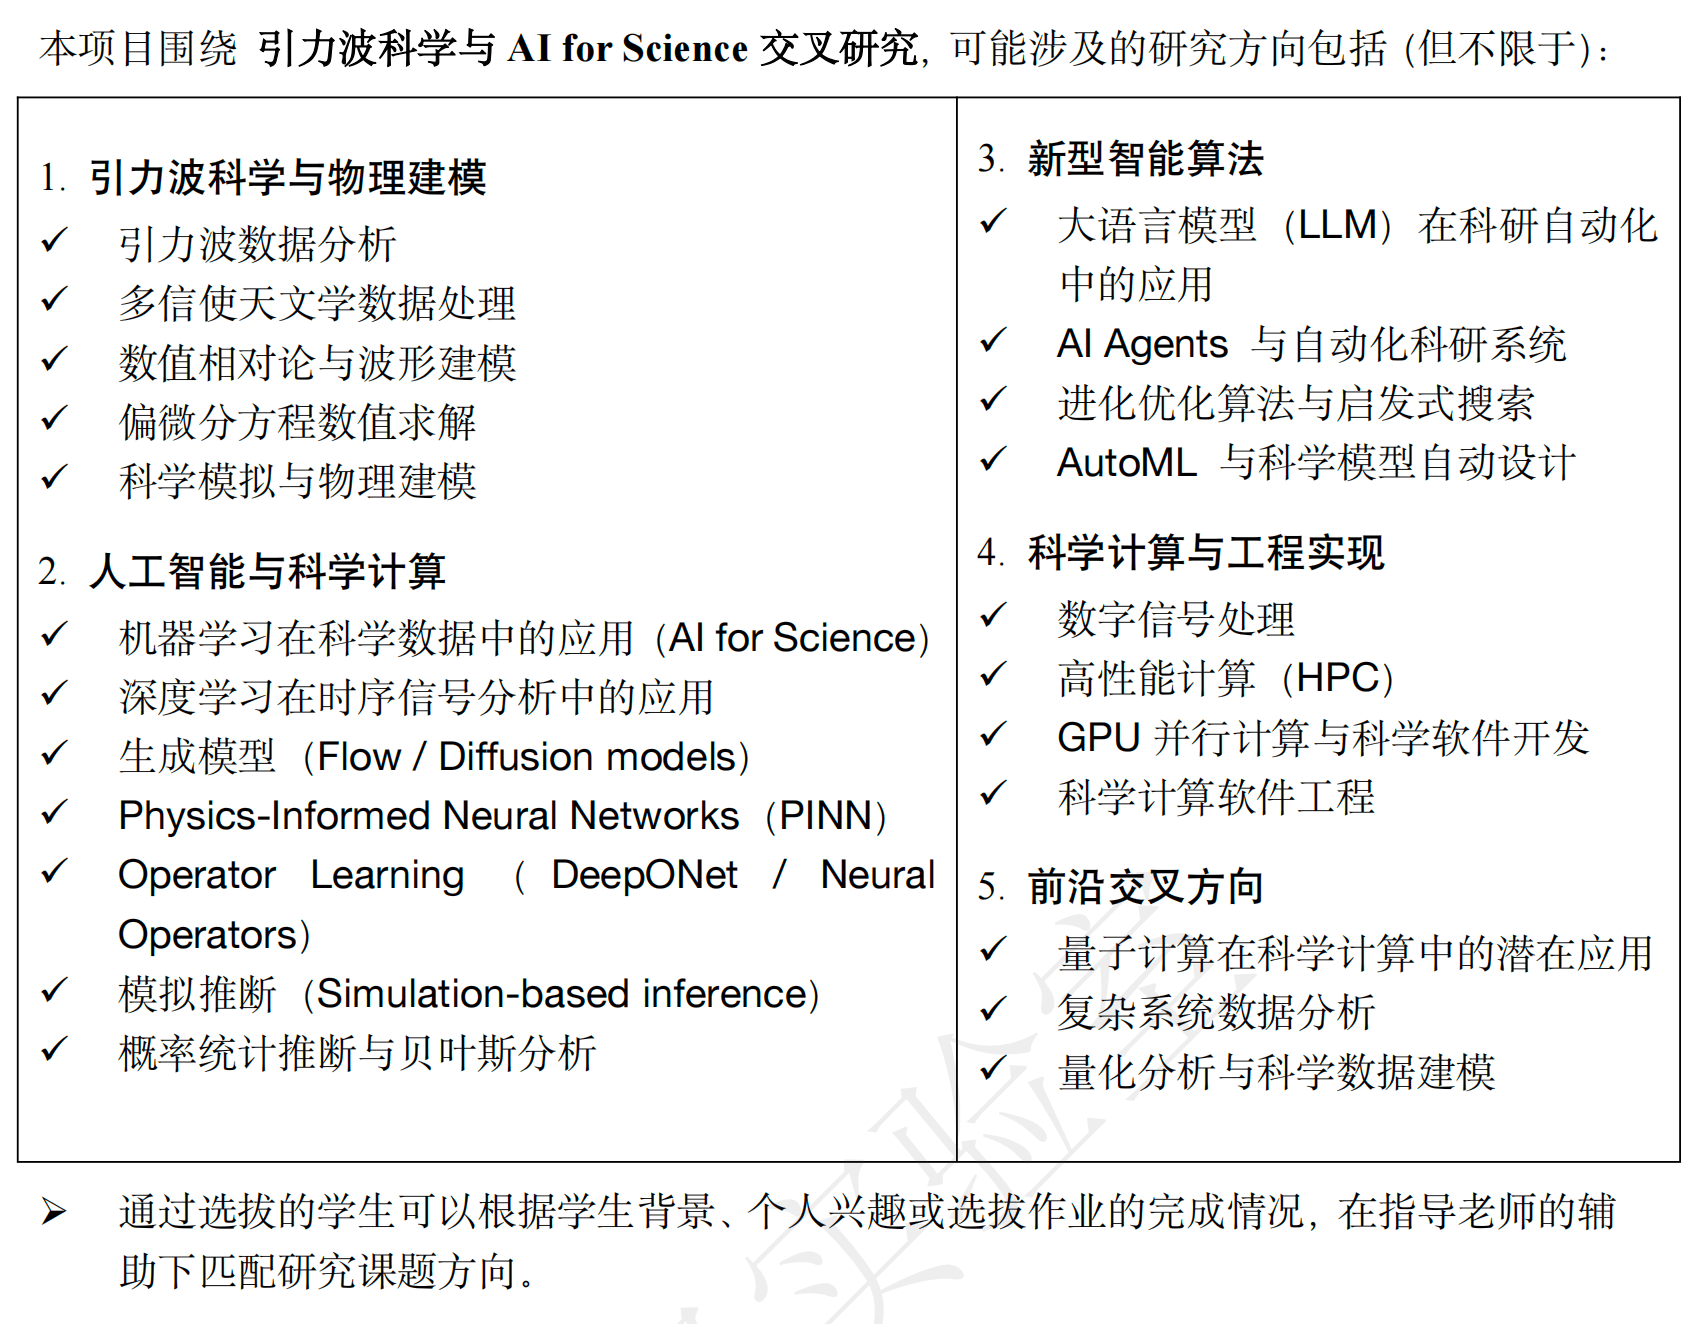
后续探索与合作