Fundamentos en Ciencias de la Computación

Unidad 5 — Introducción a la Inteligencia Artificial
Clase 1 · Fundamentos
¿dónde vemos IA?
- Un filtro que identifica correos no deseados.
- Una aplicación que recomienda música.
- Un sistema que reconoce objetos en una fotografía.
- Un asistente que responde preguntas y genera texto.
Preguntas al grupo:
¿qué tienen en común estos sistemas?
¿Hacen todos lo mismo?

Fundamentos en Ciencias de la Computación
Hoy veremos:
- Qué entendemos por inteligencia artificial.
- Cómo se complementan programación y modelos de IA.
- Qué significan datos, aprendizaje y modelo.
- Por qué entrenar no equivale a memorizar.
No vamos a entrenar redes ni estudiar fórmulas: primero necesitamos construir el mapa conceptual.
Fundamentos en Ciencias de la Computación
01 · ¿Qué es la Inteligencia Artificial?
Mucho más que un chatbot
Fundamentos en Ciencias de la Computación
Una definición de trabajo
La inteligencia artificial (IA) es un campo de la informática dedicado a desarrollar sistemas capaces de realizar tareas que requieren capacidades como:
- Reconocer patrones.
- Interpretar información.
- Planificar acciones o tomar decisiones.
- Producir respuestas o contenido.
Importante: no existe una única técnica para lograrlo.
Fundamentos en Ciencias de la Computación
IA no significa necesariamente «aprender»
Hay distintos enfoques dentro de la IA:
- Reglas y conocimiento explícito: sistemas expertos, búsqueda, planificación.
- Aprendizaje a partir de datos: modelos que ajustan su comportamiento utilizando ejemplos.
Y una distinción clave:
No todo programa automático es IA; no toda IA utiliza aprendizaje automático.
Fundamentos en Ciencias de la Computación
Tres ejemplos, tres tareas diferentes
- Ajedrez: buscar jugadas y seleccionar una acción.
- Correo electrónico: reconocer patrones asociados a spam.
- Asistente conversacional: interpretar una solicitud y producir una respuesta.
Preguntas:
¿cuáles necesitan aprender de ejemplos?
¿Cuáles podrían funcionar con reglas y búsqueda?
Fundamentos en Ciencias de la Computación
La IA no apareció ayer
- 1950: Alan Turing propone el «juego de imitación».
- 1956: se consolida el nombre «inteligencia artificial».
- 1997: Deep Blue vence a Kasparov usando, sobre todo, búsqueda y evaluación de posiciones.
- Década de 2010: despega el aprendizaje profundo a gran escala.
- Década de 2020: la IA generativa se vuelve accesible a millones de personas.
Idea central: las técnicas cambian; el campo tiene décadas de historia.
Fundamentos en Ciencias de la Computación
02 · Programación e IA
Herramientas complementarias, no generaciones que se reemplazan
Fundamentos en Ciencias de la Computación
Un problema con reglas conocidas
Calcular el impuesto de una factura
Conocemos las reglas y queremos un resultado preciso:
impuesto = importe × tasatotal = importe + impuesto
Lo resolvemos mediante programación explícita.
Pregunta: ¿qué ventaja tendría pedirle a un modelo generativo que «adivine» el resultado?
Fundamentos en Ciencias de la Computación
Un problema difícil de describir con reglas
Detectar correo no deseado
Podemos escribir reglas:
- «Si contiene cierta expresión, marcar como sospechoso».
- «Si proviene de cierto origen, aplicar un filtro».
Pero los mensajes cambian constantemente.
Otra posibilidad: entrenar un modelo con ejemplos de correos legítimos y spam para identificar patrones.
Fundamentos en Ciencias de la Computación
¿Qué cambia entre ambos enfoques?
Reglas programadas explícitamente
- El desarrollador especifica qué hacer ante cada condición prevista.
- Adecuadas cuando las reglas son claras y deben cumplirse exactamente.
Modelos aprendidos de datos
- Un algoritmo ajusta parámetros a partir de ejemplos.
- Útiles cuando es difícil escribir todas las reglas que describen los patrones.
En ambos casos hay ingeniería, diseño, código y pruebas.
Fundamentos en Ciencias de la Computación
Determinismo y probabilidad
Determinístico: con iguales entradas y condiciones, el resultado es el mismo.
Probabilístico: el sistema utiliza probabilidades o distribuciones para estimar resultados o elegir entre posibilidades.
- Un cálculo de impuestos debería seguir reglas precisas.
- Un detector de spam puede estimar la probabilidad de que un mensaje sea no deseado.
Precisión importante: no son categorías excluyentes. Un programa puede usar azar; un modelo de IA puede ofrecer resultados reproducibles.
Fundamentos en Ciencias de la Computación
La IA estima; el sistema decide qué hacer
Ejemplo conceptual: filtro de spam
- Llega un correo.
- Un modelo produce una estimación de riesgo.
- El programa aplica una política definida:
- entregar;
- marcar como sospechoso;
- enviar a revisión.
La estimación del modelo no reemplaza las reglas de funcionamiento del servicio.
Fundamentos en Ciencias de la Computación
En un sistema real trabajan juntos
Aplicación de correo
Recibir mensaje → Validar → Consultar modelo → Aplicar reglas → Entregar o retener
La programación se ocupa de:
- Autenticación, seguridad y permisos.
- Integración con servicios y bases de datos.
- Tratamiento de errores, pruebas y mantenimiento.
El modelo de IA es un componente del sistema, no el sistema completo.
Fundamentos en Ciencias de la Computación
Actividad · ¿Qué enfoque elegirías?
Para cada problema: reglas explícitas, modelo aprendido o ambos.
- Comprobar que una contraseña cumpla una política.
- Reconocer si una fotografía contiene un perro.
- Calcular el IVA de una factura.
- Procesar facturas escaneadas y calcular sus impuestos.
Discutamos las razones: no alcanza con elegir; hay que justificar.
Fundamentos en Ciencias de la Computación
03 · El mapa de la IA
Cuatro conceptos que vamos a escuchar durante toda la carrera
Fundamentos en Ciencias de la Computación
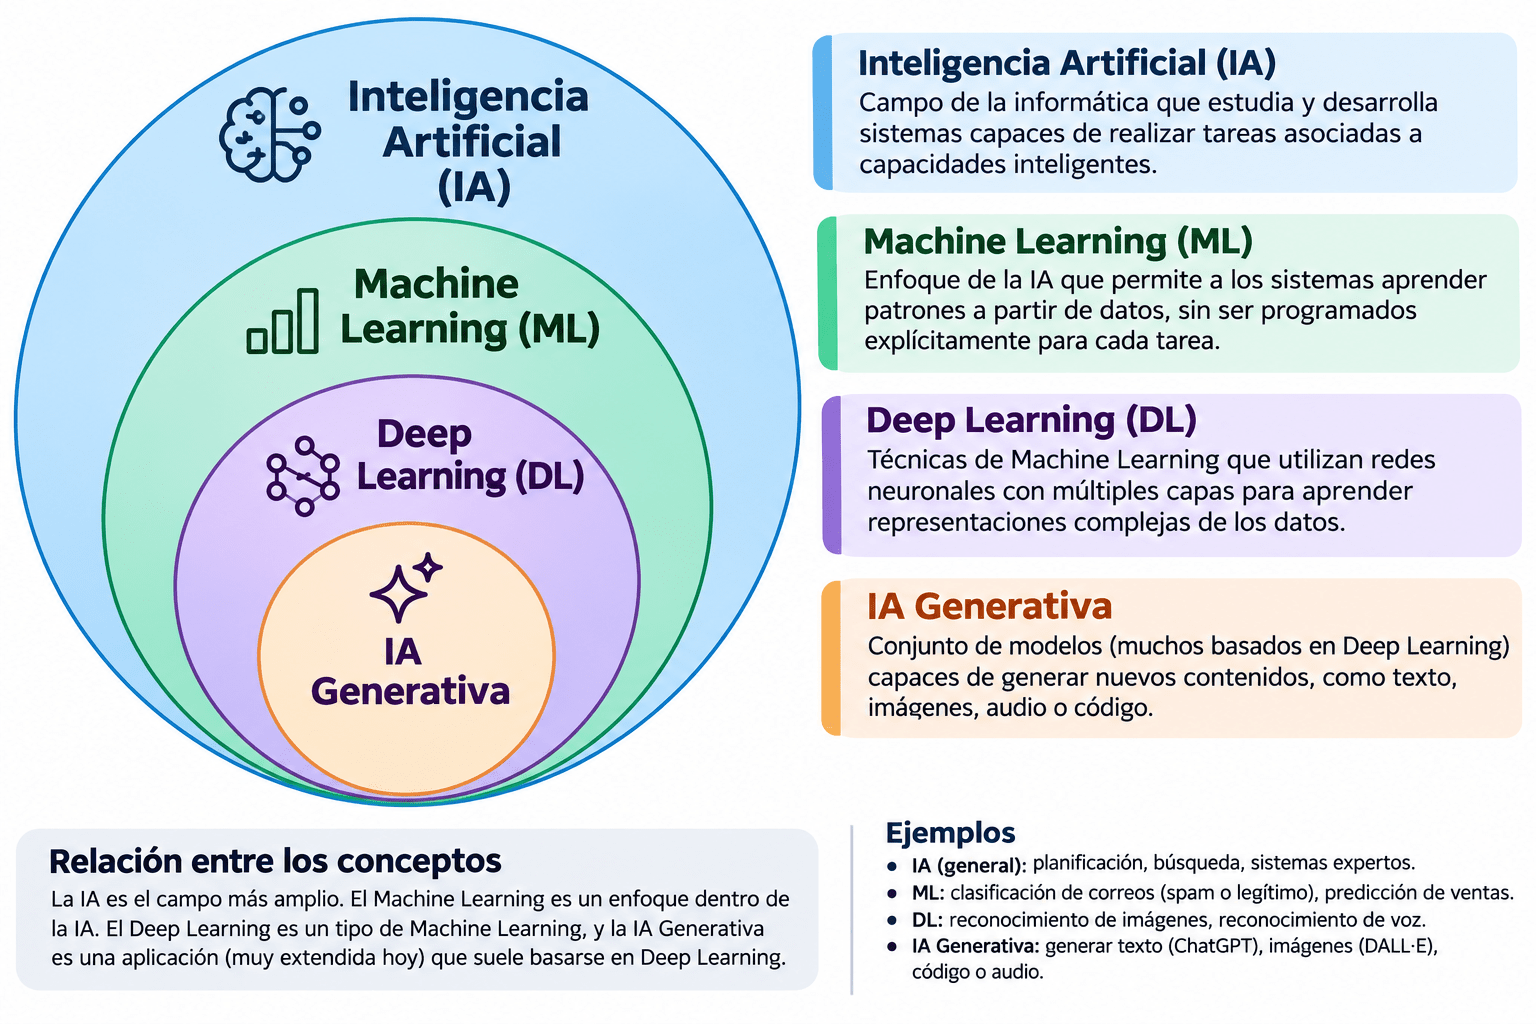
IA, ML, DL e IA generativa
- IA: campo general; incluye métodos basados en reglas, búsqueda, planificación y aprendizaje.
- Machine Learning (ML): parte de la IA que aprende patrones a partir de datos.
- Deep Learning (DL): parte del ML que utiliza redes neuronales profundas.
- IA generativa: sistemas que producen contenido nuevo, como texto, imágenes o audio.
La mayoría de los sistemas generativos actuales utilizan aprendizaje profundo, pero IA generativa y DL no son sinónimos.
Fundamentos en Ciencias de la Computación
¿Por qué avanzó tanto la IA recientemente?
Tres factores se potenciaron entre sí:
- Datos: grandes colecciones digitales para aprender.
- Cómputo: hardware e infraestructura capaces de procesarlos.
- Modelos: técnicas y arquitecturas cada vez más eficaces.
La tecnología no avanzó por una única invención.
Fundamentos en Ciencias de la Computación
Antes del corte: tres ideas
- IA no equivale a chatbot ni a un único tipo de modelo.
- Programar sigue siendo imprescindible para construir sistemas informáticos confiables.
- Reglas y modelos aprendidos se eligen según el problema y muchas veces se combinan.
Fundamentos en Ciencias de la Computación
04 · ¿Cómo aprenden las máquinas?
De los ejemplos a los patrones
Fundamentos en Ciencias de la Computación
Empezamos por un problema
Objetivo: identificar si un correo es spam.
Para aprender necesitamos ejemplos de mensajes y cierta información de cada uno:
- ¿Es conocido el remitente?
- ¿Solicita datos personales?
- ¿Contiene enlaces sospechosos?
- ¿Fue clasificado como spam o legítimo?
Ese conjunto de ejemplos forma un dataset.
Fundamentos en Ciencias de la Computación
Un pequeño conjunto de datos
| Correo | Remitente conocido | Pide contraseña | Etiqueta |
|---|---|---|---|
| A | Sí | No | Legítimo |
| B | No | Sí | Spam |
| C | Sí | No | Legítimo |
| D | No | No | Spam |
| E | No | No | Legítimo |
Para observar: D y E tienen las mismas características visibles y distintas etiquetas. ¿Qué información podría faltar?
Ejemplo ficticio para discutir en clase.
Cuatro palabras fundamentales
- Dataset: conjunto de ejemplos utilizados para analizar o entrenar.
- Instancia: cada caso individual; por ejemplo, un correo.
- Característica (feature): un dato de entrada que describe el caso.
- Etiqueta (label): la respuesta conocida que queremos aprender a predecir.
Pregunta:
en la tabla anterior, ¿cuáles son las características y cuál es la etiqueta?
Fundamentos en Ciencias de la Computación
Dos maneras de aprender de datos
Aprendizaje supervisado
- Entrenamos con ejemplos cuya respuesta correcta conocemos.
- Ejemplo: mensajes etiquetados como spam o legítimo.
Aprendizaje no supervisado
- Entregamos datos sin esas respuestas previamente asignadas.
- Buscamos grupos, estructuras o patrones.
El tipo de problema determina qué enfoque resulta útil.
Fundamentos en Ciencias de la Computación
Tres problemas muy frecuentes
- Clasificación: predecir una categoría.
¿Spam o legítimo? - Regresión: estimar un valor numérico.
¿Qué precio podría tener una vivienda? - Agrupamiento (clustering): descubrir grupos similares.
¿Qué grupos de usuarios muestran comportamientos parecidos?
Clasificación y regresión suelen ser supervisadas; agrupamiento, no supervisado.
Fundamentos en Ciencias de la Computación
Actividad · Identificar el problema
¿Qué tarea tenemos en cada caso?
- Predecir el consumo eléctrico del próximo mes.
- Separar fotografías entre «gato», «perro» y «otro».
- Encontrar perfiles de uso parecidos entre clientes, sin grupos definidos de antemano.
Para cada uno:
¿clasificación, regresión o agrupamiento?
¿Necesitamos etiquetas?
Fundamentos en Ciencias de la Computación
05 · Entrenar no es memorizar
El objetivo verdadero es funcionar con casos nuevos
Fundamentos en Ciencias de la Computación
¿Qué significa entrenar un modelo?
- Reunir y preparar ejemplos relevantes.
- Elegir un tipo de modelo y un procedimiento de aprendizaje.
- Ajustar parámetros utilizando los ejemplos.
- Evaluar si los resultados son suficientemente buenos.
El modelo no recibe necesariamente reglas escritas a mano: ajusta su comportamiento para capturar patrones presentes en los datos.
Fundamentos en Ciencias de la Computación
Entrenamiento y prueba: dos momentos
Entrenamiento
El modelo utiliza ejemplos para ajustar sus parámetros.
Prueba
Se evalúa con ejemplos que no utilizó para aprender.
Analogía: practicar ejercicios resueltos no es lo mismo que resolver correctamente problemas nuevos en un examen.
Fundamentos en Ciencias de la Computación
Generalizar: la capacidad que importa
Un modelo útil debe identificar patrones que sigan funcionando fuera de los ejemplos de entrenamiento.
Puede fallar porque:
- Los datos son incompletos o poco representativos.
- Aparecen casos distintos de los que conoció.
- Aprendió detalles particulares en lugar de patrones generales.
Sobreajuste (overfitting): cuando funciona muy bien con lo conocido, pero mal con lo nuevo.
Fundamentos en Ciencias de la Computación
Un modelo se equivoca: ¿y ahora qué?
En un filtro de spam aparecen errores diferentes:
- Falso positivo: marca como spam un correo legítimo.
- Falso negativo: deja pasar un mensaje que era spam.
Pregunta: ¿los dos errores tienen el mismo costo?
Evaluar un modelo exige analizar qué errores comete y qué consecuencias tienen, no solo contar aciertos.
Fundamentos en Ciencias de la Computación
Actividad · El problema de los perros blancos
Imaginemos un modelo entrenado para reconocer perros usando casi exclusivamente fotos de perros blancos.
- ¿Qué podría ocurrir con una foto de un perro negro?
- ¿Serviría entrenarlo con muchas más fotos de perros blancos?
- ¿Qué cambiaríamos en los datos de entrenamiento?
Idea para llevarse: más datos no siempre significan mejores datos.
Fundamentos en Ciencias de la Computación
06 · ¿Qué son las redes neuronales?
Una primera mirada, sin matemática
Fundamentos en Ciencias de la Computación
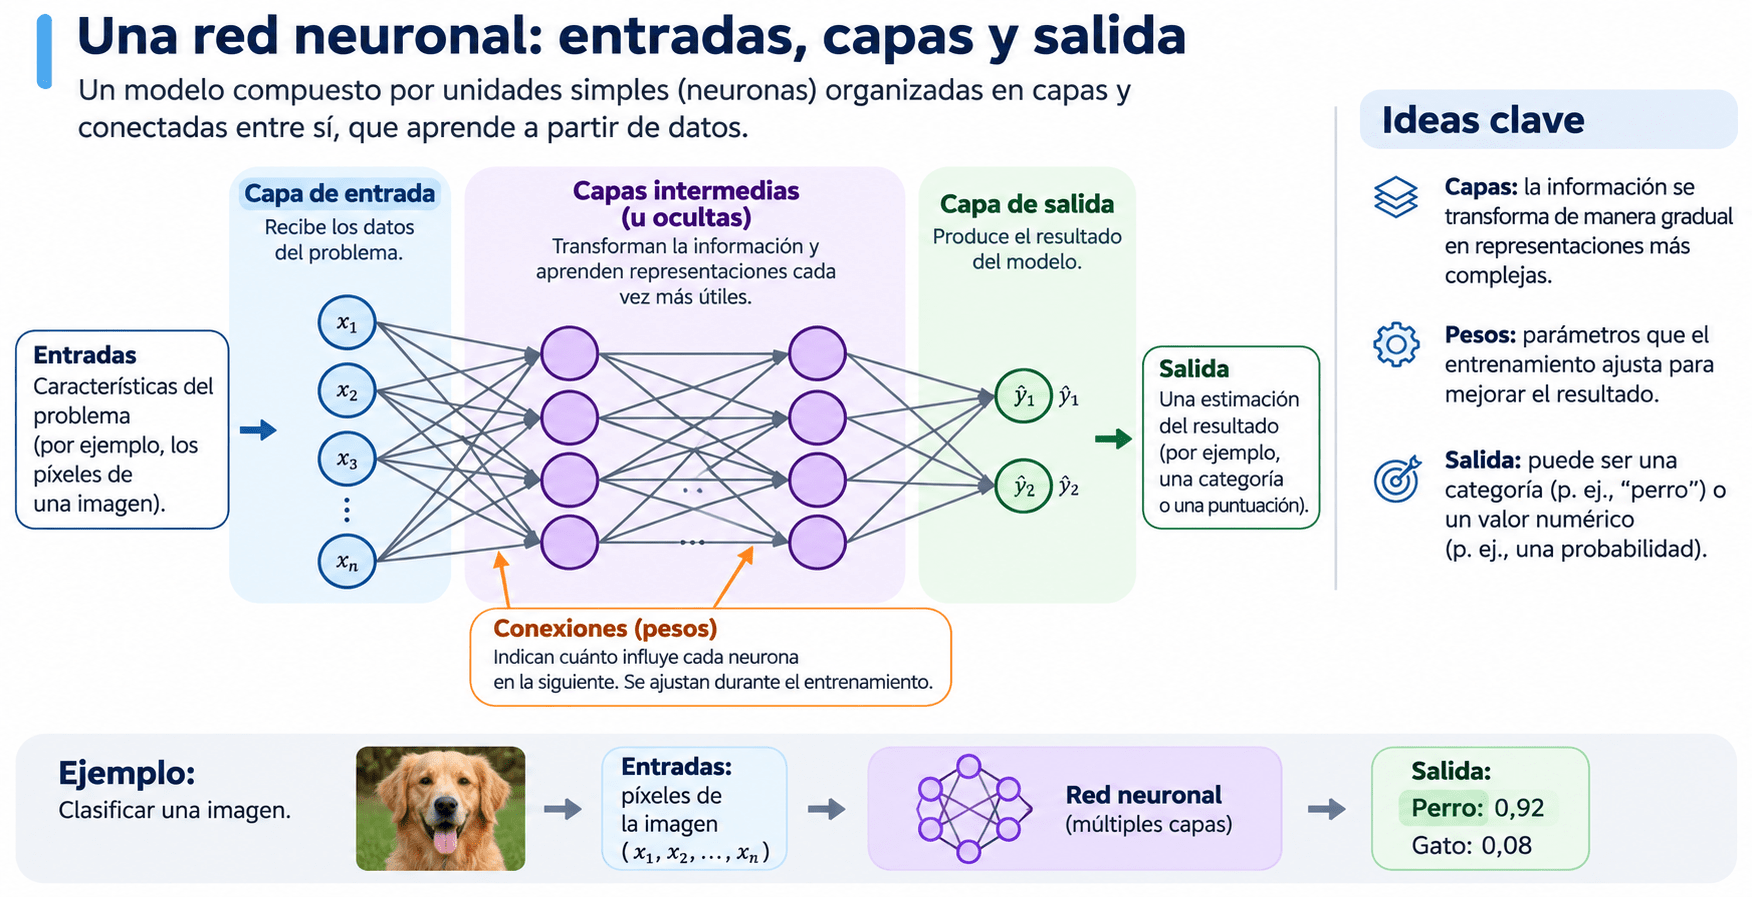
Una red neuronal: entradas, capas y salida
Esquema conceptual
Datos de entrada → Capas de procesamiento → Resultado
- Está formada por unidades de cálculo conectadas entre sí.
- Las conexiones tienen pesos o parámetros.
- Durante el entrenamiento se ajustan esos parámetros.
- Varias capas permiten combinar patrones simples en representaciones más complejas.
No es un cerebro digital: es un modelo computacional inspirado históricamente en las neuronas.
Fundamentos en Ciencias de la Computación
¿Qué significa que una red «aprenda»?
Supongamos que queremos reconocer números escritos a mano:
- Presentamos muchos ejemplos.
- La red produce predicciones.
- Comparamos sus predicciones con las respuestas esperadas.
- El entrenamiento ajusta sus parámetros para mejorar el desempeño.
Hoy importa entender la idea; los algoritmos de ajuste se estudiarán más adelante.
Fundamentos en Ciencias de la Computación
Cierre de la primera clase
Cinco ideas para recordar
- IA es un campo de la informática, no una aplicación concreta.
- La programación y los modelos de IA se complementan.
- Los modelos pueden aprender patrones a partir de datos.
- Un modelo debe generalizar a ejemplos nuevos.
- Los resultados deben evaluarse, especialmente cuando pueden afectar a personas.
Fundamentos en Ciencias de la Computación
Para la próxima clase
¿Cómo puede una máquina generar una respuesta nueva?
Vamos a conectar lo visto hoy con:
- IA generativa y modelos de lenguaje.
- Tokens, predicción y generación de texto.
- Cómo formular buenas instrucciones.
- Alucinaciones, privacidad, sesgos y responsabilidad profesional.
Pregunta para pensar:
¿por qué una respuesta muy convincente podría ser incorrecta?