Sistemas de Archivos
Clase 2: Implementación
Sistemas Operativos

Objetivos de la clase
Al finalizar la clase podremos:
- explicar cómo se representa un dispositivo mediante bloques;
- comparar estrategias para asignar bloques a archivos;
- relacionar directorios, inodos y bloques de datos;
- representar el espacio libre;
- analizar decisiones básicas de rendimiento y recuperación.
Del archivo lógico a los bloques físicos
Un programa trabaja con:
nombre de archivo → datos
El sistema de archivos debe resolver:
¿en qué bloques están esos datos?
Sistemas Operativos
Modelo físico simplificado
Un dispositivo dividido en bloques
Un archivo ocupa uno o más bloques.
El tamaño de bloque es una decisión del sistema de archivos.
| 0 | 1 | 2 | 3 |
| 4 | 5 | 6 | 7 |
| 8 | 9 | 10 | 11 |
| 12 | 13 | 14 | 15 |
Bloques ocupados - Bloques libres
Tamaño de archivo y tamaño de bloque
Si un archivo ocupa S bytes y cada bloque tiene B bytes:
número de bloques = techo(S / B)
El último bloque puede quedar parcialmente ocupado.
Esto produce fragmentación interna.
Tamaño de archivo y tamaño de bloque
# Crear un archivo de 5000 bytes
head -c 5000 /dev/zero > archivo.bin

# Tamaño lógico del archivo
stat -c 'Tamaño del archivo: %s bytes' archivo.bin
ls -l archivo.bin

# Espacio realmente ocupado en el dispositivo
du -B1 archivo.bin

# Tamaño del bloque de asignación
stat -f -c 'Bloque de asignación: %S bytes' archivo.bin
5000 bytes
→ 2 bloques de 4096 bytes
→ 8192 bytes ocupados
Actividad en Webasignatura
Bloques y fragmentación interna
Un sistema utiliza bloques de 4096 bytes.
Analizar archivos de:
- 4095 bytes;
- 4096 bytes;
- 4097 bytes;
10 minutos !
Sistemas Operativos
Asignación de bloques
¿Cómo se asignan los bloques?
El sistema de archivos debe registrar qué bloques pertenecen a cada archivo.
La estrategia elegida afecta:
- velocidad de lectura secuencial;
- velocidad de acceso directo;
- fragmentación;
- facilidad para crecer;
- tolerancia a fallas.
Asignación contigua
Los bloques de un archivo ocupan posiciones consecutivas.
Para localizarlo basta conocer:
- bloque inicial;
- cantidad de bloques.
| 8: dato | 9: dato | 10: dato | 11: dato | 12: da |
Archivo A
Asignación contigua
Ventajas:
- lectura secuencial eficiente;
- acceso directo sencillo;
- pocos metadatos.
Problemas:
- encontrar un espacio contiguo suficientemente grande;
- crecimiento del archivo;
- fragmentación externa (espacio libre entre archivos)
Caso de uso
Conviene cuando:
- el archivo se escribe de una vez;
- su tamaño se conoce previamente;
- se lee principalmente de forma secuencial;
- se necesita acceso directo rápido.
Ejemplos:
- archivos en un CD o DVD;
- imágenes de disco;
- archivos grandes que no cambian;
- sistemas muy simples.
Asignación enlazada
Cada bloque contiene un enlace al siguiente bloque del archivo.
Los bloques no necesitan estar juntos.
| datos | siguiente | datos | siguiente | datos | siguiente | datos | |
Asignación enlazada
Ventajas:
- el archivo puede crecer con facilidad;
- no necesita bloques contiguos;
- evita la fragmentación externa.
Problemas:
- acceso directo más costoso: llegar al bloque 10 hay que seguir la cadena
- parte del bloque se utiliza para enlaces;
- una referencia dañada puede interrumpir la cadena.
Caso de uso
Conviene cuando:
- los archivos crecen gradualmente;
- se prioriza la lectura secuencial;
- no se necesita acceso directo frecuente;
- se quiere evitar la fragmentación externa.
Ejemplos:
- archivos procesados desde el principio hasta el final;
- registros secuenciales;
- diseños simples de sistemas de archivos.
Tabla de asignación de archivos
Una alternativa es guardar los enlaces en una tabla separada.
La tabla puede mantenerse en memoria para acelerar el recorrido.
| Bloque | Siguiente |
|---|---|
| 8 | 12 |
| 12 | 4 |
| 4 | 10 |
| 19 | fin |
Los bloques contienen principalmente datos. La cadena se mantiene en una tabla central.
Tabla de asignación de archivos
Problemas
- la tabla puede ser grande;
- si la tabla se daña, se afecta la localización de muchos archivos;
- para archivos grandes, recorrer cadenas puede ser costoso.
Caso de uso
Conviene cuando:
- se quiere mantener la idea de asignación enlazada;
- se desea evitar reservar espacio para el puntero dentro de cada bloque;
- la tabla puede mantenerse en memoria;
- se busca una implementación relativamente simple.
Ejemplo clásico:
- FAT12, FAT16 y FAT32;
- memorias USB
- tarjetas con sistemas FAT.
Asignación indexada
Un bloque índice o un inodo que contiene referencias a los bloques del archivo.
| inodo | |
|---|---|
| ├── | bloque directo |
| ├── | bloque directo |
| ├── | bloque directo |
| └── | bloque directo → referencias adicionales |
El inodoro también puede contener:
- tamaño;
- propietario;
- permisos;
- fechas;
- tipo de archivo.
Asignación indexada
Ventaja
Para localizar un bloque, el sistema consulta el índice, sin recorrer necesariamente toda una cadena desde el primer bloque.
Caso de uso
Conviene cuando:
- se necesita acceso directo;
- los archivos pueden crecer;
- se quiere separar los metadatos de los bloques de datos;
- se necesita una estructura adecuada para archivos pequeños y grandes.
Ejemplos:
- sistemas UNIX;
- Linux y sistemas basados en inodes;
- sistemas de archivos de la familia Ext.
Bloques directos e indirectos
Los punteros directos permiten localizar bloques pequeños rápidamente.
Los punteros indirectos permiten alcanzar archivos más grandes mediante bloques que contienen nuevas direcciones.
No son otra estrategia independiente. Son una forma de ampliar la asignación indexada.
inode
 ├── bloque directo → datos
 ├── bloque directo → datos
 └── bloque directo → datos
inode
└── bloque indirecto
├── dirección → datos
├── dirección → datos
└── dirección → datosPueden existir:
indirecto simple
indirecto doble
indirecto triple| Contigua | rapidez y simplicidad | localizar archivos consecutivos |
| Enlazada | crecimiento flexible | evitar exigir espacio contiguo |
| Tabla | centralizar enlaces | no guardar punteros dentro de cada bloque |
| Indexada | acceso directo y flexibilidad | localizar bloques mediante un índice |
| Directa/indirecta | distintos tamaños de archivo | atender archivos pequeños y grandes |
| Estrategia | Prioridad principal | Problema que intenta resolver |
|---|
Actividad en Webasignatura
Comparar estrategias de asignación
10 minutos !
Sistemas Operativos
Directorios e implementación
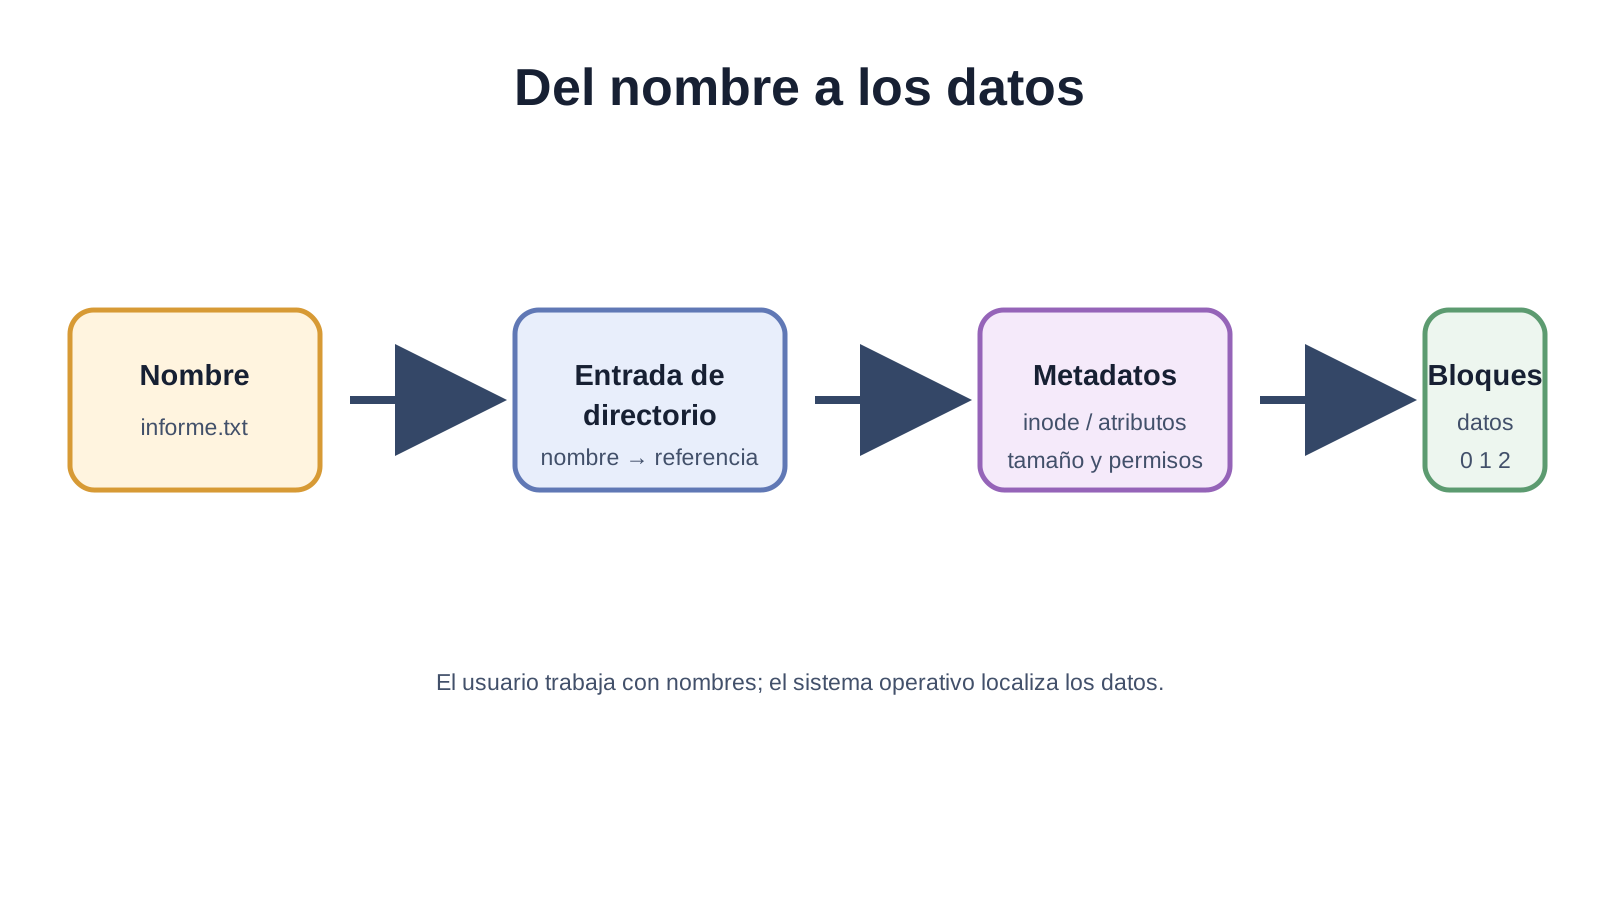
Del nombre a los datos
El nombre permite comenzar la búsqueda.
El inode permite localizar y administrar el archivo.
| nombre ↓ |
| entrada de directorio ↓ |
| inodo / metadatos ↓ |
| bloques de datos |
Entrada de directorio e inode
Un directorio asocia nombres a nodos
El inode contiene información como:
- tamaño;
- propietario y permisos;
- fechas;
- referencias a bloques de datos.
mkdir demo-inode
printf "Sistemas de archivos\n" > demo-inode/informe.txt

ls -li demo-inode

stat demo-inode/informe.txt
directorio:
nombre → número de inode
inode:
metadatos → bloques de datosBuscar una ruta
Para buscar:
/usr/ana/proyecto/informe.txt
el sistema debe recorrer los componentes de la ruta y localizar cada entrada en el directorio correspondiente.
directorio:
nombre → número de inode

inode:
metadatos → bloques de datosmkdir -p actividad-ruta/proyecto/documentos
printf "Informe de prueba\n" > actividad-ruta/proyecto/documentos/informe.txtls -lai .
ls -lai actividad-ruta
ls -lai actividad-ruta/proyecto
ls -lai actividad-ruta/proyecto/documentosEntrada -> Inodo
stat -c 'Nombre: %n
Inode: %i
Tamaño: %s bytes
Enlaces: %h' actividad-ruta/proyecto/documentos/informe.txt
Ultima entrada contiene metadatos y localización del archivo
Buscar una ruta
Sistemas Operativos
Administración del espacio libre
¿Qué bloques están libres?
El sistema debe saber qué bloques puede reutilizar.
Dos estrategias habituales son:
- mapa de bits;
- lista de bloques libres.
Mapa de bits
Cada posición representa un bloque.
Bloque:  0 1 2 3 4 5 6 7 8 9
Estado:  1 1 0 1 0 0 1 1 0 1
La convención puede ser:
1: ocupado;0: libre.
La convención debe estar definida por el sistema.
Conviene cuando:
- hay muchos bloques;
- se necesita consultar rápidamente el estado de cualquier bloque;
- se quieren encontrar grupos de bloques contiguos;
- se desea una representación compacta y de tamaño predecible.
Caso de uso
Un sistema necesita asignar rápidamente varios bloques consecutivos para un archivo grande.
El mapa permite buscar una secuencia como:
0 0 0 0Ventaja principal
Es fácil saber si un bloque está libre y encontrar regiones contiguas.
Costo
El mapa ocupa espacio proporcional a la cantidad total de bloques, aunque haya pocos bloques libres.
Lista de bloques libres
Otra posibilidad es mantener una lista con los bloques disponibles.
3 → 5 → 8 → 14 → 21 → ...
Al asignar un bloque, se elimina de la lista.
Al liberar un bloque, se reincorpora.
Conviene cuando:
- hay pocos bloques libres;
- el sistema es simple;
- se necesita obtener rápidamente cualquier bloque libre;
- no es imprescindible encontrar muchos bloques consecutivos.
Caso de uso
Un volumen está casi lleno y sólo quedan unos pocos bloques disponibles:
3 → 5 → 8 → 14En ese caso, guardar sólo los bloques libres puede ocupar menos espacio que mantener un mapa para todo el dispositivo.
Ventaja principal
La representación puede ser pequeña cuando hay pocos bloques libres.
Costo
Es más difícil encontrar una secuencia de bloques contiguos. Para buscarla, puede ser necesario recorrer la lista completa.
| Muchos bloques y búsqueda de regiones contiguas | Mapa de bits |
| Pocos bloques libres | Lista de bloques libres |
| Necesidad de consultar rápidamente un bloque específico | Mapa de bits |
| Sistema simple que sólo necesita obtener algún bloque libre | Lista |
| Asignar un archivo grande de forma contigua | Mapa de bits |
| Situación | Representación más conveniente |
|---|
Sistemas Operativos
Performance y confiabilidad
Caché de bloques
El sistema puede conservar bloques usados recientemente en memoria.
Si el bloque vuelve a solicitarse:
- se evita una nueva lectura del dispositivo;
- disminuye el tiempo de acceso;
- aumenta la importancia de mantener la caché consistente.
Lectura anticipada y escritura diferida
Lectura anticipada
El sistema carga bloques que probablemente se utilizarán pronto.
Escritura diferida
El sistema acumula cambios y los escribe posteriormente.
Estas técnicas mejoran el rendimiento, pero complican la recuperación ante fallas.
Una falla durante una escritura
Supongamos que una operación modifica:
- los datos del archivo;
- sus metadatos;
- una entrada de directorio;
- la información de bloques libres.
¿Qué ocurre si la computadora se apaga entre dos de esas escrituras?
Journaling
El journaling registra operaciones o cambios antes de aplicarlos completamente.
Después de una falla, el sistema puede revisar ese registro para:
- completar operaciones pendientes;
- descartar operaciones incompletas;
- recuperar una estructura consistente.
Integración de conceptos
Cada nivel resuelve una parte diferente del problema.
| nombre ↓ |
| entrada de directorio ↓ |
| inodo / metadatos ↓ |
| bloques de datos ↓ |
| espacio libre y cache |
Preguntas de cierre
- ¿Qué estrategia facilita más el acceso directo?
- ¿Qué estrategia permite crecer con mayor flexibilidad?
- ¿Qué información necesita el sistema para localizar un archivo?
- ¿Cómo sabe qué bloques puede reutilizar?
- ¿Qué problema intenta resolver el journaling?
Próxima clase
Protección, compartición y recuperación de archivos
- permisos;
- enlaces;
- respaldos;
- RAID;
- sistemas de archivos reales y de red.