CS 4/5789: Introduction to Reinforcement Learning
Lecture 5: Proximal Policy Optimization
Prof. Sarah Dean
MW 1:25-2:40pm
155 Olin Hall
Reminders
- Homework
- PSet 2 released today
- Project 1 due Friday
- In-class Exam on 9/23
How should we update the policy parameters to improve the expected reward?
Agenda
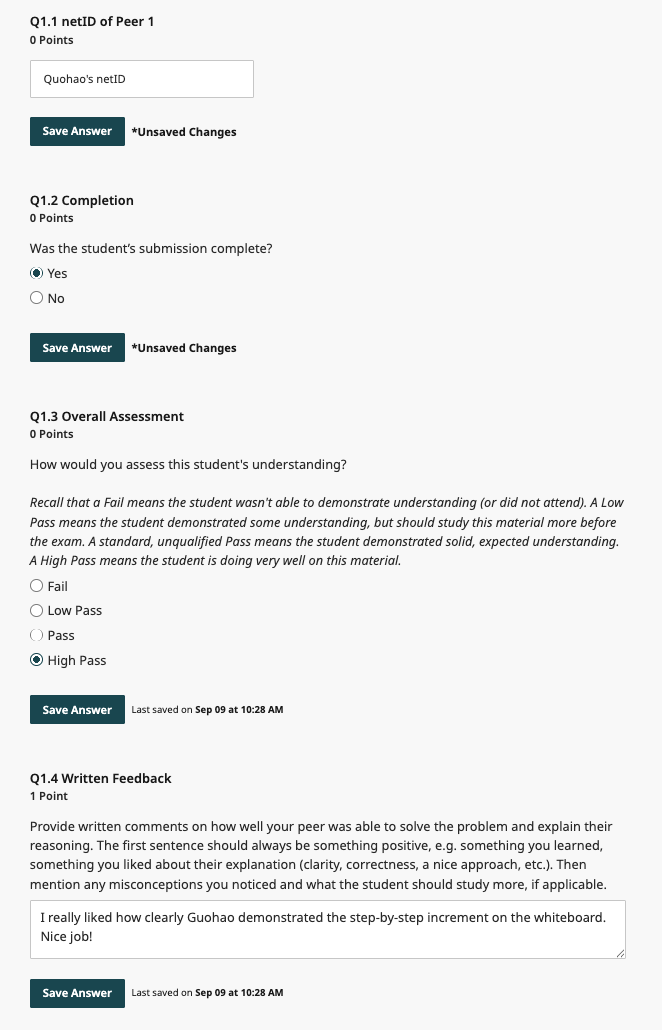
- Peer Feedback Demo
- Trust Region Recap
- Proximal Policy Optimization
- Policy Optimization Summary
Peer Feedback Demo
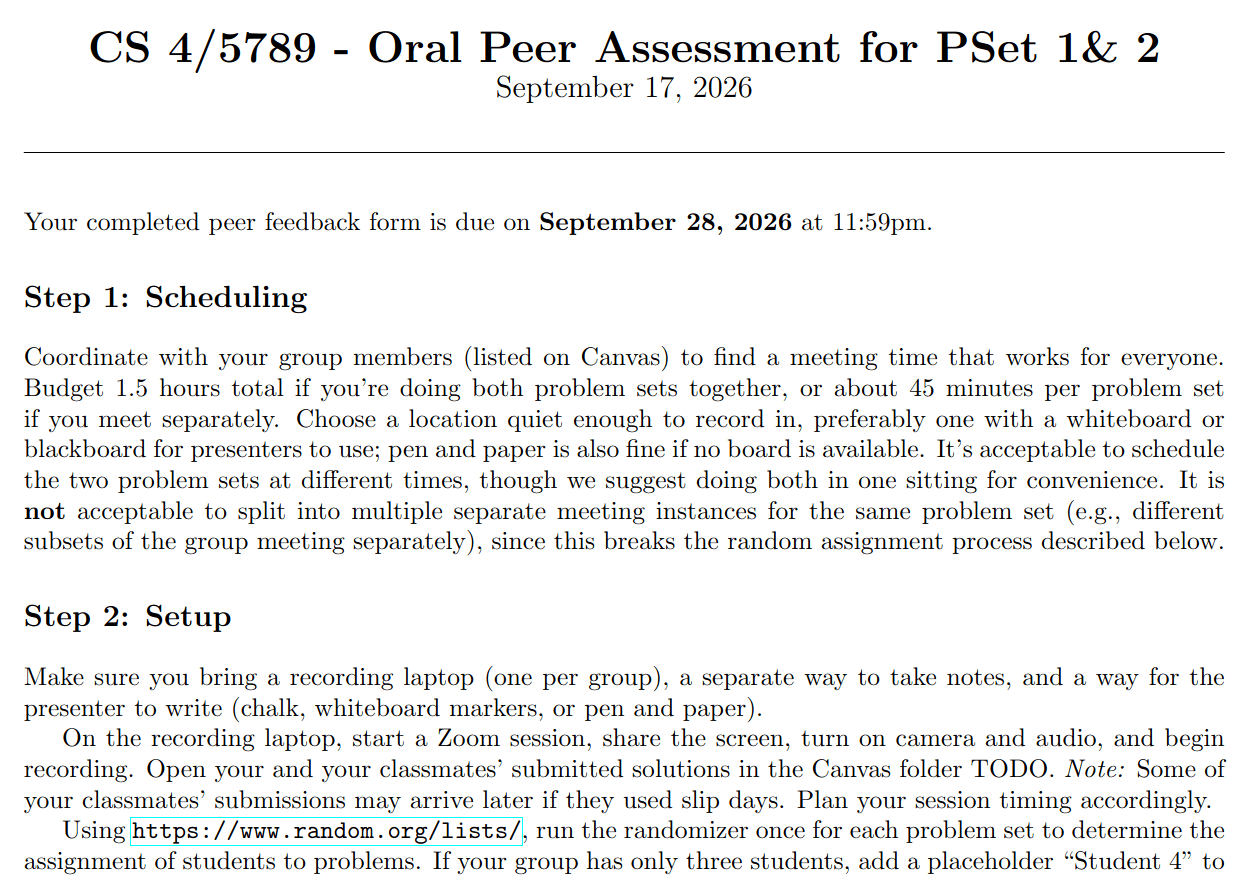
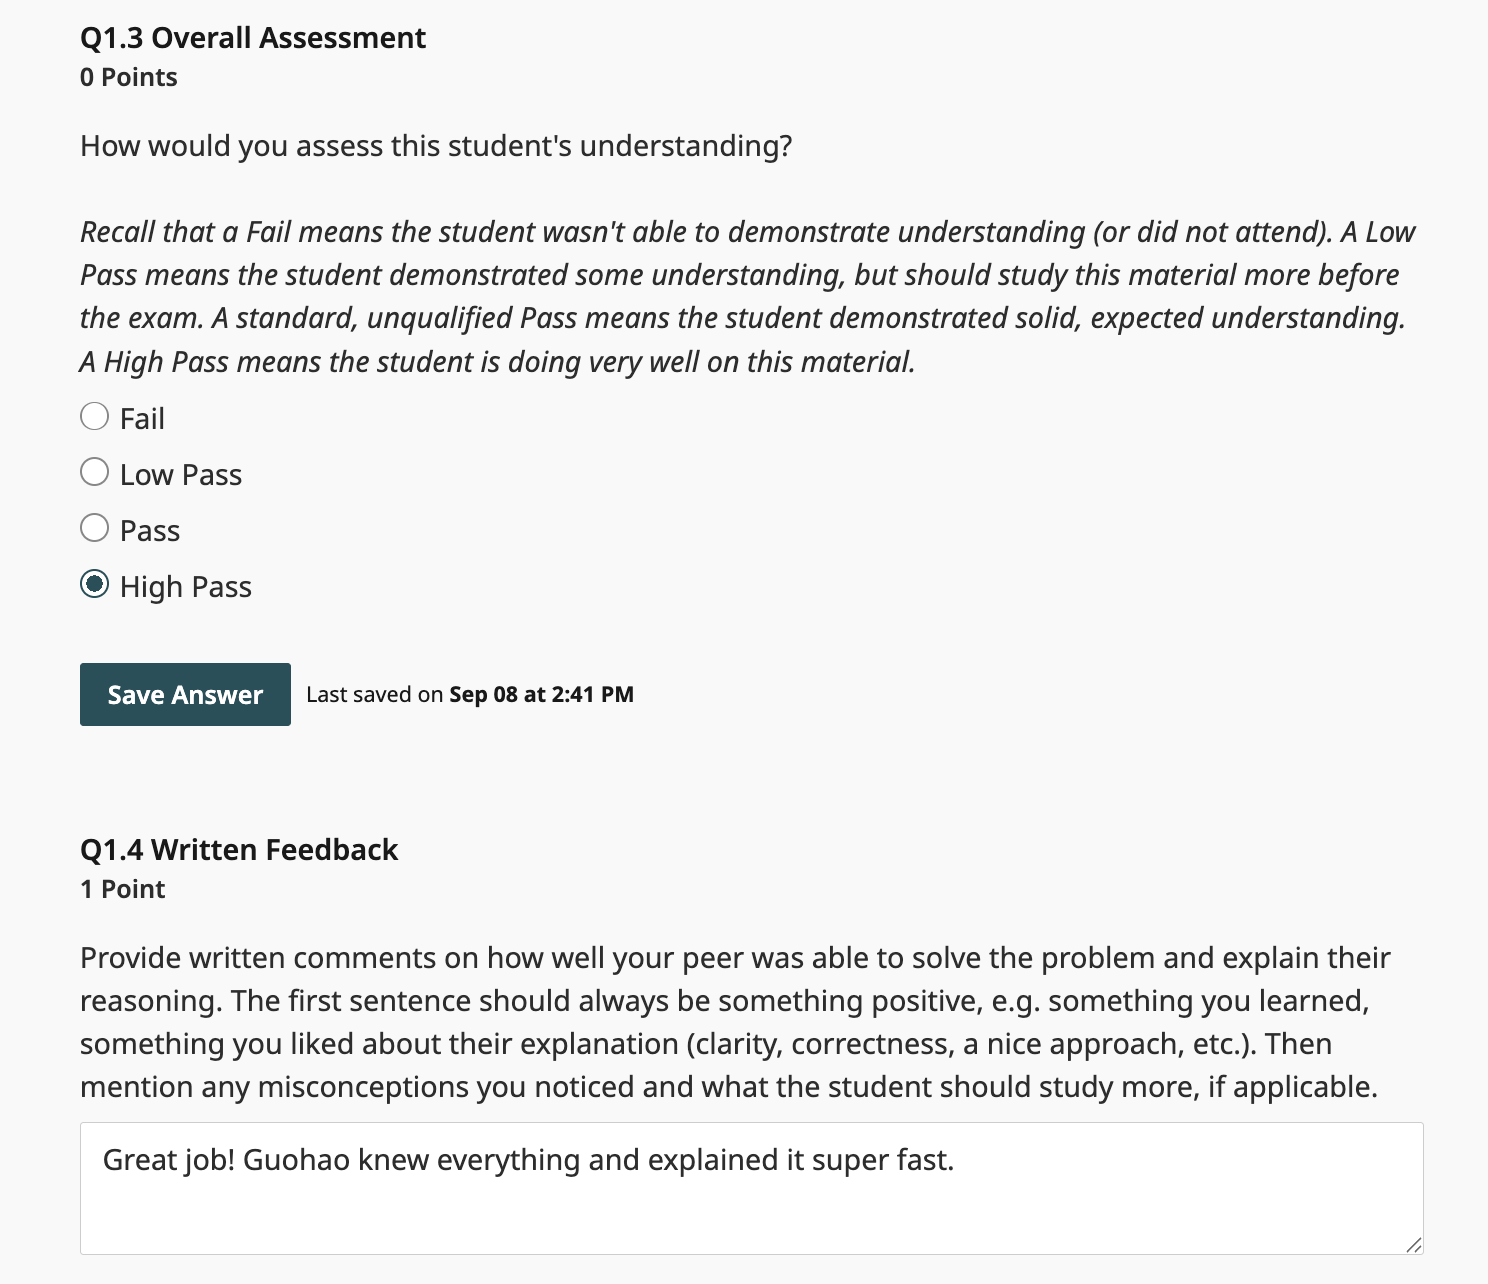
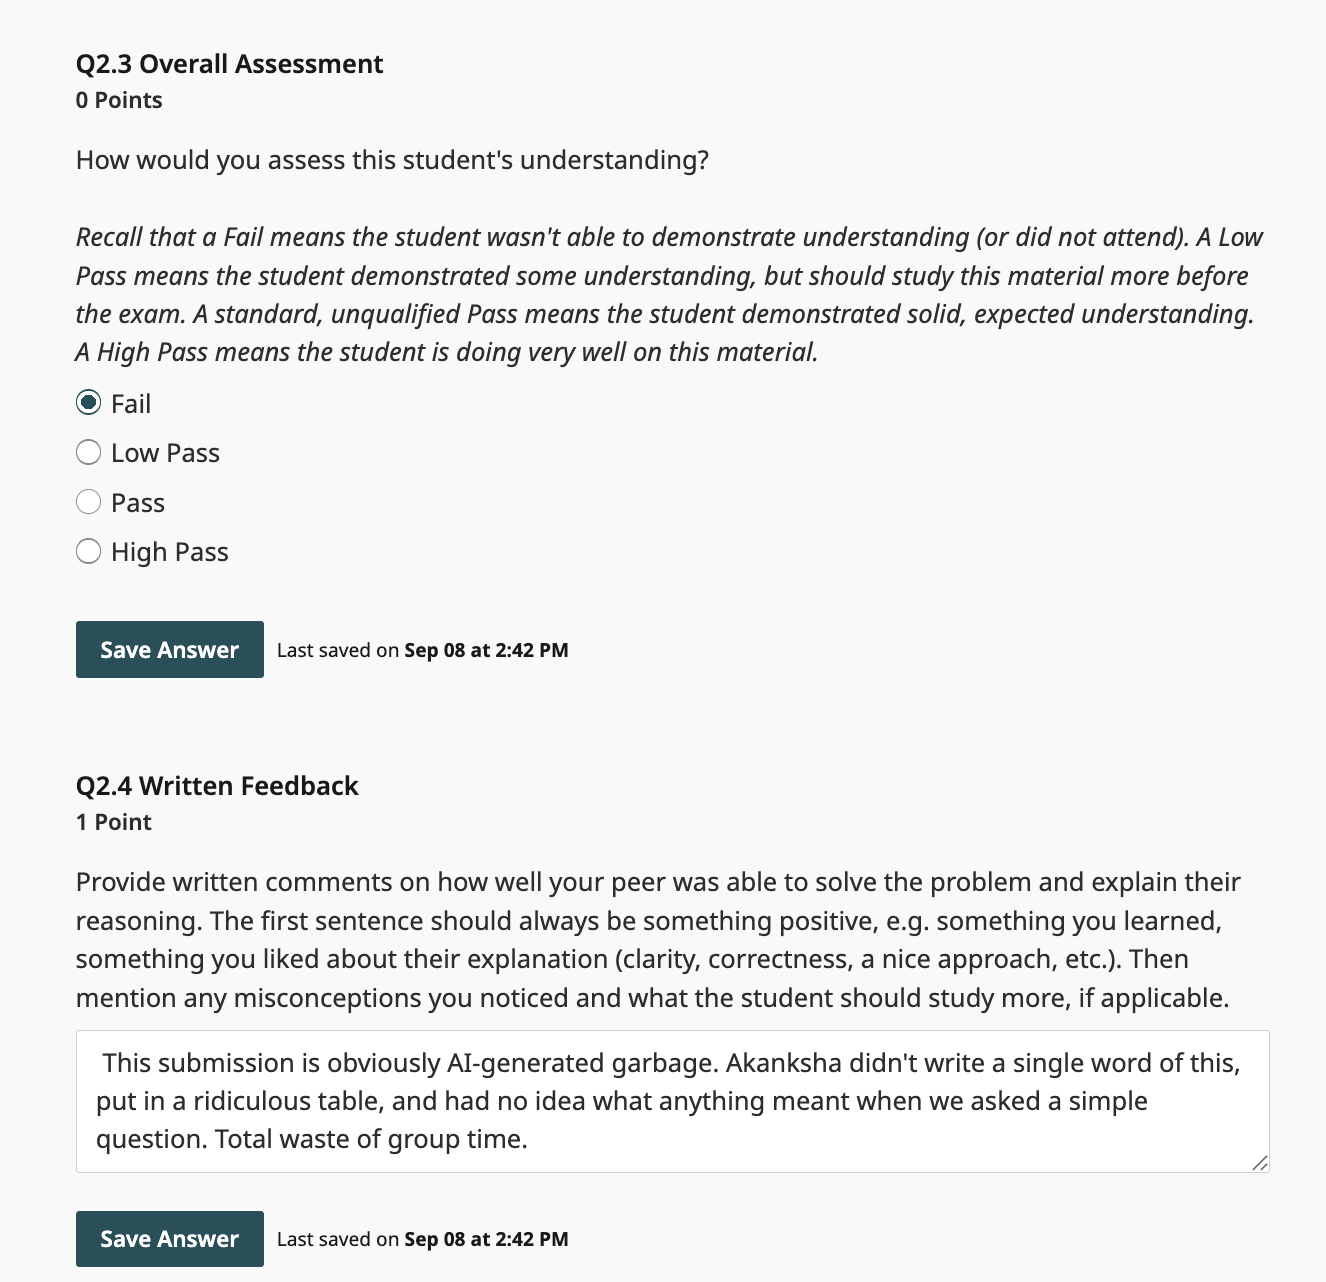
PollEV
Survey
Agenda
- Peer Feedback Demo
- Trust Region Recap
- Proximal Policy Optimization
- Policy Optimization Summary
How should we update the policy parameters to improve the expected reward?
What is \(\nabla_\theta d_{KL}(\theta',\theta)\)? Recall $$d_{KL}(\theta',\theta) = \mathbb{E}_{x,a \sim \rho_{\theta'}}\!\left[ \log\frac{\pi_{\theta'}(a|x)}{\pi_{\theta}(a|x)} \right].$$
Think/Pair/Share
REINFORCE (90s)
- Given: baseline function \(b\)
- For data collection epochs \(j=1,...,N_{coll}\):
- For collection steps \(i=1,...,n\):
- observe \(x_{i}\), sample \(a_{i}\sim \pi_{\theta_{j}}(x_{i})\), get \(r_{i}\)
- Update $$\theta_{j+1} = \theta_j + \alpha \frac{1}{n} \sum_{i=1}^n \nabla \log \pi_{\theta_j}(a_i|x_i) (r_i-b(x_i) ) $$
- For collection steps \(i=1,...,n\):
Natural Policy Gradient (00s)
- Given: baseline function \(b\)
- For data collection epochs \(j=1,...,N_{coll}\):
- For collection steps \(i=1,...,n_j\):
- observe \(x_{i}\), sample \(a_{i}\sim \pi_{\theta_{j}}(x_{i})\), get \(r_{i}\)
- Compute then invert $$\hat F_{\theta}=\frac{1}{n} \sum_{i=1}^n \nabla \log \pi_\theta(a_i|x_i) \nabla \log \pi_\theta(a_i|x_i) ^\top $$
- Update $$\theta_{j+1} = \theta_j + \alpha \frac{1}{n} \hat F_{\theta_j}^{-1} \sum_{i=1}^n \nabla \log \pi_{\theta_j}(a_i|x_i) (r_i-b(x_i) ) $$
- For collection steps \(i=1,...,n_j\):
- Given: baseline function \(b\)
- For data collection epochs \(j=1,...,N_{coll}\):
- For collection steps \(i=1,...,n_j\):
- observe \(x_{i}\), sample \(a_{i}\sim \pi_{\theta_{j,1}}(x_{i})\), get \(r_{i}\)
- For update steps \(k=1,...,N_{up}\): $$\theta_{j,k+1}=\theta_{j,k} +\alpha \frac{1}{n} \sum_{i=1}^n \nabla \log \pi_\theta(a_i|x_i)\left( \frac{\pi_{\theta_{j,k}}(a_i|x_i)}{\pi_{\theta_{j,1}}(a_i|x_i)} (r_i-b(x_i)) + \lambda \right)$$
- Set \(\theta_{j+1,1} = \theta_{j,k}\)
- For collection steps \(i=1,...,n_j\):
Proximal Policy Optimization (10s)
- Given: baseline function \(b\)
- For data collection epochs \(j=1,...,N_{coll}\):
- For collection steps \(i=1,...,n_j\):
- observe \(x_{i}\), sample \(a_{i}\sim \pi_{\theta_{j}}(x_{i})\), get \(r_{i}\)
- For update steps \(k=1,...,N_{up}\):
- Form estimates
- Update parameter \(\theta_{j,k+1}=\theta_{j,k} +\alpha\)update
- Set \(\theta_{j+1,1} = \theta_{j,k}\)
- For collection steps \(i=1,...,n_j\):
Policy Opt. Meta Algorithm
Policy Opt. Meta Algorithm
- For data collection epochs \(j=1,...,N_{coll}\):
- For collection steps \(i=1,...,n_j\):
- observe \(x_{i}\), sample \(a_{i}\sim \pi_{\theta_{j,1}}(x_{i})\), get \(r_{i}\)
- For update steps \(k=1,...,N_{up}\):
- Form estimates
- Update parameter \(\theta_{j,k+1}=\theta_{j,k} +\alpha\)update
- Set \(\theta_{j+1,1} = \theta_{j,k}\)
- For collection steps \(i=1,...,n_j\):
- Policy Gradient: update is \(\alpha \widehat{\nabla J}_{\theta;\theta'}\) with $$\widehat{\nabla J}_{\theta;\theta'} =\frac{1}{n} \sum_{i=1}^n \frac{\pi_\theta(a_i|x_i)}{\pi_{\theta'}(a_i|x_i)} \nabla \log \pi_\theta(a_i|x_i) (r_i-b(x_i))$$
-
NPG: update is \(\alpha \hat F_{\theta;\theta'}^{-1} \widehat{\nabla J}_{\theta;\theta'}\) with $$\hat F_{\theta;\theta'}^{-1}=\frac{1}{n} \sum_{i=1}^n \frac{\pi_\theta(a_i|x_i)}{\pi_{\theta'}(a_i|x_i)} \nabla \log \pi_\theta(a_i|x_i) \nabla \log \pi_\theta(a_i|x_i) ^\top $$
-
PPO: update is \(\alpha (\widehat{\nabla J}_{\theta;\theta'}+\frac{1}{n}\sum_{i=1}^n\lambda \nabla \log \pi_\theta(a_i|x_i) ) \) $$=\frac{1}{n} \sum_{i=1}^n \nabla \log \pi_\theta(a_i|x_i) (\frac{\pi_\theta(a_i|x_i)}{\pi_{\theta'}(a_i|x_i)} (r_i-b(x_i)) + \lambda)$$
Summary
On-policy whenever \(N_{up}=1\) and importance weight \(=1\)