59 CONGRESO NACIONAL DE LA SOCIEDAD MATEMÁTICA MEXICANA
Aprendizaje automático para dinámicas estocásticas en bioprocesos
PINNs y SNODEs aplicados al crecimiento logístico en la producción de kéfir
Saúl Diaz Infante Velasco · saul.diazinfante@unison.mx
Tlaxcala, octubre de 2026
Presentación SMM 2026
Aprendizaje automático para
dinámicas estocásticas
en bioprocesos
Datos, código y resultados
Modelos de crecimiento de kéfir
ODE y SDE neuronales
PINNs y comparación de modelos
Contenido
01
Transición de modelos: de ODE a SDE
02
Métodos numéricos clásicos
03
Aprendizaje automático científico (SciML)
04
ODE y SDE neuronales
Integración de modelos físicos y aprendizaje automático para bioprocesos estocásticos.
05
Aplicación: un caso de bioprocesos
Transición de modelos:
ODE → SDE
Cuantificación de incertidumbre
Incorporar ruido al modelo determinista
Crecimiento poblacional
Crecimiento de una población
Crecimiento poblacional
Crecimiento de una población
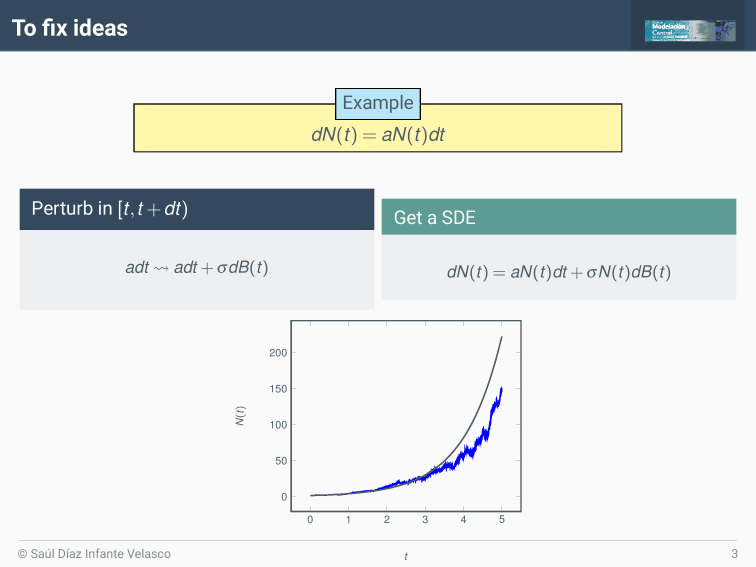
De una ODE a una SDE
Ejemplo
De una ODE a una SDE
Ejemplo
Perturbamos la tasa en un intervalo corto
De una ODE a una SDE
Ejemplo
Perturbamos la tasa en un intervalo corto
De una ODE a una SDE
Ejemplo
Perturbamos la tasa en un intervalo corto
De una ODE a una SDE
Perturbamos la tasa
Obtenemos una SDE
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Henston
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Langevin
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Brusselator
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Lotka–Volterra
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
SIR
Dos enfoques principales
Objetivo principal
Presentar dos enfoques habituales para el
modelado estocástico mediante SDE.
Enfoque de Allen
Perturbación estocástica
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
Aproximaciones numéricas de SDE
Notación: deriva y difusión
Notación: deriva y difusión
Notación integral de una SDE
Construcción de Euler–Maruyama
Construcción de Euler–Maruyama
Una malla temporal
Construcción de Euler–Maruyama
Una malla temporal
Construcción de Euler–Maruyama
Una malla temporal
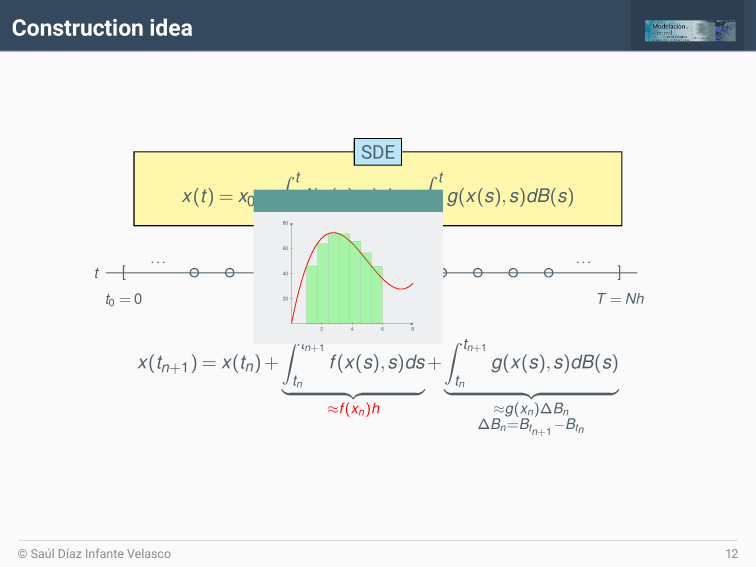
Construcción de Euler–Maruyama
Una malla temporal
Construcción de Euler–Maruyama
Una malla temporal
Construcción de Euler–Maruyama
Una malla temporal
Construcción de Euler–Maruyama
Construcción de Euler–Maruyama
[Sec. 1.2, Teo. 1.2.2]
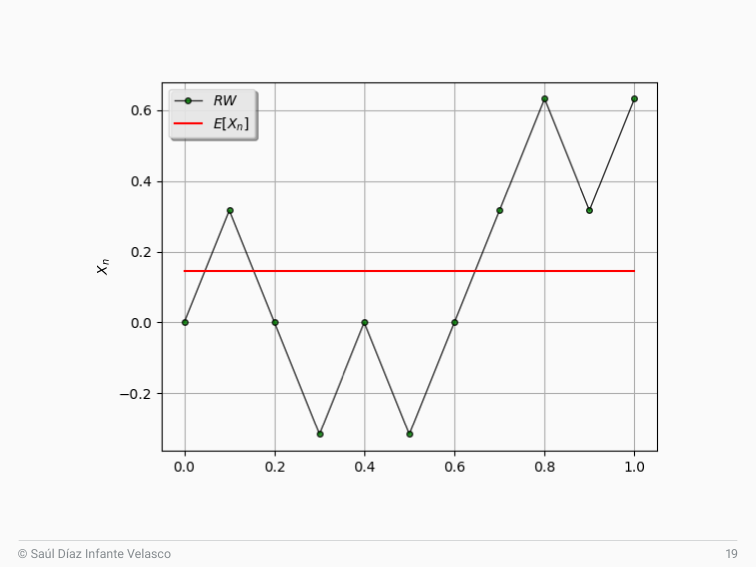
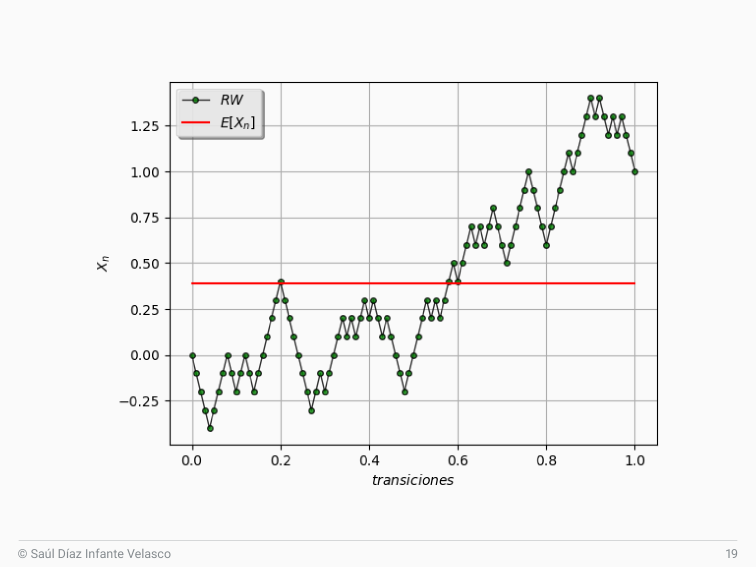
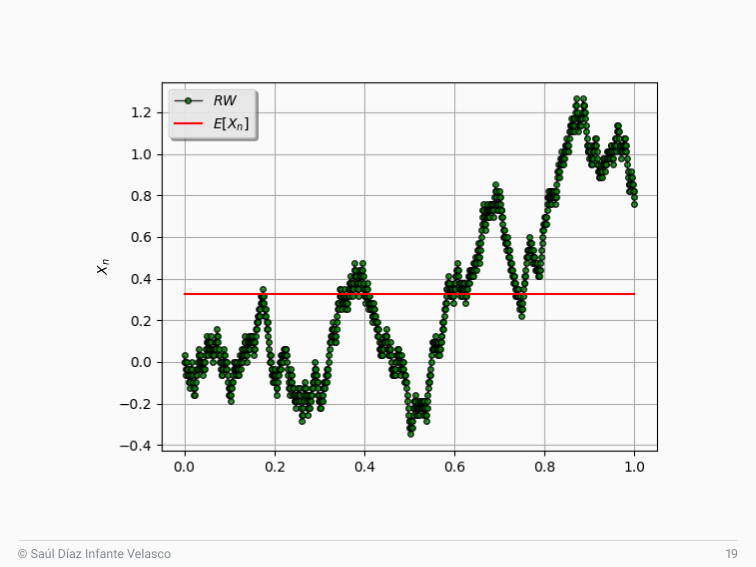
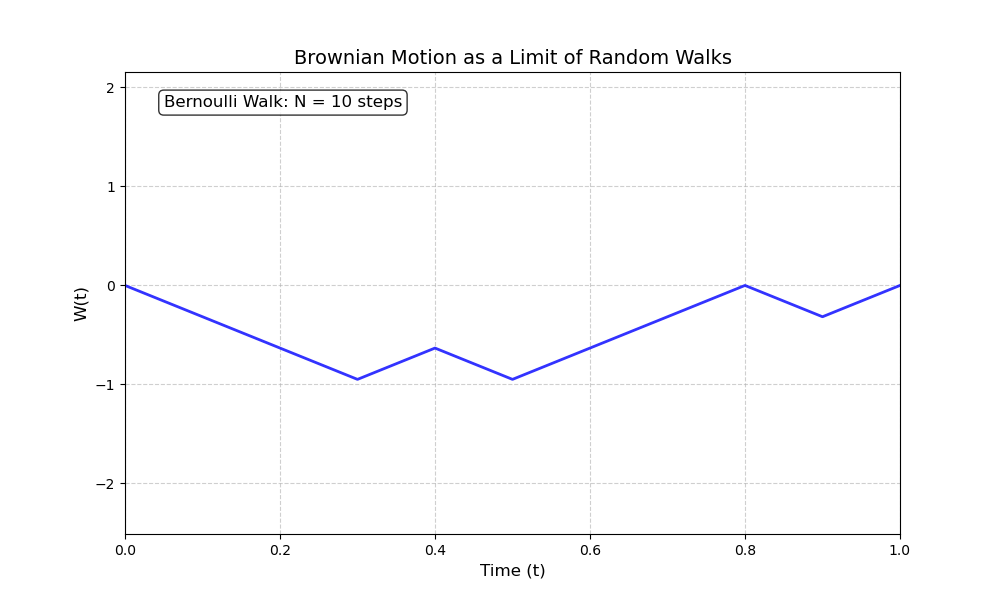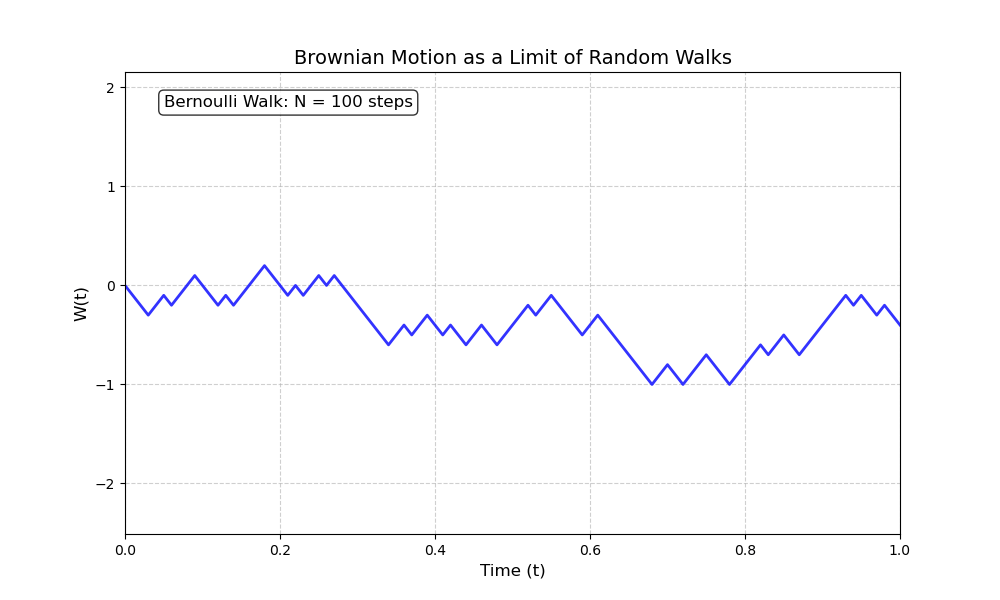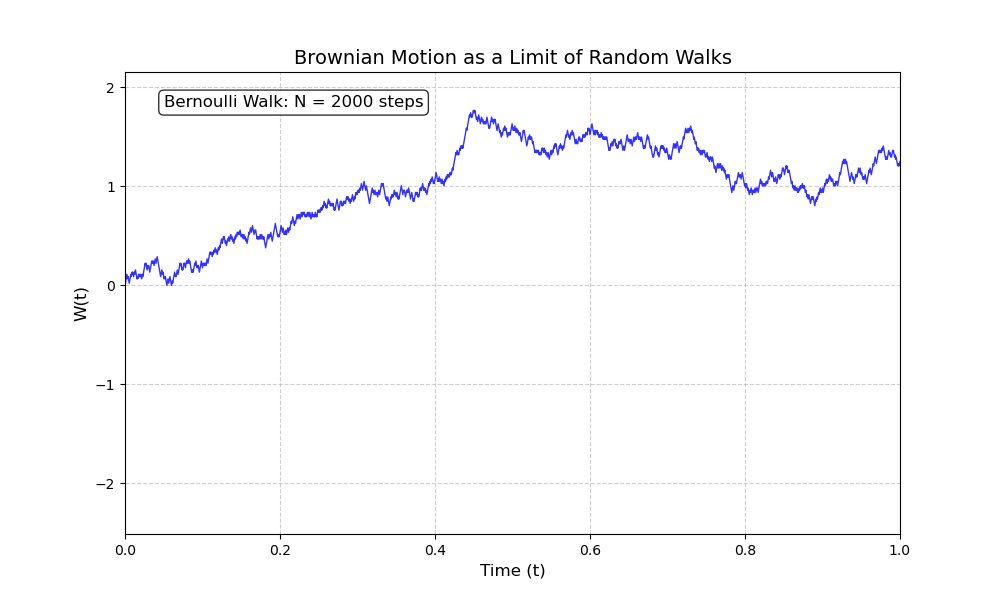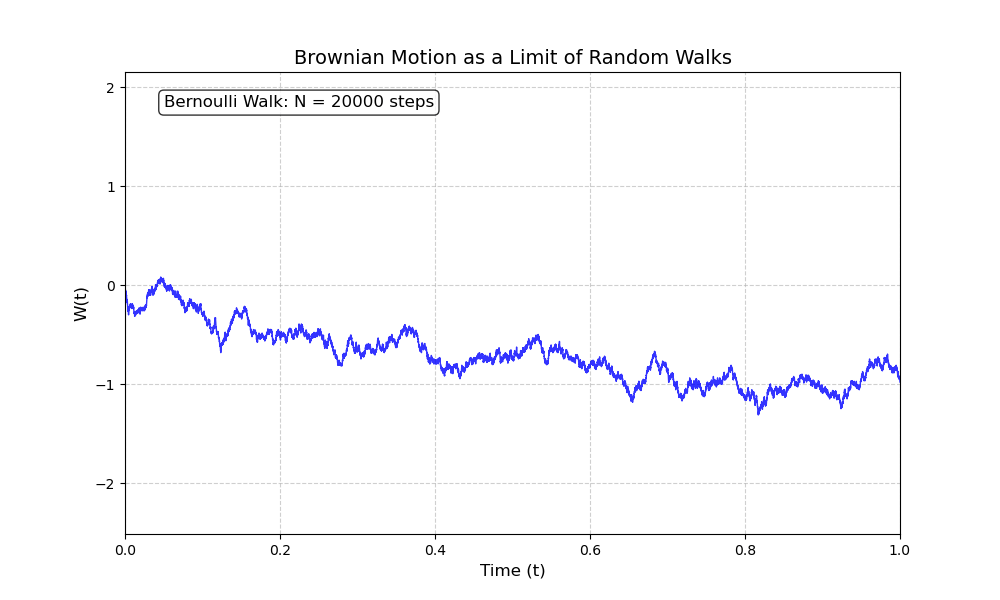
Movimiento browniano discreto
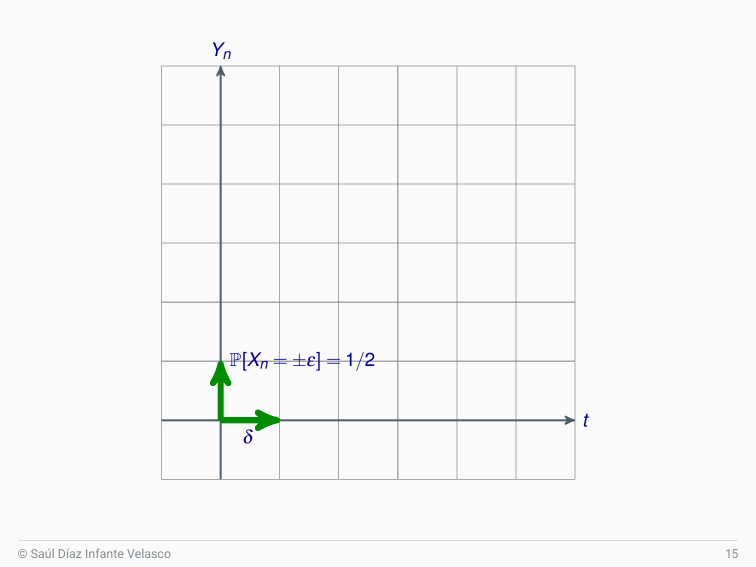
Construcción del movimiento browniano
Teorema
Sea Y una caminata aleatoria que parte de 0,
con saltos equiprobables de signos opuestos en los tiempos
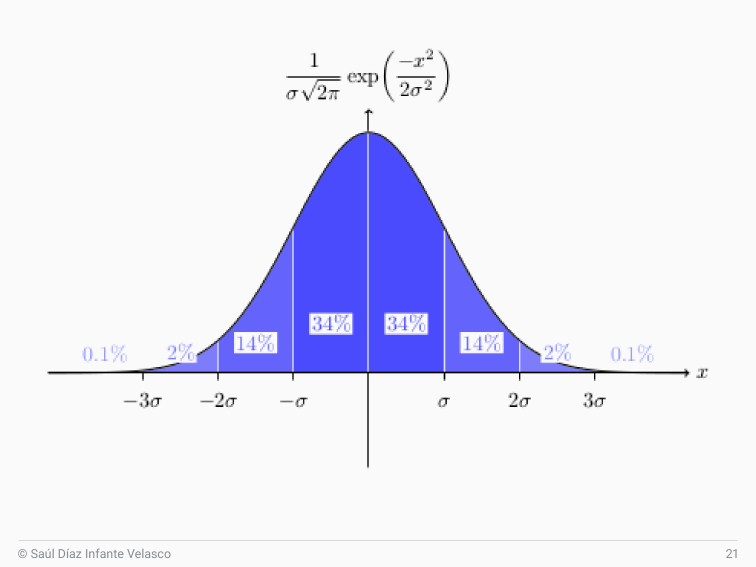
Para cada t ≥ 0, el límite existe en distribución:
Distribución normal
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
(iii) Para cada partición, las variables aleatorias
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
(iii) Para cada partición, las variables aleatorias
Dado t en [0,T], tomamos una malla:
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
(iii) Para cada partición, las variables aleatorias
Dado t en [0,T], tomamos una malla:
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
(iii) Para cada partición, las variables aleatorias
Dado t en [0,T], tomamos una malla:
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
(iii) Para cada partición, las variables aleatorias
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
(iii) Para cada partición, las variables aleatorias
Aproximación débil y fuerte
Problema dado
Débil
Fuerte
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Método theta de Euler–Maruyama
Xuerong Mao and Lukasz Szpruch.
Strong convergence and stability of implicit numerical
methods for stochastic differential equations with
non-globally lipschitz continuous coefficients.
Journal of Computational and Applied Mathematics,
238:14–28, January 2013.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama hacia adelante y atrás
Xuerong Mao and Lukasz Szpruch.
Strong convergence and stability of implicit numerical
methods for stochastic differential equations with
non-globally lipschitz continuous coefficients.
Journal of Computational and Applied Mathematics,
238:14–28, January 2013.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama atenuado
Martin Hutzenthaler, Arnulf Jentzen, and Peter E. Kloeden.
Strong convergence of an explicit numerical method
for sdes with nonglobally lipschitz continuous coefficients.
The Annals of Applied Probability,
22(4):1611–1641, August 2012.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama truncado
Xuerong Mao.
The truncated euler-maruyama method for stochastic
differential equations.
Journal of Computational and Applied Mathematics,
290:370–384, 2015.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama con coeficientes variables
Sotirios Sabanis.
Euler approximations with varying coefficients: the
case of superlinearly growing diffusion coefficients.
To appear in Annals of Applied Probability, 2015.
Referencias
Aprendizaje automático científico (SciML)
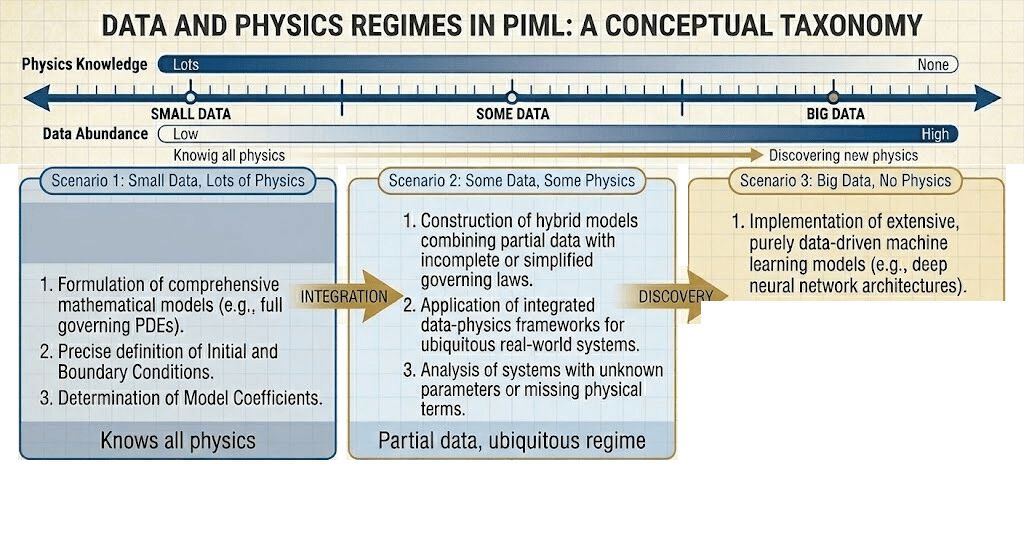
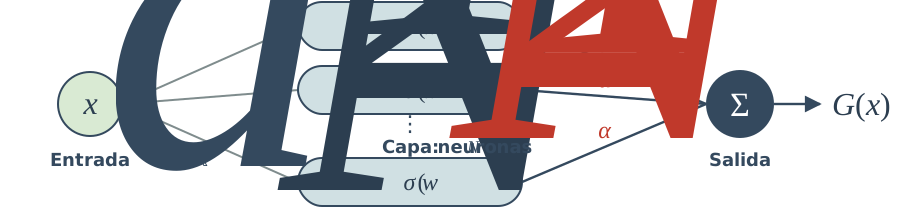
Aproximación universal con redes neuronales
- Las redes neuronales pueden aproximar funciones no lineales muy generales.
Teorema (Cybenko, 1989)
Sea \(\sigma:\mathbb{R}\to\mathbb{R}\) una función sigmoidal continua tal que
$$\lim_{x\to-\infty}\sigma(x) = 0, \qquad \lim_{x\to\infty}\sigma(x) = 1.$$
Entonces la clase de funciones
$$F(x) = \sum_{i=1}^{N} \alpha_i\,\sigma\big(w_i^\top x + b_i\big)$$
es densa en \(C([0,1]^n)\).
- Para toda \(f:[0,1]^n\to\mathbb{R}\) continua y todo \(\varepsilon>0\), existe \(F(x)\) tal que
$$|F(x) - f(x)| < \varepsilon.$$
- Por lo tanto, una red con una sola capa oculta puede aproximar cualquier función continua tan bien como queramos.
La función sigmoidal en el teorema de Cybenko
Cybenko llama función sigmoidal a cualquier función medible \(\sigma(t)\) que cumpla
$$\sigma(t)\to 1 \text{ cuando } t\to\infty \quad\text{y}\quad \sigma(t)\to 0 \text{ cuando } t\to-\infty.$$
Ejemplo clásico: la función logística
$$\sigma(x) = \frac{1}{1+e^{-x}}$$
- Acotada: sus valores están en el intervalo \((0,1)\).
- Monótona: siempre creciente, con un gradiente suave.
- Aproximación universal: las combinaciones lineales finitas \(G(x) = \sum_{i=1}^{N}\alpha_i\,\sigma\big(w_i^\top x + b_i\big)\) aproximan cualquier función continua en un compacto.
Dimensiones y datos de entrenamiento
\(\displaystyle f(x) \approx G(x) = \sum_{i=1}^{N}\alpha_i\,\sigma\big(w_i^\top x + b_i\big)\)
Dimensiones
Sea \(d\) el número de variables de entrada.
- \(x\in\mathbb{R}^d\): vector de entrada (un dato).
- \(w_i\in\mathbb{R}^d\): vector de pesos de la neurona \(i\).
- \(b_i\in\mathbb{R}\): sesgo (escalar) de la neurona \(i\).
- \(\alpha_i\in\mathbb{R}\): peso de salida que escala la sigmoide \(i\).
Relación con los datos de entrenamiento
En aprendizaje supervisado:
- Datos \(D := \{(x_j,y_j)\}_{j=1}^{m}\).
- Buscamos \(\{w_i, b_i, \alpha_i\}\) tales que \(G(x_j)\approx y_j\).
- Cybenko prueba que para todo \(\varepsilon>0\) existe \(N\) tal que \(|G(x)-f(x)|<\varepsilon\) para toda \(x\) en un compacto.
Resolver con PINNs
Cada solución de la ecuación diferencial se obtiene resolviendo un problema de optimización.
Este enfoque está relacionado con los métodos de colocación y de elementos finitos. Es una línea de trabajo extendida.
Sea
$$\frac{dy_{\theta}}{dt} = f(t, y_{\theta}(t)), \quad t \in (0, T],$$
con condición inicial conocida:
$$y_{\theta}(0) = y_0.$$
Buscamos una red neuronal \(y_{\theta}\), con parámetros \(\theta\), que satisfaga esta ecuación.
Para ajustar la red neuronal, definimos la función de pérdida
$$ L(\theta) = L_{\text{residual}} + \lambda L_{\text{IC}}.$$
Elegimos puntos de colocación, \(\{t_i\}_{i=1}^{N}\), distribuidos en \((0,T]\). En cada punto calculamos el residuo:
$$\text{Residuo}(t_i) = \frac{dy_\theta}{dt}(t_i) - f(t_i,y_\theta(t_i)).$$
$$L_{\text{IC}} = |y_\theta(0) - y_0|^2$$
El reto: simular SDE
Consideremos una SDE escalar general:
$$dX_t = f(X_t) dt + g(X_t) dW_t$$
Ecuación de Fokker–Planck (ecuación de avance de Kolmogorov):
$$\frac{\partial p}{\partial t} = -\frac{\partial}{\partial x} [f(x) p(x,t)] + \frac{1}{2} \frac{\partial^2}{\partial x^2} [g^2(x) p(x,t)]$$
Ejemplo: movimiento browniano geométrico (GBM)
SDE:
$$dX_t = \mu X_t\,dt + \sigma X_t\,dW_t$$
- Problema de referencia clásico (finanzas, ruido multiplicativo).
- Tiene solución explícita, lo que lo hace ideal para validar.
Transformación logarítmica:
$$Y_t = \log X_t$$
$$dY_t = a\,dt + \sigma\,dW_t, \qquad a = \mu - \tfrac{1}{2}\sigma^2$$
- Ahora \(Y_t\) es un movimiento browniano con deriva (ruido aditivo).
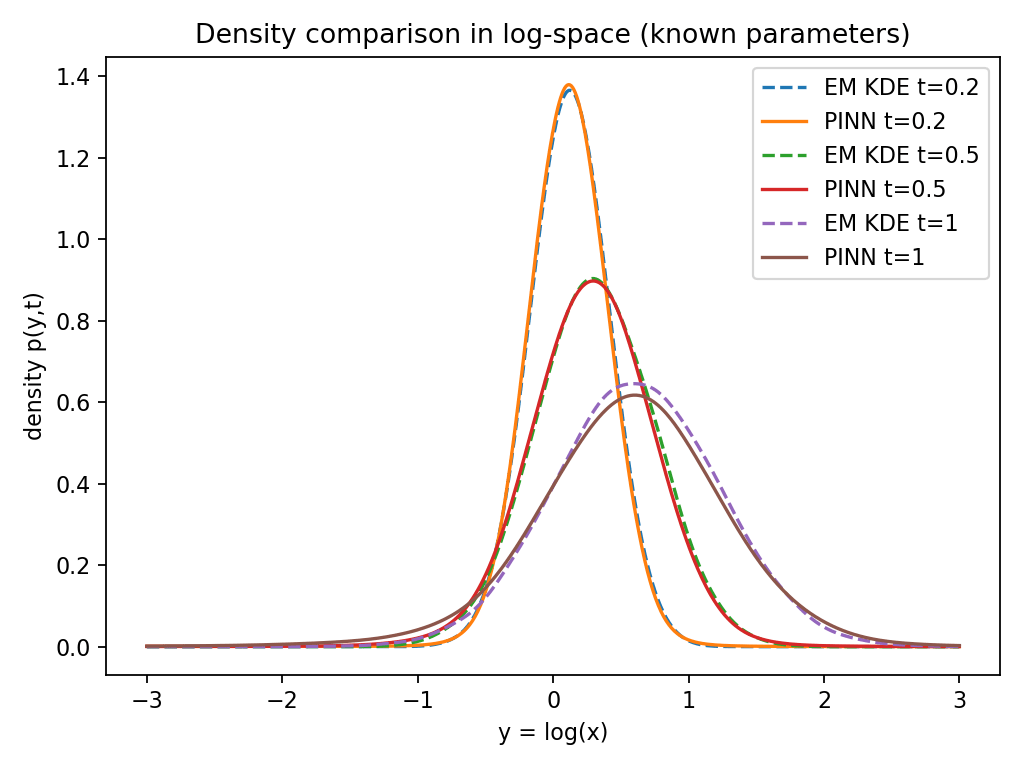
Density PINN: resolver la ecuación de Fokker–Planck
Sea \(p(y,t)\) la densidad de \(Y_t\):
$$p_t = -a\,p_y + \tfrac{1}{2}\sigma^2 p_{yy}$$
- Aproximamos la densidad con una PINN: \(p(y,t) \approx \hat p_\theta(y,t)\).
- Revisamos que \(\hat p_\theta\) resuelva la EDP con diferenciación automática en los puntos de colocación.
Función de pérdida (típica):
$$\begin{aligned}\mathcal{L} &= \underbrace{\big\| p_t + a\,p_y - \tfrac{1}{2}\sigma^2 p_{yy} \big\|^2}_{\text{residuo de la EDP}} \\ &\quad + \|\mathrm{IC}(t=0)\|^2 + \|\mathrm{BC}\|^2 + \Big| \int \hat p \, dy - 1 \Big|^2\end{aligned}$$
- Luego, los momentos de \(X_t = e^{Y_t}\) se calculan integrando:
$$\mathbb{E}[X_t] = \int e^{y}\,p(y,t)\,dy, \qquad \operatorname{Var}[X_t] = \int e^{2y}\,p\,dy - \big(\mathbb{E}[X_t]\big)^2$$
Pathwise PINN: una red que genera trayectorias
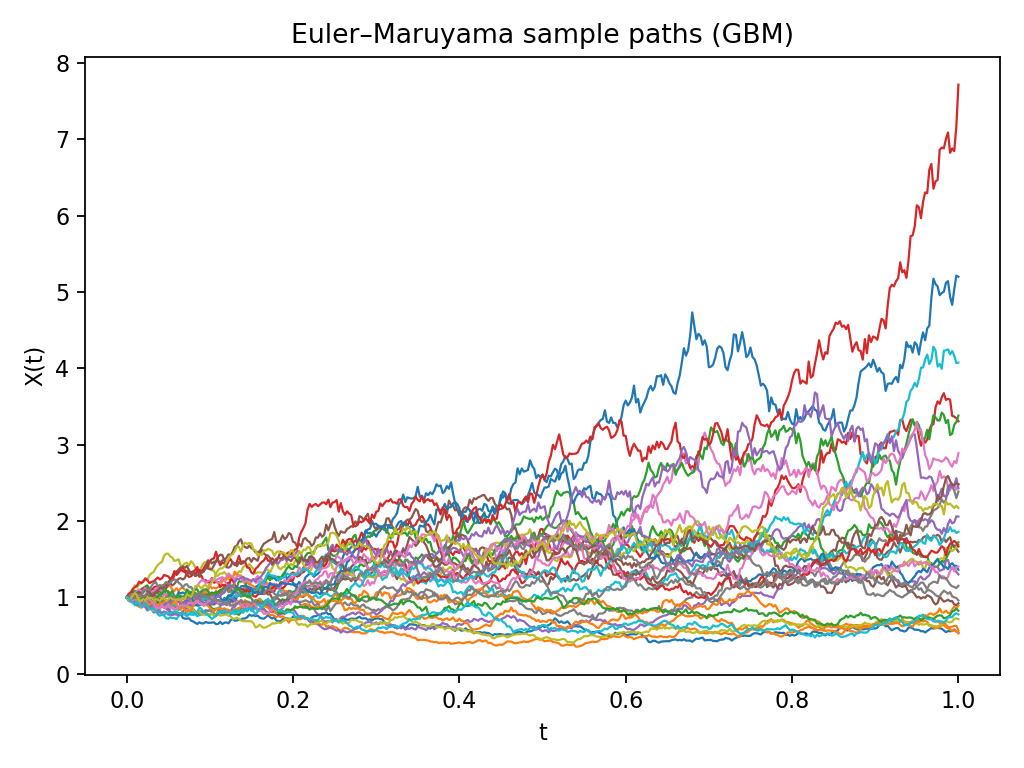
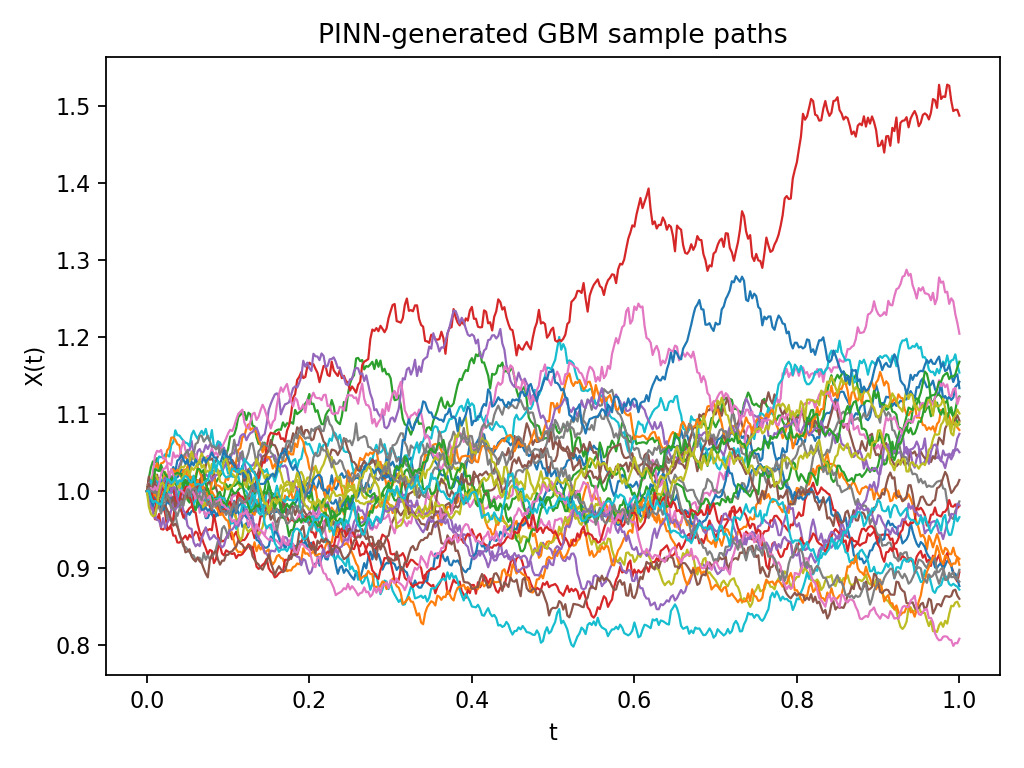
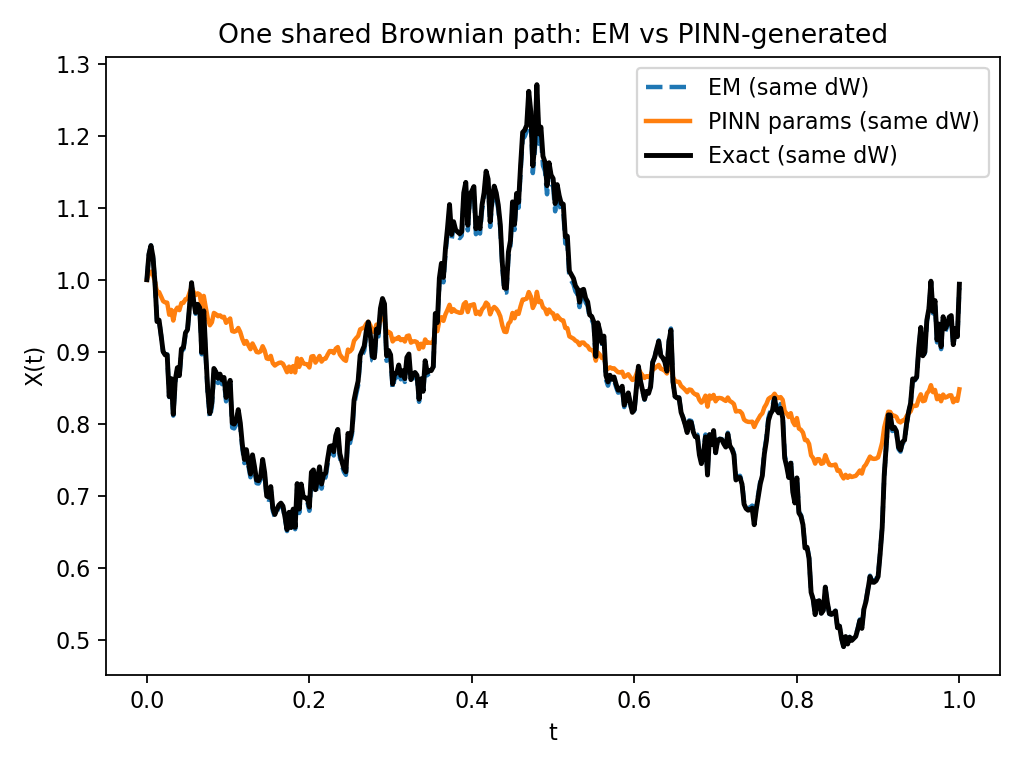
Objetivo: generar trayectorias con una red neuronal, comparables con las de Euler–Maruyama.
- Aprendemos una función determinista \(u(t,w)\) tal que
$$u(t, W_t) \approx X_t.$$
- Luego simulamos una trayectoria browniana \(W_t(\omega)\) y definimos
$$X_t(\omega) \approx u\big(t, W_t(\omega)\big).$$
La idea principal
La fórmula de Itô convierte la SDE en restricciones deterministas sobre \(u(t,w)\).
Restricciones de Itô para el GBM (Itô-map PINN)
Consideremos \(u(t, W_t)\). Por la fórmula de Itô:
$$d\,u(t,W_t) = u_t\,dt + u_w\,dW_t + \tfrac{1}{2}u_{ww}\,dt$$
- Queremos que \(u(t,W_t)\) se comporte como un GBM:
$$dX_t = \mu X_t\,dt + \sigma X_t\,dW_t$$
Igualando los coeficientes de \(dt\) y \(dW_t\):
$$u_w = \sigma u, \qquad u_t + \tfrac{1}{2}u_{ww} = \mu u$$
- Obtenemos restricciones deterministas, en forma de EDP, sobre \((t,w)\).
Entrenamiento y generación de trayectorias
Entrenamos \(u_\theta(t,w)\) minimizando:
$$\begin{aligned}\mathcal{L} &= \|u_w - \sigma u\|^2 \\ &\quad + \Big\| u_t + \tfrac{1}{2}u_{ww} - \mu u \Big\|^2 \\ &\quad + \|u(0,0) - x_0\|^2\end{aligned}$$
Generamos trayectorias:
- Simulamos el movimiento browniano:
$$W_{n+1} = W_n + \Delta W_n, \quad \Delta W_n \sim \mathcal{N}(0, \Delta t)$$
- Trayectoria de la PINN:
$$X_n^{\text{PINN}} = u_\theta(t_n, W_n)$$
- Comparamos con Euler–Maruyama usando los mismos \(\Delta W_n\):
$$X_{n+1} = X_n + \mu X_n\,\Delta t + \sigma X_n\,\Delta W_n$$
Qué comparar en la práctica
Comparación de trayectorias:
- Graficamos trayectorias con los mismos incrementos brownianos, para que la comparación sea justa.
- Comparamos rasgos de la distribución (p. ej., histograma o KDE de \(\log X_t\)).
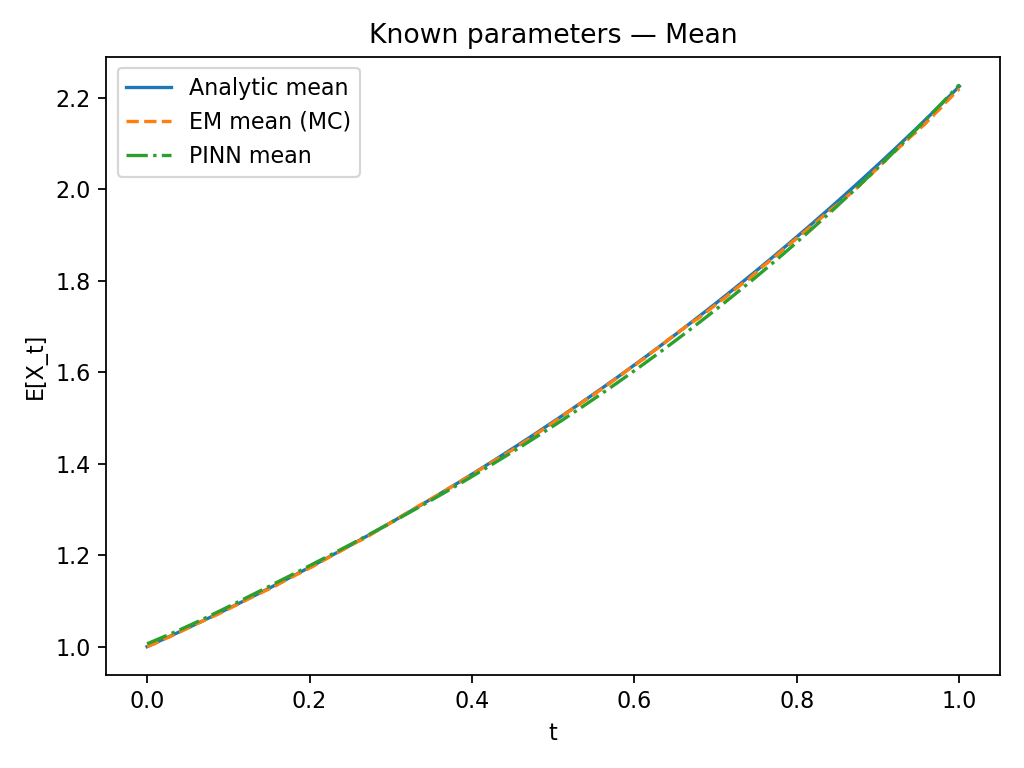
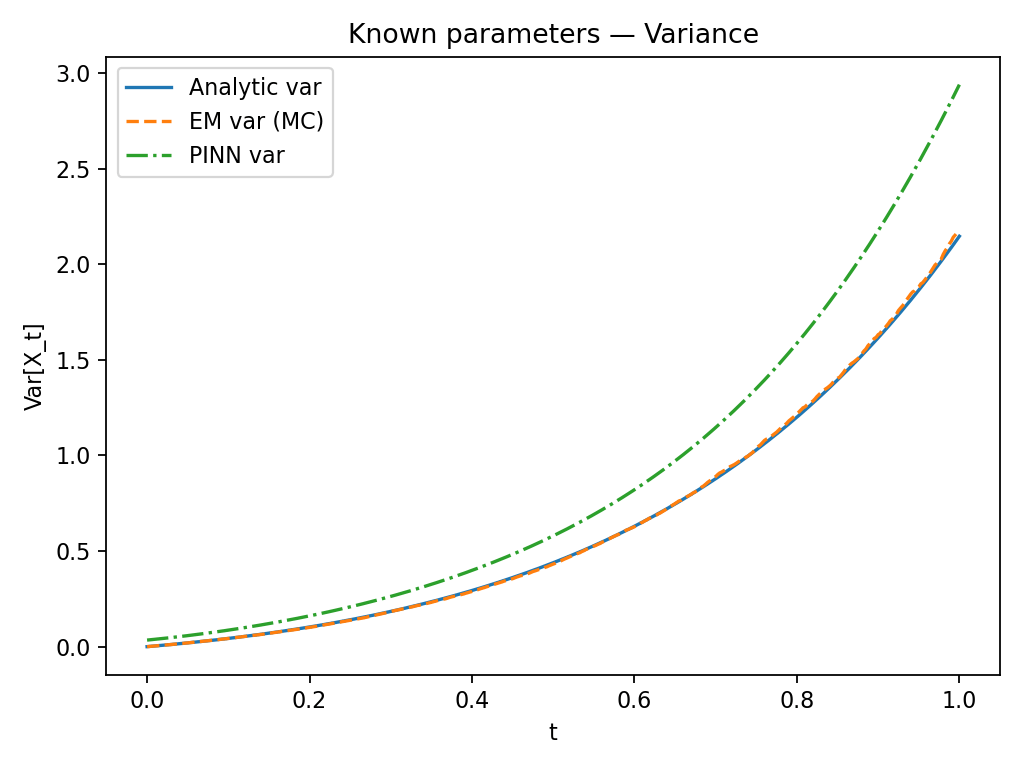
Comparación de momentos:
- Estimamos \(\mathbb{E}[X_t]\) y \(\operatorname{Var}[X_t]\) con muchas trayectorias (Monte Carlo).
Validamos con las fórmulas del GBM:
$$\mathbb{E}[X_t] = x_0 e^{\mu t}, \quad \operatorname{Var}[X_t] = x_0^2 e^{2\mu t}\big(e^{\sigma^2 t} - 1\big)$$
Costo computacional:
- EM: barato por trayectoria, pero se necesitan muchas para obtener estadísticas.
- PINN: entrenamiento costoso, evaluación rápida una vez entrenada.
| Característica | Métodos clásicos | PINNs |
|---|---|---|
| Teoría | Sólida | En desarrollo |
| Interpretabilidad | Alta | Moderada |
| Dimensión alta | Difícil | Mejor |
| Integración de datos | Limitada | Natural |
| Garantías de estabilidad | Sí | A menudo inciertas |
Referencias
- An algorithmic introduction to numerical simulation of stochastic differential equations. SIAM Review, 43(3):525–546, 2001. doi:10.1137/S0036144500378302
- Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378:686–707, 2019. doi:10.1016/j.jcp.2018.10.045
- Error bounds for physics-informed neural networks in Fokker-Planck PDEs. In Proceedings of the Forty-first Conference on Uncertainty in Artificial Intelligence, Proceedings of Machine Learning Research, volume 286, pages 2291–2324, 2025. Fuente PMLR
ODE y SDE neuronales
ODE neuronales
Una ecuación diferencial ordinaria neuronal es una ecuación diferencial cuyo campo vectorial está parametrizado por una red neuronal.
La idea central es integrar un solucionador de ecuaciones diferenciales en un grafo computacional diferenciable que se aprende, como los usados en aprendizaje profundo.
Chen et al. Neural Ordinary Differential Equations. in Advances in Neural Information Processing Systems (eds. Bengio, S. et al.) vol. 31 (2018).
arXiv:1806.07366
Podemos minimizar la función de pérdida con métodos basados en gradientes ; para ello necesitamos una forma eficiente de calcular el gradiente.
La ecuación adjunta de la teoría de control óptimo es una herramienta fundamental.
La primera derivación de la ecuación adjunta se basa en el formalismo lagrangiano, donde \(a\), la variable adjunta, desempeña un papel similar al de un multiplicador de Lagrange
Los resultados muestran que resolver la ecuación adjunta hacia atrás en el tiempo proporciona el gradiente de la pérdida.
Costo en MNIST (Chen et al., Tabla 1)
ModeloErrorParám.MemoriaTiempo
| ResNet | 0.41% | 0.60 M | O(L) | O(L) |
| RK-Net | 0.47% | 0.22 M | O(L̃) | O(L̃) |
| ODE-Net | 0.42% | 0.22 M | O(1) | O(L̃) |
L: capas · L̃: evaluaciones de f (NFE), ajustables con la tolerancia. Hacia atrás ≈ 0.8× NFE del paso hacia adelante.
Algoritmo 1: estado aumentado en una sola llamada al solver hacia atrás; z(t) se reconstruye en vez de almacenarse ⇒ memoria O(1).
1. Pasada hacia adelante
2. Estado adjunto
3. Integración inversa
4. Gradientes de salida
ℒ
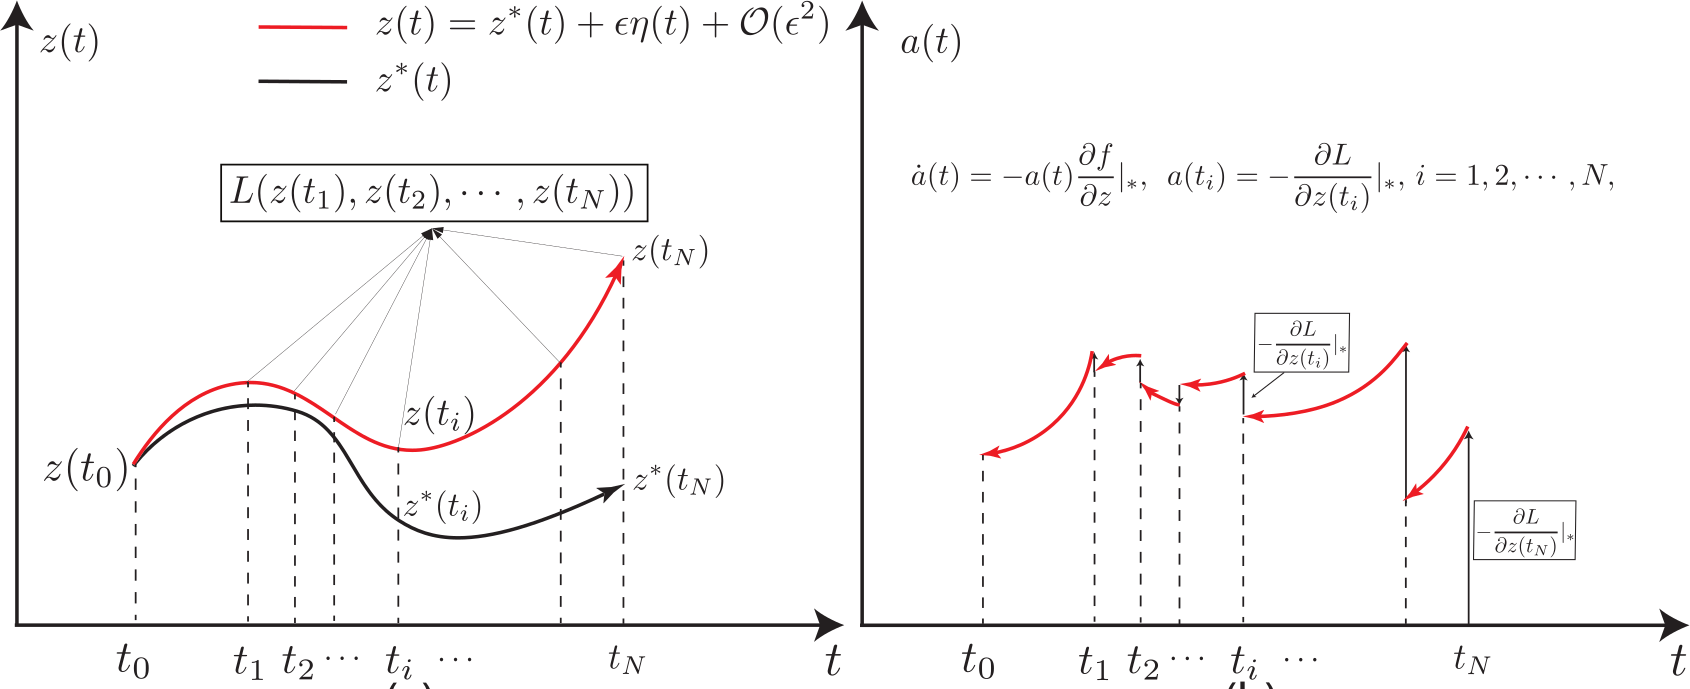
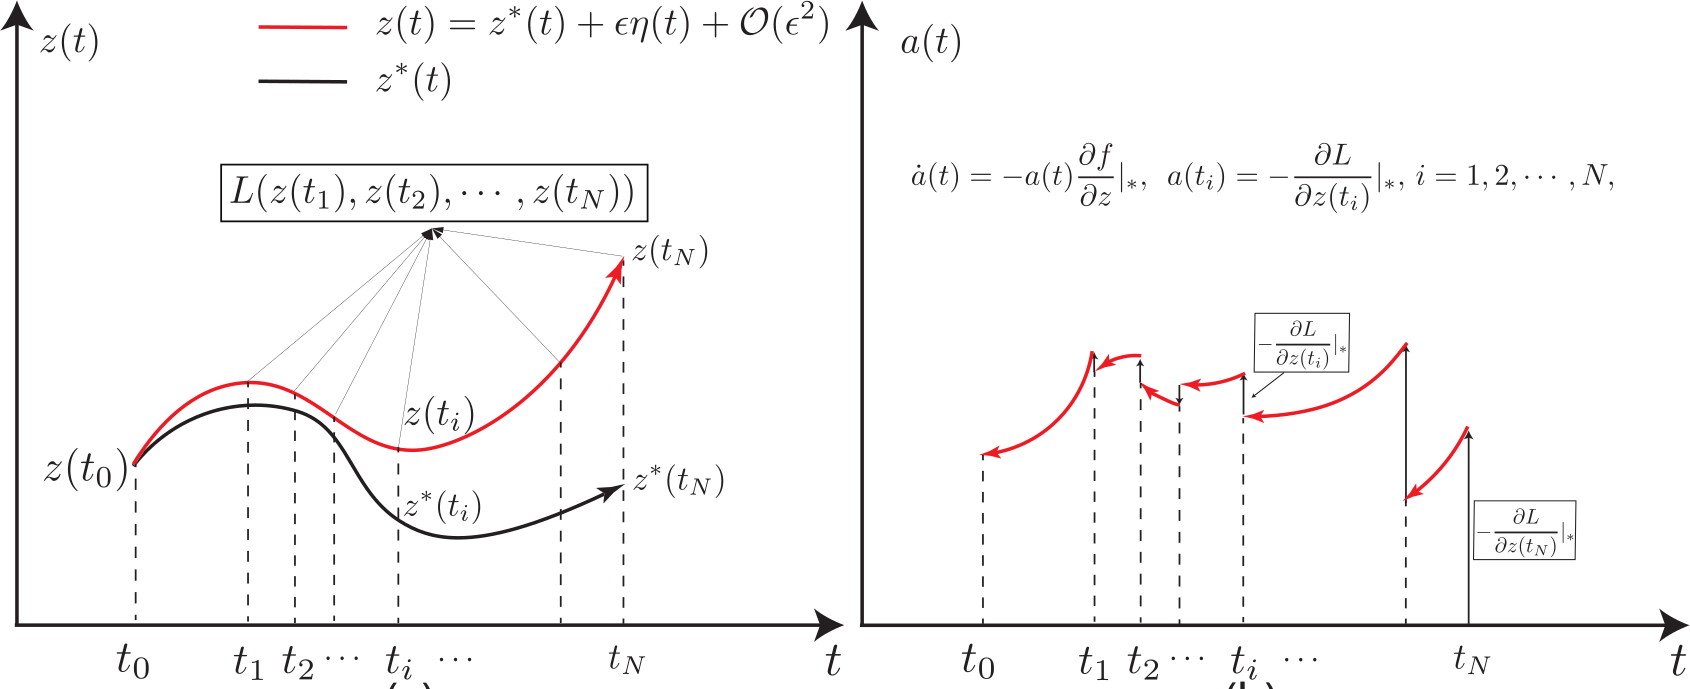
En el modelado de secuencias y el análisis de series temporales, la pérdida suele depender del estado en varios tiempos discretos \(\{t_1, t_2, \dots, t_N\}\).
El problema de optimización es:
Método adjunto para pérdidas en varios tiempos
$$\left( \frac{\partial L}{\partial \theta} \right)_k = \sum_{i=1}^{N} \frac{\partial L}{\partial z(t_i)} \frac{\partial z(t_i)}{\partial \theta_k}$$
$$\frac{\partial z(t_i)}{\partial \theta_k} = \int_{t_0}^{t_N} \frac{\partial z(t)}{\partial \theta_k} \delta(t - t_i) dt$$
$$\left( \frac{\partial L}{\partial \theta} \right)_k = \int_{t_0}^{t_N} \frac{\partial z(t)}{\partial \theta_k} \left( \sum_{i=1}^{N} \frac{\partial L}{\partial z(t_i)} \delta(t - t_i) \right) dt$$
$$\left( \frac{\partial L}{\partial \theta} \right)_k = \left\langle \sum_{i=1}^{N} \frac{\partial L}{\partial z(t_i)} \delta(t - t_i), \frac{\partial z(t)}{\partial \theta_k} \right\rangle_{X^*, X}$$
Al diferenciar ambos lados de la ecuación de restricción respecto de \(\theta\)
Supongamos que \(a\) = \(a(t)\) tal que
Integrando por partes
SDE neuronal
Simulamos la SDE hacia adelante, obtenemos \(Z_T\) y calculamos la pérdida
\[\mathcal L = \ell(Z_T).\]
Sin embargo, el paso hacia atrás debe usar la misma trayectoria browniana que el paso hacia adelante.
No es válido invertir directamente una SDE de Itô. La construcción en tiempo inverso utiliza la forma de Stratonovich:
Para una trayectoria browniana fija, la SDE de Stratonovich define un flujo estocástico
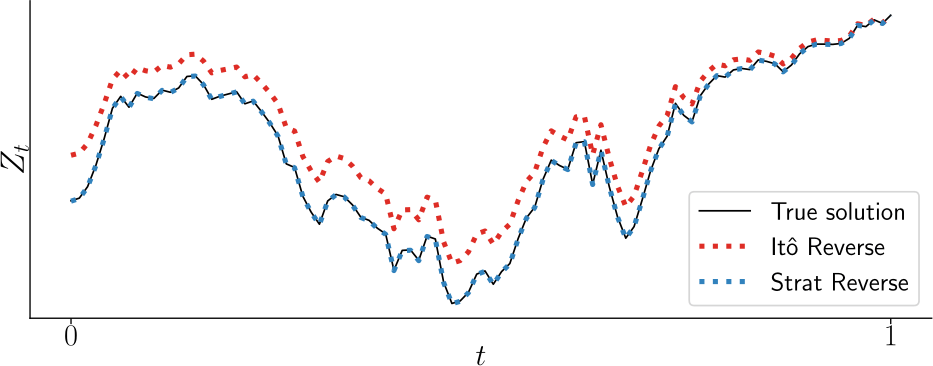
Reconstrucción del estado hacia atrás
El flujo estocástico inverso reconstruye el estado anterior a partir del estado terminal:
Referencias: PINNs y cuantificación de incertidumbre
- NeuralUQ: A Comprehensive Library for Uncertainty Quantification in Neural Differential Equations and Operators. SIAM Review, 66(1):161–190, 2024. doi:10.1137/21M1446859
- Uncertainty Quantification in Scientific Machine Learning: Methods, Metrics, and Comparisons. Journal of Computational Physics, 477:111902, 2023. doi:10.1016/j.jcp.2022.111902
- Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378:686-707, 2019. doi:10.1016/j.jcp.2018.10.045
Referencias: ODE y SDE neuronales
- Neural ordinary differential equations. Advances in Neural Information Processing Systems, 31, 2018. Fuente NeurIPS
- Solving ordinary differential equations I: Nonstiff problems. Springer Series in Computational Mathematics, volume 8, second edition, Springer, 1993. doi:10.1007/978-3-540-78862-1
- “Hey, that’s not an ODE”: Faster ODE adjoints via seminorms. In Proceedings of the 38th International Conference on Machine Learning, Proceedings of Machine Learning Research, 139:5443–5452, 2021. Fuente PMLR
- Scalable gradients for stochastic differential equations. In Proceedings of the 23rd International Conference on Artificial Intelligence and Statistics (AISTATS), Proceedings of Machine Learning Research, 108:3870-3882, 2020. Fuente PMLR
- Neural SDEs as Infinite-Dimensional GANs. In Proceedings of the 38th International Conference on Machine Learning, Proceedings of Machine Learning Research, 139:5453-5463, 2021. Fuente PMLR
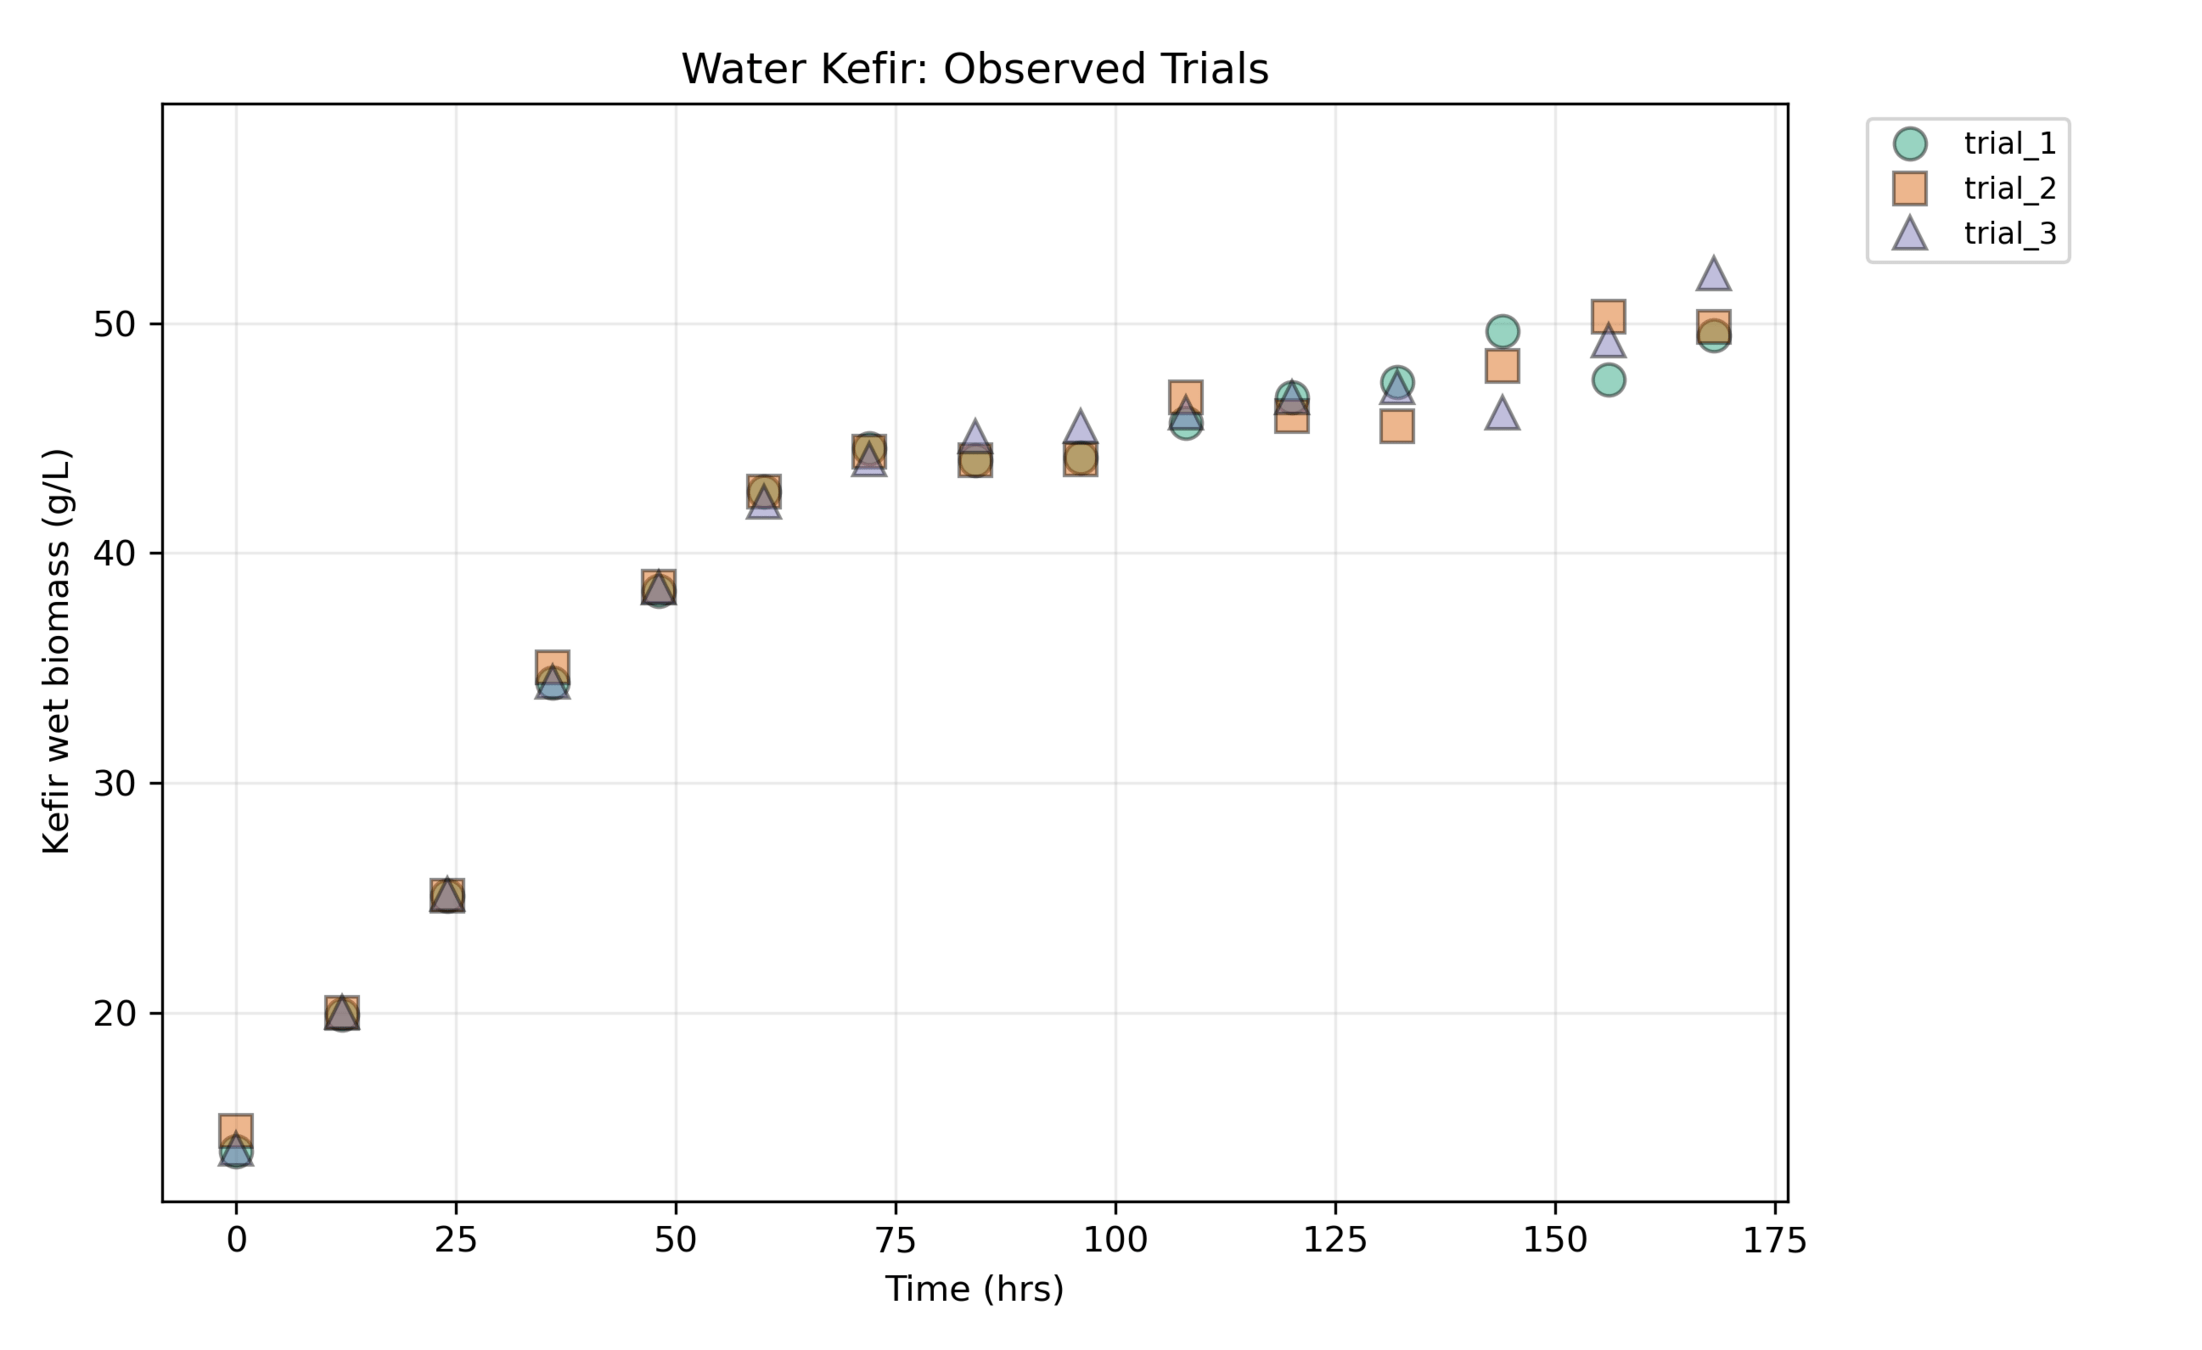
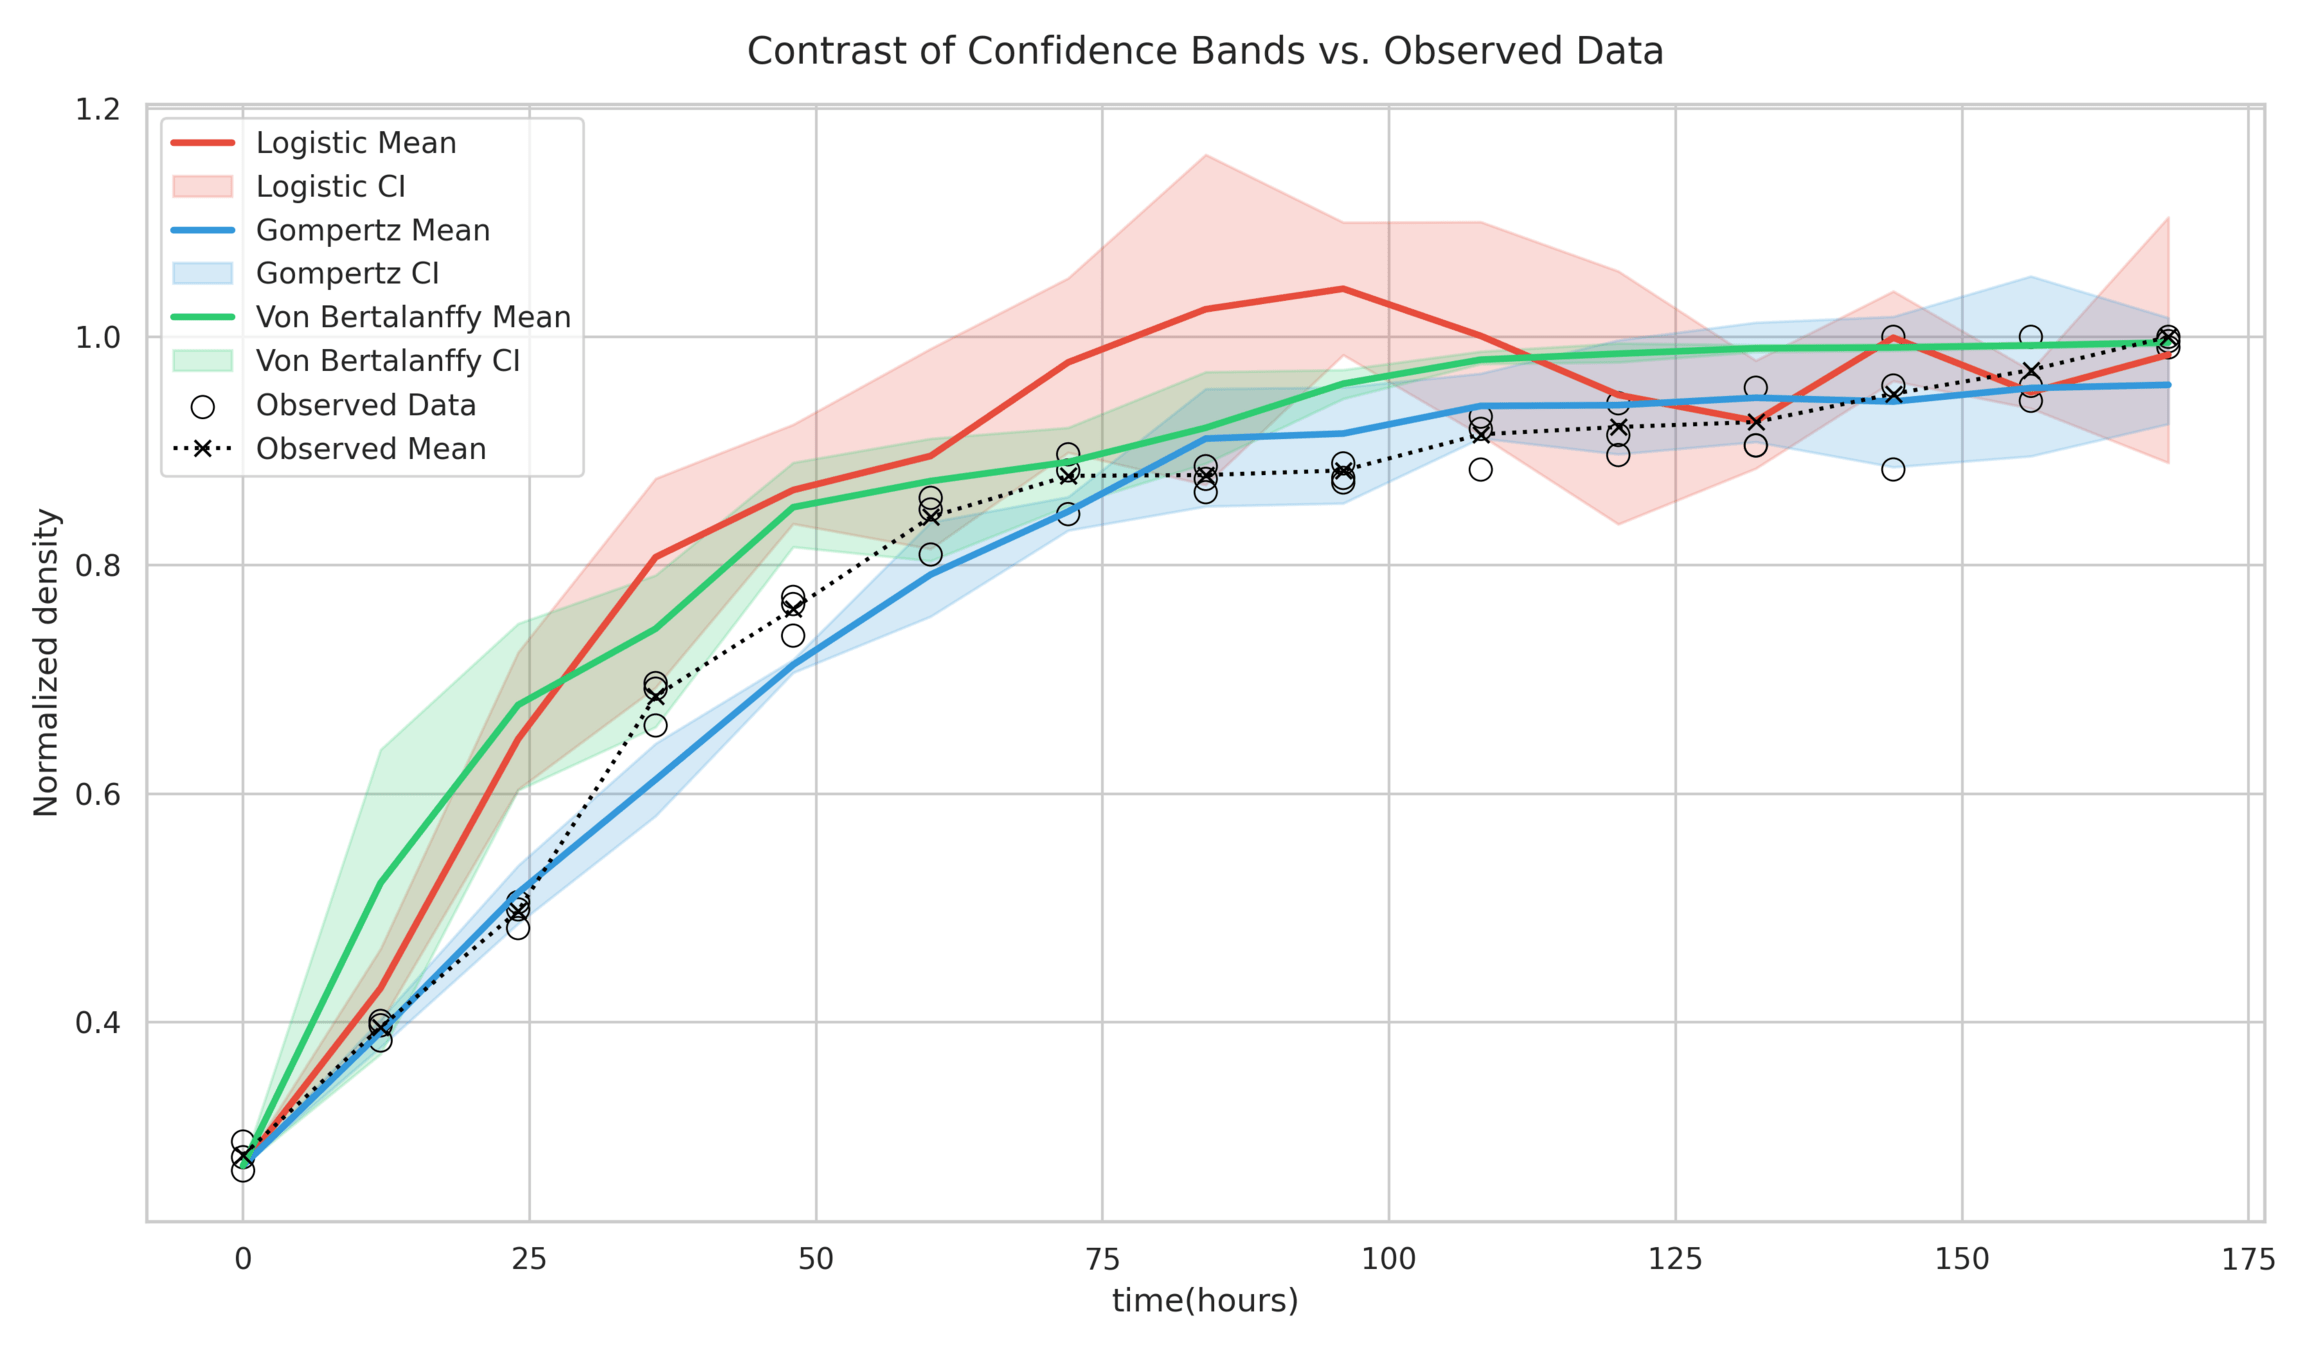
Ajuste de datos de producción de kéfir de agua
Ejemplo con datos reales
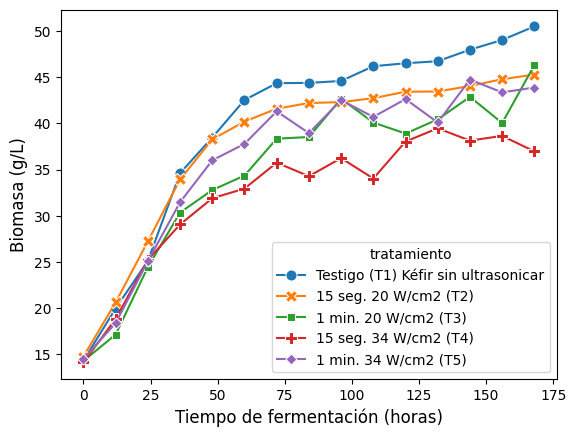
Producción de kéfir de agua
Dr. José Carlos Rodríguez Figueroa
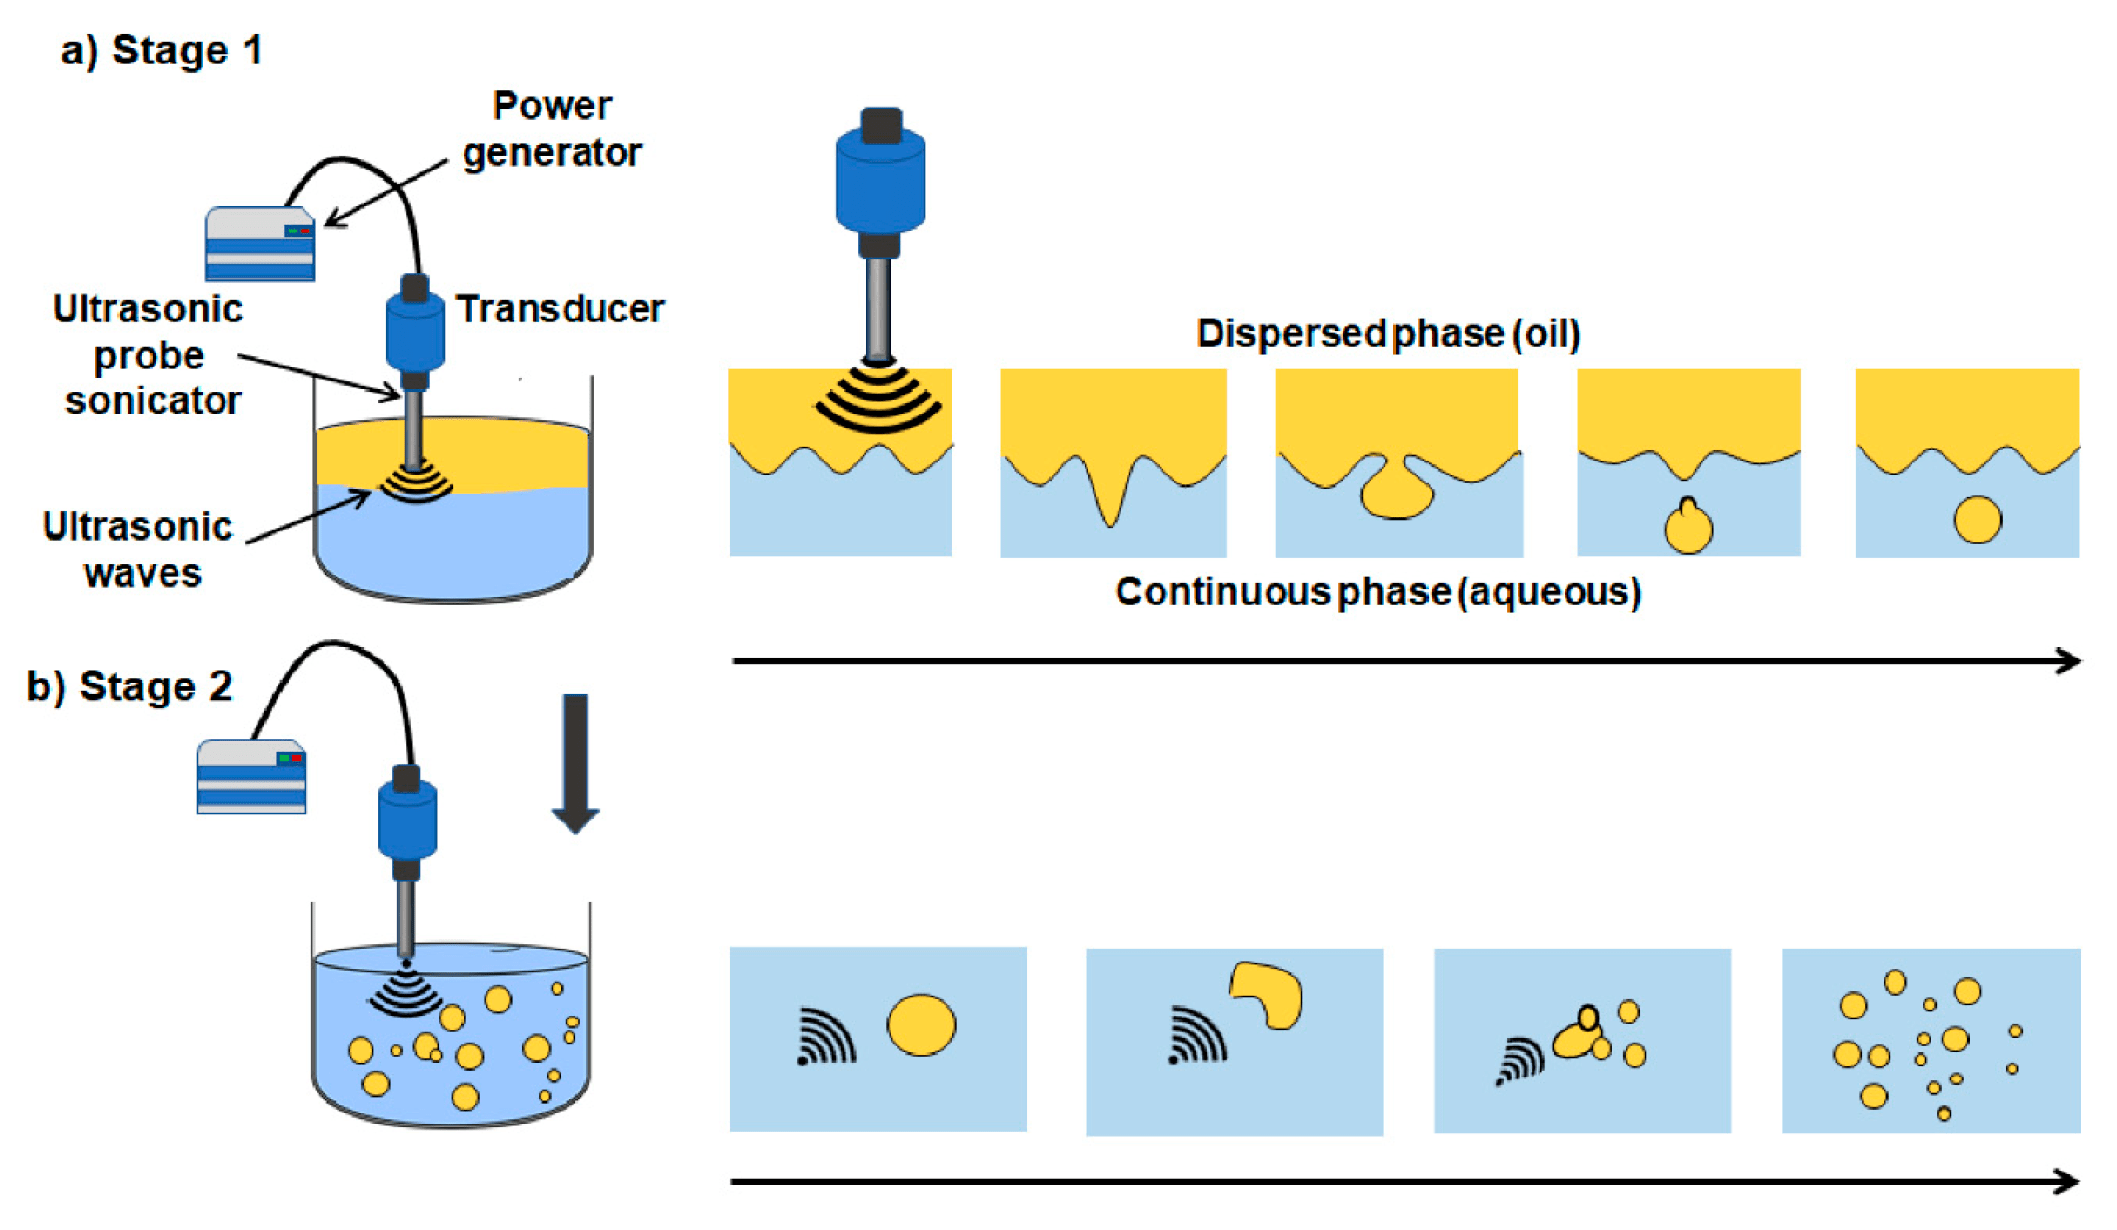
Efecto del ultrasonido de intensidad alta y la fermentación sobre los metabolitos específicos y propiedades funcionales del kéfir de agua
Yanet Proenza, D. (Autor), Rodríguez Figueroa, J. C. (Director). 2025
Tesis de máster
Parametrización de la ODE neuronal
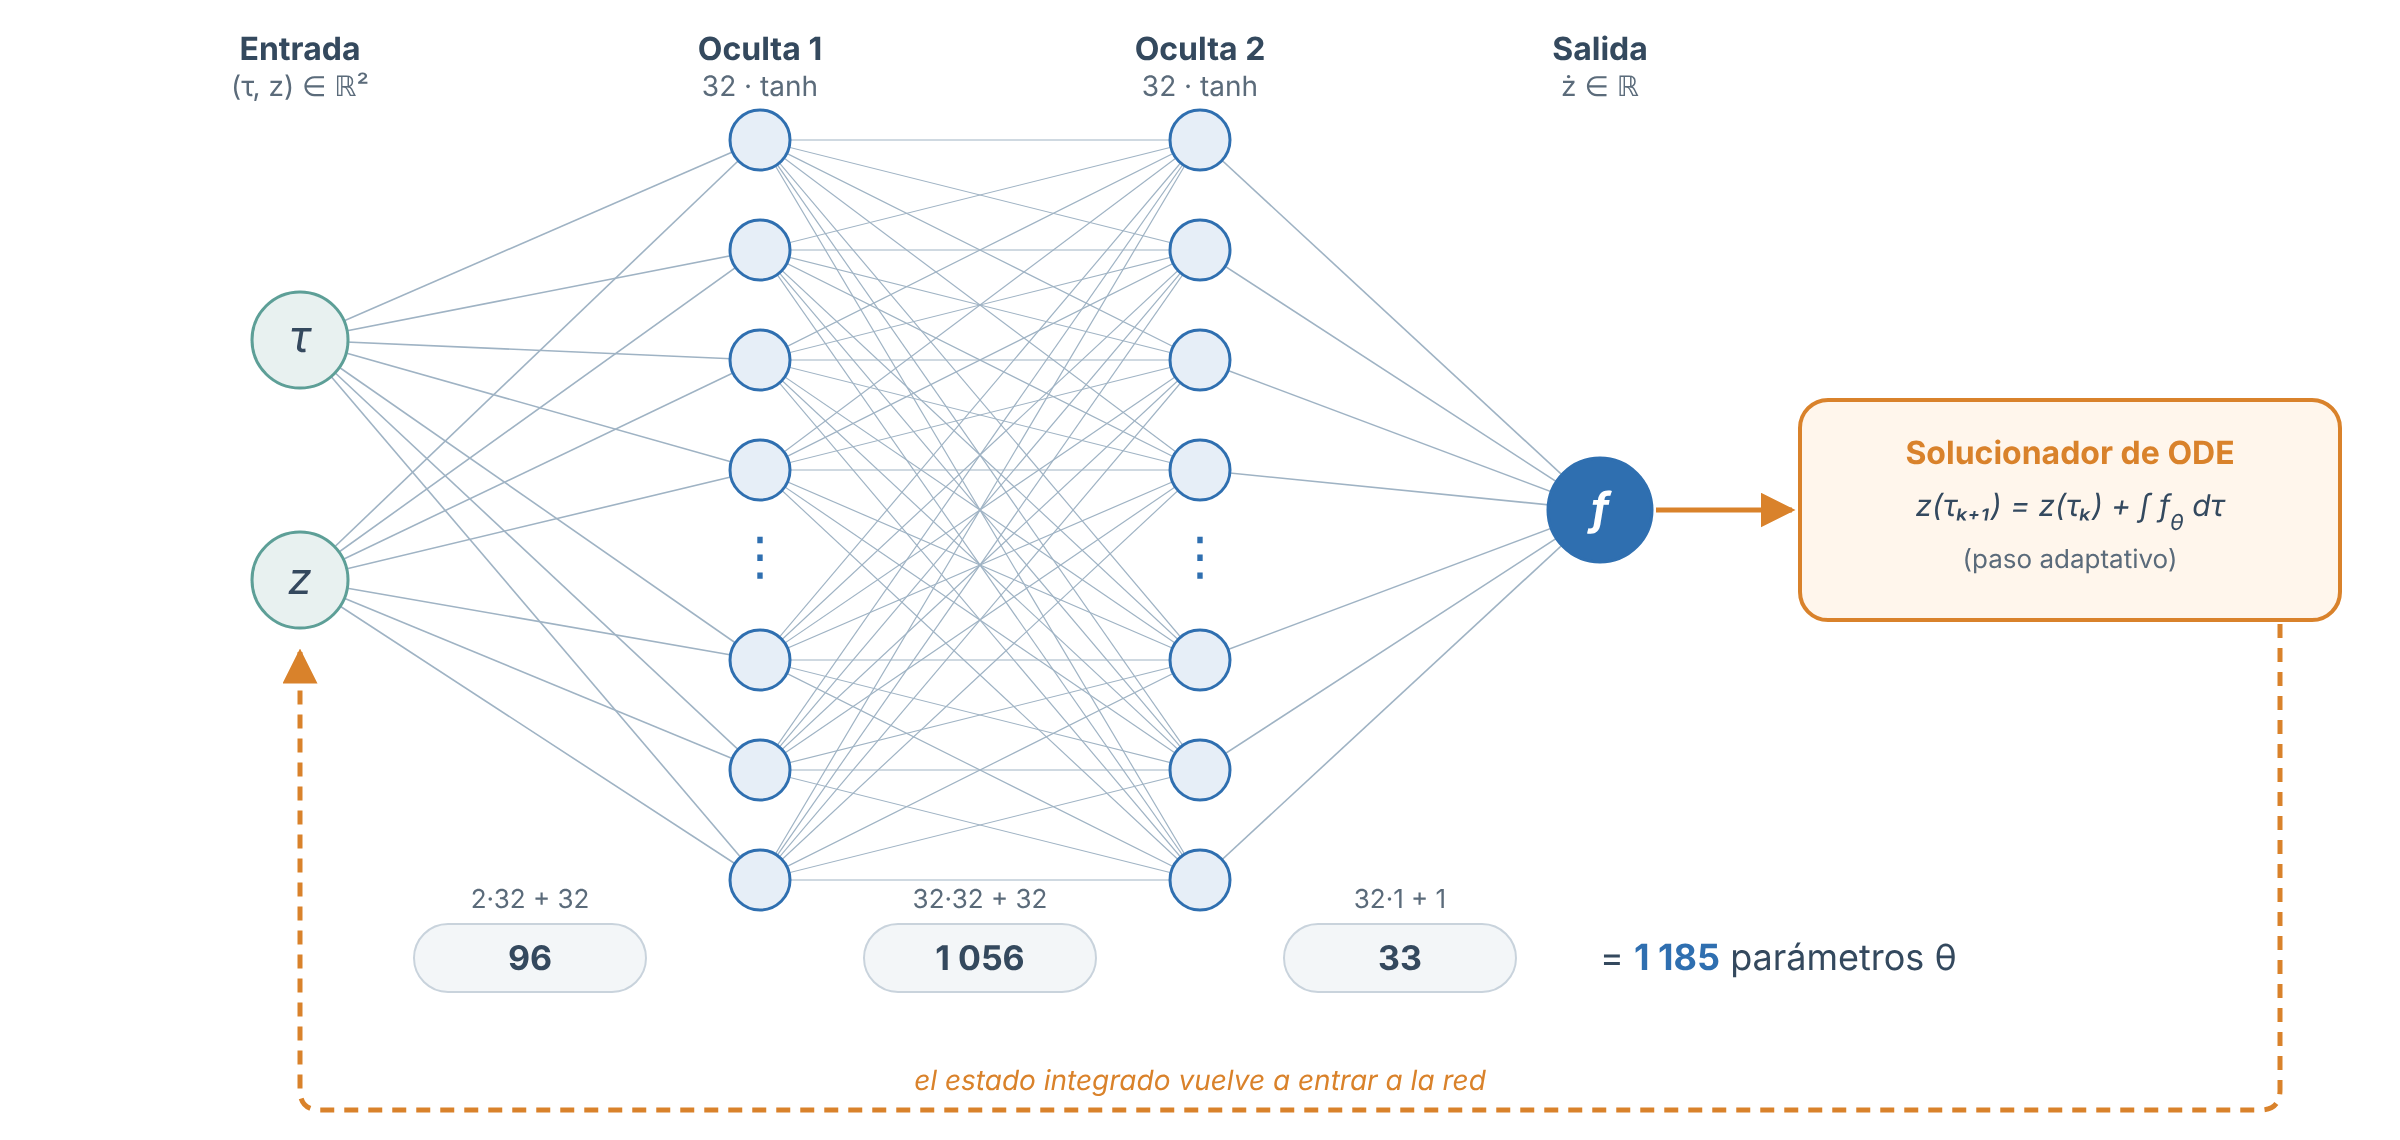
- La red sustituye todo el lado derecho logístico: no se impone forma funcional.
- Tiempo reescalado: \(\tau = \frac{t - t_{\min}}{t_{\max} - t_{\min}} \in [0,1]\).
- Entrada \((\tau, z)\) → 2 capas \(\tanh\) de 32 → salida \(\frac{dz}{d\tau}\).
- \(\theta\) se ajusta derivando a través del solucionador (método adjunto) para minimizar \(\mathcal{L}_{\mathrm{ODE}}\).
Logística · 2 parámetros (r, K)
ODE neuronal · 1 185 parámetros θ
Misma ecuación de estado, distinto campo vectorial: la ganancia en flexibilidad se paga con ~600× más parámetros.
El lado derecho \(f_\theta\) es una red neuronal totalmente conectada con entrada
\((\tau,z) \in \mathbb R^2\), dos capas ocultas, 32 unidades por capa y
activación tangente hiperbólica:
Sean \(\{\xi_m\}_{m=1}^M\), con \(M=128\), puntos de colocación equiespaciados en \([0,1]\).
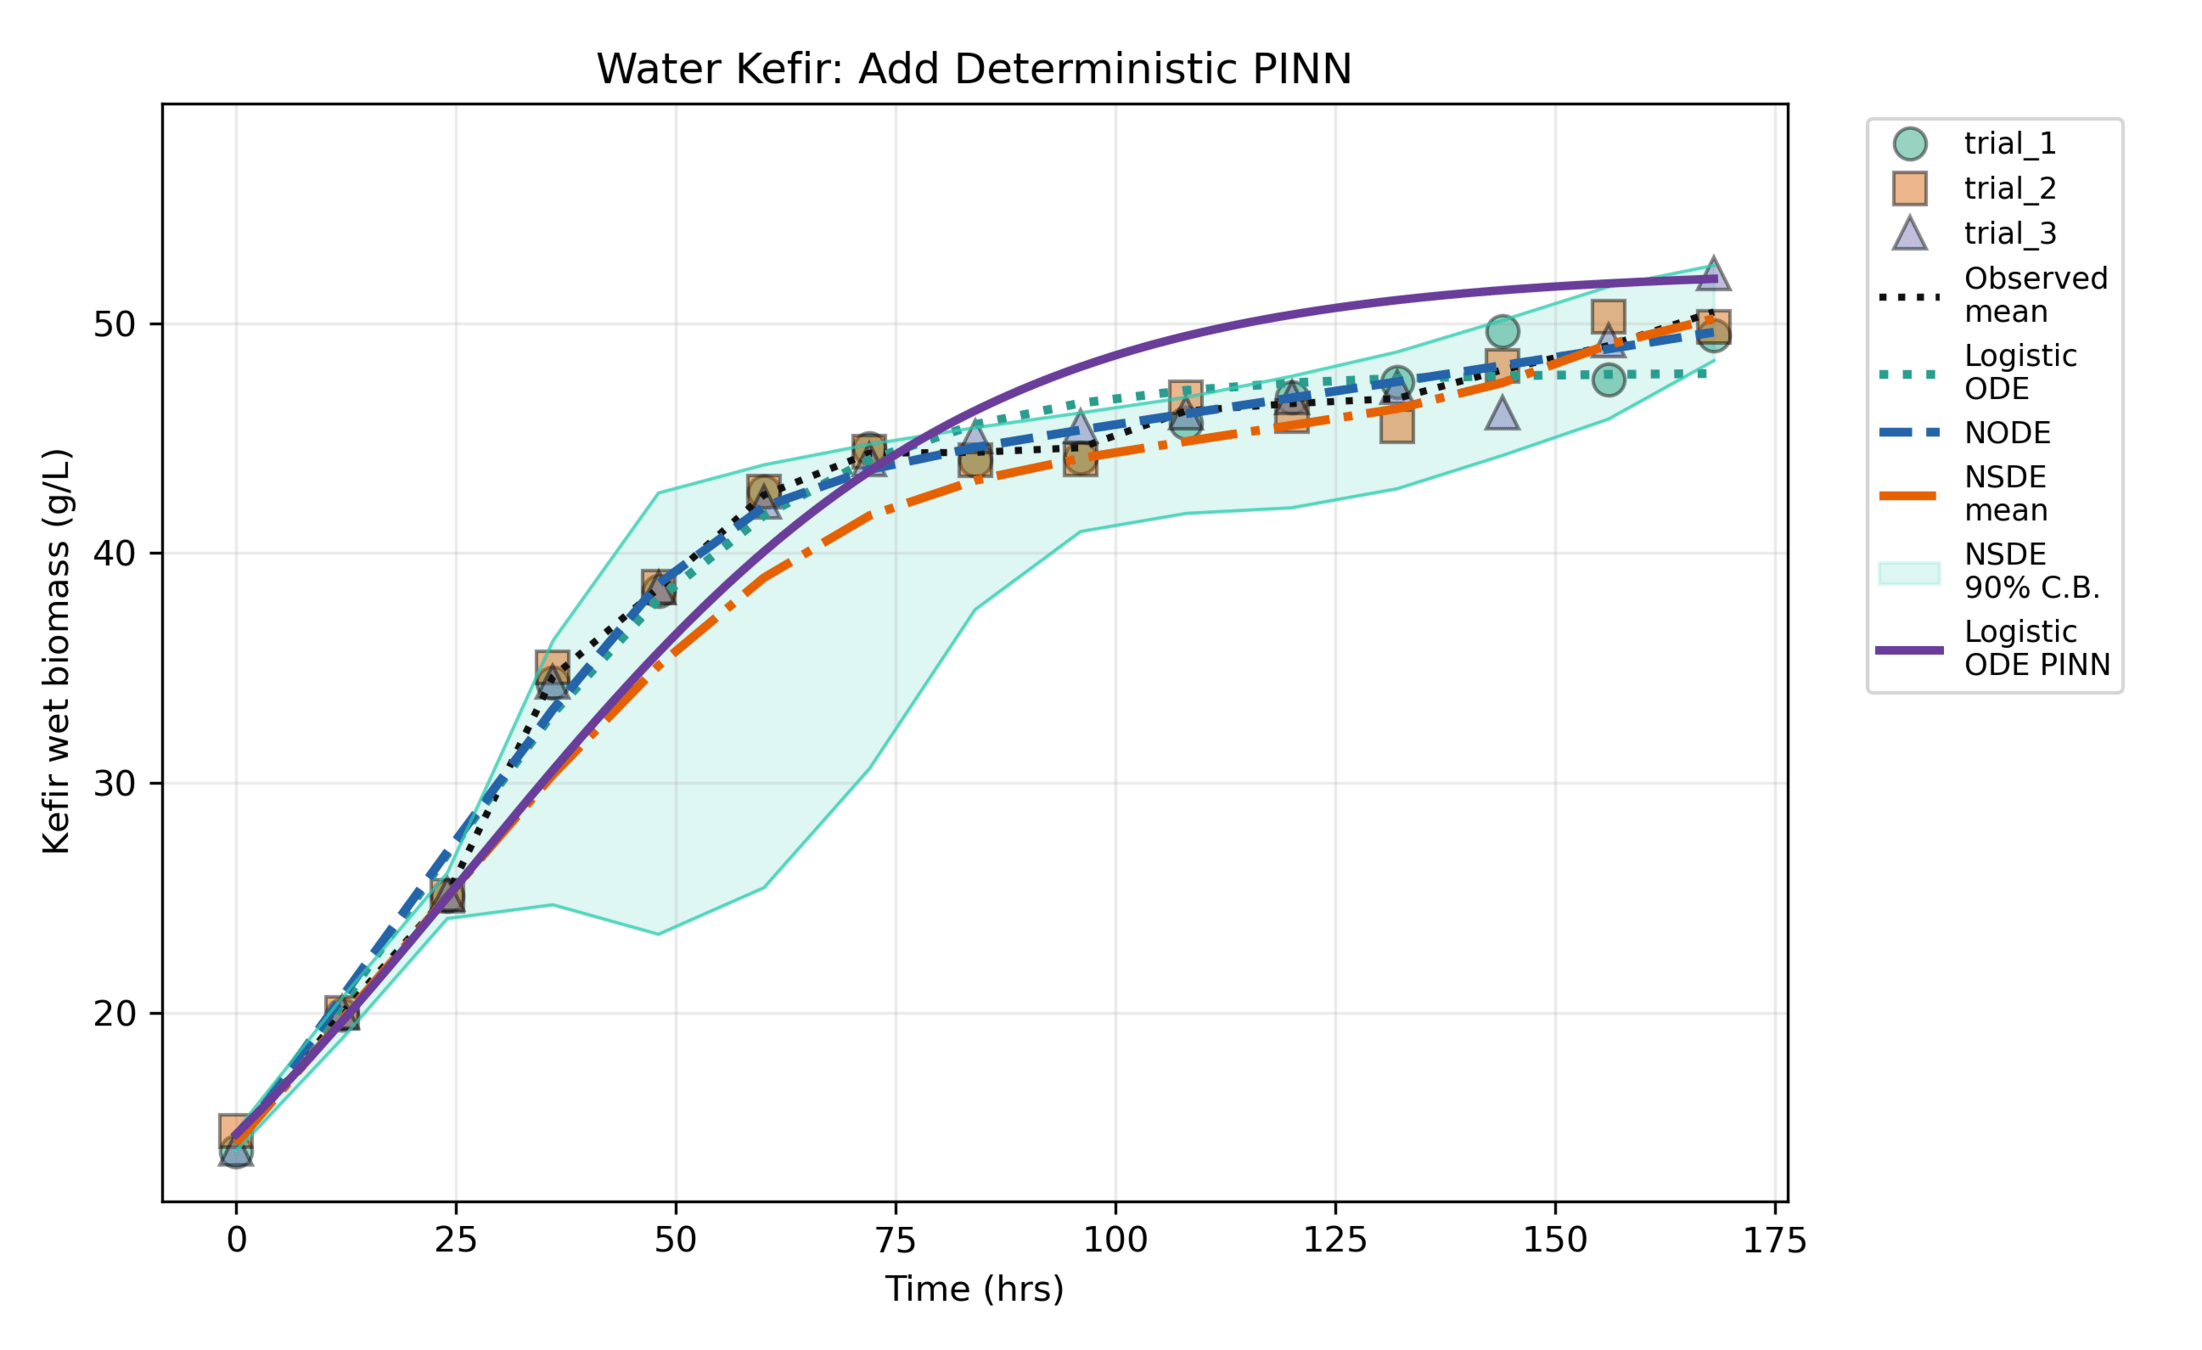
La PINN determinista
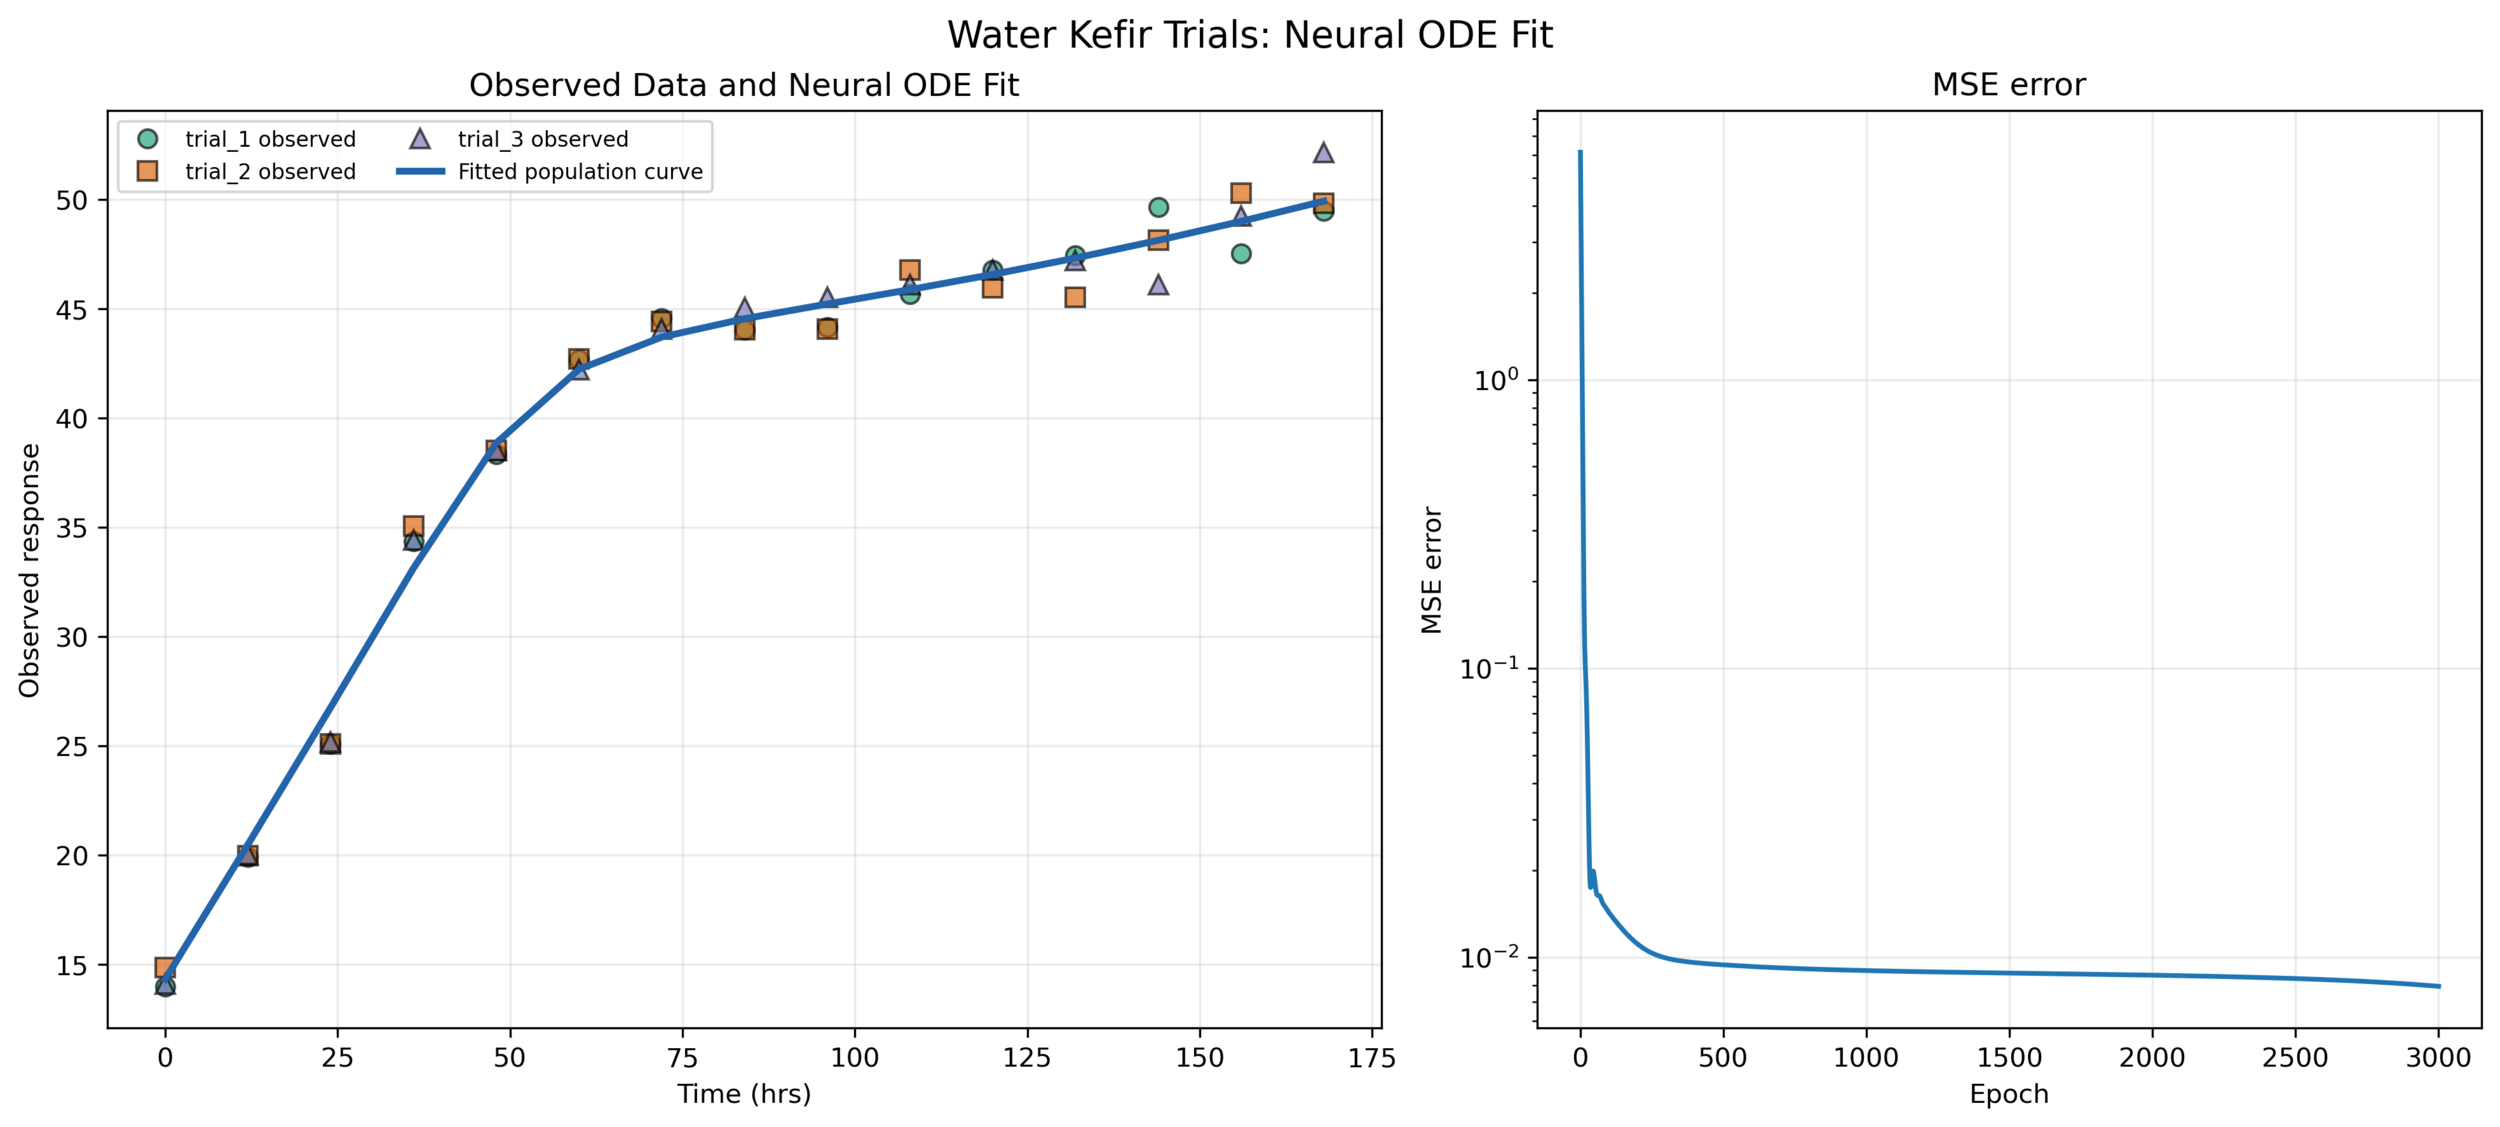
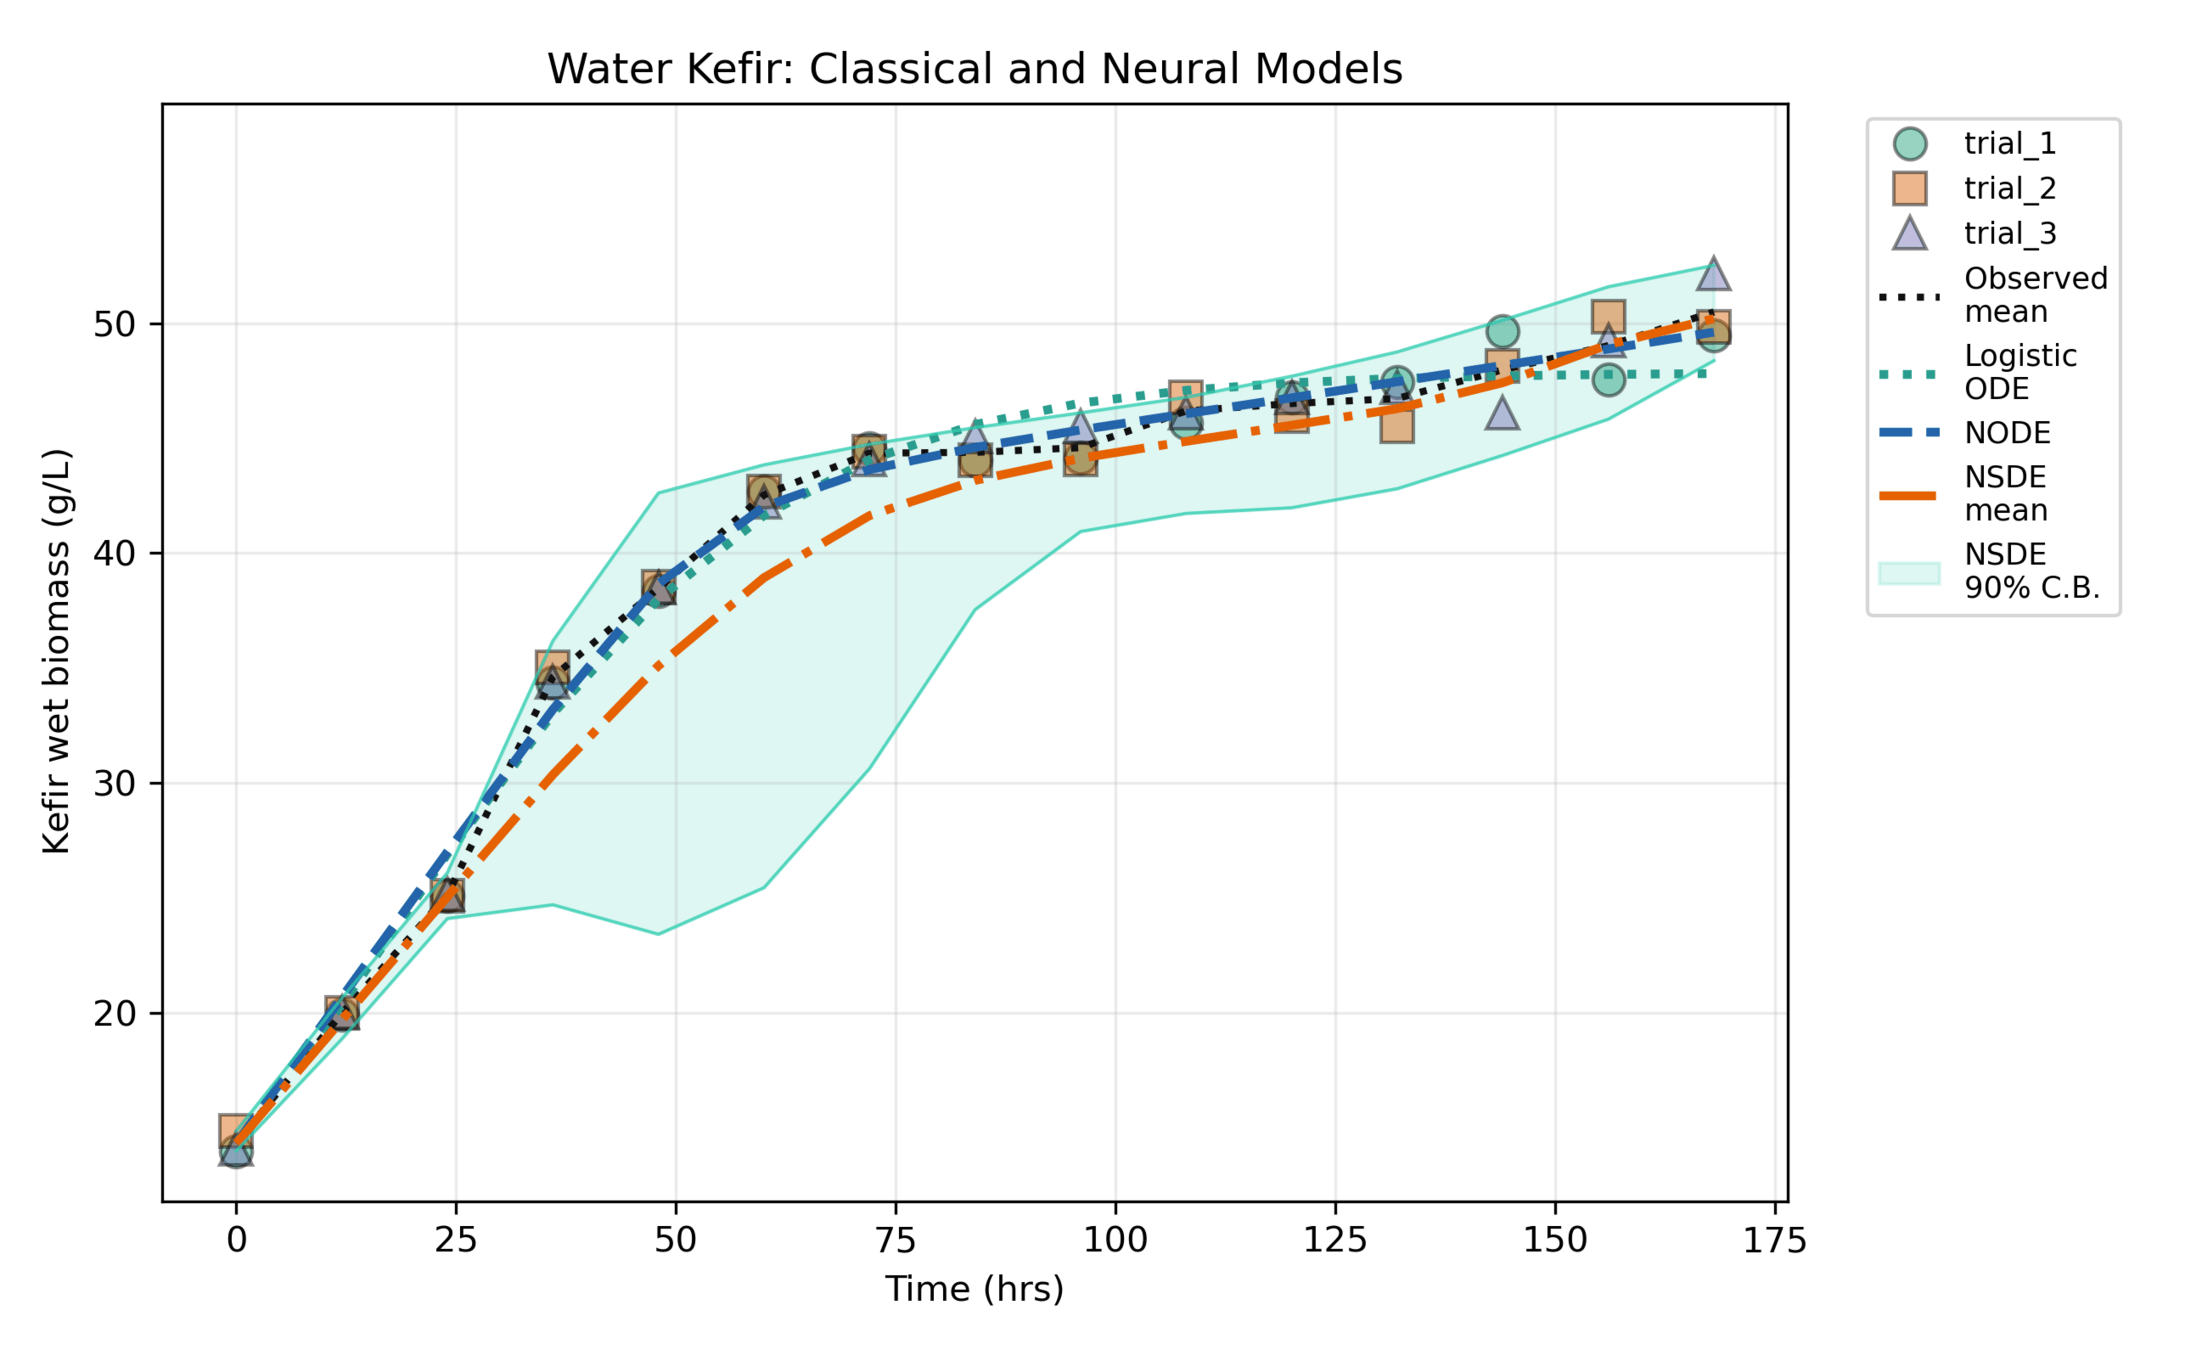
Ajuste de la ODE neuronal
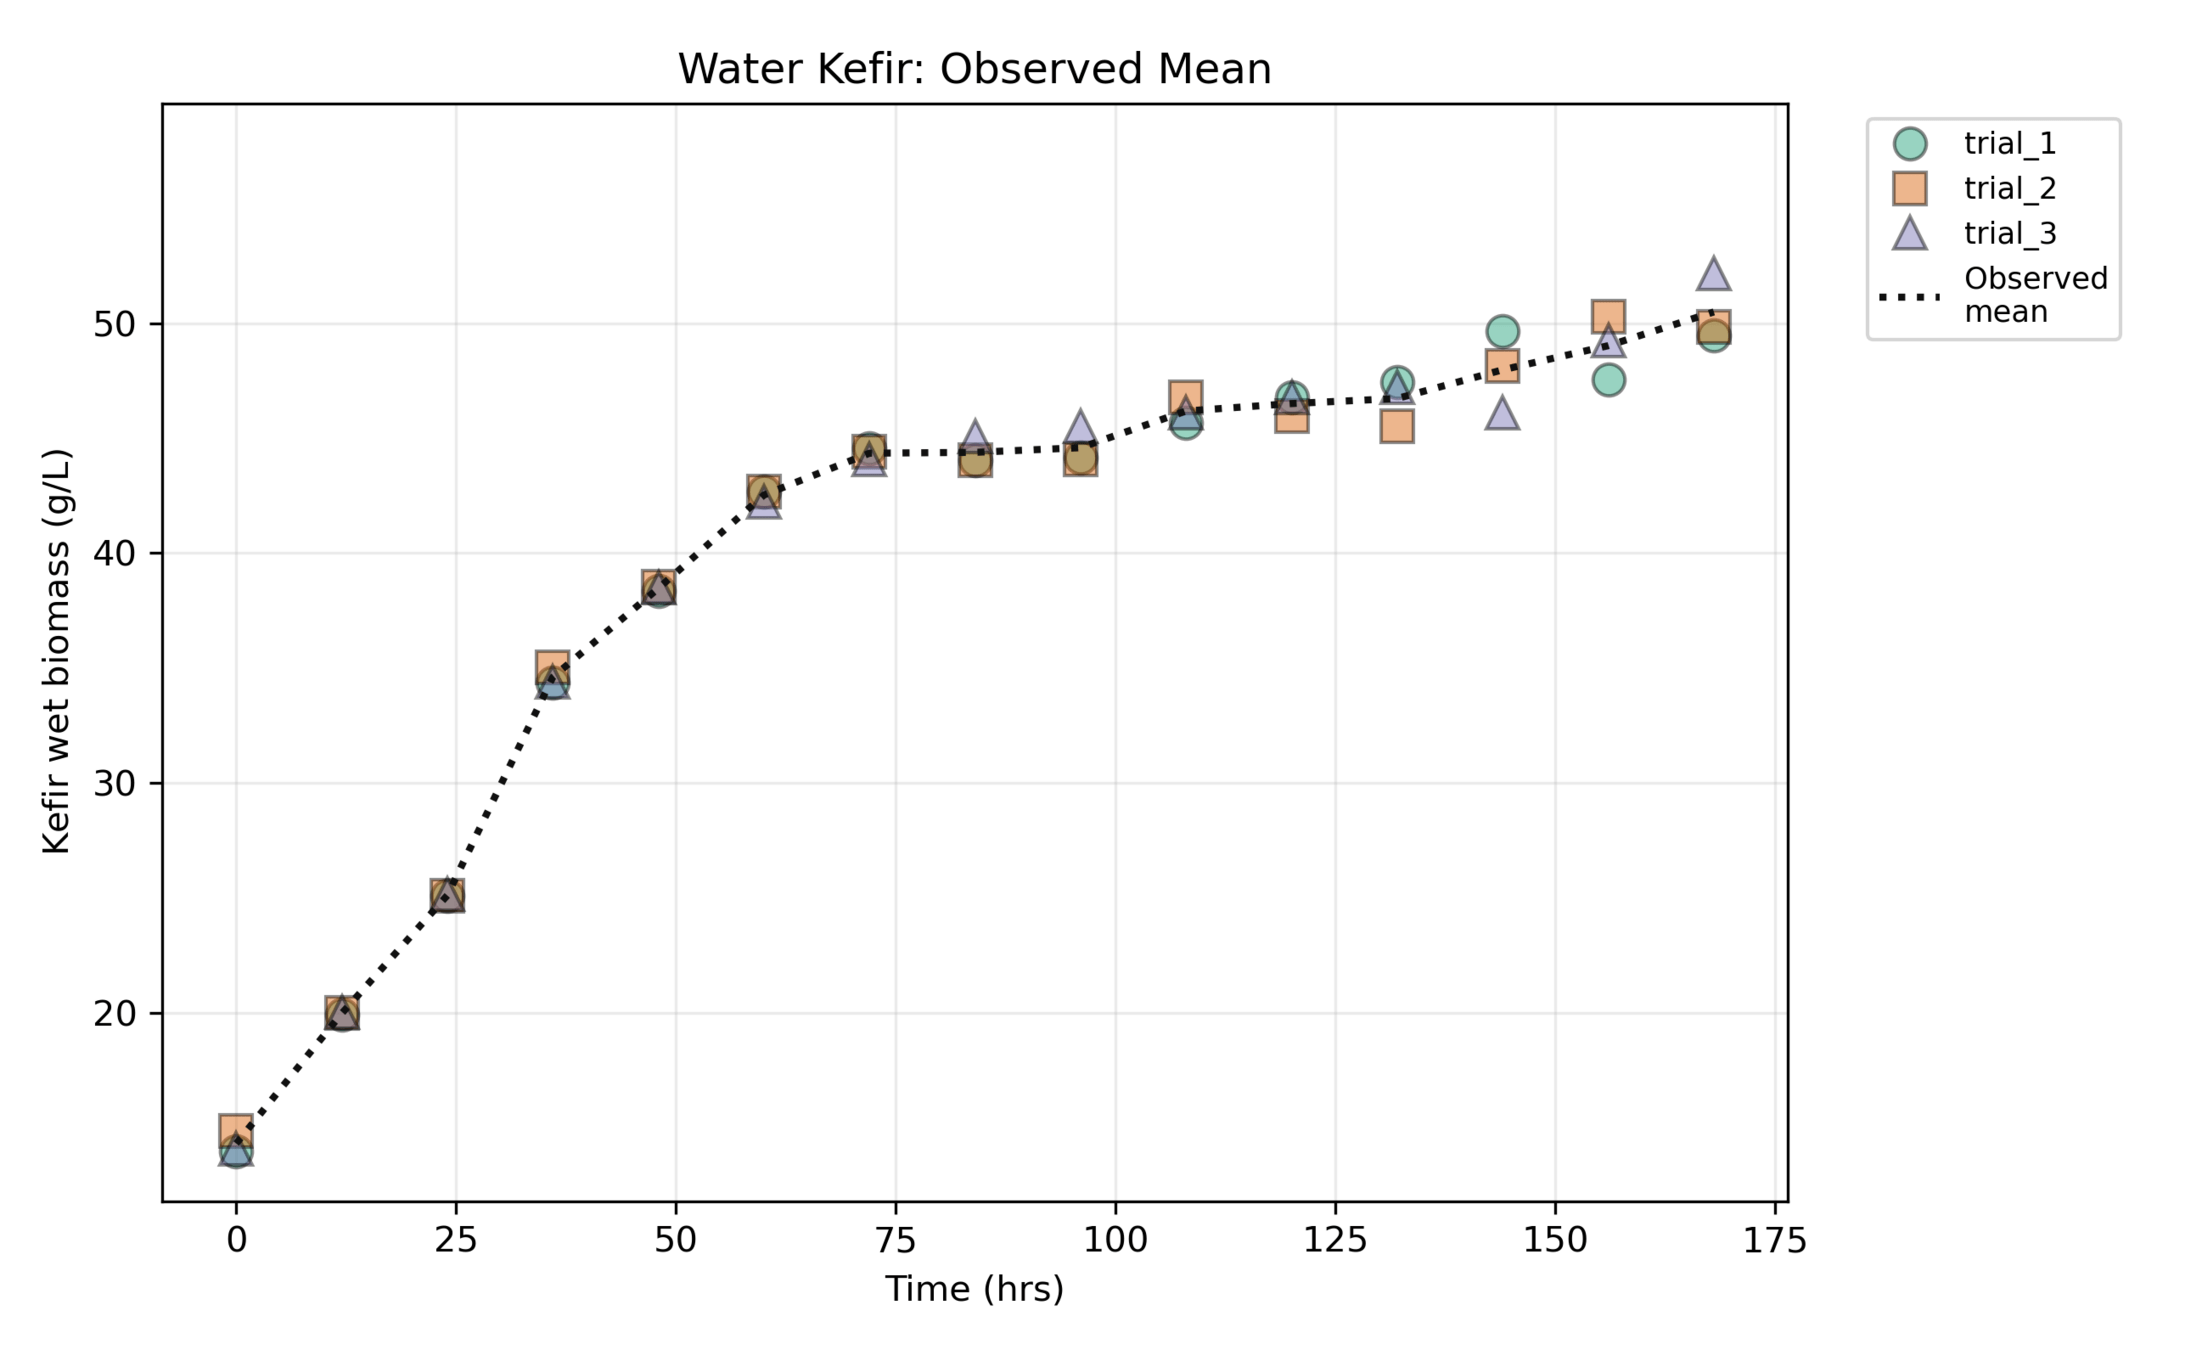
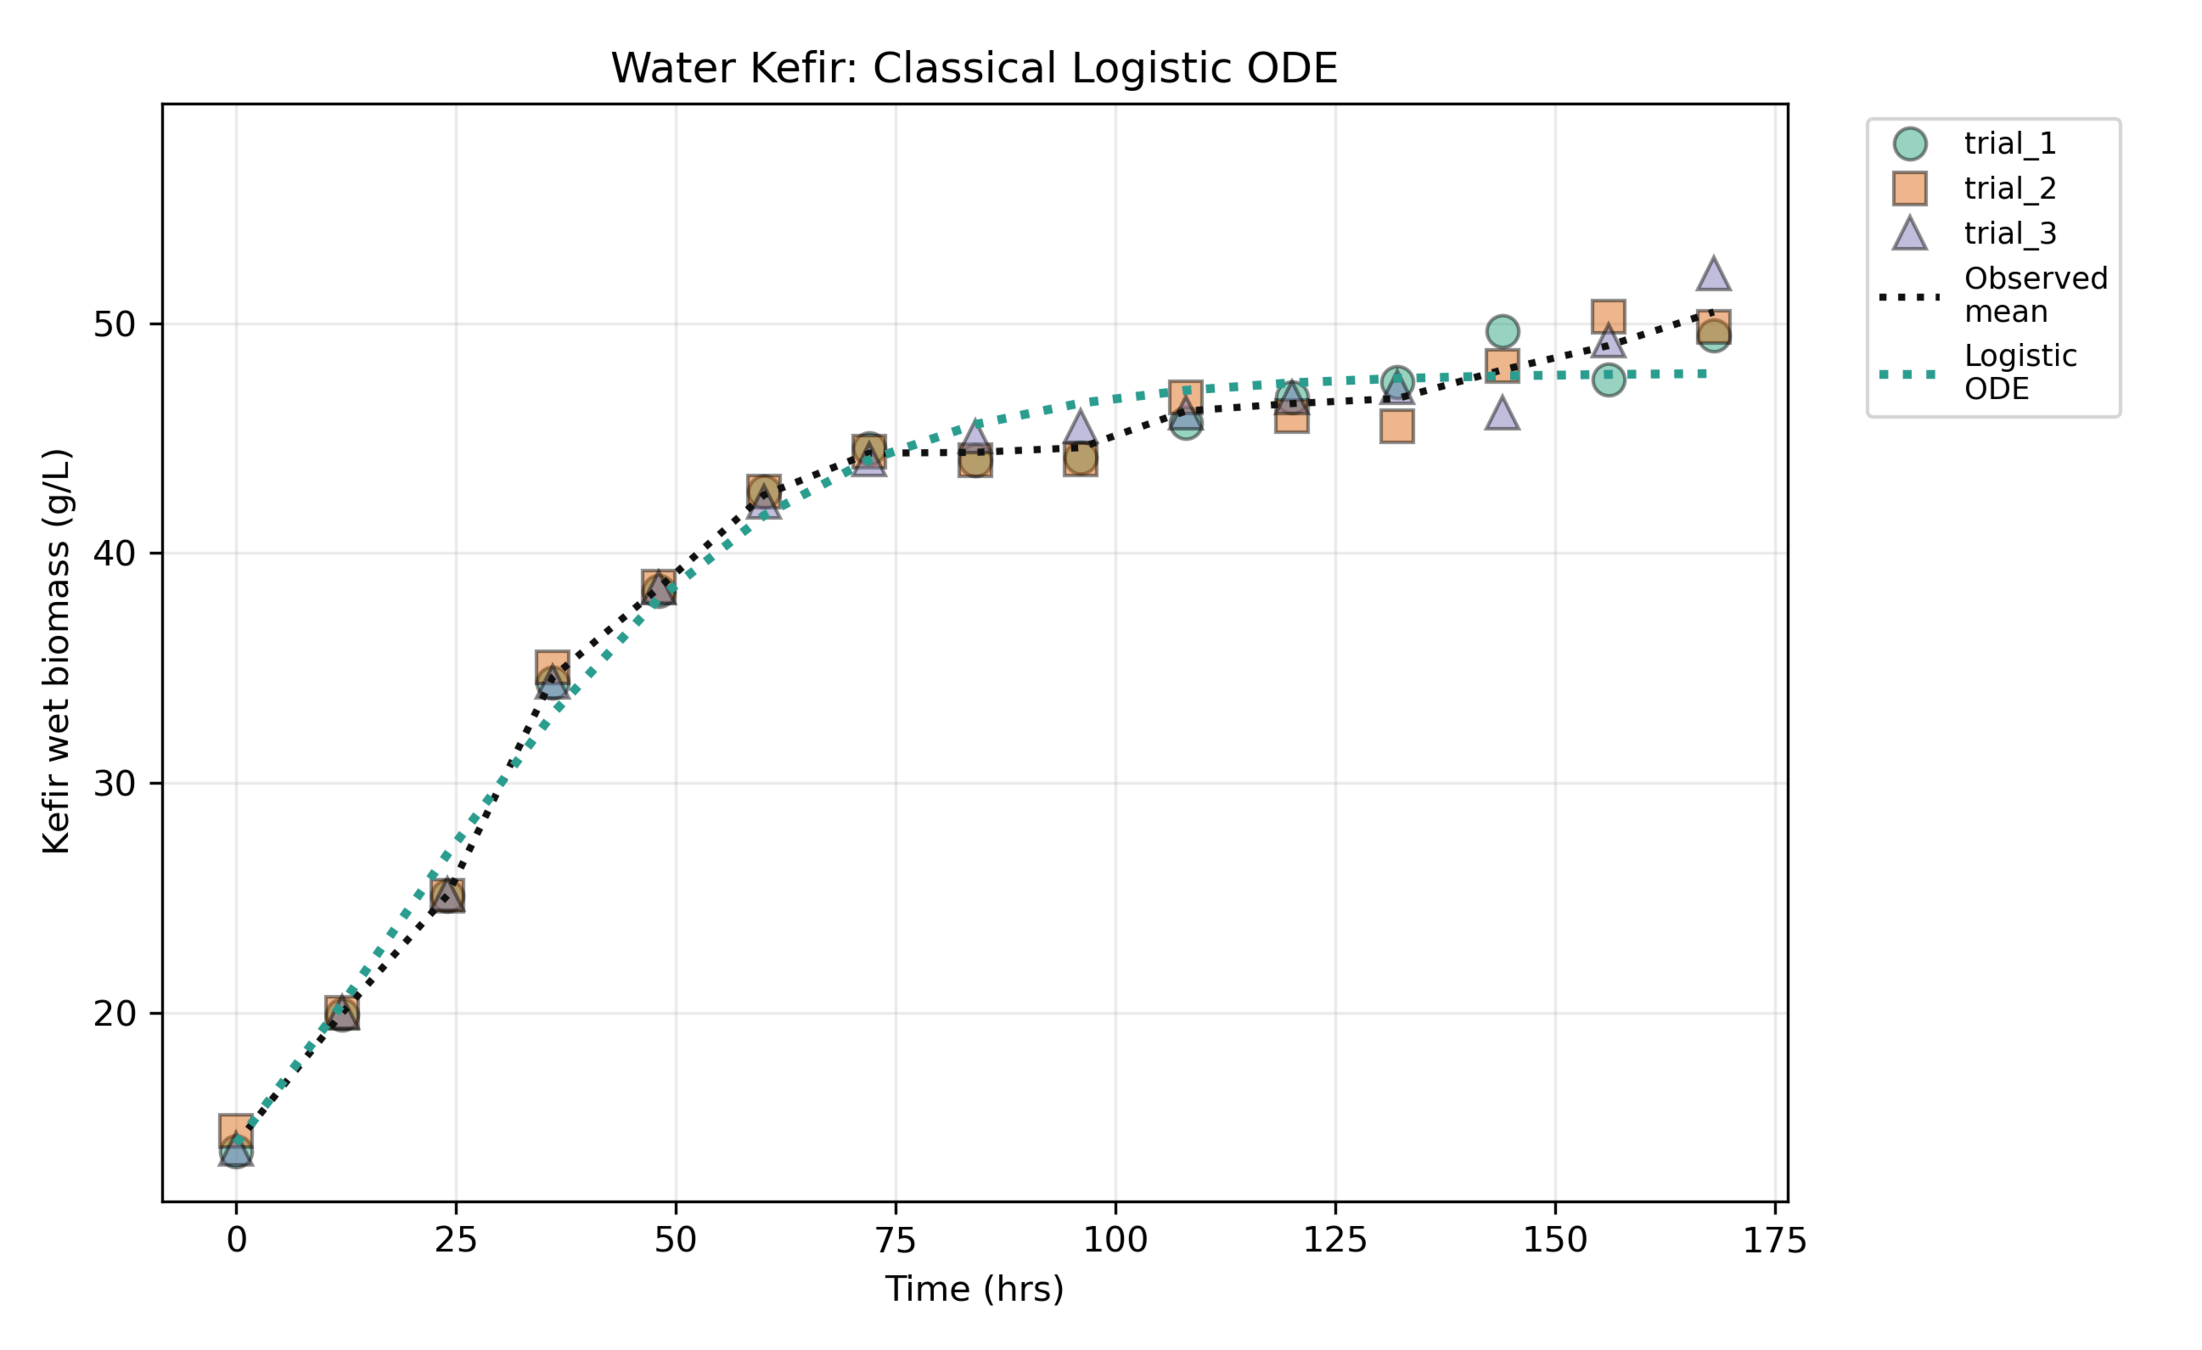
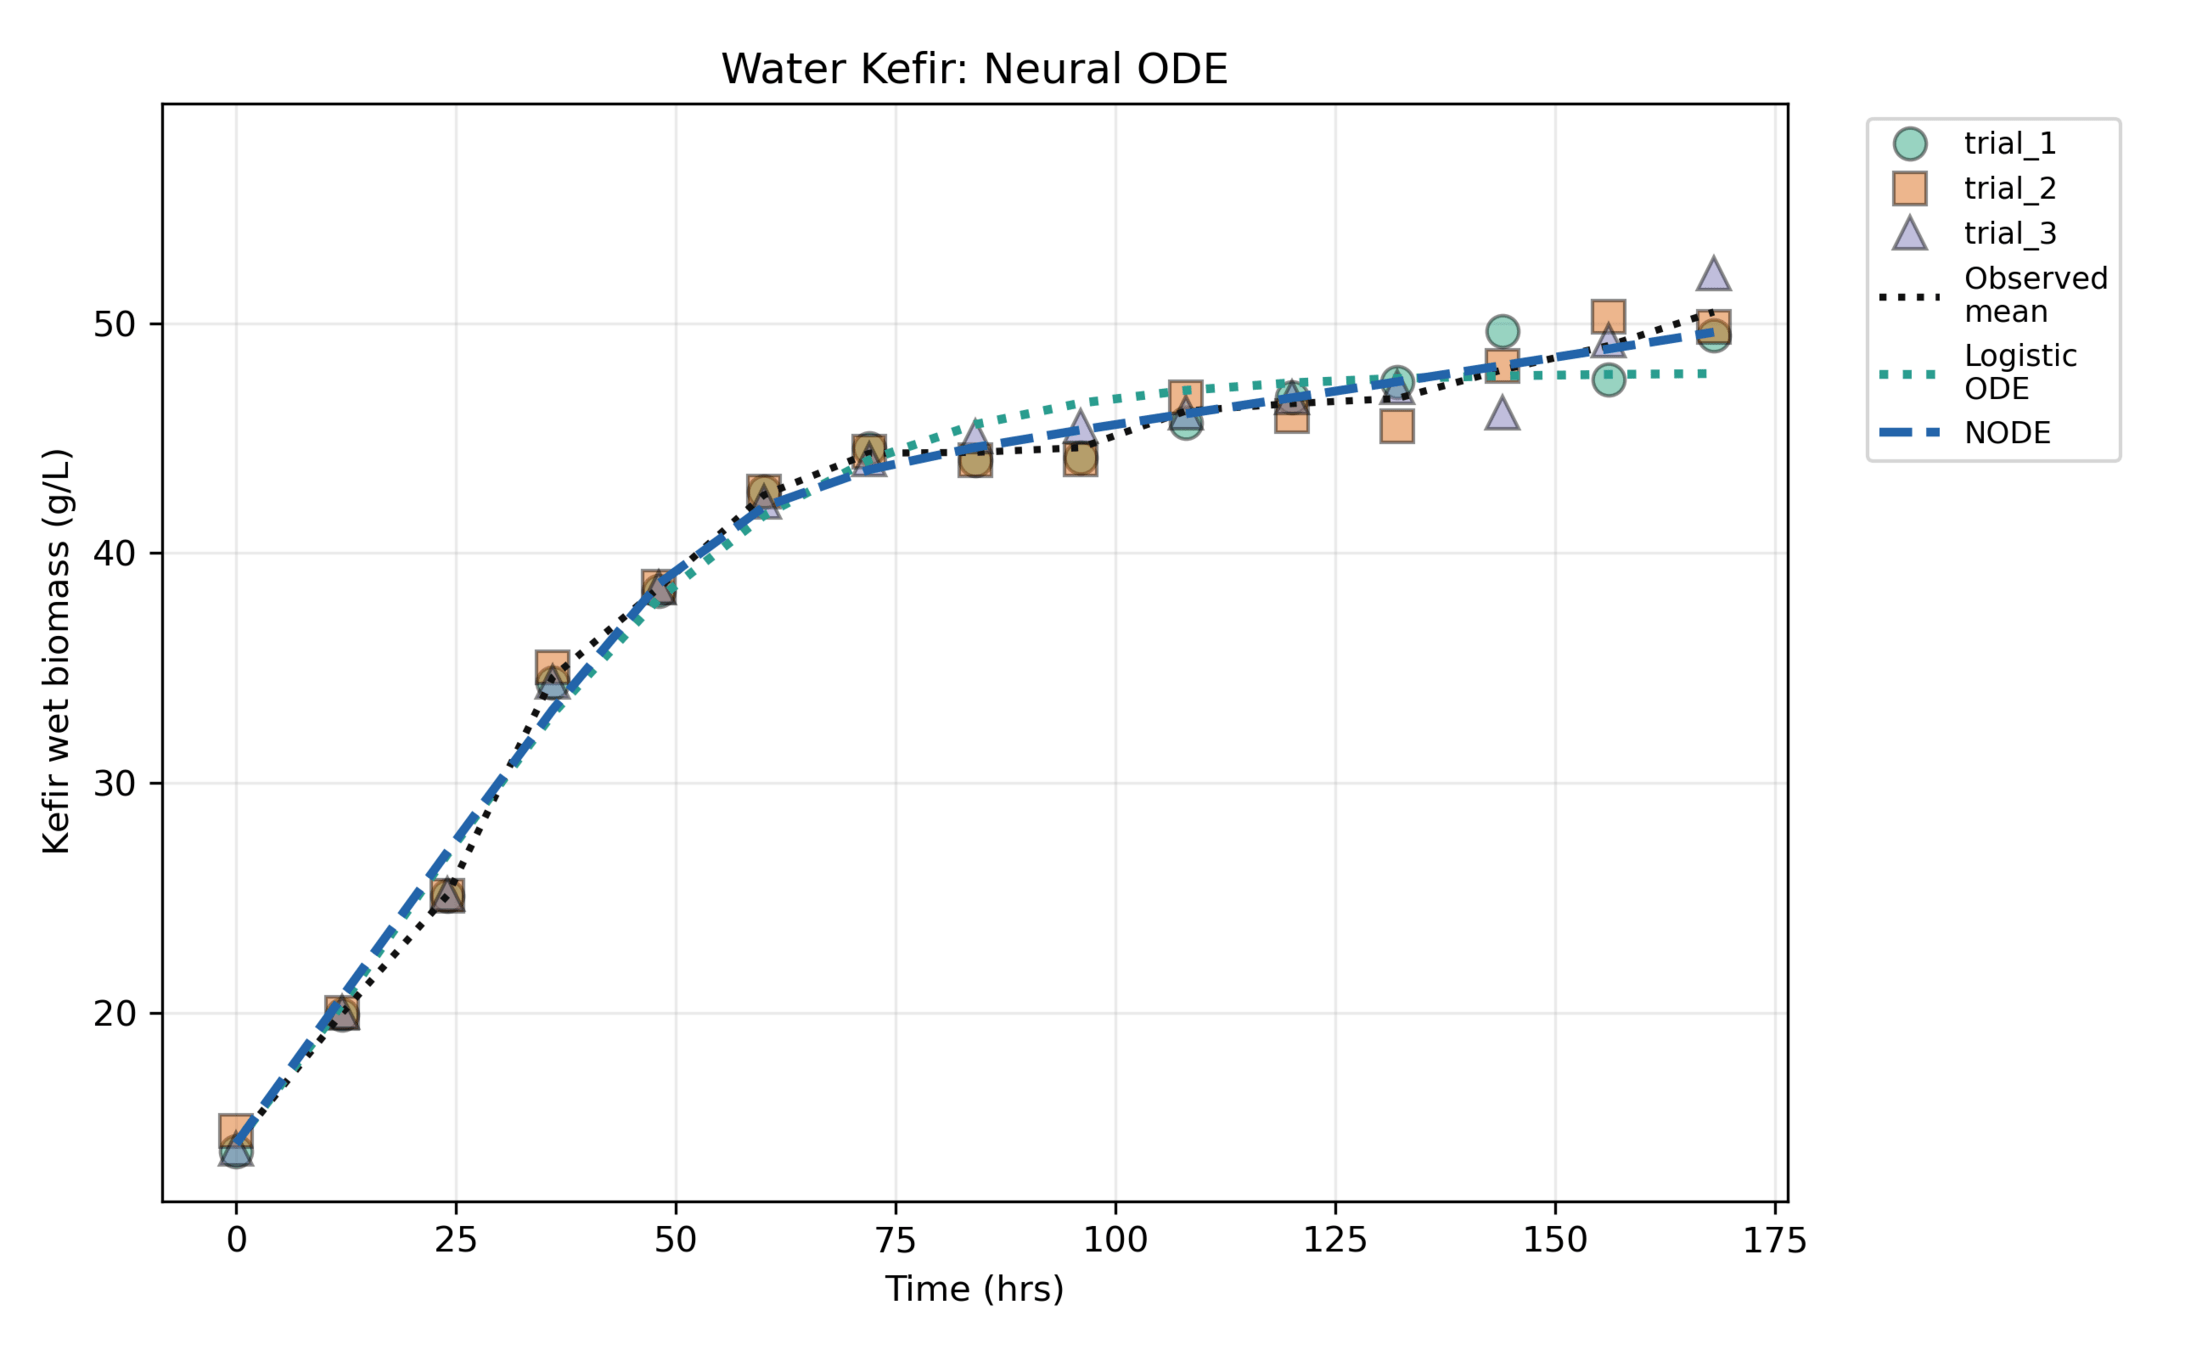
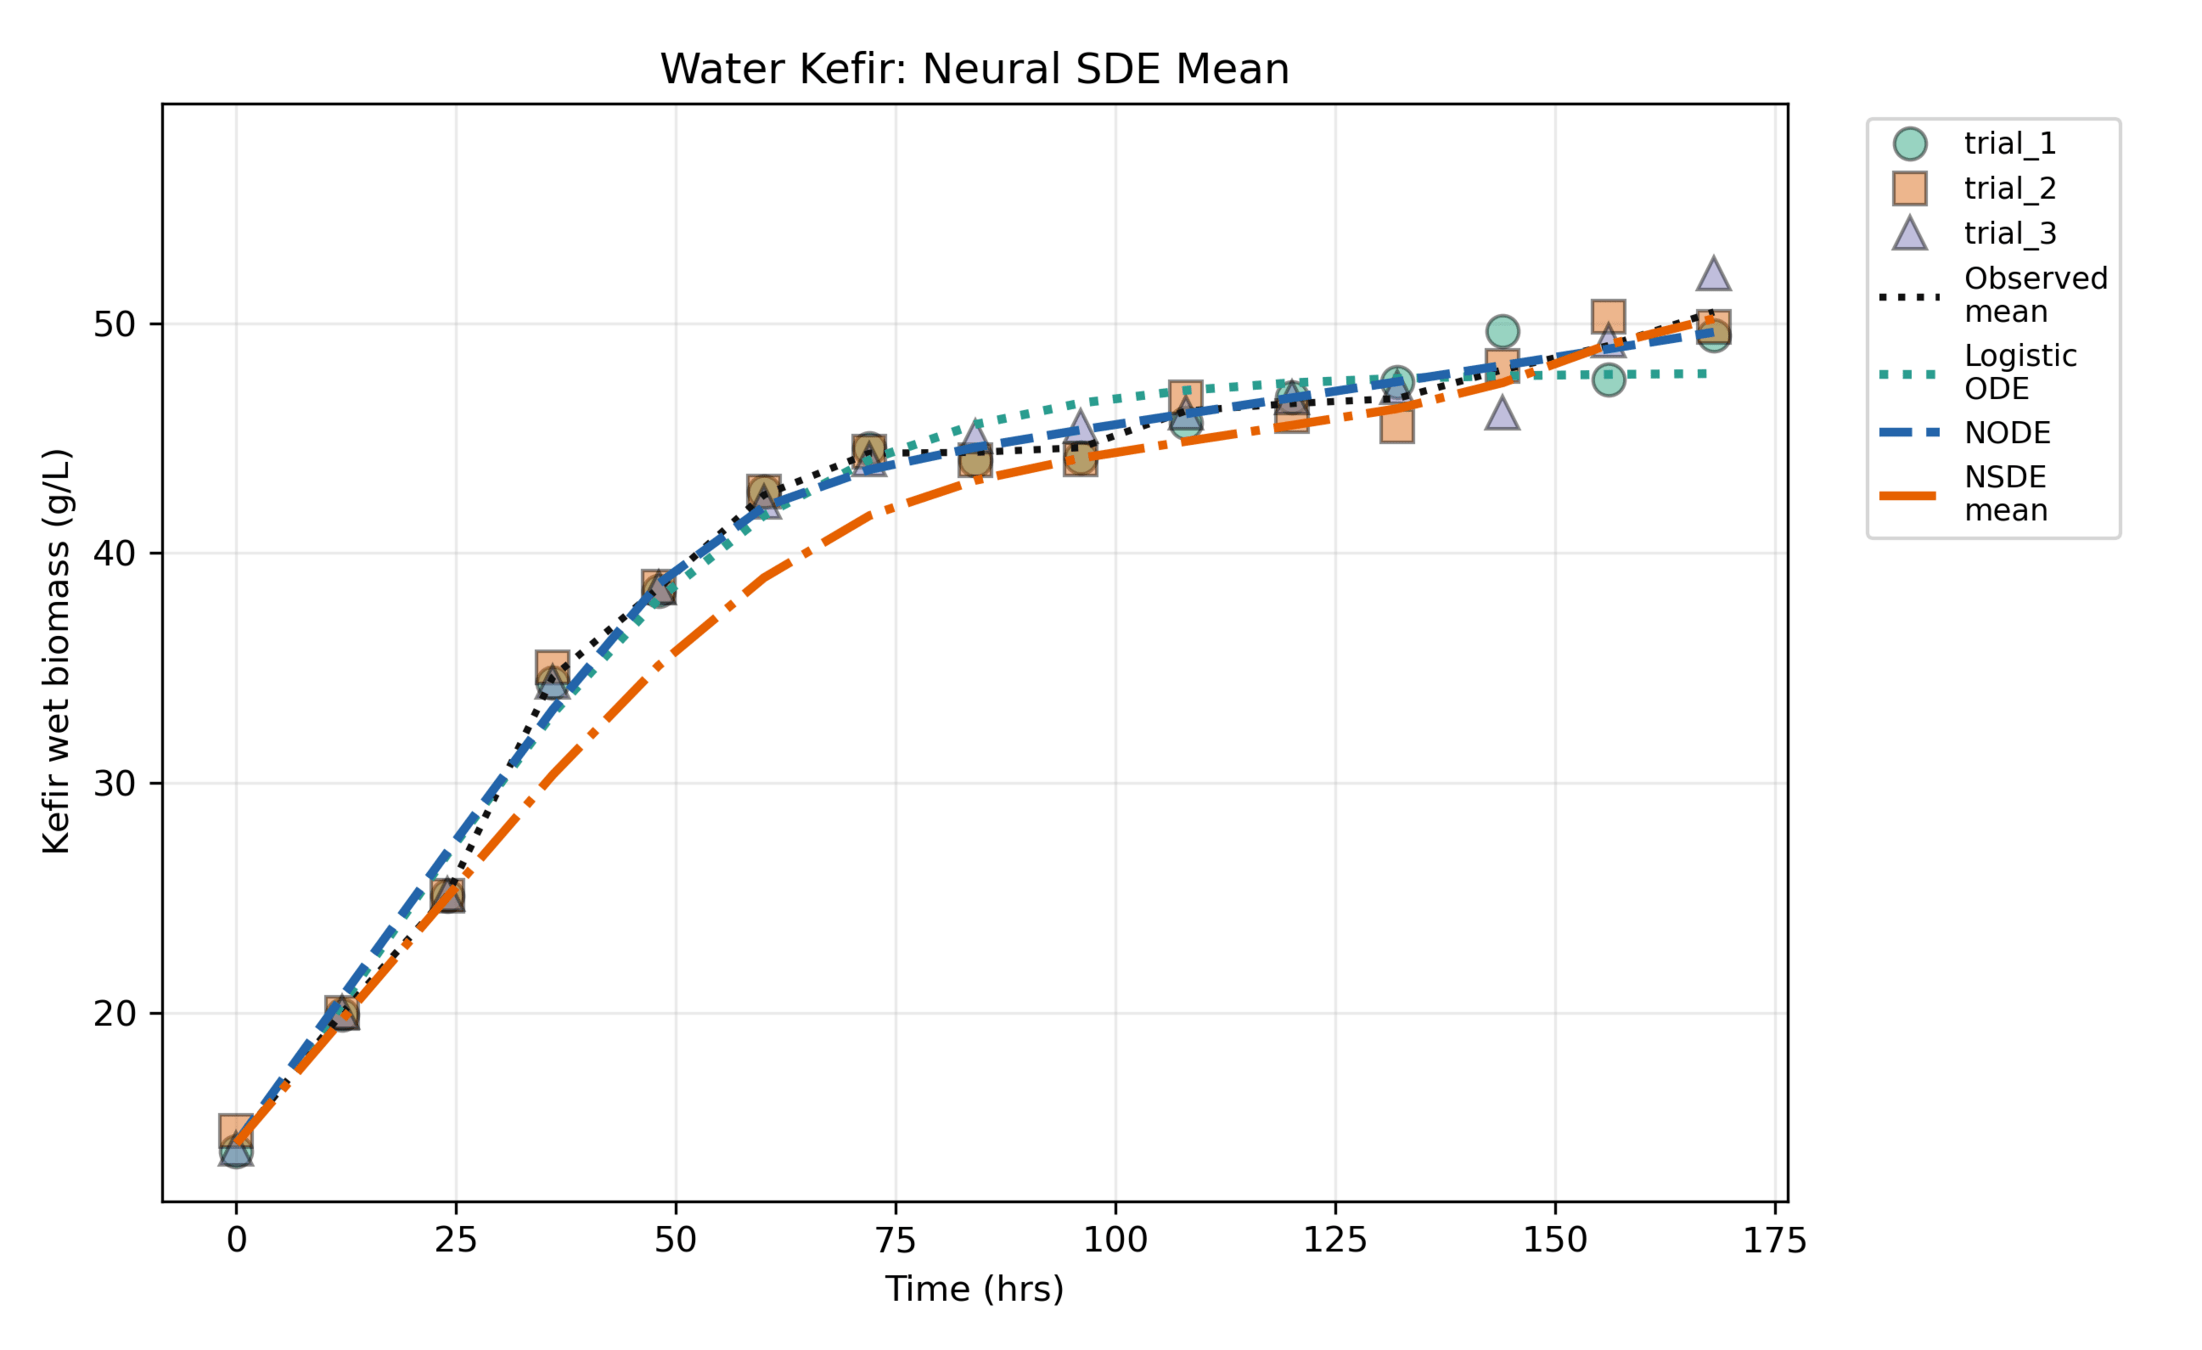
Criterios de evaluación
1.Baltazar-Larios, F., Delgado-Vences, F. & Ornelas, A. Parameter estimation and model selection for stochastic differential equations for biological growth. Environ. Ecol. Stat. 32, 195–227 (2025).
arXiv:2301.08294
2.Baltazar-Larios, F., Delgado-Vences, F., Diaz-Infante, S. & Gomez, E. L. Statistical inference for a stochastic generalized logistic differential equation. Commun. Nonlinear Sci. Numer. Simul. 108261 (2024) doi:10.1016/j.cnsns.2024.108261.
arXiv:2405.03815
3.Baltazar-Larios, F., Delgado-Vences, F. & Diaz-Infante, S. Maximum likelihood estimation for a stochastic SEIR system with a COVID-19 application. Int J Comput Math 1–23 (2022) doi:10.1080/00207160.2022.2148316.
Idea principal del artículo
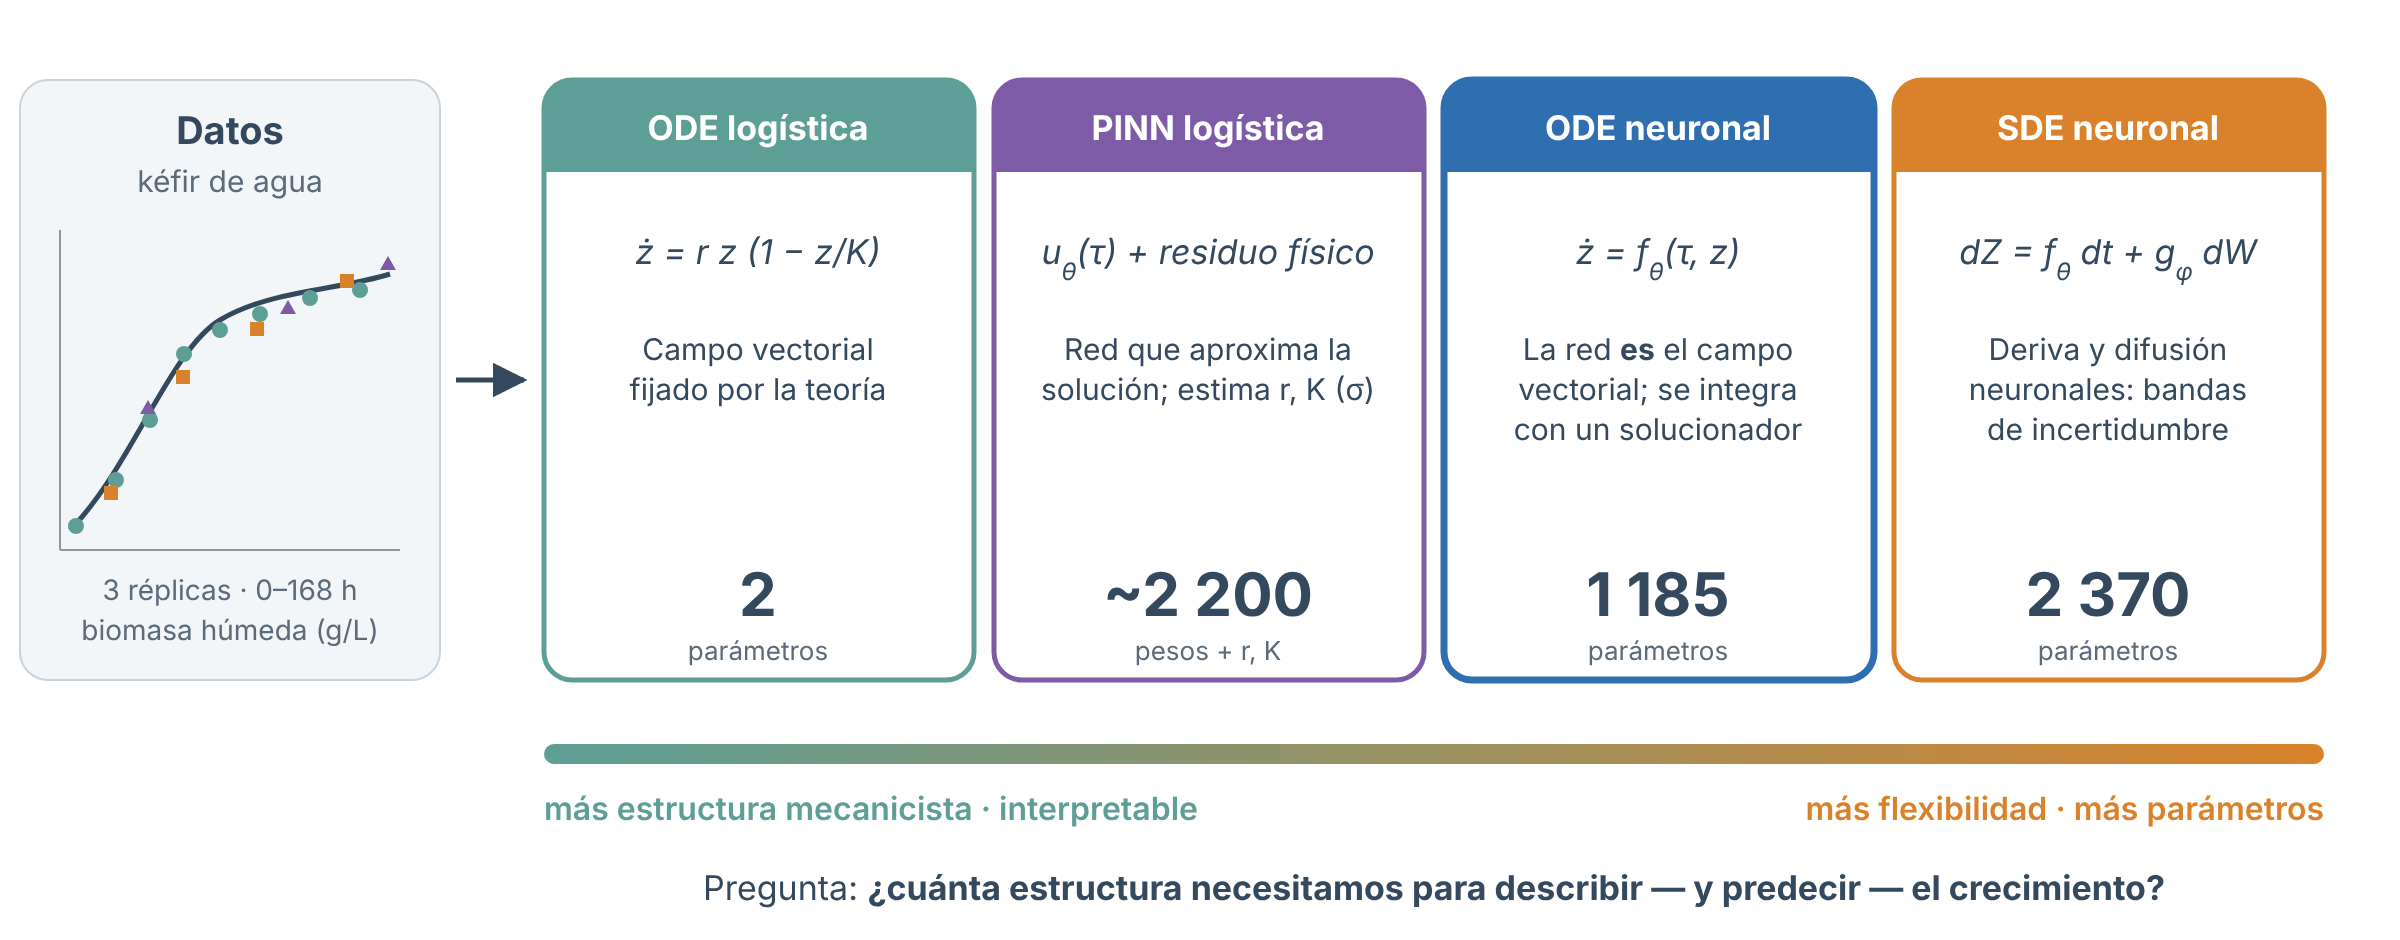
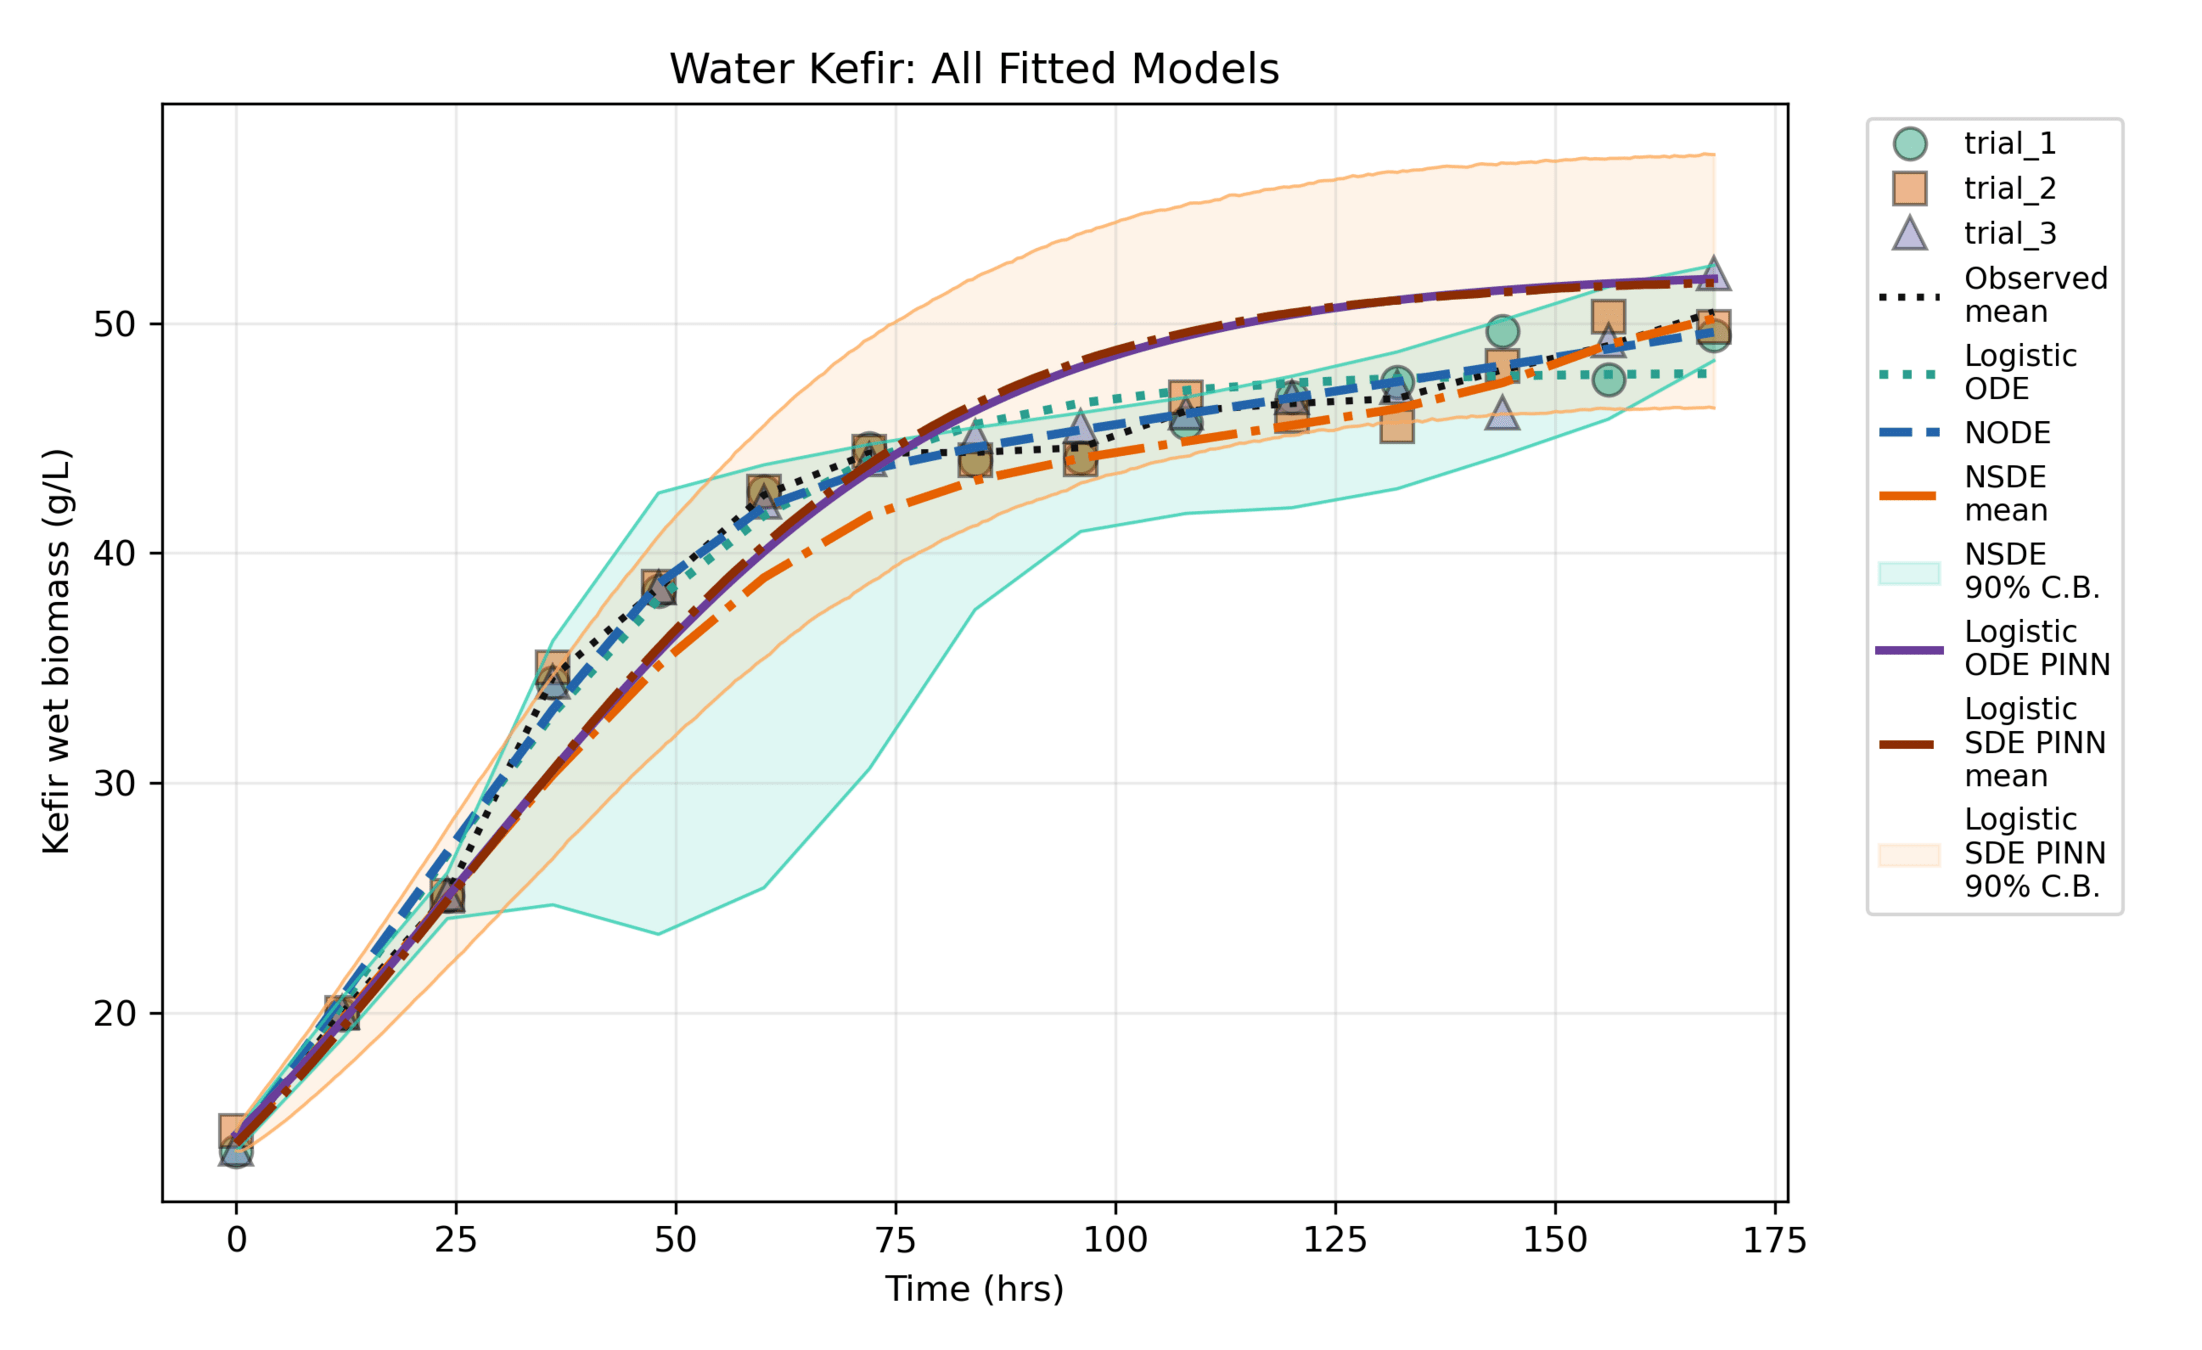
Comparamos cuatro formas de modelar el crecimiento del kéfir de agua —de la ODE logística a las ODE/SDE neuronales— para medir qué se gana y qué se pierde al sustituir la estructura mecanicista por redes neuronales: precisión, parsimonia, incertidumbre e interpretabilidad.
Avance del artículo
✓ Logrado
- Cuatro familias de modelos implementadas y ajustadas a 3 réplicas (repositorio kefir-models).
- ODE neuronal: mejor ajuste en muestra (RMSE 1.03, R² 0.991).
- SDE neuronal: mejor cobertura del intervalo de 90 % (93 %, anchura media 7.4).
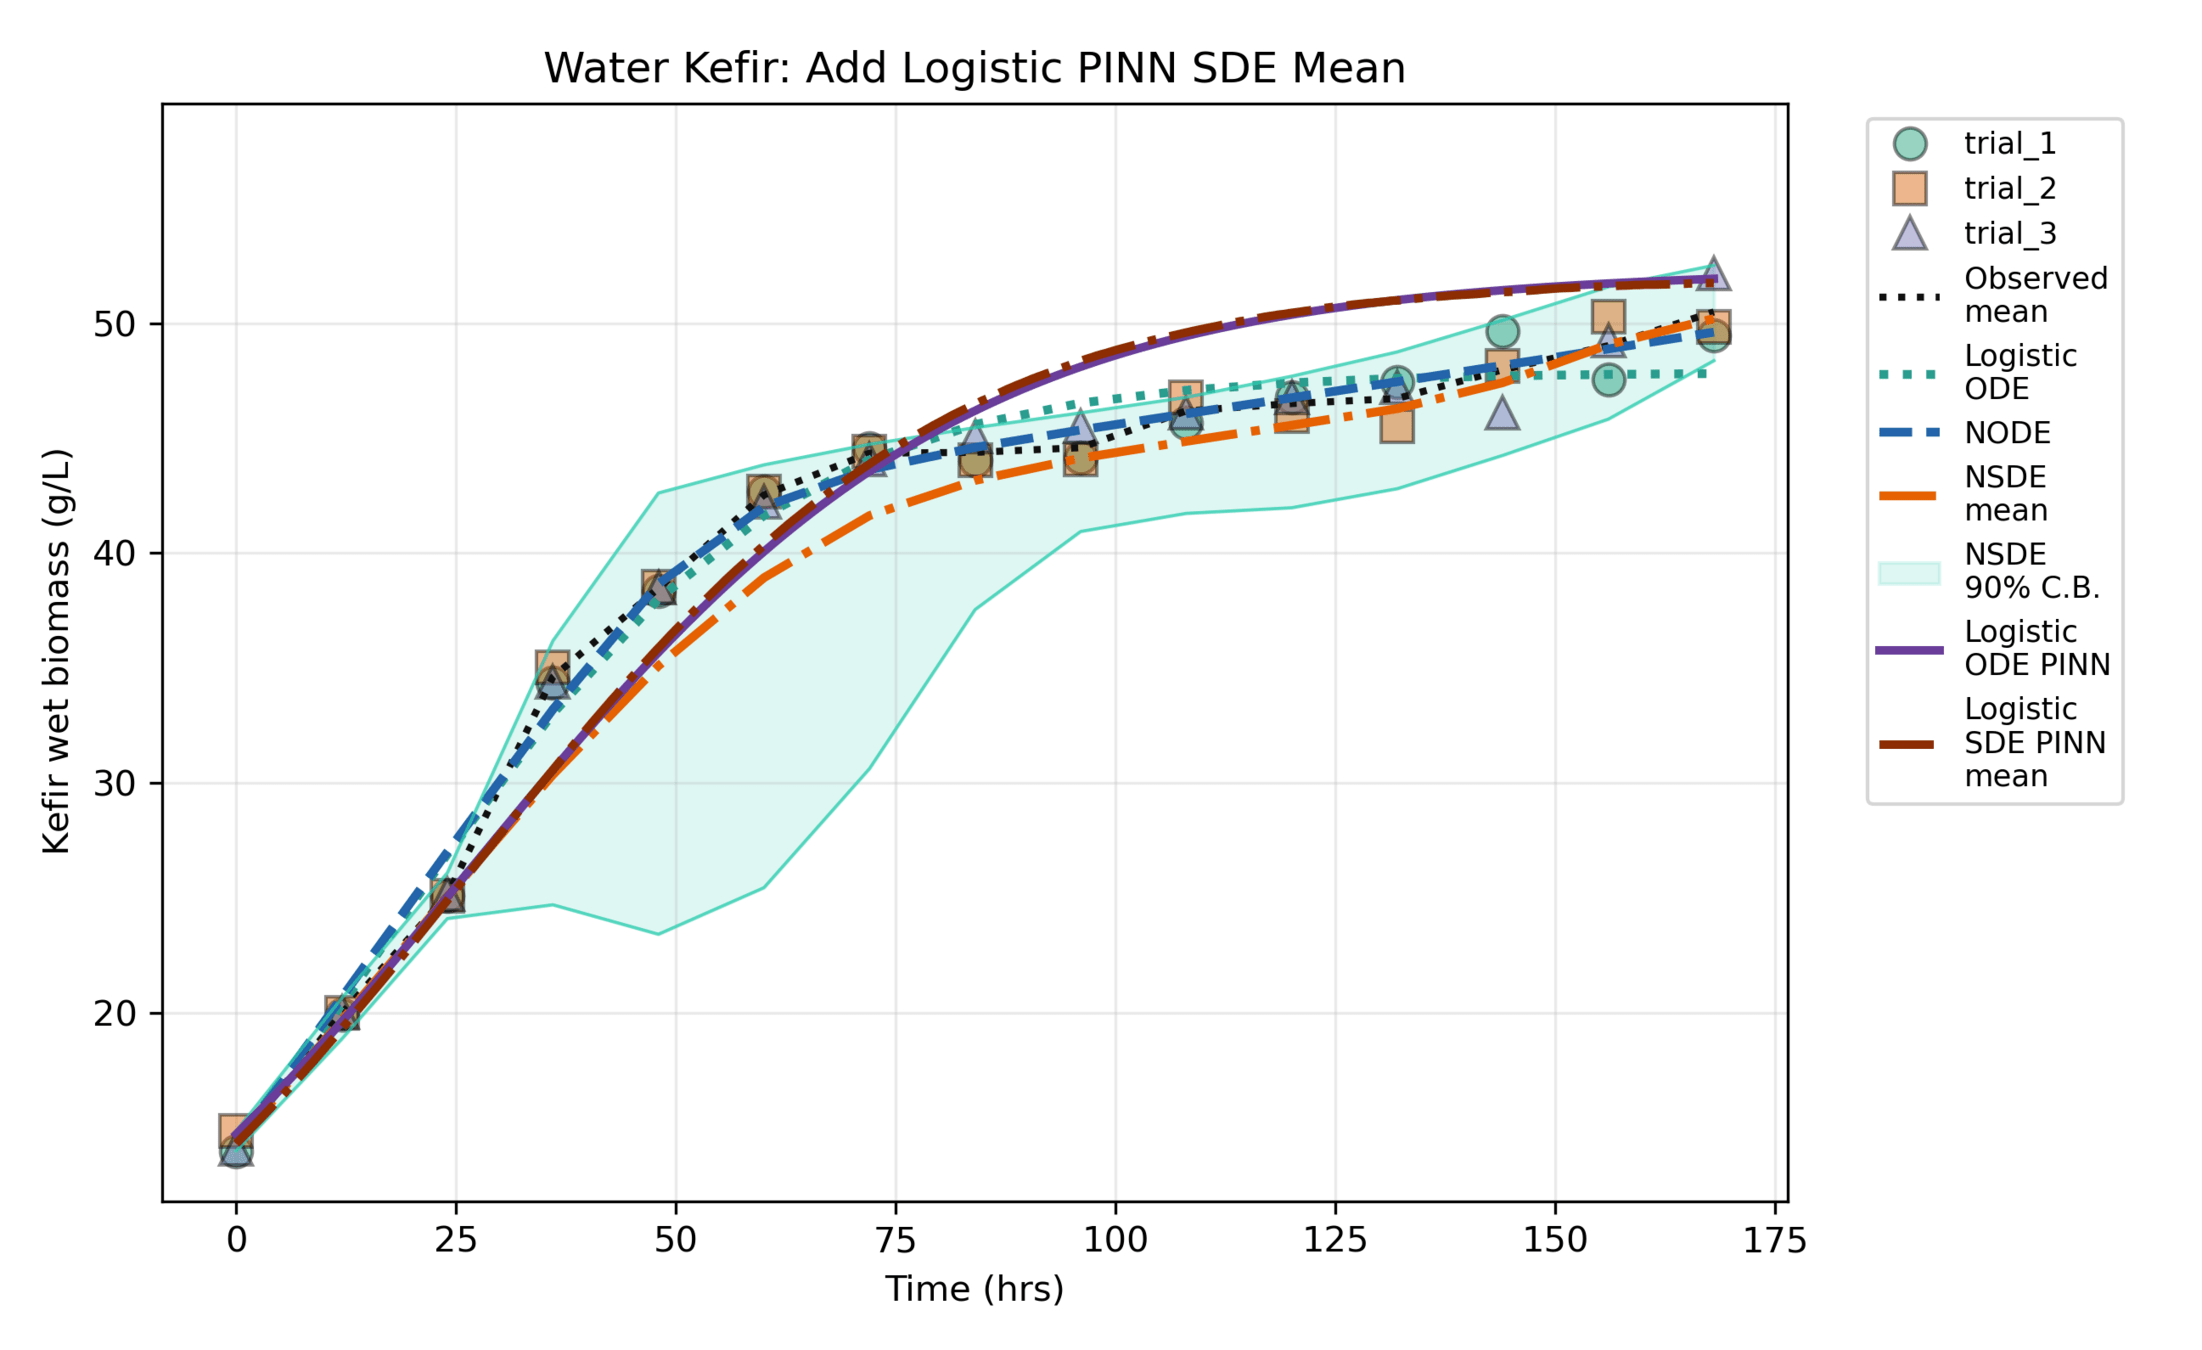
- PINN logística: recupera r ≈ 0.035 h⁻¹ y K ≈ 52.3 g/L; la versión estocástica estima σ ≈ 0.017.
⚠ Limitaciones
- 1 185 parámetros frente a 2: AIC/BIC favorecen la logística (166 vs 2 502).
- Solo 3 réplicas y ~15 tiempos: riesgo de sobreajuste; las métricas son en muestra.
- fθ(τ, z) depende del tiempo: el modelo no es autónomo y no extrapola fuera de 0–168 h.
- Los pesos de la red no tienen interpretación biológica directa.
→ Pendiente
- NODE autónoma y compacta: fθ(z) con 16 neuronas por capa (~320 parámetros).
- Modelo híbrido (UDE): término logístico + corrección neuronal NNφ(z).
- Validación cruzada dejando una réplica fuera; error de predicción fuera de muestra.
- Extender a los tratamientos con ultrasonido: ¿cómo cambian r y K?
Presentación y código
Presentación SMM 2026
Repositorio kefir-models
Declaración de uso de IA
Diligencia, marco 4D de fluidez en IA
Herramientas: Claude Opus 5.5 (Anthropic), Codex con GPT-5.6 Luna (OpenAI) y Gemini 3.5 Flash (desarrollado por Google).
Uso: apoyo en redacción y traducción, edición de fórmulas en LaTeX, diseño de diapositivas y desarrollo del código y figuras del repositorio kefir-models.
Creación: el planteamiento, los modelos, la metodología y las conclusiones son del autor. Todas las derivaciones, resultados y código generados con IA fueron revisados, corregidos y verificados por el autor.
Transparencia: se declara aquí el uso de IA. El código y su historial son públicos en el repositorio para su revisión y reproducción.
Despliegue: el autor asume la responsabilidad total por la exactitud, la integridad y el uso de este material.