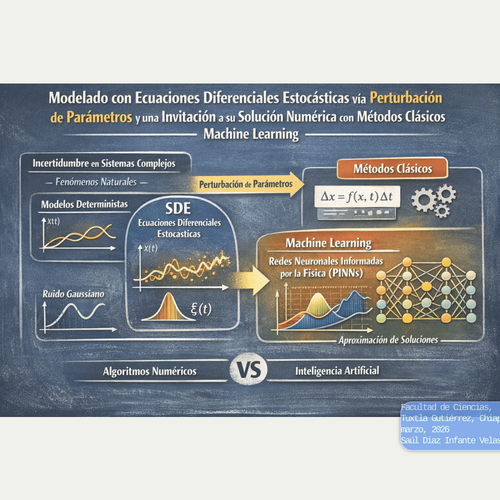
59 CONGRESO NACIONAL DE LA SOCIEDAD MATEMÁTICA MEXICANA
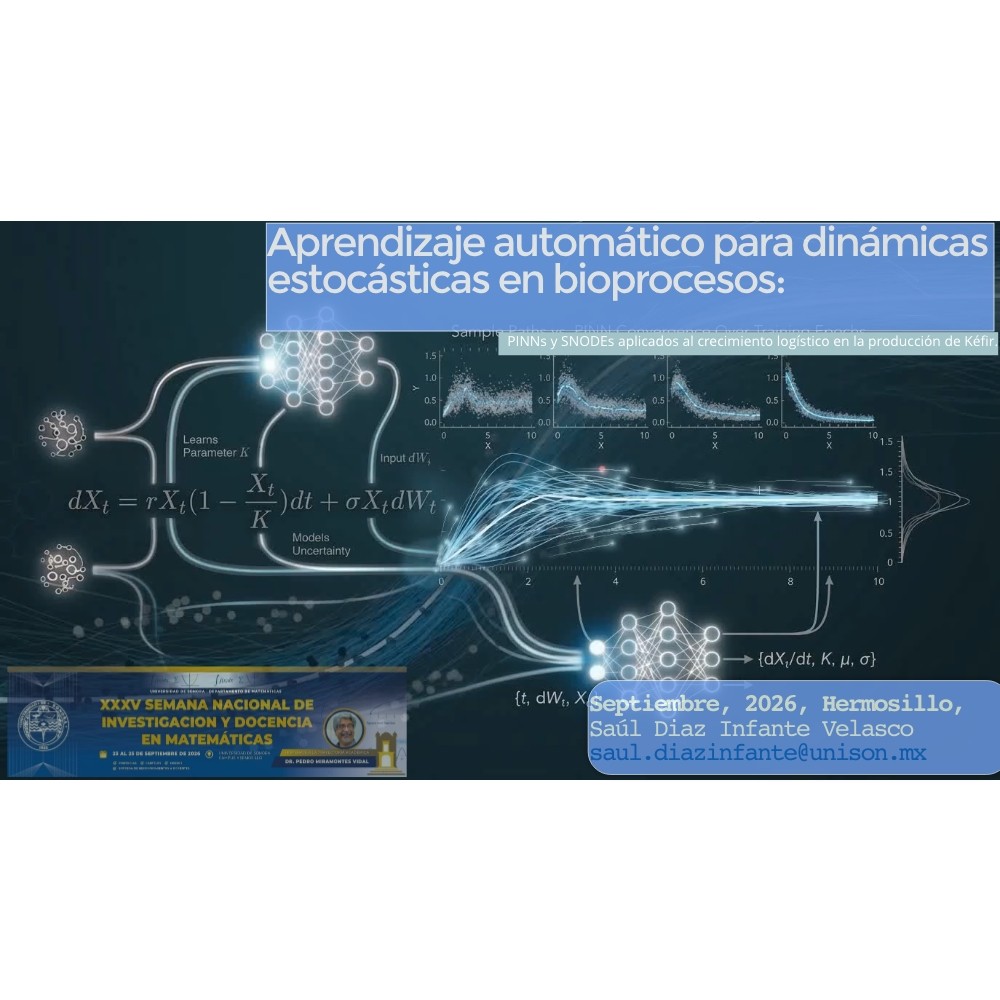
Aprendizaje automático para dinámicas estocásticas en bioprocesos
PINNs y SNODEs aplicados al crecimiento logístico en la producción de kéfir
Saúl Diaz Infante Velasco · saul.diazinfante@unison.mx
Tlaxcala, octubre de 2026
Presentación SMM 2026
Aprendizaje automático para
dinámicas estocásticas
en bioprocesos
Datos, código y resultados
Modelos de crecimiento de kéfir
ODE y SDE neuronales
PINNs y comparación de modelos
Contenido
01
Transición de modelos: de ODE a SDE
02
Métodos numéricos clásicos
03
Aprendizaje automático científico (SciML)
04
ODE y SDE neuronales
Integración de modelos físicos y aprendizaje automático para bioprocesos estocásticos.
05
Aplicación: un caso de bioprocesos
Transición de modelos:
ODE → SDE
Cuantificación de incertidumbre
Incorporar ruido al modelo determinista
\text{ODE}+\text{ruido}=\text{mejor modelo}
Crecimiento poblacional
\text{ODE}+\text{ruido}=\text{mejor modelo}
Crecimiento de una población
\frac{dN}{dt}=a(t)N(t),\qquad N_0=N(0)=\text{cte.}
Crecimiento poblacional
\text{ODE}+\text{ruido}=\text{mejor modelo}
Crecimiento de una población
\frac{dN}{dt}=a(t)N(t),\qquad N_0=N(0)=\text{cte.}
a(t)=r(t)+\text{ruido}
De una ODE a una SDE
Ejemplo
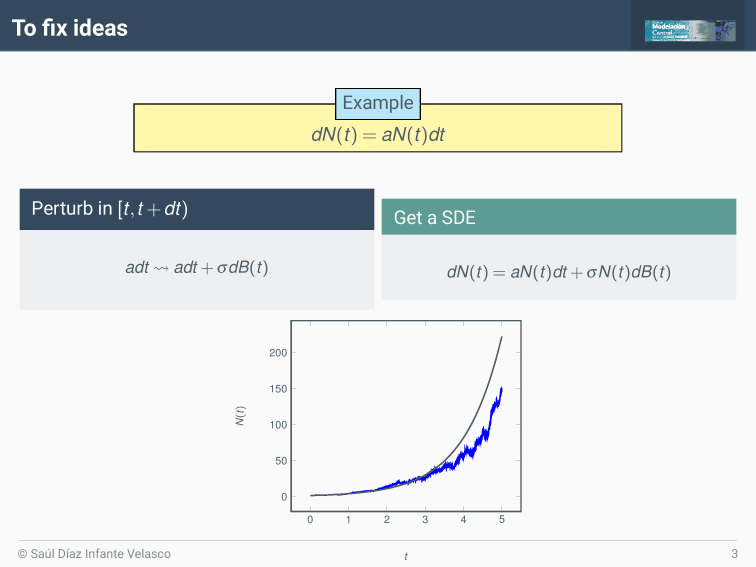
dN(t)=aN(t)\,dt
De una ODE a una SDE
Ejemplo
dN(t)=aN(t)\,dt
Perturbamos la tasa en un intervalo corto
[t,t+dt)
De una ODE a una SDE
Ejemplo
dN(t)=aN(t)\,dt
Perturbamos la tasa en un intervalo corto
[t,t+dt)
a\,dt\rightsquigarrow a\,dt+\sigma\,dB(t)
De una ODE a una SDE
Ejemplo
dN(t)=aN(t)\,dt
Perturbamos la tasa en un intervalo corto
[t,t+dt)
a\,dt\rightsquigarrow a\,dt+\sigma\,dB(t)
dN(t)=aN(t)\,dt+\sigma N(t)\,dB(t)
De una ODE a una SDE
dN(t)=aN(t)\,dt
Perturbamos la tasa
a\,dt\rightsquigarrow a\,dt+\sigma\,dB(t)
Obtenemos una SDE
dN(t)=aN(t)\,dt+\sigma N(t)\,dB(t)
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Henston
dS_t=\mu S_t\,dt+\sqrt{V_t}S_t\bigl(\sqrt{1-\rho^2}\,dW_t^{(1)}+\rho\,dW^{(2)}\bigr)
dV_t=\kappa(\lambda-V_t)\,dt+\theta\sqrt{V_t}\,dW_t^{(2)}
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Langevin
dX_t=-(\nabla U)(X_t)\,dt+\sqrt{2\varepsilon}\,dW_t
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Brusselator
dX_t=\bigl[\delta-(\alpha+1)X_t+Y_tX_t^2\bigr]\,dt+g_1(X_t)\,dW_t^{(1)}
dY_t=\bigl[\alpha X_t+Y_tX_t^2\bigr]\,dt+g_2(X_t)\,dW_t^{(2)}
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
Lotka–Volterra
dX_t=(\lambda X_t-kX_tY_t)\,dt+\sigma X_t\,dW_t
dY_t=(kX_tY_t-mY_t)\,dt
Hutzenthaler, M. and Jentzen, A. (2015).
Numerical approximations of stochastic differential equations with
non-globally Lipschitz continuous coefficients.
Memoirs of the American Mathematical Society, 236(1112).
arXiv:1203.5809
Aplicaciones de las SDE
Finanzas
Física
Química
Biología
Epidemiología
SIR
dS_t=(-\alpha S_tI_t-\delta S_t+\delta)\,dt-\beta S_tI_t\,dW_t
dI_t=(\alpha S_tI_t-(\gamma+\delta)I_t)\,dt+\beta S_tI_t\,dW_t
dR_t=(\gamma I_t-\delta R_t)\,dt
Dos enfoques principales
Objetivo principal
Presentar dos enfoques habituales para el
modelado estocástico mediante SDE.
Enfoque de Allen
Perturbación estocástica
\mathrm{DTMC}\to\mathrm{CTMC}\to\mathrm{SDE}
\frac{dN(t)}{dt}=aN(t)
a\,dt\rightsquigarrow a\,dt+\sigma\,dB(t)
dN(t)=aN(t)\,dt+\sigma N(t)\,dB(t)
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
\mathrm{DTMC}+\mathrm{CTMC}+\mathrm{ME}\to\mathrm{SDE}
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
\phi\,dt\rightsquigarrow\phi\,dt+\sigma\,dB_t
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
\phi\,dt\rightsquigarrow\phi\,dt+F(x)\,dB_t
Alternativas
En biología
DTMC, CTMC
Perturbación estocástica
de parámetros
Procesos de reversión
a la media
d\phi_t=(\phi_e-\phi_t)\,dt+\sigma_{\phi}\,dB_t
Aproximaciones numéricas de SDE
Notación: deriva y difusión
dx(t)=\underbrace{f(x(t),t)\,dt}_{\text{deriva}}+\underbrace{g(x(t),t)\,dB(t)}_{\text{difusión}}
Notación: deriva y difusión
dx(t)=\underbrace{f(x(t),t)\,dt}_{\text{deriva}}+\underbrace{g(x(t),t)\,dB(t)}_{\text{difusión}}
x(0)=x_0,\qquad t\in[0,T]
Notación integral de una SDE
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
f:\mathbb R^d\times[0,T]\to\mathbb R^d,\qquad g:\mathbb R^d\times[0,T]\to\mathbb R^{d\times m}
B(t)=(B_1(t),\ldots,B_m(t))^\top,\qquad (\Omega,\mathcal F,\{\mathcal F_t\}_{t\ge0},\mathbb P)
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
Una malla temporal
t_n=nh,\qquad n=0,\ldots,N,\qquad T=Nh
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
Una malla temporal
t_n=nh,\qquad n=0,\ldots,N,\qquad T=Nh
x(t_{n+1})=x(t_n)+\int_{t_n}^{t_{n+1}} f(x(s),s)\,ds+\int_{t_n}^{t_{n+1}} g(x(s),s)\,dB(s)
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
Una malla temporal
t_n=nh,\qquad n=0,\ldots,N,\qquad T=Nh
x(t_{n+1})=x(t_n)+\underbrace{\int_{t_n}^{t_{n+1}} f(x(s),s)\,ds}_{\text{aprox. determinista}}+\int_{t_n}^{t_{n+1}} g(x(s),s)\,dB(s)
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
Una malla temporal
t_n=nh,\qquad n=0,\ldots,N,\qquad T=Nh
x(t_{n+1})=x(t_n)+\underbrace{\int_{t_n}^{t_{n+1}} f(x(s),s)\,ds}_{\text{aprox. determinista}}+\int_{t_n}^{t_{n+1}} g(x(s),s)\,dB(s)
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
Una malla temporal
t_n=nh,\qquad n=0,\ldots,N,\qquad T=Nh
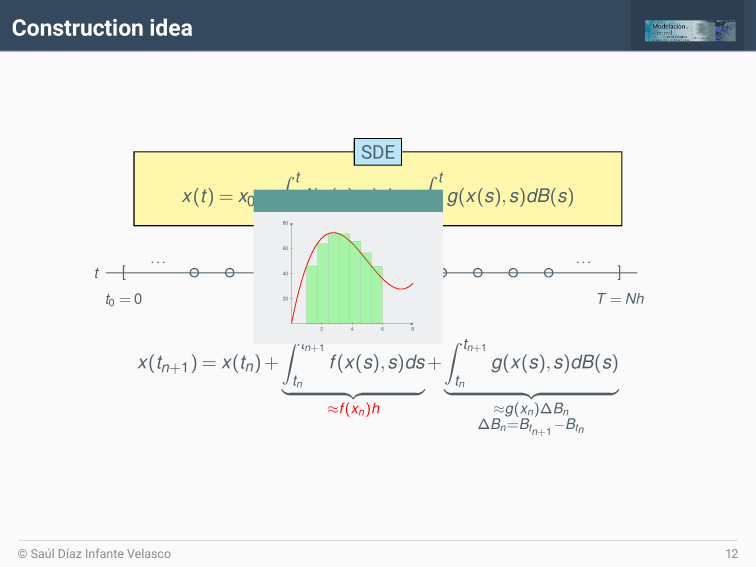
x(t_{n+1})=x(t_n)+\underbrace{\int_{t_n}^{t_{n+1}} f(x(s),s)\,ds}_{\approx f(X_n)h}+\underbrace{\int_{t_n}^{t_{n+1}} g(x(s),s)\,dB(s)}_{\approx g(X_n)\Delta B_n}
\Delta B_n=B(t_{n+1})-B(t_n)
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
t_n=nh,\quad T=Nh,\quad X_0=x_0,\quad X_n\approx x(t_n)
x(t_{n+1})=x(t_n)+\underbrace{\int_{t_n}^{t_{n+1}} f(x(s),s)\,ds}_{\approx f(X_n)h}+\underbrace{\int_{t_n}^{t_{n+1}} g(x(s),s)\,dB(s)}_{\approx g(X_n)\Delta B_n}
\Delta B_n=B(t_{n+1})-B(t_n)
X_{n+1}=X_n+f(X_n)h+g(X_n)\Delta B_n
Construcción de Euler–Maruyama
x(t)=x_0+\int_0^t f(x(s),s)\,ds+\int_0^t g(x(s),s)\,dB(s)
t_n=nh,\quad T=Nh,\quad X_0=x_0,\quad X_n\approx x(t_n)
x(t_{n+1})=x(t_n)+\underbrace{\int_{t_n}^{t_{n+1}} f(x(s),s)\,ds}_{\approx f(X_n)h}+\underbrace{\int_{t_n}^{t_{n+1}} g(x(s),s)\,dB(s)}_{\approx g(X_n)\Delta B_n}
\Delta B_n=B(t_{n+1})-B(t_n)
X_{n+1}=X_n+f(X_n)h+\underbrace{g(X_n)\Delta B_n}_{\text{incremento aleatorio}}
[Sec. 1.2, Teo. 1.2.2]
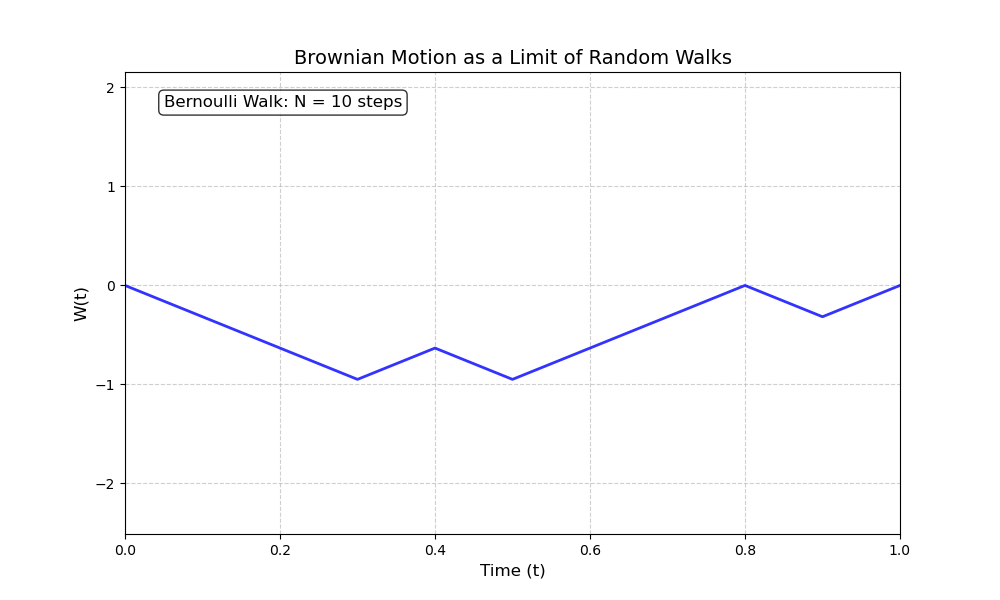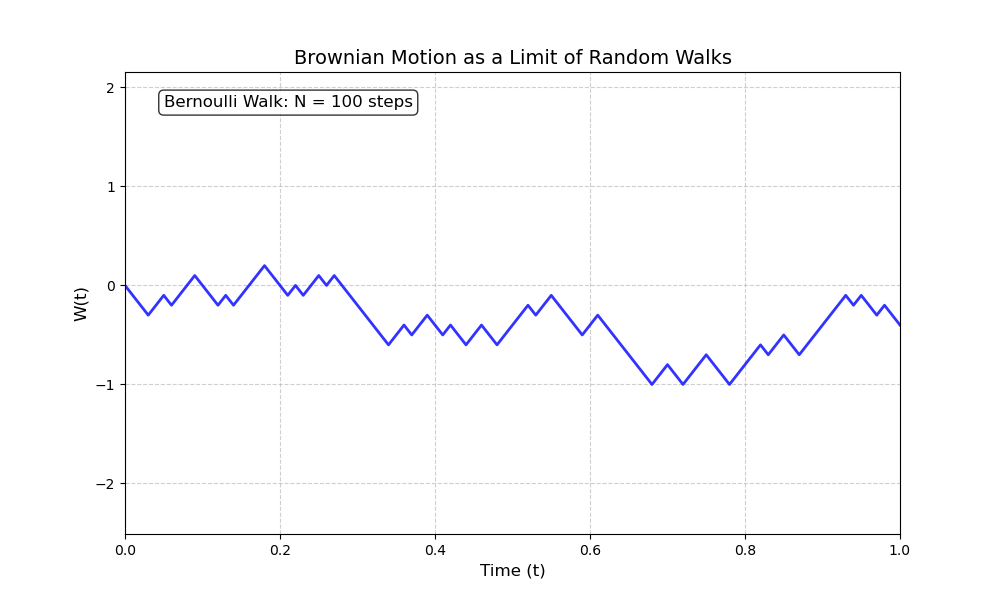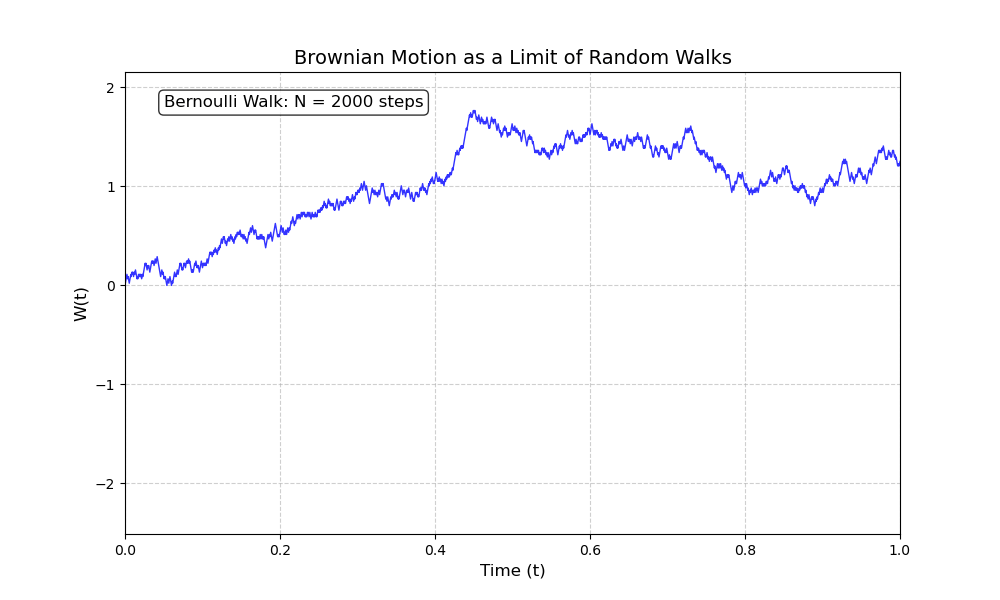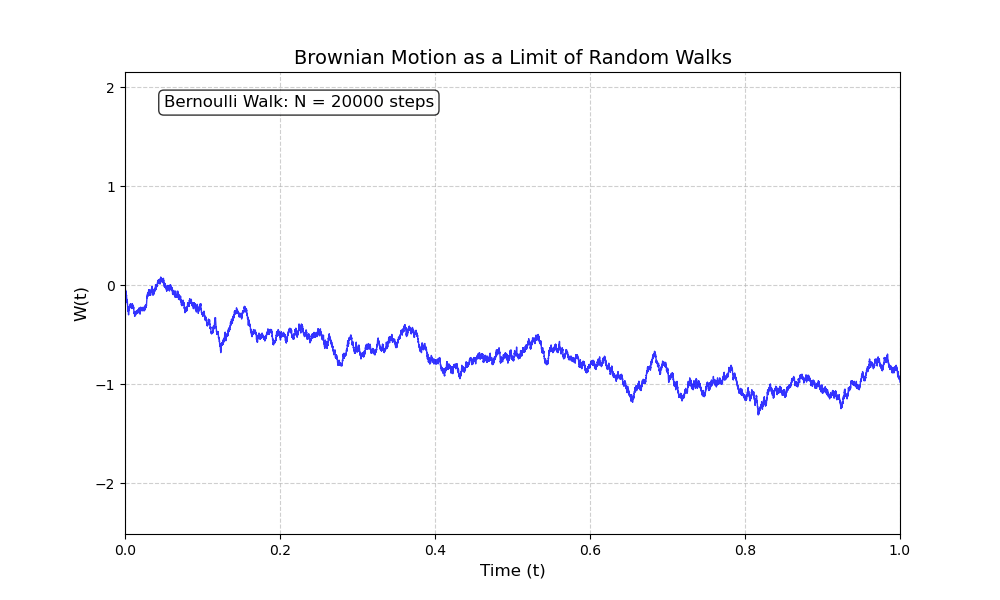
Movimiento browniano discreto
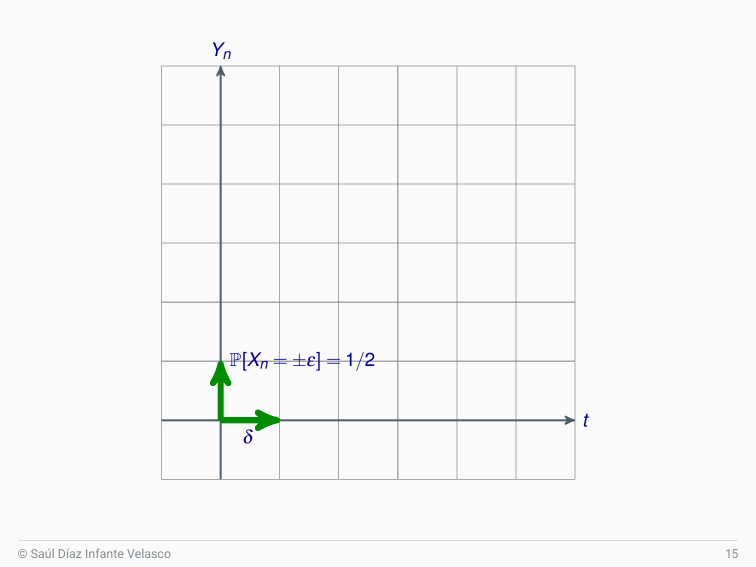
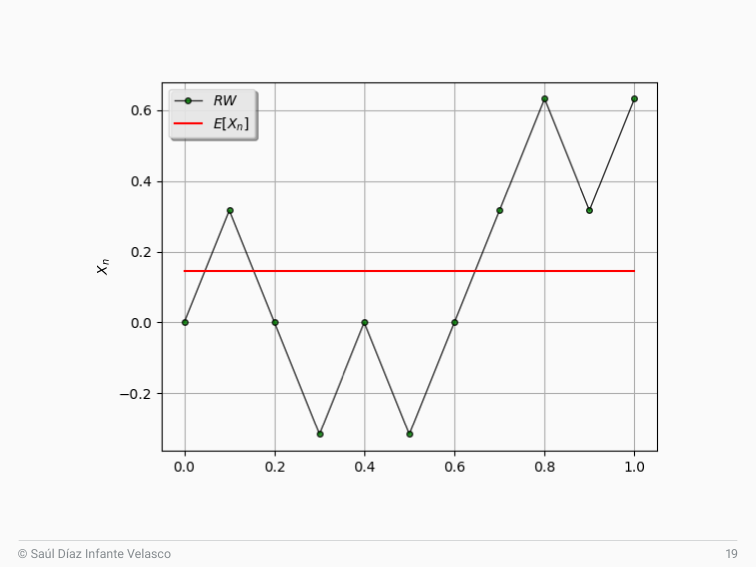
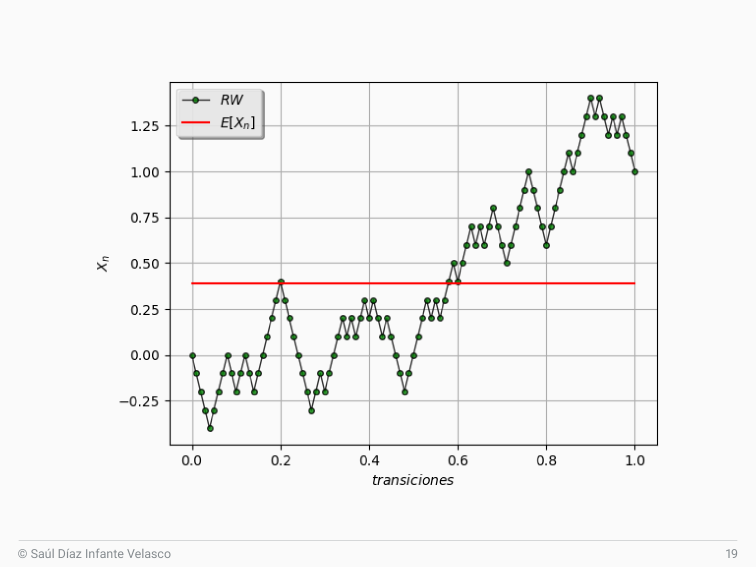
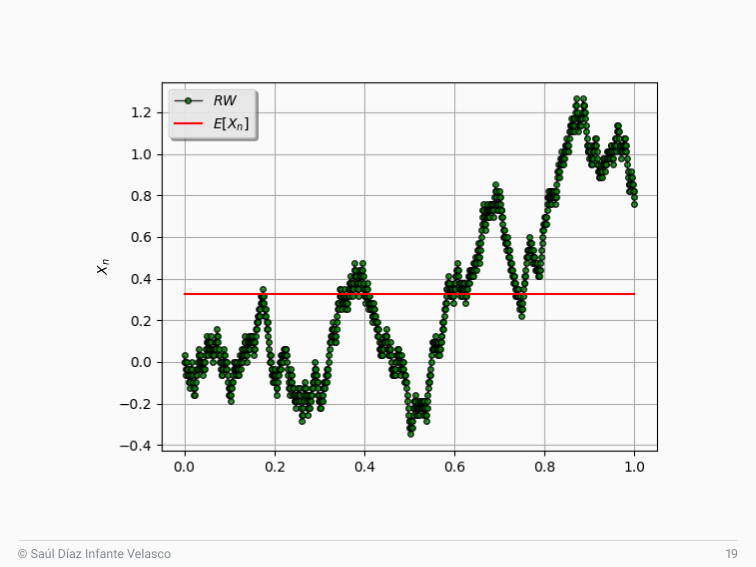
Construcción del movimiento browniano
Teorema
Sea Y una caminata aleatoria que parte de 0,
con saltos equiprobables de signos opuestos en los tiempos
\text{saltos }\varepsilon,-\varepsilon,\quad\text{tiempos }\delta,2\delta,3\delta,\ldots,\quad\varepsilon^2=\delta.
Para cada t ≥ 0, el límite existe en distribución:
B(t)=\lim_{\delta\to0}Y_{\delta,\sqrt{\delta}}(t)
\mathbb E\!\left[e^{i\lambda B(t)}\right]=e^{-\frac12t\lambda^2},\qquad\lambda\in\mathbb R.
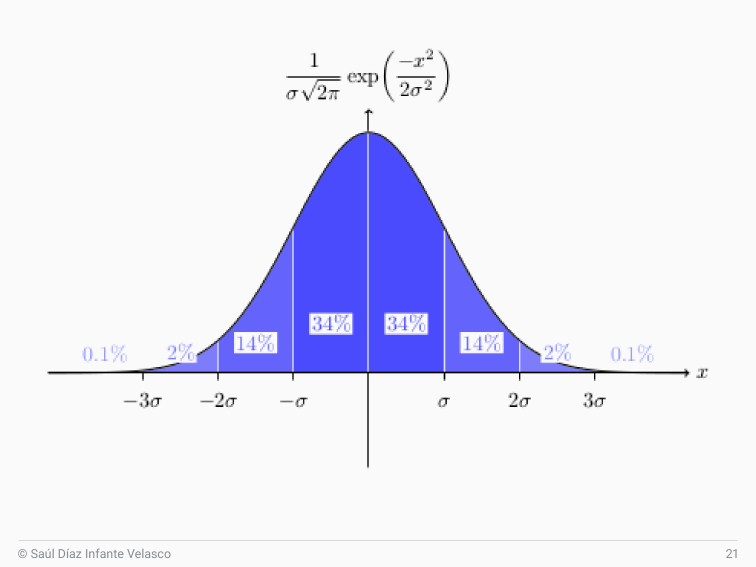
Distribución normal
\frac{1}{\sigma\sqrt{2\pi}}\exp\!\left(\frac{-x^2}{2\sigma^2}\right)
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
\text{(i)}\quad B(0)=0\quad\text{c.s.}
\text{(ii)}\quad 0\le s\le t,\quad B(t)-B(s)\sim\sqrt{t-s}\,\mathcal N(0,1).
(iii) Para cada partición, las variables aleatorias
t_0\le t_1\le\cdots\le t_n\in[0,T],\qquad B(t_i)-B(t_j)\text{ son independientes.}
Dado t en [0,T], tomamos una malla:
0=t_0\le t_1\le\cdots\le t_{M-1}\le t_M=t
B(t)=\sum_{j=1}^{M}\bigl(B(t_j)-B(t_{j-1})\bigr).
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
\text{(i)}\quad B(0)=0\quad\text{c.s.}
\text{(ii)}\quad 0\le s\le t,\quad B(t)-B(s)\sim\sqrt{t-s}\,\mathcal N(0,1).
(iii) Para cada partición, las variables aleatorias
t_0\le t_1\le\cdots\le t_n\in[0,T],\qquad B(t_i)-B(t_j)\text{ son independientes.}
Dado t en [0,T], tomamos una malla:
0=t_0\le t_1\le\cdots\le t_{M-1}\le t_M=t
B(t)=\sum_{j=1}^{M}\underbrace{\bigl(B(t_j)-B(t_{j-1})\bigr)}_{:=\Delta B_j}.
Aproximación fuerte
Definición
El movimiento browniano B es el único proceso que satisface:
\text{(i)}\quad B(0)=0\quad\text{c.s.}
\text{(ii)}\quad 0\le s\le t,\quad B(t)-B(s)\sim\sqrt{t-s}\,\mathcal N(0,1).
(iii) Para cada partición, las variables aleatorias
t_0\le t_1\le\cdots\le t_n\in[0,T],\qquad B(t_i)-B(t_j)\text{ son independientes.}
\{t_n\}_{n=0}^{N},\qquad t_n=nh,
B(t_n)\approx\sum_{j=0}^{n}\Delta B_j,\qquad\Delta B_0:=0,
\Delta B_j\sim\sqrt h\,\mathcal N(0,1).
Aproximación débil y fuerte
Problema dado
dx(t)=f(x(t))\,dt+g(x(t))\,dB(t),
x(0)=x_0,\qquad t\in[0,T]
Débil
Fuerte
X_{n+1}=X_n+f(X_n)h+g(X_n)\Delta B_n
X_{n+1}=X_n+f(X_n)h+g(X_n)\Delta B_n
\Delta B_n\approx\sqrt h\,\varepsilon_n,
\Delta B_n\approx\sqrt h\,\varepsilon_n,
\mathbb P[\varepsilon_n=\pm1]=1/2
\varepsilon_n\sim\mathcal N(0,1)
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Método theta de Euler–Maruyama
Y_{k+1}=Y_k+h(1-\theta)f(Y_k)+\theta f(Y_{k+1})+g(Y_k)\Delta W_k,
\theta\in[0,1].
Xuerong Mao and Lukasz Szpruch.
Strong convergence and stability of implicit numerical
methods for stochastic differential equations with
non-globally lipschitz continuous coefficients.
Journal of Computational and Applied Mathematics,
238:14–28, January 2013.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama hacia adelante y atrás
Y_k=Y_{k-1}+h(1-\theta)f(Y_{k-1})+\theta f(Y_k)+g(Y_{k-1})\Delta W_{k-1}
\widehat Y_{k+1}=\widehat Y_k+hf(Y_k)+g(Y_k)\Delta W_k,\qquad\theta\in[0,1].
Xuerong Mao and Lukasz Szpruch.
Strong convergence and stability of implicit numerical
methods for stochastic differential equations with
non-globally lipschitz continuous coefficients.
Journal of Computational and Applied Mathematics,
238:14–28, January 2013.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama atenuado
Y_{k+1}=Y_k+\frac{hf(Y_k)}{1+h\lVert f(Y_k)\rVert}+g(Y_k)\Delta W_k
Martin Hutzenthaler, Arnulf Jentzen, and Peter E. Kloeden.
Strong convergence of an explicit numerical method
for sdes with nonglobally lipschitz continuous coefficients.
The Annals of Applied Probability,
22(4):1611–1641, August 2012.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama truncado
Y_{k+1}=Y_k+f_\Delta(Y_k)h+g_\Delta(Y_k)\Delta_k,
f_\Delta(x):=\left(|x|\wedge\mu^{-1}(h(\Delta))\frac{x}{|x|}\right),
g_\Delta(x):=\left(|x|\wedge\mu^{-1}(h(\Delta))\frac{x}{|x|}\right)
Xuerong Mao.
The truncated euler-maruyama method for stochastic
differential equations.
Journal of Computational and Applied Mathematics,
290:370–384, 2015.
Esquemas numéricos representativos
Implícitos
theta-BEM
FBEM
Explícitos
EM atenuado
EM truncado
Sabanis
Euler–Maruyama con coeficientes variables
Y_{k+1}=Y_k+\frac{hf(Y_k)+g(Y_k)\Delta W_k}{1+k^{-\alpha}(\lVert f(Y_k)\rVert+\lVert g(Y_k)\rVert)},
\alpha\in(0,1/2]
Sotirios Sabanis.
Euler approximations with varying coefficients: the
case of superlinearly growing diffusion coefficients.
To appear in Annals of Applied Probability, 2015.
Referencias
Aprendizaje automático científico (SciML)
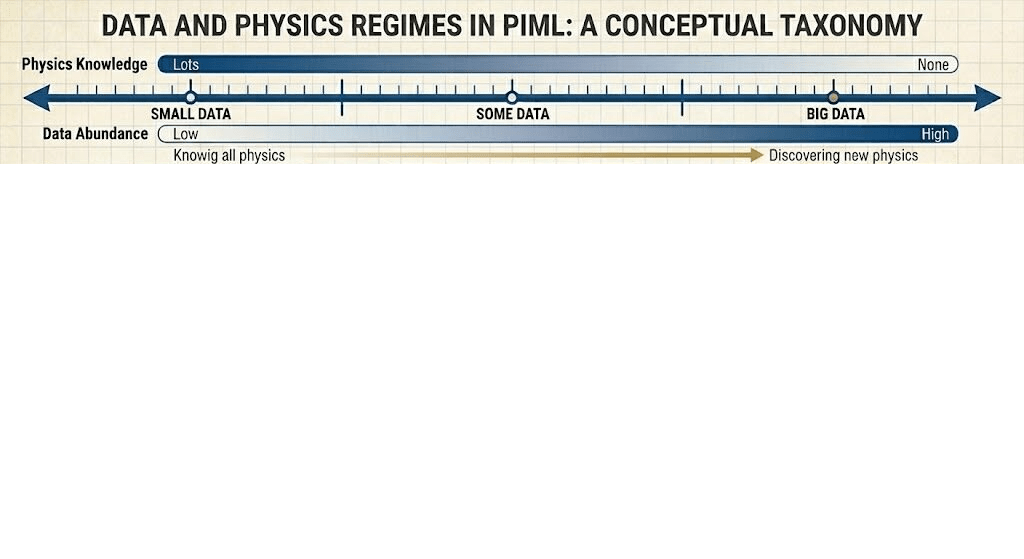
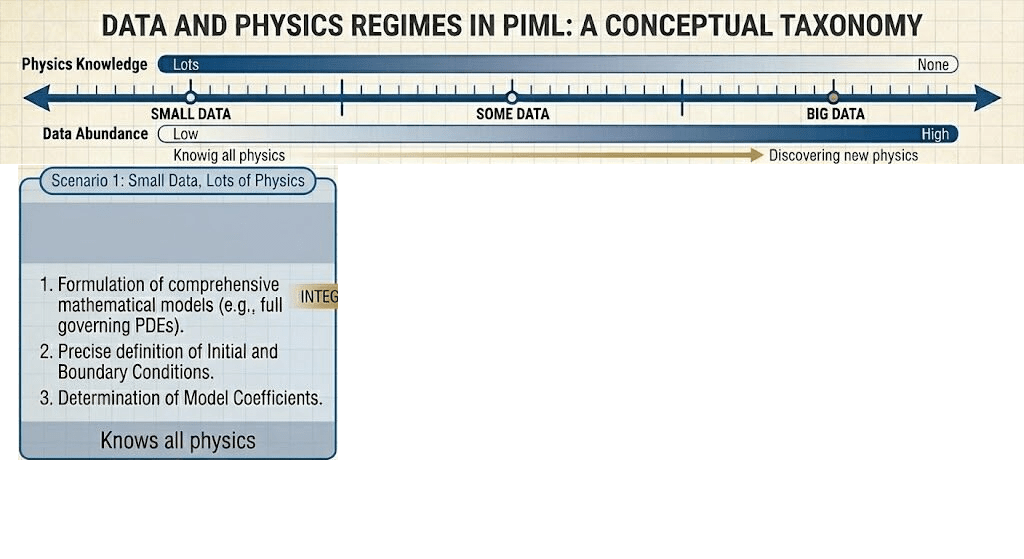
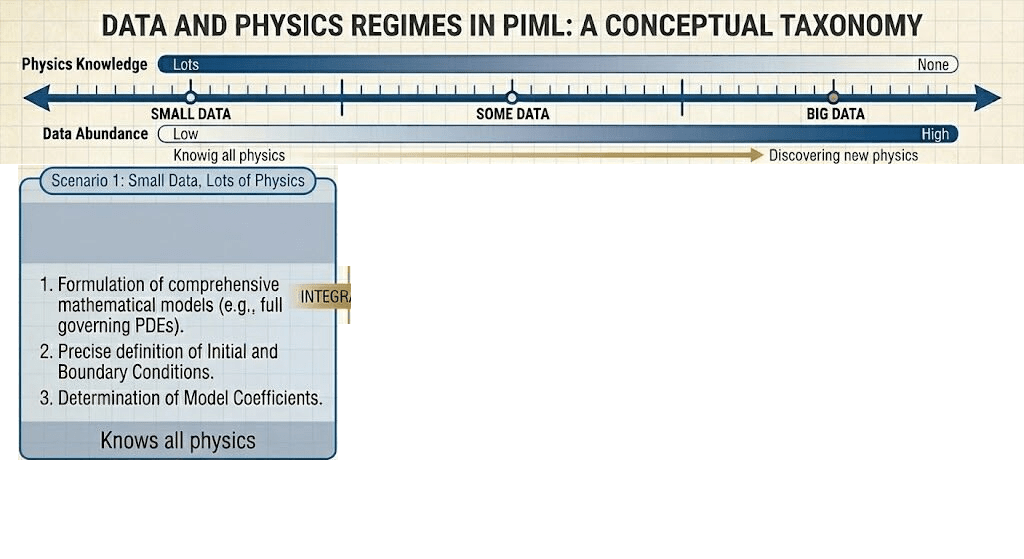
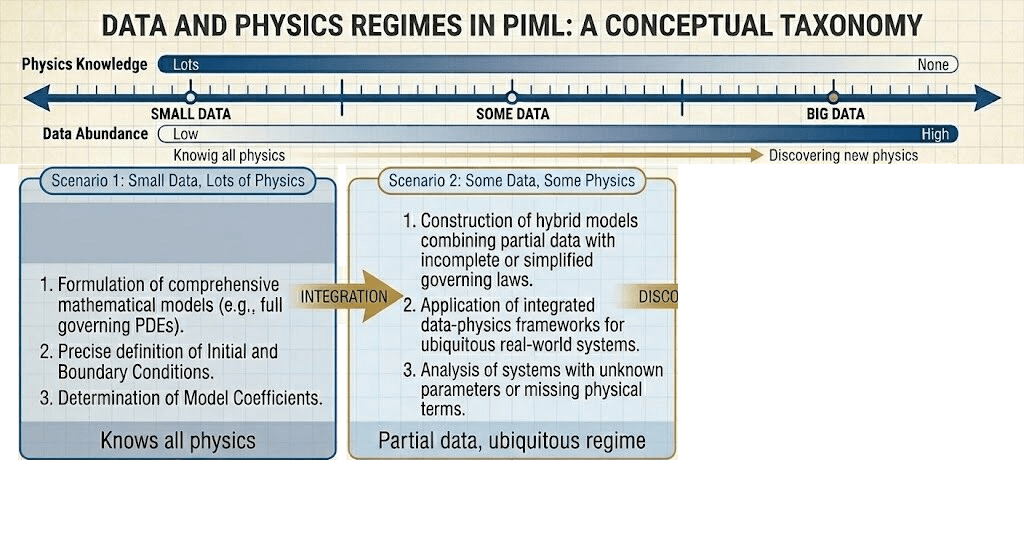
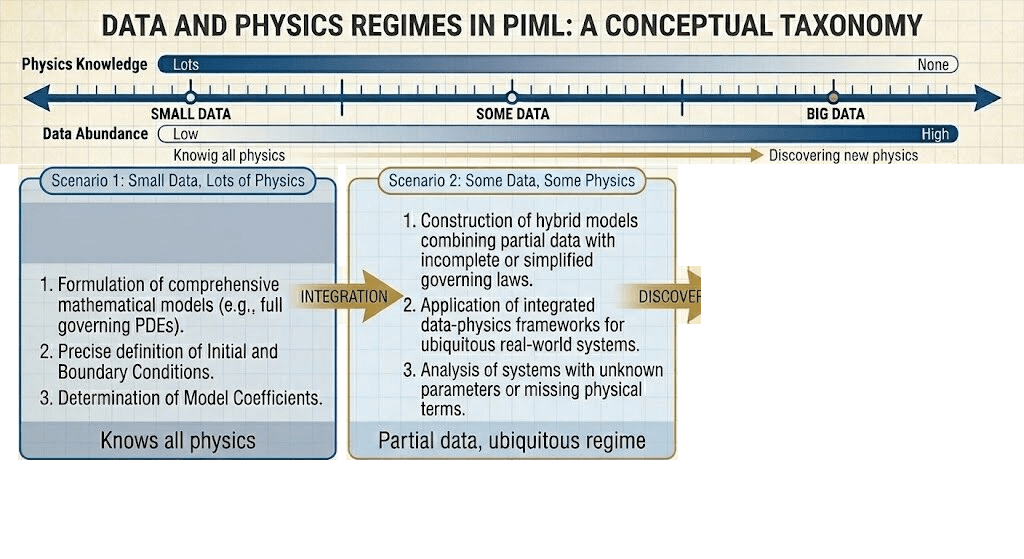
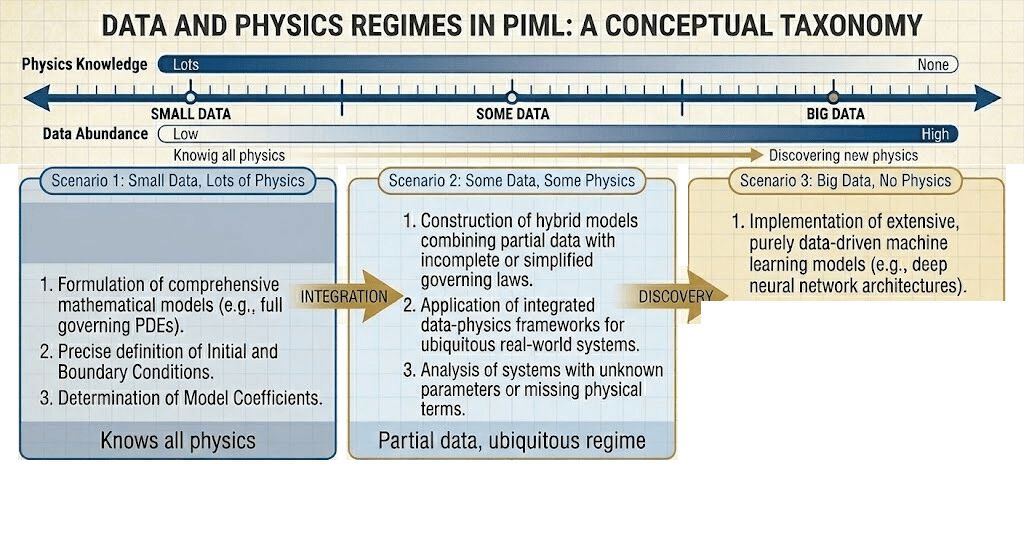
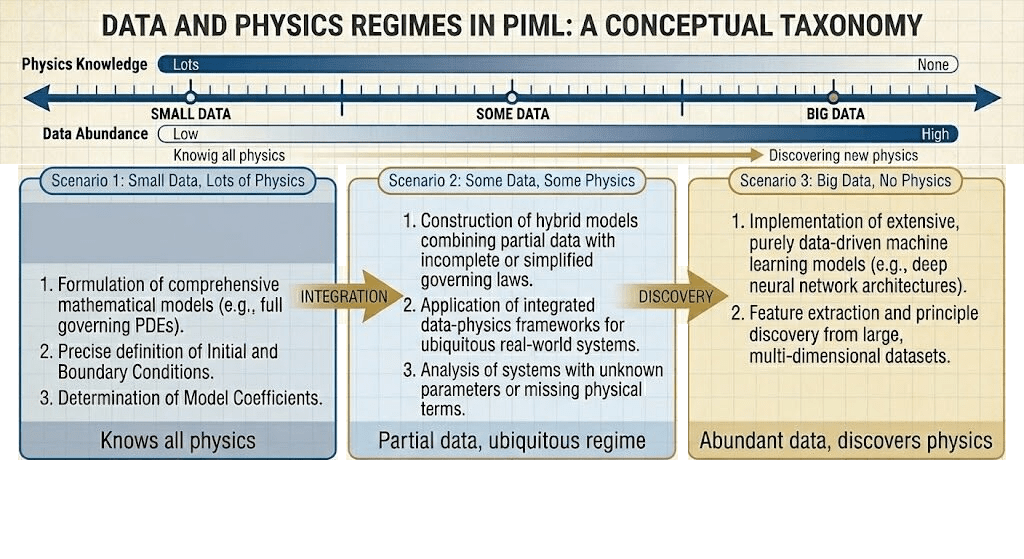
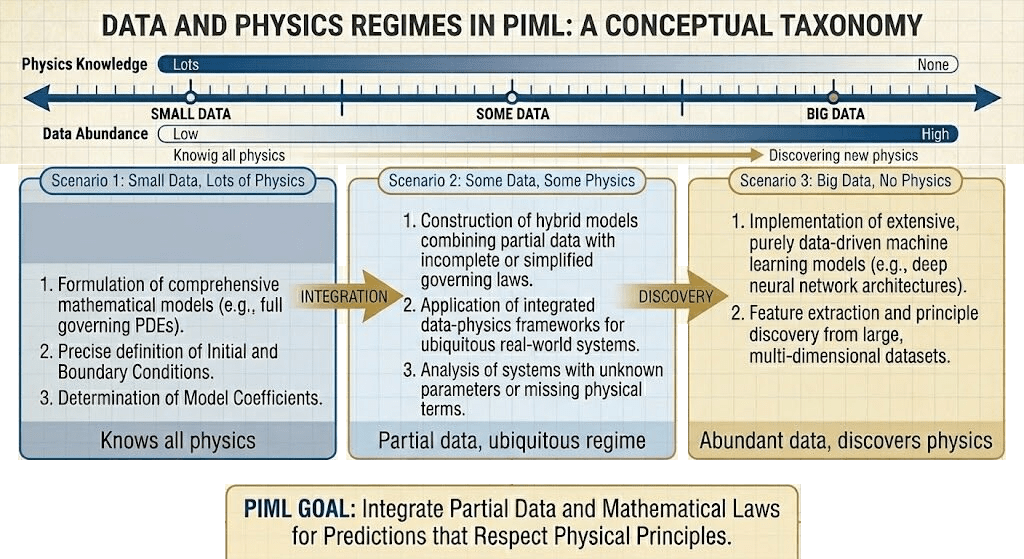
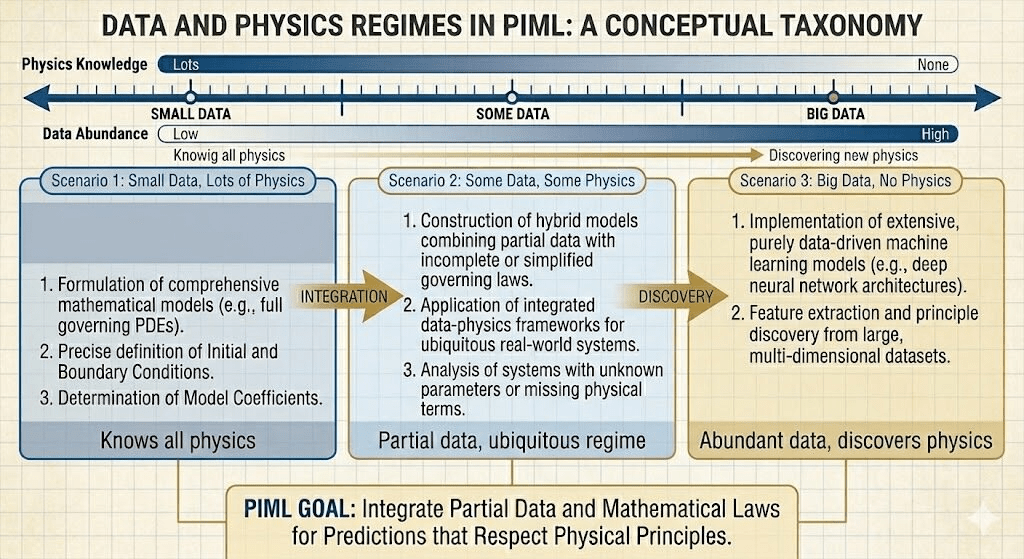
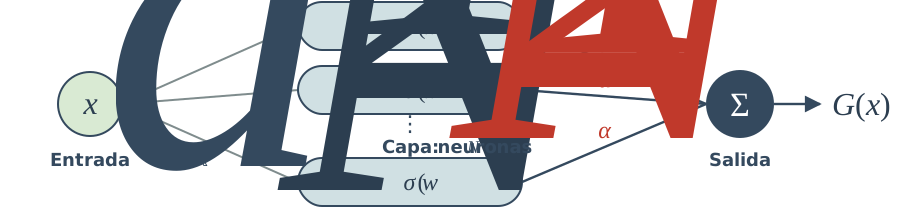
Aproximación universal con redes neuronales
- Las redes neuronales pueden aproximar funciones no lineales muy generales.
Teorema (Cybenko, 1989)
Sea \(\sigma:\mathbb{R}\to\mathbb{R}\) una función sigmoidal continua tal que
$$\lim_{x\to-\infty}\sigma(x) = 0, \qquad \lim_{x\to\infty}\sigma(x) = 1.$$
Entonces la clase de funciones
$$F(x) = \sum_{i=1}^{N} \alpha_i\,\sigma\big(w_i^\top x + b_i\big)$$
es densa en \(C([0,1]^n)\).
- Para toda \(f:[0,1]^n\to\mathbb{R}\) continua y todo \(\varepsilon>0\), existe \(F(x)\) tal que
$$|F(x) - f(x)| < \varepsilon.$$
- Por lo tanto, una red con una sola capa oculta puede aproximar cualquier función continua tan bien como queramos.
La función sigmoidal en el teorema de Cybenko
Cybenko llama función sigmoidal a cualquier función medible \(\sigma(t)\) que cumpla
$$\sigma(t)\to 1 \text{ cuando } t\to\infty \quad\text{y}\quad \sigma(t)\to 0 \text{ cuando } t\to-\infty.$$
Ejemplo clásico: la función logística
$$\sigma(x) = \frac{1}{1+e^{-x}}$$
- Acotada: sus valores están en el intervalo \((0,1)\).
- Monótona: siempre creciente, con un gradiente suave.
- Aproximación universal: las combinaciones lineales finitas \(G(x) = \sum_{i=1}^{N}\alpha_i\,\sigma\big(w_i^\top x + b_i\big)\) aproximan cualquier función continua en un compacto.
Dimensiones y datos de entrenamiento
\(\displaystyle f(x) \approx G(x) = \sum_{i=1}^{N}\alpha_i\,\sigma\big(w_i^\top x + b_i\big)\)
Dimensiones
Sea \(d\) el número de variables de entrada.
- \(x\in\mathbb{R}^d\): vector de entrada (un dato).
- \(w_i\in\mathbb{R}^d\): vector de pesos de la neurona \(i\).
- \(b_i\in\mathbb{R}\): sesgo (escalar) de la neurona \(i\).
- \(\alpha_i\in\mathbb{R}\): peso de salida que escala la sigmoide \(i\).
Relación con los datos de entrenamiento
En aprendizaje supervisado:
- Datos \(D := \{(x_j,y_j)\}_{j=1}^{m}\).
- Buscamos \(\{w_i, b_i, \alpha_i\}\) tales que \(G(x_j)\approx y_j\).
- Cybenko prueba que para todo \(\varepsilon>0\) existe \(N\) tal que \(|G(x)-f(x)|<\varepsilon\) para toda \(x\) en un compacto.
Resolver con PINNs
\begin{aligned}
\min_\theta
&
\frac{1}{N}
\sum_{i=1}^N
\lambda_0
\Big |
\frac{d y_\theta}{d t}(t_i) - f(t_i, y_\theta(t_i))
\Big |^2
+ \lambda |y_{\theta}(0) - y_0|^2
\\
& t_i \in (0, T]
\end{aligned}
Cada solución de la ecuación diferencial se obtiene resolviendo un problema de optimización.
Este enfoque está relacionado con los métodos de colocación y de elementos finitos. Es una línea de trabajo extendida.
Sea
$$\frac{dy_{\theta}}{dt} = f(t, y_{\theta}(t)), \quad t \in (0, T],$$
con condición inicial conocida:
$$y_{\theta}(0) = y_0.$$
Buscamos una red neuronal \(y_{\theta}\), con parámetros \(\theta\), que satisfaga esta ecuación.
Para ajustar la red neuronal, definimos la función de pérdida
$$ L(\theta) = L_{\text{residual}} + \lambda L_{\text{IC}}.$$
Elegimos puntos de colocación, \(\{t_i\}_{i=1}^{N}\), distribuidos en \((0,T]\). En cada punto calculamos el residuo:
$$\text{Residuo}(t_i) = \frac{dy_\theta}{dt}(t_i) - f(t_i,y_\theta(t_i)).$$
$$L_{\text{IC}} = |y_\theta(0) - y_0|^2$$
L_{\text{residual}} =
\frac{1}{N}
\sum_{i=1}^N
\Big |
\frac{d y_\theta}{d t}(t_i) - f(t_i, y_\theta(t_i))
\Big |^2
El reto: simular SDE
Consideremos una SDE escalar general:
$$dX_t = f(X_t) dt + g(X_t) dW_t$$
Ecuación de Fokker–Planck (ecuación de avance de Kolmogorov):
$$\frac{\partial p}{\partial t} = -\frac{\partial}{\partial x} [f(x) p(x,t)] + \frac{1}{2} \frac{\partial^2}{\partial x^2} [g^2(x) p(x,t)]$$
Ejemplo: movimiento browniano geométrico (GBM)
SDE:
$$dX_t = \mu X_t\,dt + \sigma X_t\,dW_t$$
- Problema de referencia clásico (finanzas, ruido multiplicativo).
- Tiene solución explícita, lo que lo hace ideal para validar.
Transformación logarítmica:
$$Y_t = \log X_t$$
$$dY_t = a\,dt + \sigma\,dW_t, \qquad a = \mu - \tfrac{1}{2}\sigma^2$$
- Ahora \(Y_t\) es un movimiento browniano con deriva (ruido aditivo).
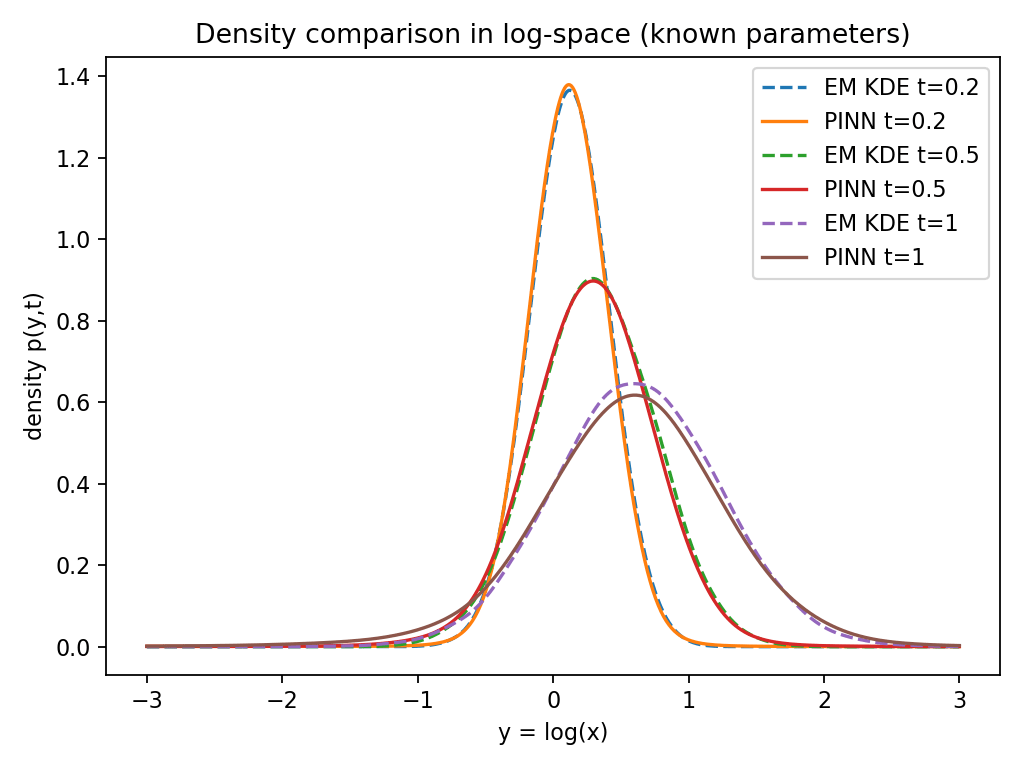
Density PINN: resolver la ecuación de Fokker–Planck
Sea \(p(y,t)\) la densidad de \(Y_t\):
$$p_t = -a\,p_y + \tfrac{1}{2}\sigma^2 p_{yy}$$
- Aproximamos la densidad con una PINN: \(p(y,t) \approx \hat p_\theta(y,t)\).
- Revisamos que \(\hat p_\theta\) resuelva la EDP con diferenciación automática en los puntos de colocación.
Función de pérdida (típica):
$$\begin{aligned}\mathcal{L} &= \underbrace{\big\| p_t + a\,p_y - \tfrac{1}{2}\sigma^2 p_{yy} \big\|^2}_{\text{residuo de la EDP}} \\ &\quad + \|\mathrm{IC}(t=0)\|^2 + \|\mathrm{BC}\|^2 + \Big| \int \hat p \, dy - 1 \Big|^2\end{aligned}$$
- Luego, los momentos de \(X_t = e^{Y_t}\) se calculan integrando:
$$\mathbb{E}[X_t] = \int e^{y}\,p(y,t)\,dy, \qquad \operatorname{Var}[X_t] = \int e^{2y}\,p\,dy - \big(\mathbb{E}[X_t]\big)^2$$
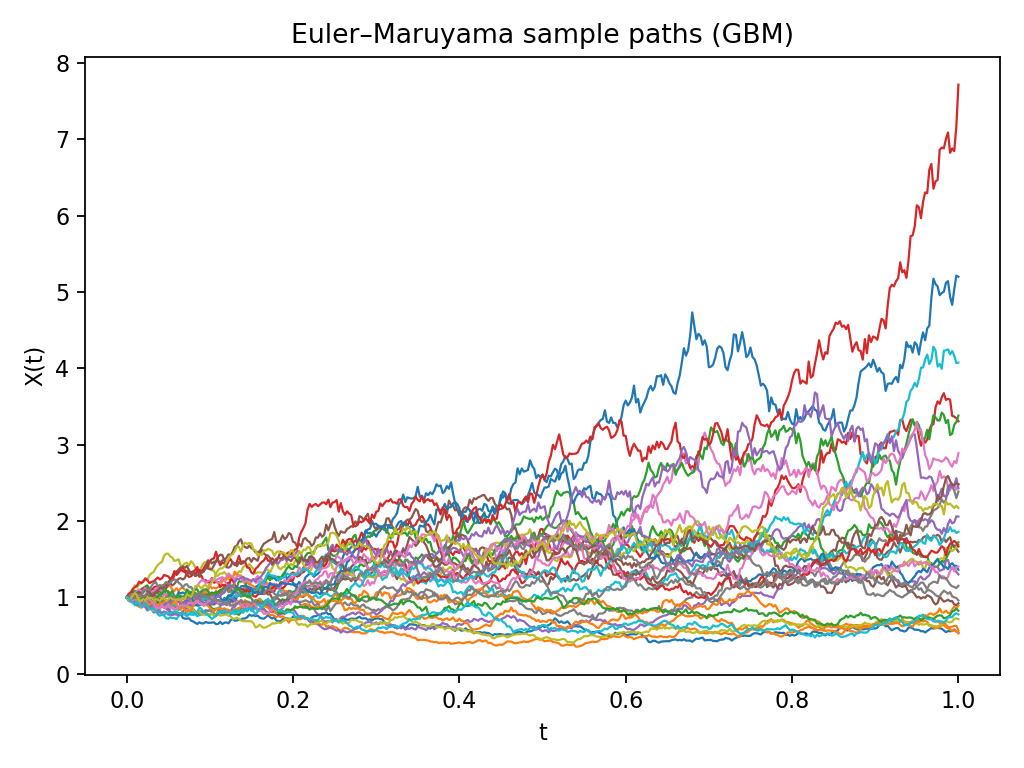
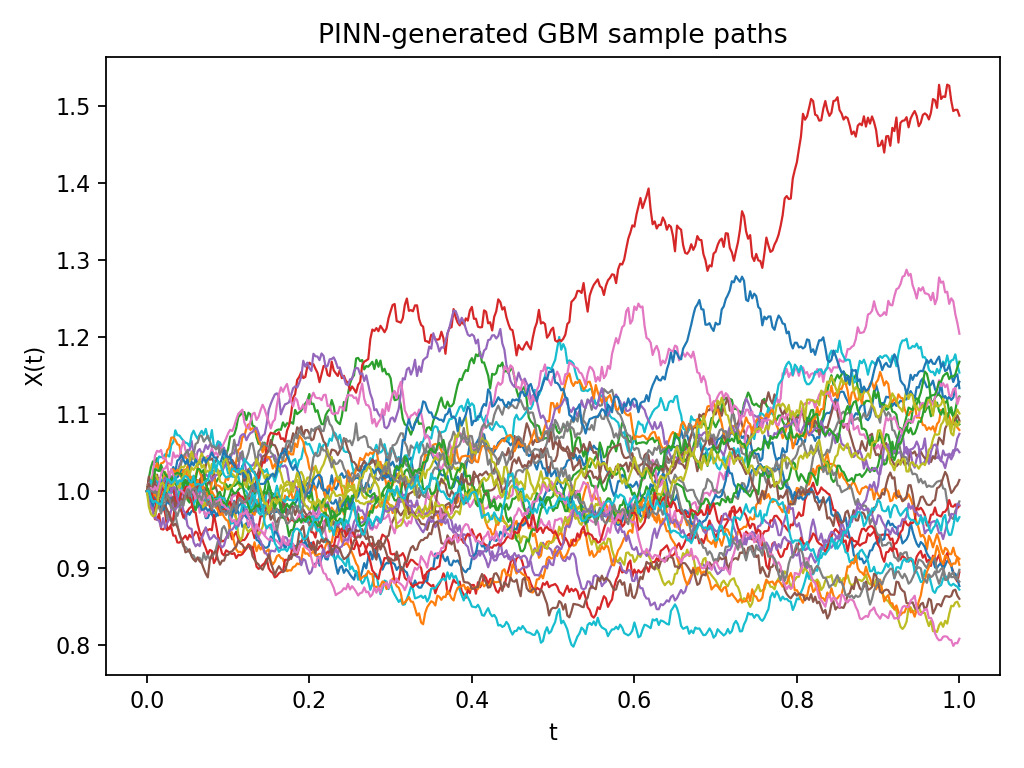
Pathwise PINN: una red que genera trayectorias
Objetivo: generar trayectorias con una red neuronal, comparables con las de Euler–Maruyama.
- Aprendemos una función determinista \(u(t,w)\) tal que
$$u(t, W_t) \approx X_t.$$
- Luego simulamos una trayectoria browniana \(W_t(\omega)\) y definimos
$$X_t(\omega) \approx u\big(t, W_t(\omega)\big).$$
La idea principal
La fórmula de Itô convierte la SDE en restricciones deterministas sobre \(u(t,w)\).
Restricciones de Itô para el GBM (Itô-map PINN)
Consideremos \(u(t, W_t)\). Por la fórmula de Itô:
$$d\,u(t,W_t) = u_t\,dt + u_w\,dW_t + \tfrac{1}{2}u_{ww}\,dt$$
- Queremos que \(u(t,W_t)\) se comporte como un GBM:
$$dX_t = \mu X_t\,dt + \sigma X_t\,dW_t$$
Igualando los coeficientes de \(dt\) y \(dW_t\):
$$u_w = \sigma u, \qquad u_t + \tfrac{1}{2}u_{ww} = \mu u$$
- Obtenemos restricciones deterministas, en forma de EDP, sobre \((t,w)\).
Entrenamiento y generación de trayectorias
Entrenamos \(u_\theta(t,w)\) minimizando:
$$\begin{aligned}\mathcal{L} &= \|u_w - \sigma u\|^2 \\ &\quad + \Big\| u_t + \tfrac{1}{2}u_{ww} - \mu u \Big\|^2 \\ &\quad + \|u(0,0) - x_0\|^2\end{aligned}$$
Generamos trayectorias:
- Simulamos el movimiento browniano:
$$W_{n+1} = W_n + \Delta W_n, \quad \Delta W_n \sim \mathcal{N}(0, \Delta t)$$
- Trayectoria de la PINN:
$$X_n^{\text{PINN}} = u_\theta(t_n, W_n)$$
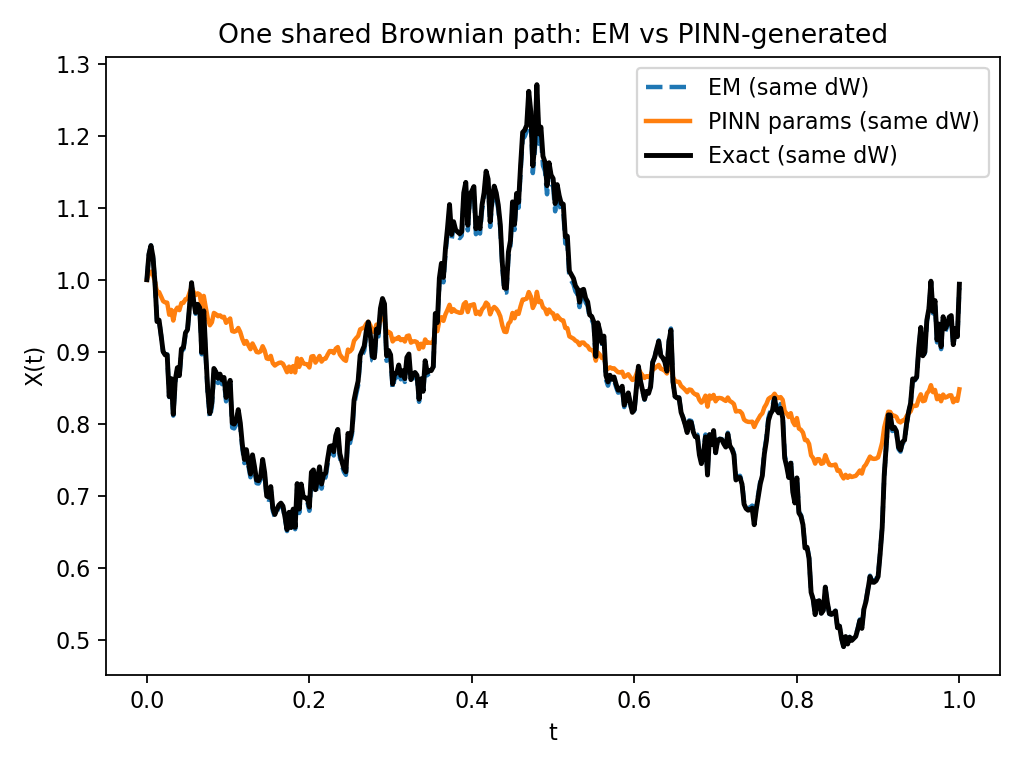
- Comparamos con Euler–Maruyama usando los mismos \(\Delta W_n\):
$$X_{n+1} = X_n + \mu X_n\,\Delta t + \sigma X_n\,\Delta W_n$$
Qué comparar en la práctica
Comparación de trayectorias:
- Graficamos trayectorias con los mismos incrementos brownianos, para que la comparación sea justa.
- Comparamos rasgos de la distribución (p. ej., histograma o KDE de \(\log X_t\)).
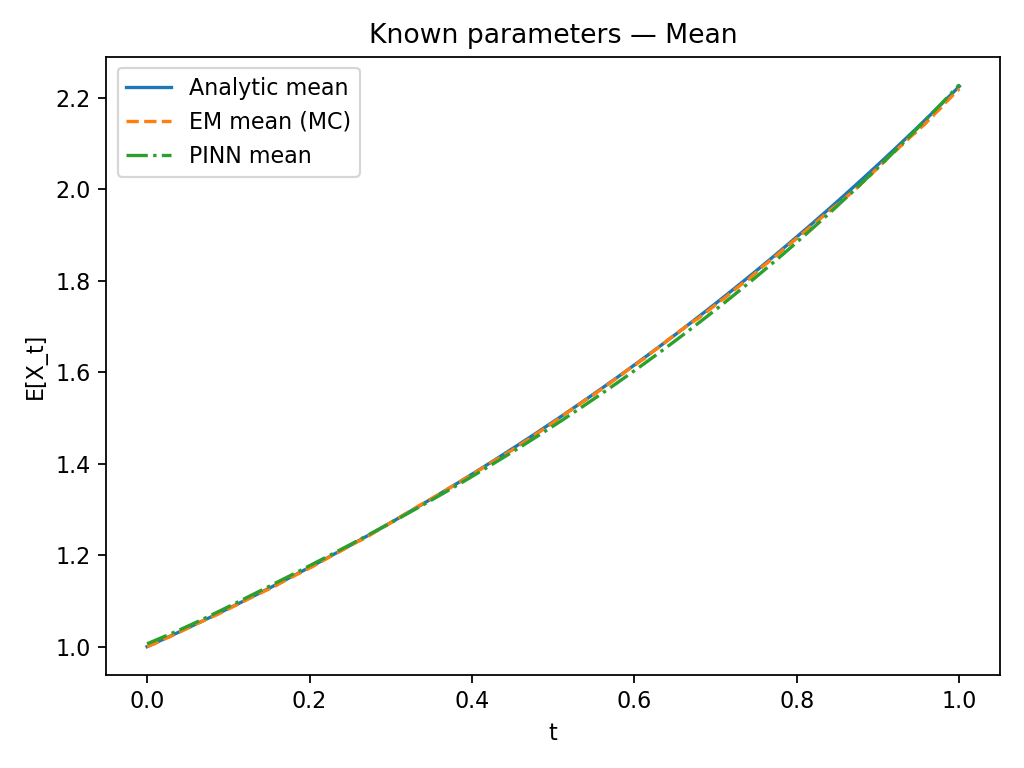
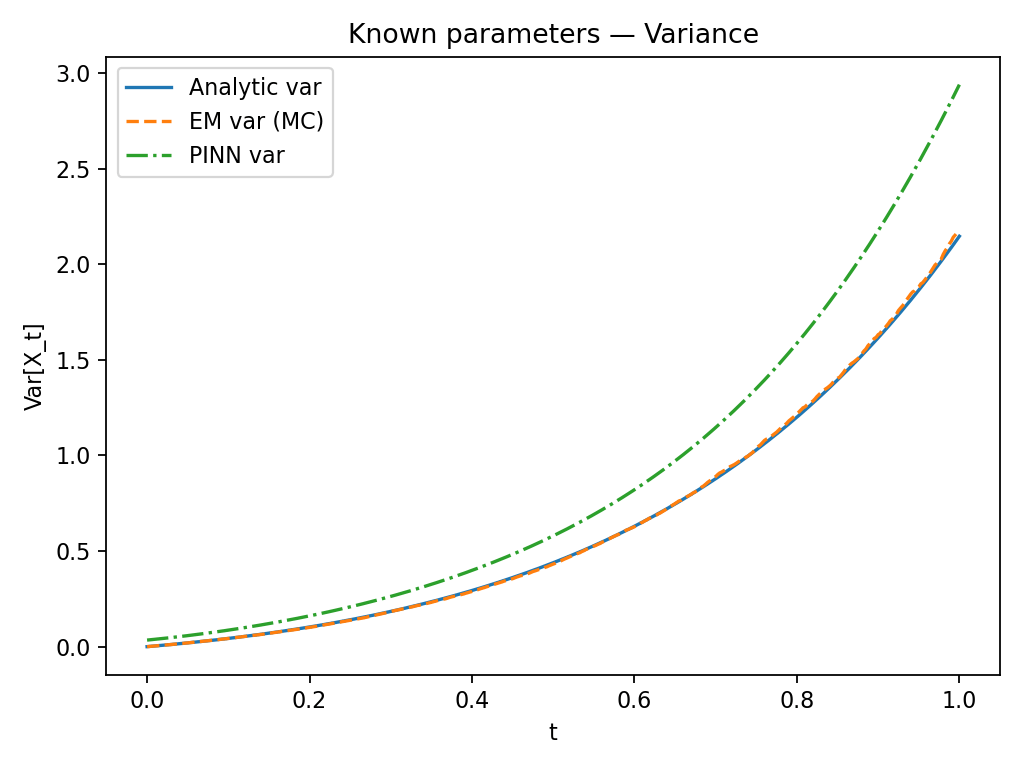
Comparación de momentos:
- Estimamos \(\mathbb{E}[X_t]\) y \(\operatorname{Var}[X_t]\) con muchas trayectorias (Monte Carlo).
Validamos con las fórmulas del GBM:
$$\mathbb{E}[X_t] = x_0 e^{\mu t}, \quad \operatorname{Var}[X_t] = x_0^2 e^{2\mu t}\big(e^{\sigma^2 t} - 1\big)$$
Costo computacional:
- EM: barato por trayectoria, pero se necesitan muchas para obtener estadísticas.
- PINN: entrenamiento costoso, evaluación rápida una vez entrenada.
| Característica | Métodos clásicos | PINNs |
|---|---|---|
| Teoría | Sólida | En desarrollo |
| Interpretabilidad | Alta | Moderada |
| Dimensión alta | Difícil | Mejor |
| Integración de datos | Limitada | Natural |
| Garantías de estabilidad | Sí | A menudo inciertas |
Referencias
- An algorithmic introduction to numerical simulation of stochastic differential equations. SIAM Review, 43(3):525–546, 2001. doi:10.1137/S0036144500378302
- Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378:686–707, 2019. doi:10.1016/j.jcp.2018.10.045
- Error bounds for physics-informed neural networks in Fokker-Planck PDEs. In Proceedings of the Forty-first Conference on Uncertainty in Artificial Intelligence, Proceedings of Machine Learning Research, volume 286, pages 2291–2324, 2025. Fuente PMLR
ODE y SDE neuronales
ODE neuronales
Una ecuación diferencial ordinaria neuronal es una ecuación diferencial cuyo campo vectorial está parametrizado por una red neuronal.
La idea central es integrar un solucionador de ecuaciones diferenciales en un grafo computacional diferenciable que se aprende, como los usados en aprendizaje profundo.
\begin{aligned}
\frac{d y}{d t}(t)
&
= f_\theta(t, y(t))
\\
&
y(0) = y_0
\\
&
f_\theta:
\mathbb{R} \times \mathbb{R}^{d_1 \times \cdots \times d_k}
\to \mathbb{R}^{d_1 \times \cdots \times d_k}
\end{aligned}
Chen et al. Neural Ordinary Differential Equations. in Advances in Neural Information Processing Systems (eds. Bengio, S. et al.) vol. 31 (2018).
arXiv:1806.07366
Podemos minimizar la función de pérdida con métodos basados en gradientes ; para ello necesitamos una forma eficiente de calcular el gradiente.
La ecuación adjunta de la teoría de control óptimo es una herramienta fundamental.
La primera derivación de la ecuación adjunta se basa en el formalismo lagrangiano, donde \(a\), la variable adjunta, desempeña un papel similar al de un multiplicador de Lagrange
Los resultados muestran que resolver la ecuación adjunta hacia atrás en el tiempo proporciona el gradiente de la pérdida.
Costo en MNIST (Chen et al., Tabla 1)
ModeloErrorParám.MemoriaTiempo
| ResNet | 0.41% | 0.60 M | O(L) | O(L) |
| RK-Net | 0.47% | 0.22 M | O(L̃) | O(L̃) |
| ODE-Net | 0.42% | 0.22 M | O(1) | O(L̃) |
L: capas · L̃: evaluaciones de f (NFE), ajustables con la tolerancia. Hacia atrás ≈ 0.8× NFE del paso hacia adelante.
Algoritmo 1: estado aumentado en una sola llamada al solver hacia atrás; z(t) se reconstruye en vez de almacenarse ⇒ memoria O(1).
\begin{aligned}
s_0 &= \Big[\,z(t_1),\ \tfrac{\partial L}{\partial z(t_1)},\ 0_{|\theta|}\Big]\\
\dot s &= \Big[\,f,\ -a^{\top}\tfrac{\partial f}{\partial z},\ -a^{\top}\tfrac{\partial f}{\partial \theta}\Big]\\
\Big[z(t_0),\tfrac{\partial L}{\partial z(t_0)},\tfrac{\partial L}{\partial \theta}\Big] &= \mathrm{ODESolve}(s_0,\dot s,\,t_1\!\to t_0)
\end{aligned}
1. Pasada hacia adelante
\begin{gathered}\mathbf{z}(t_1)=\mathrm{ODESolve}\big(\mathbf{z}(t_0),f,t_0,t_1,\theta\big)\\[10pt]\mathcal{L}=\mathcal{L}\big(\mathbf{z}(t_1)\big)\end{gathered}
2. Estado adjunto
\begin{gathered}\mathbf{a}(t)\equiv\dfrac{\partial\mathcal{L}}{\partial\mathbf{z}(t)}\\[10pt]\dfrac{d\mathbf{a}(t)}{dt}=-\mathbf{a}(t)^{\top}\dfrac{\partial f}{\partial\mathbf{z}}\end{gathered}
3. Integración inversa
\begin{gathered}\mathbf{a}(t_1)=\dfrac{\partial\mathcal{L}}{\partial\mathbf{z}(t_1)}\\[10pt]\text{Integración: } t_1\to t_0\end{gathered}
4. Gradientes de salida
\begin{gathered}\dfrac{\partial\mathcal{L}}{\partial\mathbf{z}(t_0)}=\mathbf{a}(t_0)\\[10pt]\dfrac{\partial\mathcal{L}}{\partial\theta}=-\int_{t_1}^{t_0}\mathbf{a}(t)^{\top}\dfrac{\partial f}{\partial\theta}\,dt\end{gathered}
ℒ
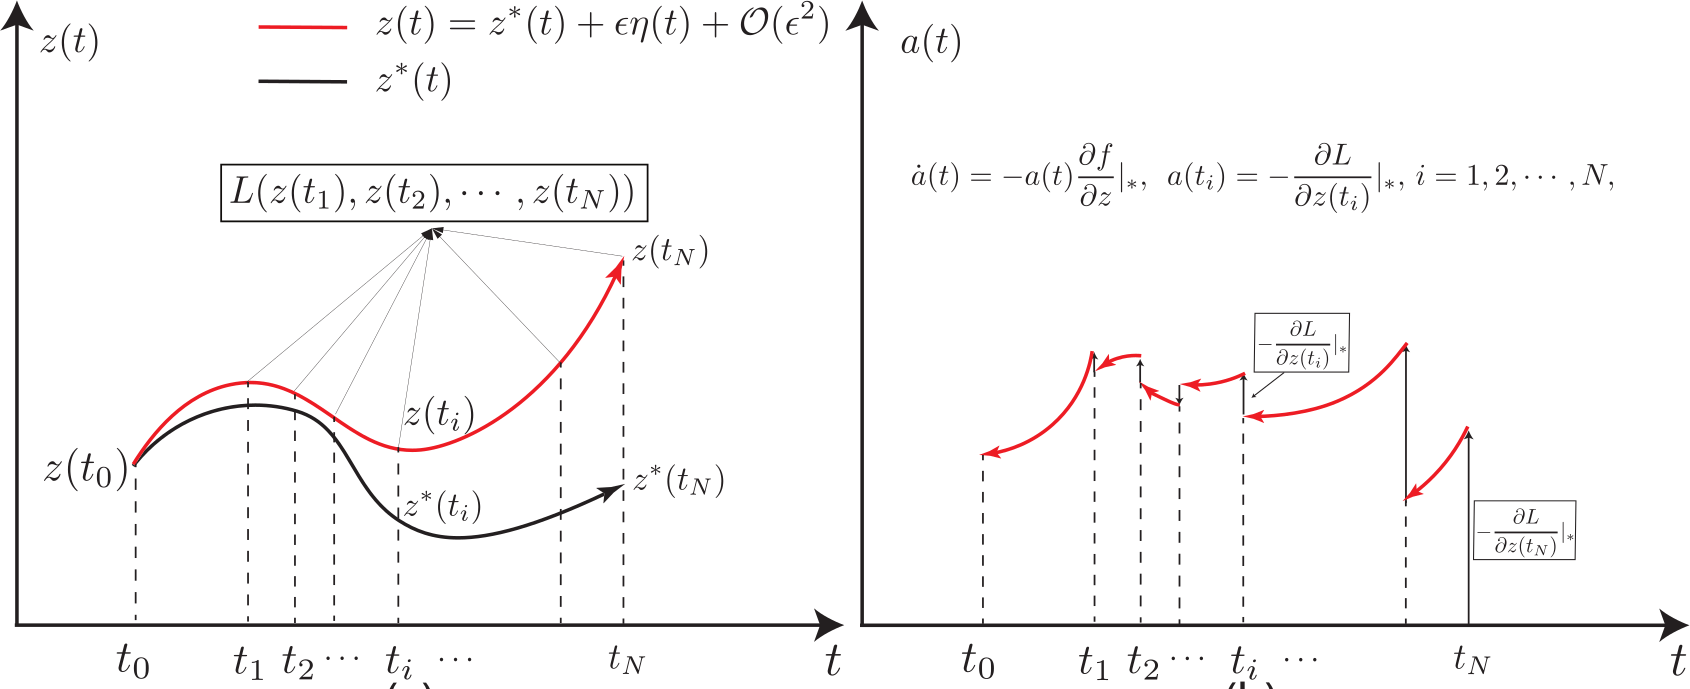
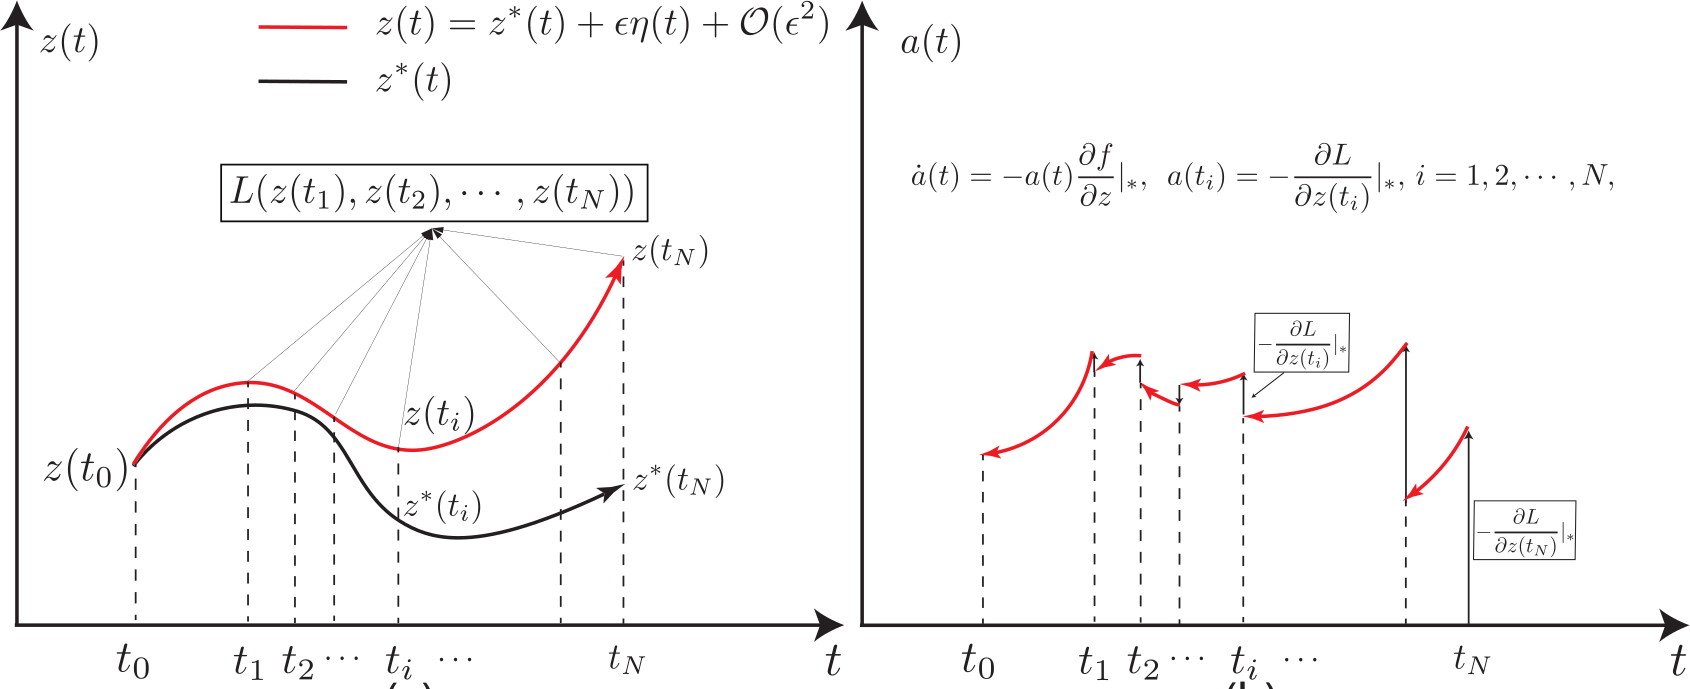
En el modelado de secuencias y el análisis de series temporales, la pérdida suele depender del estado en varios tiempos discretos \(\{t_1, t_2, \dots, t_N\}\).
El problema de optimización es:
Método adjunto para pérdidas en varios tiempos
\begin{aligned}
&\min_{\theta} L(z(t_1), z(t_2), \dots, z(t_N))
\\
\text{sujeto a} &
\\
&\dot{z}(t) = f(t, z(t), \theta)
\end{aligned}
$$\left( \frac{\partial L}{\partial \theta} \right)_k = \sum_{i=1}^{N} \frac{\partial L}{\partial z(t_i)} \frac{\partial z(t_i)}{\partial \theta_k}$$
$$\frac{\partial z(t_i)}{\partial \theta_k} = \int_{t_0}^{t_N} \frac{\partial z(t)}{\partial \theta_k} \delta(t - t_i) dt$$
$$\left( \frac{\partial L}{\partial \theta} \right)_k = \int_{t_0}^{t_N} \frac{\partial z(t)}{\partial \theta_k} \left( \sum_{i=1}^{N} \frac{\partial L}{\partial z(t_i)} \delta(t - t_i) \right) dt$$
$$\left( \frac{\partial L}{\partial \theta} \right)_k = \left\langle \sum_{i=1}^{N} \frac{\partial L}{\partial z(t_i)} \delta(t - t_i), \frac{\partial z(t)}{\partial \theta_k} \right\rangle_{X^*, X}$$
\left( \frac{\partial L}{\partial \theta} \right)_k
=
\left\langle
\frac{\partial L}{\partial z}
,
\frac{\partial z(t)}{\partial \theta_k}
\right\rangle_{X^*, X}
\begin{aligned}
&\min_{\theta} L(z(t_1), z(t_2), \dots, z(t_N))
\\
\text{sujeto a} &
\\
&\dot{z}(t) = f(t, z(t), \theta)
\end{aligned}
Al diferenciar ambos lados de la ecuación de restricción respecto de \(\theta\)
\frac{d}{d\theta} \dot{z} =
\frac{\partial f}{\partial z}
\frac{\partial z}{\partial \theta} +
\frac{\partial f}{\partial \theta}
\Big(
\frac{d}{dt} - \frac{\partial f}{\partial z}
\Big) \frac{\partial z}{\partial \theta}
=
\frac{\partial f}{\partial \theta}
Supongamos que \(a\) = \(a(t)\) tal que
\begin{aligned}
\left\langle
\frac{\partial L}{\partial z}
,
\frac{\partial z(t)}{\partial \theta_k}
\right\rangle_{X^*, X}
=&
\left\langle
a
,
\Big(
\frac{d}{dt} - \frac{\partial f}{\partial z}
\Big)
\frac{\partial z(t)}{\partial \theta_k}
\right\rangle
\\
=&
\left\langle
a
,
\frac{\partial f}{\partial \theta_k}
\right\rangle
\\
=&
\left\langle
\Big(
-\frac{d}{dt}
- \frac{\partial f}{\partial z}
\Big)^{\top}
a
,
\frac{\partial z}{\partial \theta_k}
\right\rangle
\end{aligned}
Integrando por partes
\begin{aligned}
-\frac{d}{dt}
a^{\top}(t) &=
\sum_{i=1}^N
\frac{\partial L}{\partial z(t_i)}
\delta(t-t_i)
+
a^{\top}
\frac{\partial f}{\partial z}
\\
&a(t_N) = 0
\\
-\frac{d}{dt}
a^{\top}(t)
& =
a \frac{\partial f}{\partial z}
\\
&a^{\top}(t_i^{-})
=
a(t_i^{+}) + \frac{\partial L}{\partial z(t_i)}
\\
& i = N-1, \dots, 1
\end{aligned}
\Big(
\frac{\partial L}{\partial \theta}
\Big)_k =
\int_{t_N}^{t_0}
a(t)^{T}
\frac{\partial}{\partial \theta_k}
f(t, \textcolor{green}{z(t,\theta)}, \theta)
\begin{aligned}
&\min_{\theta} L(z(t_1), z(t_2), \dots, z(t_N))
\\
\text{sujeto a} &
\\
&\dot{z}(t) = f(t, z(t), \theta)
\end{aligned}
dZ_t = b_\theta(Z_t,t)\,dt+\sigma_\theta(Z_t,t)\,dW_t,
\qquad Z_0=z_0
SDE neuronal
Simulamos la SDE hacia adelante, obtenemos \(Z_T\) y calculamos la pérdida
\[\mathcal L = \ell(Z_T).\]
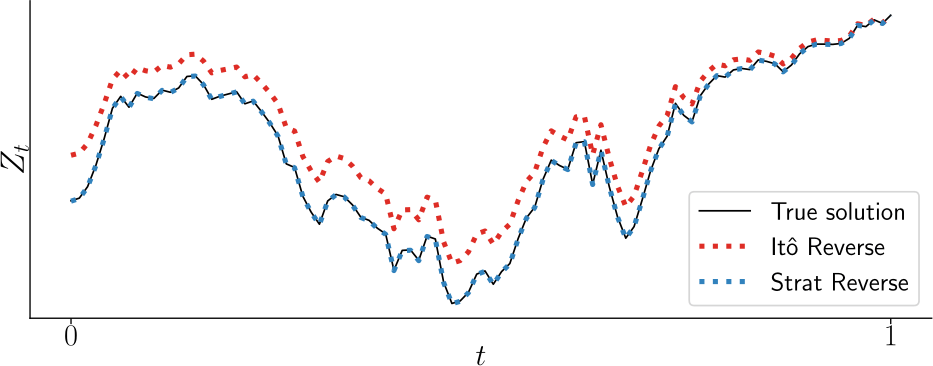
Sin embargo, el paso hacia atrás debe usar la misma trayectoria browniana que el paso hacia adelante.
No es válido invertir directamente una SDE de Itô. La construcción en tiempo inverso utiliza la forma de Stratonovich:
dZ_t
=
b_\theta(Z_t,t)\,dt
+
\sum_{i=1}^m \sigma_{\theta,i}(Z_t,t)\circ dW_t^{(i)}
Para una trayectoria browniana fija, la SDE de Stratonovich define un flujo estocástico
Z_t = \Phi_{s,t}(Z_s)
Z_T
=
Z_0
+
\int_0^T b_\theta(Z_t,t)\,dt
+
\sum_{i=1}^m
\int_0^T
\sigma_{\theta,i}(Z_t,t)\circ dW_t^{(i)}
Reconstrucción del estado hacia atrás
El flujo estocástico inverso reconstruye el estado anterior a partir del estado terminal:
Z_s
=
Z_T
-
\int_s^T b_\theta(Z_r,r)\,dr
-
\sum_{i=1}^m
\int_s^T
\sigma_{\theta,i}(Z_r,r)\circ d\widehat W_r^{(i)}
\begin{aligned}
&a_t=\frac{\partial \mathcal L}{\partial Z_t},\qquad a_T=\frac{\partial \ell}{\partial Z_T},\qquad a_0=\frac{\partial \mathcal L}{\partial Z_0}\\[6pt]
da_t&=a_t\frac{\partial b_\theta}{\partial z}(Z_t,t)\,dt+\sum_{i=1}^m a_t\frac{\partial \sigma_{\theta,i}}{\partial z}(Z_t,t)\circ d\widehat W_t^{(i)}\\[6pt]
a_s&=a_T+\int_s^T a_r\frac{\partial b_\theta}{\partial z}(Z_r,r)\,dr\\
&\quad+\sum_{i=1}^m\int_s^T a_r\frac{\partial \sigma_{\theta,i}}{\partial z}(Z_r,r)\circ d\widehat W_r^{(i)}
\end{aligned}
\begin{aligned}
&q_t=\frac{\partial \mathcal L}{\partial \theta},\qquad q_T=0\\
q_s&=q_T+\int_s^T a_r\frac{\partial b_\theta}{\partial \theta}(Z_r,r)\,dr\\
&\quad+\sum_{i=1}^m\int_s^T a_r\frac{\partial \sigma_{\theta,i}}{\partial \theta}(Z_r,r)\circ d\widehat W_r^{(i)}\\
&\frac{\partial \mathcal L}{\partial \theta}=q_0
\end{aligned}
Referencias: PINNs y cuantificación de incertidumbre
- NeuralUQ: A Comprehensive Library for Uncertainty Quantification in Neural Differential Equations and Operators. SIAM Review, 66(1):161–190, 2024. doi:10.1137/21M1446859
- Uncertainty Quantification in Scientific Machine Learning: Methods, Metrics, and Comparisons. Journal of Computational Physics, 477:111902, 2023. doi:10.1016/j.jcp.2022.111902
- Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378:686-707, 2019. doi:10.1016/j.jcp.2018.10.045
Referencias: ODE y SDE neuronales
- Neural ordinary differential equations. Advances in Neural Information Processing Systems, 31, 2018. Fuente NeurIPS
- Solving ordinary differential equations I: Nonstiff problems. Springer Series in Computational Mathematics, volume 8, second edition, Springer, 1993. doi:10.1007/978-3-540-78862-1
- “Hey, that’s not an ODE”: Faster ODE adjoints via seminorms. In Proceedings of the 38th International Conference on Machine Learning, Proceedings of Machine Learning Research, 139:5443–5452, 2021. Fuente PMLR
- Scalable gradients for stochastic differential equations. In Proceedings of the 23rd International Conference on Artificial Intelligence and Statistics (AISTATS), Proceedings of Machine Learning Research, 108:3870-3882, 2020. Fuente PMLR
- Neural SDEs as Infinite-Dimensional GANs. In Proceedings of the 38th International Conference on Machine Learning, Proceedings of Machine Learning Research, 139:5453-5463, 2021. Fuente PMLR
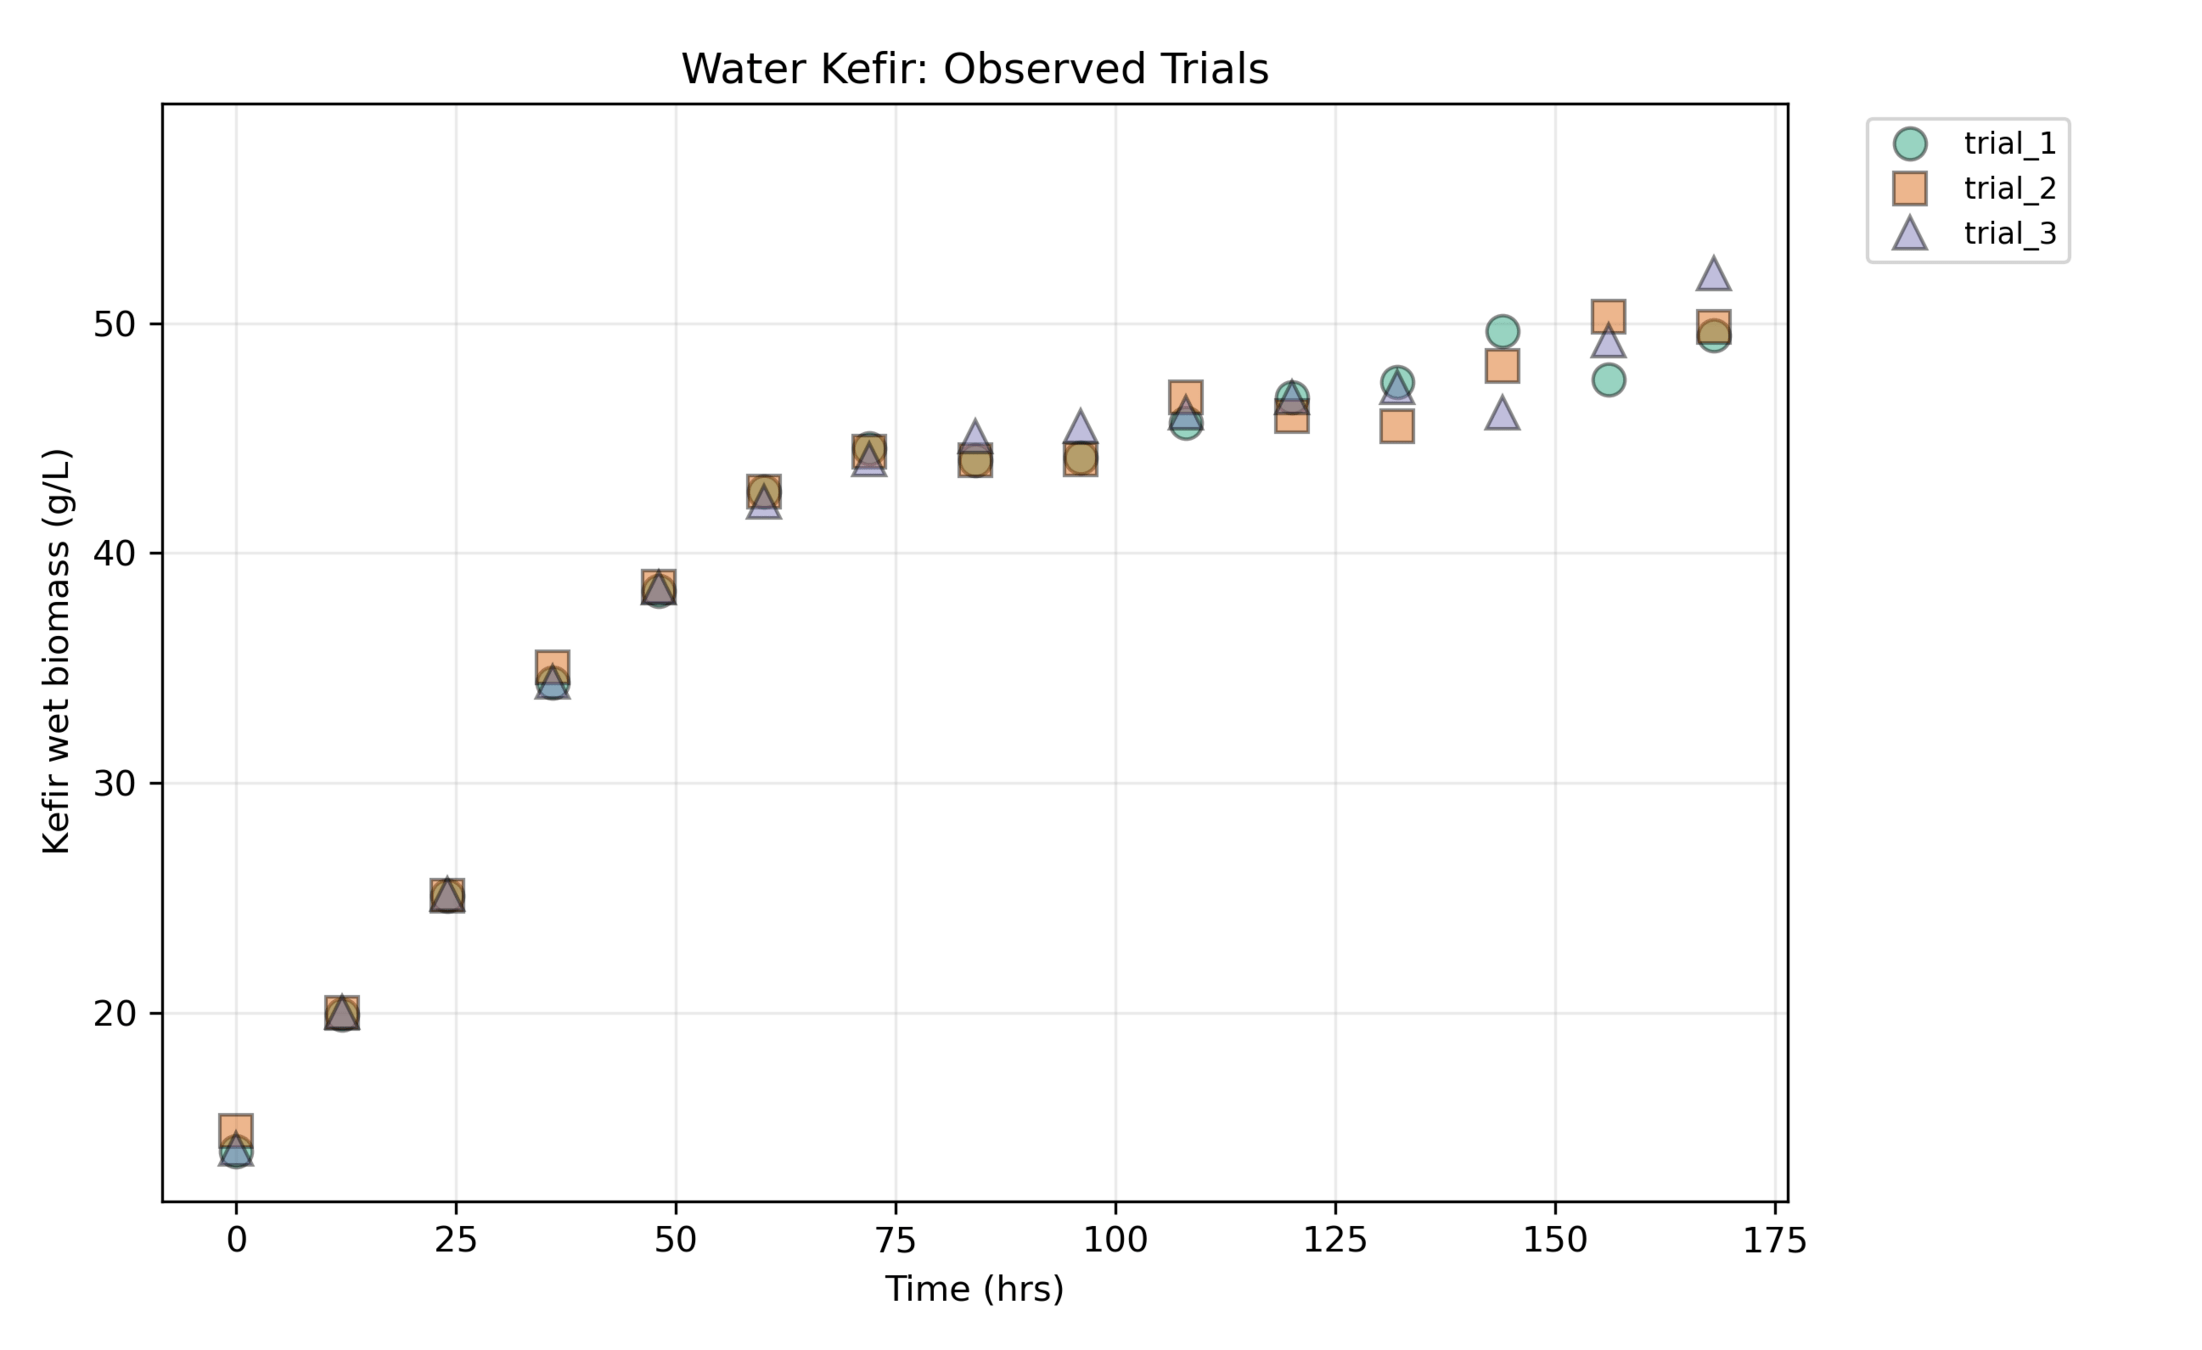
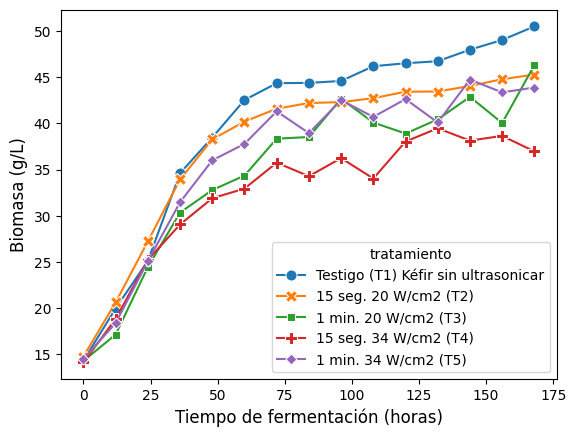
Ajuste de datos de producción de kéfir de agua
Ejemplo con datos reales
Producción de kéfir de agua
Dr. José Carlos Rodríguez Figueroa
Efecto del ultrasonido de intensidad alta y la fermentación sobre los metabolitos específicos y propiedades funcionales del kéfir de agua
Yanet Proenza, D. (Autor), Rodríguez Figueroa, J. C. (Director). 2025
Tesis de máster
Parametrización de la ODE neuronal
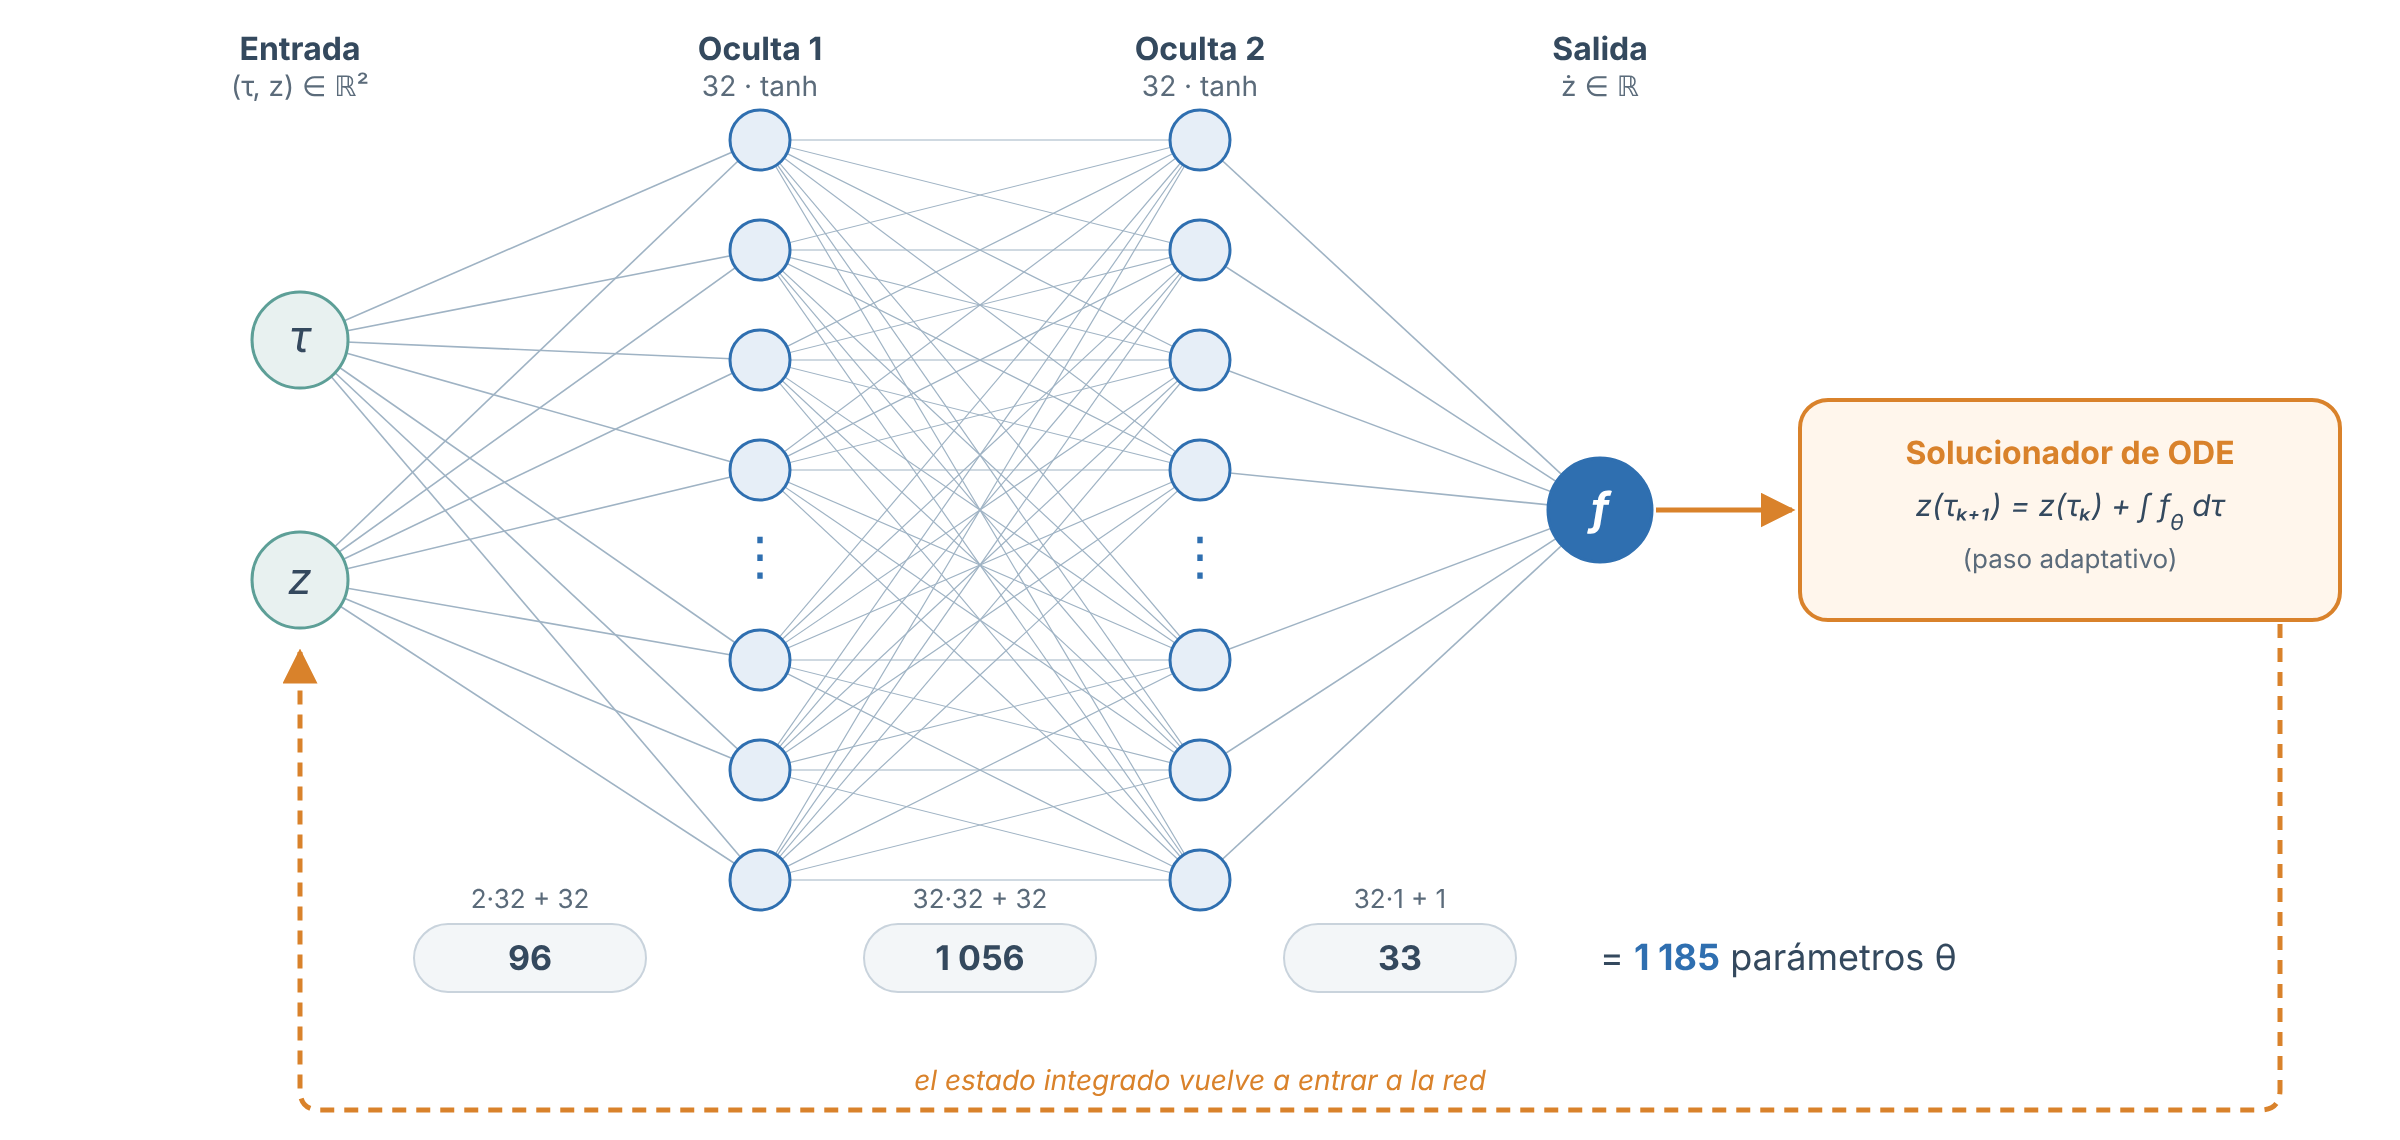
- La red sustituye todo el lado derecho logístico: no se impone forma funcional.
- Tiempo reescalado: \(\tau = \frac{t - t_{\min}}{t_{\max} - t_{\min}} \in [0,1]\).
- Entrada \((\tau, z)\) → 2 capas \(\tanh\) de 32 → salida \(\frac{dz}{d\tau}\).
- \(\theta\) se ajusta derivando a través del solucionador (método adjunto) para minimizar \(\mathcal{L}_{\mathrm{ODE}}\).
Logística · 2 parámetros (r, K)
\frac{dz}{d\tau}=(t_{\max}-t_{\min})\,r\,z\left(1-\frac{z}{K}\right)
ODE neuronal · 1 185 parámetros θ
\frac{dz}{d\tau}=f_\theta(\tau,z),\quad \theta=\{W_\ell,b_\ell\}_{\ell=1,2,o}
Misma ecuación de estado, distinto campo vectorial: la ganancia en flexibilidad se paga con ~600× más parámetros.
El lado derecho \(f_\theta\) es una red neuronal totalmente conectada con entrada
\((\tau,z) \in \mathbb R^2\), dos capas ocultas, 32 unidades por capa y
activación tangente hiperbólica:
\frac{d z}{d\tau} = f_\theta(\tau,z),
\qquad
z(0)=z_0.
\begin{aligned}
h_1 &=
\tanh(W_1 x+b_1),
\\
h_{\ell}
&=
\tanh(W_{\ell}h_{\ell-1}+b_{\ell}),
\\
f_\theta(x)
&=
W_o h_2+b_o
\end{aligned}
\mathcal L_{\mathrm{ODE}}(\theta)
=
\frac{1}{n}
\sum_{(i,j)\in\Omega}
\left(z_i^{[j]}-\widehat z_i(\theta)\right)^2
\begin{aligned}
\hbox{entrada a oculta 1:}&\quad 2\cdot 32+32=96,\\
\hbox{oculta 1 a oculta 2:}&\quad 32\cdot 32+32=1056,\\
\hbox{oculta 2 a salida:}&\quad 32\cdot 1+1=33.
\end{aligned}
\frac{du_\theta}{d\tau}
=
(t_{\max}-t_{\min})\,
r u_\theta(\tau)\left(1-\frac{u_\theta(\tau)}{K}\right).
Sean \(\{\xi_m\}_{m=1}^M\), con \(M=128\), puntos de colocación equiespaciados en \([0,1]\).
\mathcal L_{\mathrm{data}}(\theta)
=
\frac{1}{n}
\sum_{(i,j)\in\Omega}
\left(
\frac{u_\theta(\tau_i)-y_i^{[j]}}{s_y}
\right)^2,
\mathcal L_{\mathrm{init}}(\theta)
=
\frac{1}{J}
\sum_{j=1}^J
\left(
\frac{u_\theta(0)-y_0^{[j]}}{s_y}
\right)^2,
\mathcal L_{\mathrm{phys}}(\theta,r,K)
=
\frac{1}{M}
\sum_{m=1}^M
\left[
\frac{
\dfrac{du_\theta}{d\tau}(\xi_m)
-
(t_{\max}-t_{\min})r u_\theta(\xi_m)
\left(1-\dfrac{u_\theta(\xi_m)}{K}\right)
}{s_y}
\right]^2
La PINN determinista
\mathcal L_{\mathrm{detPINN}}
=
\mathcal \lambda_{\text{data}} L_{\mathrm{data}}
+
\lambda_0\mathcal L_{\mathrm{init}}
+
\lambda_{\mathrm{phys}}\mathcal L_{\mathrm{phys}},
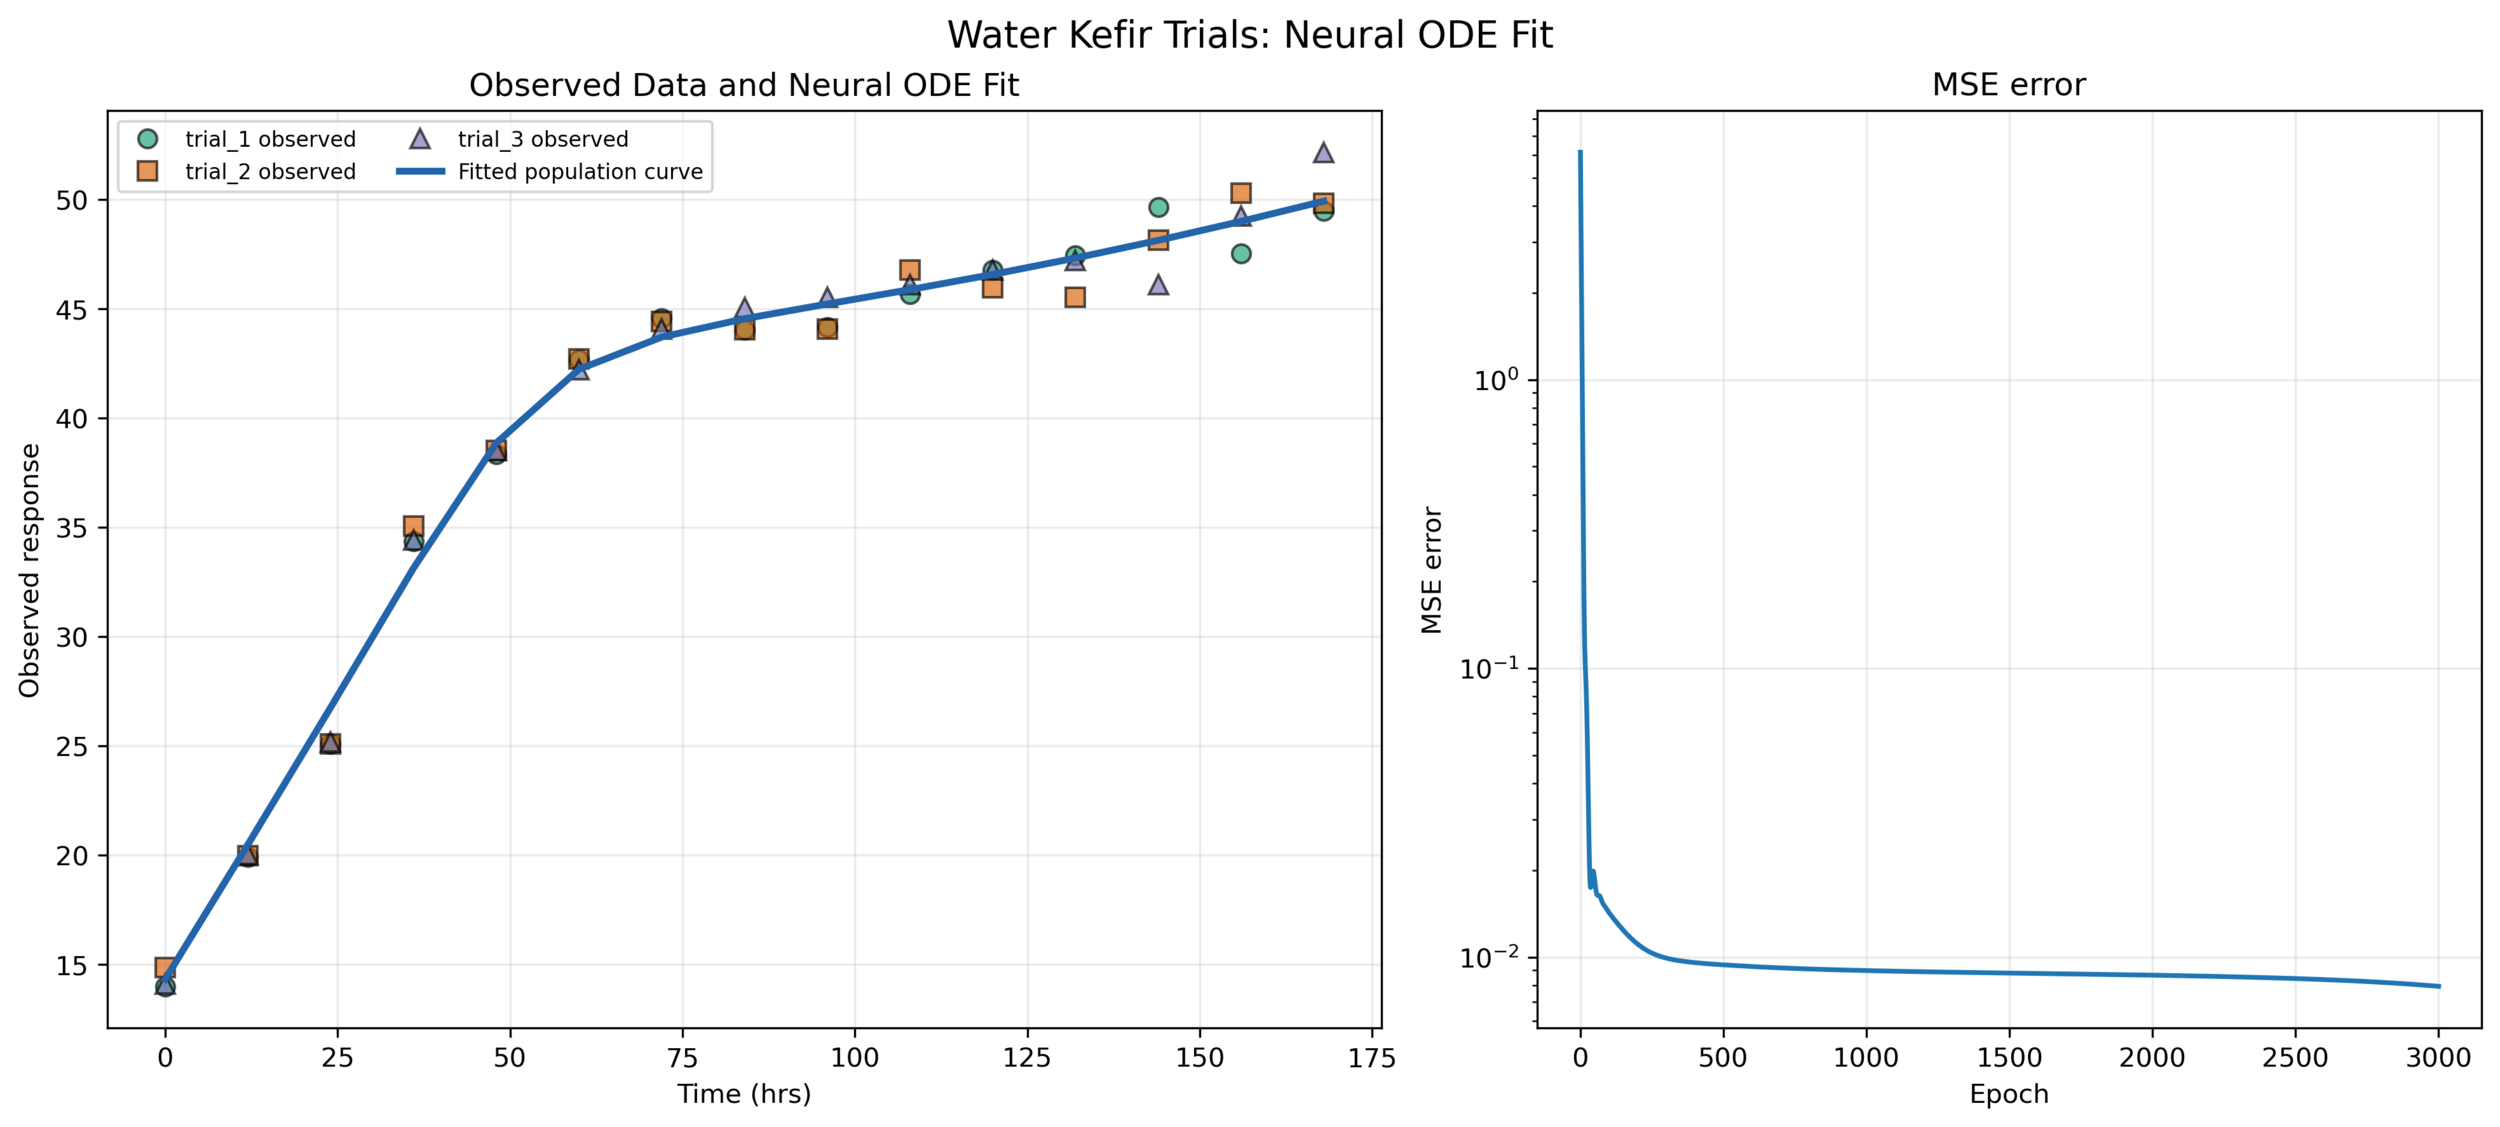
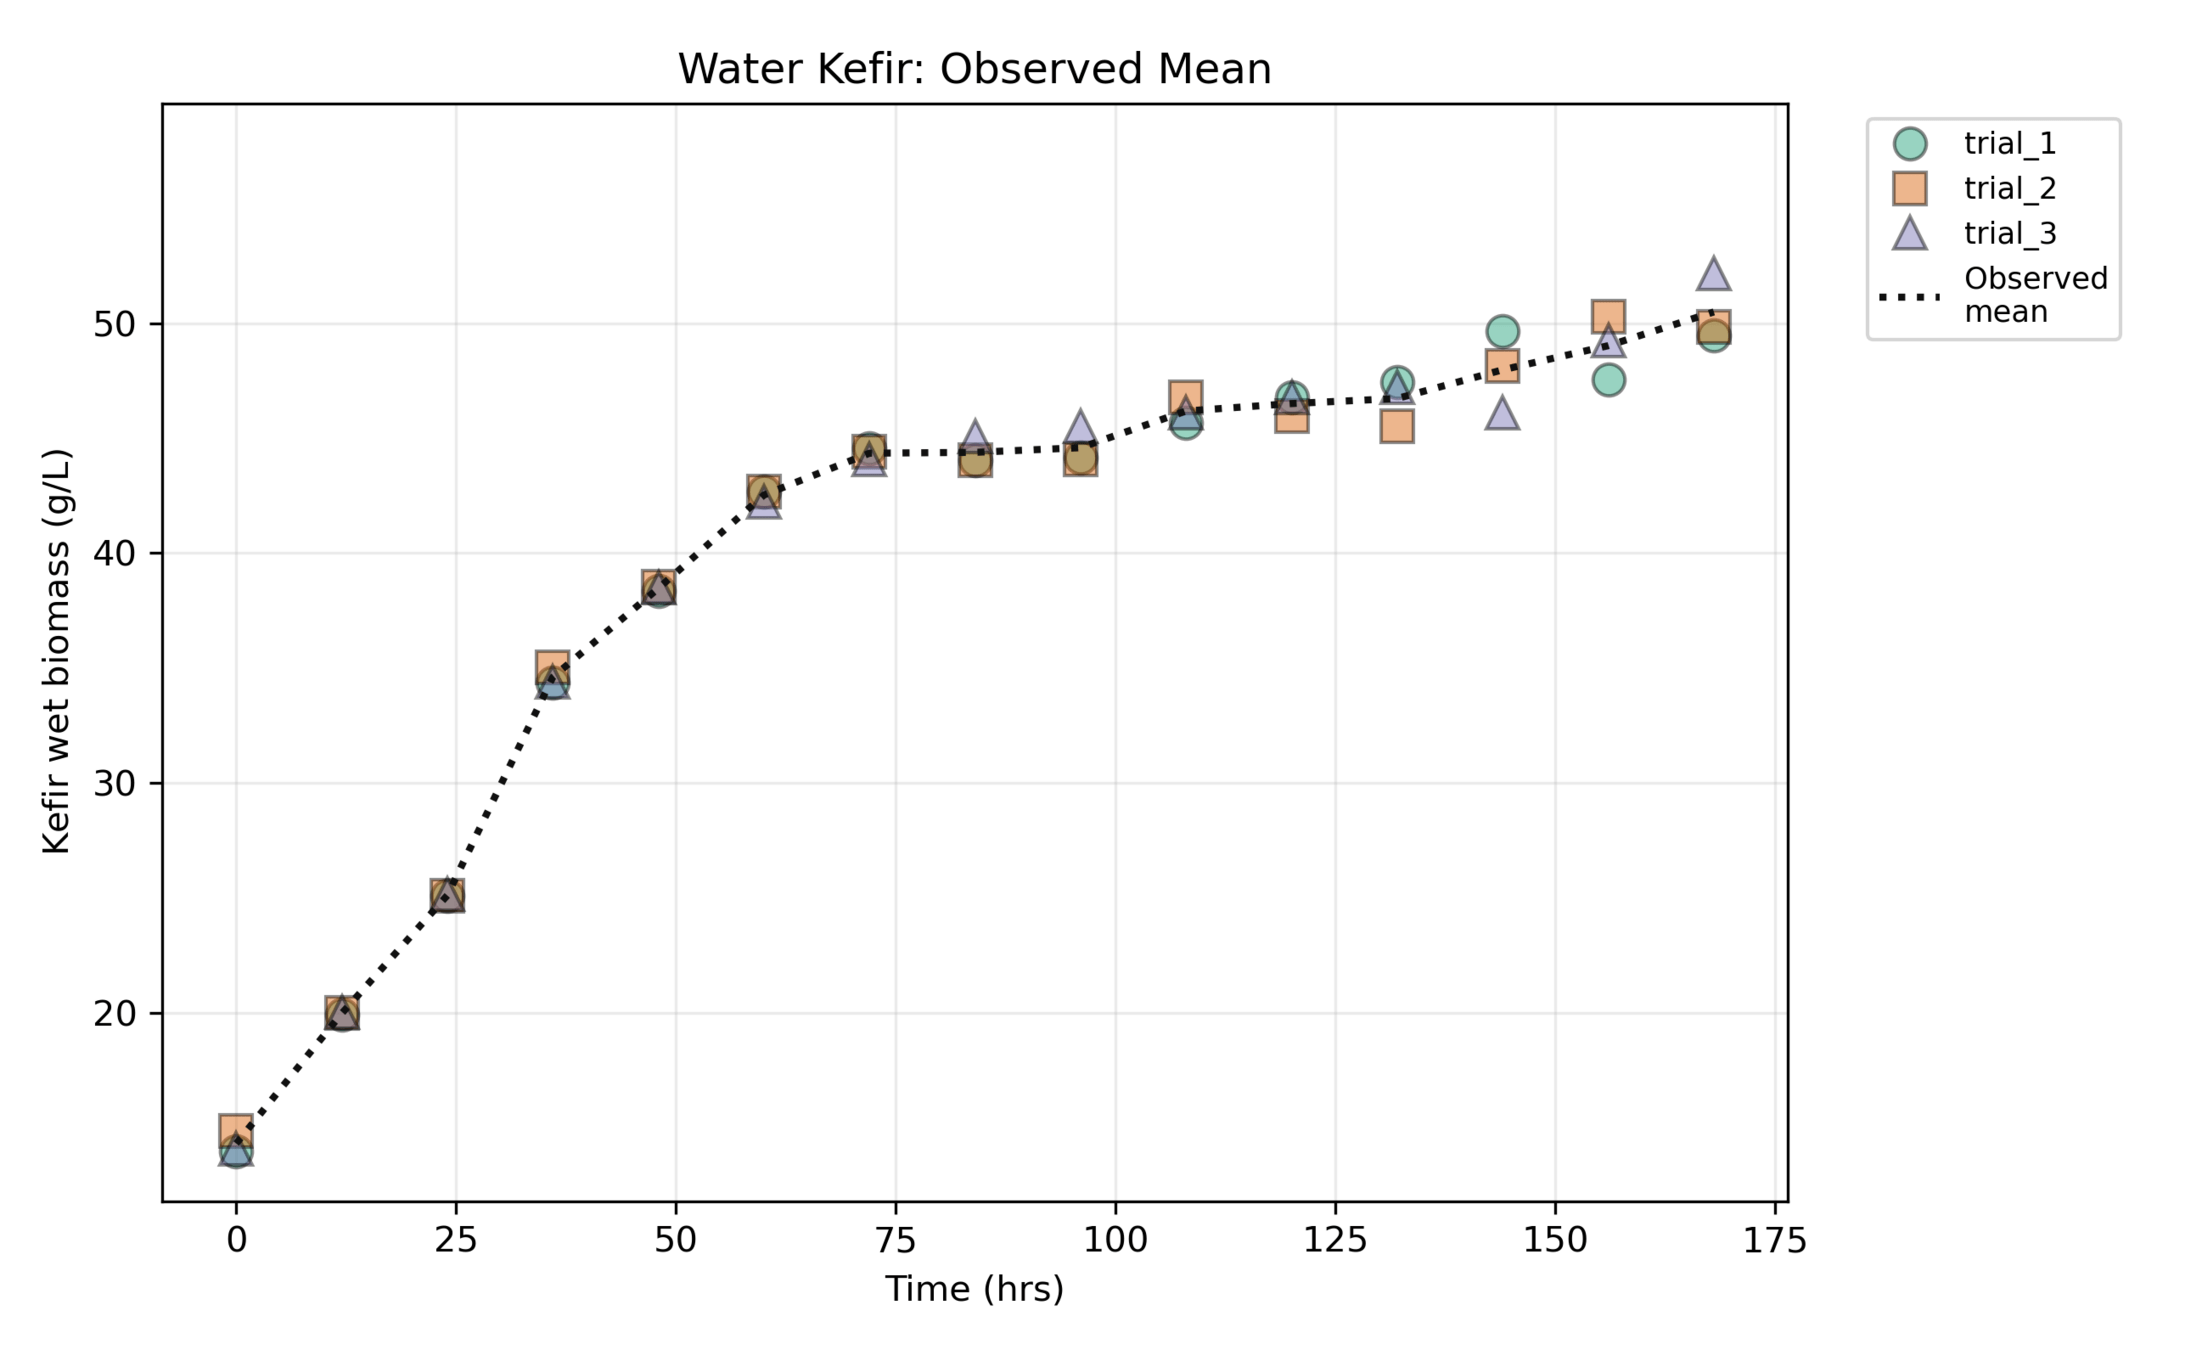
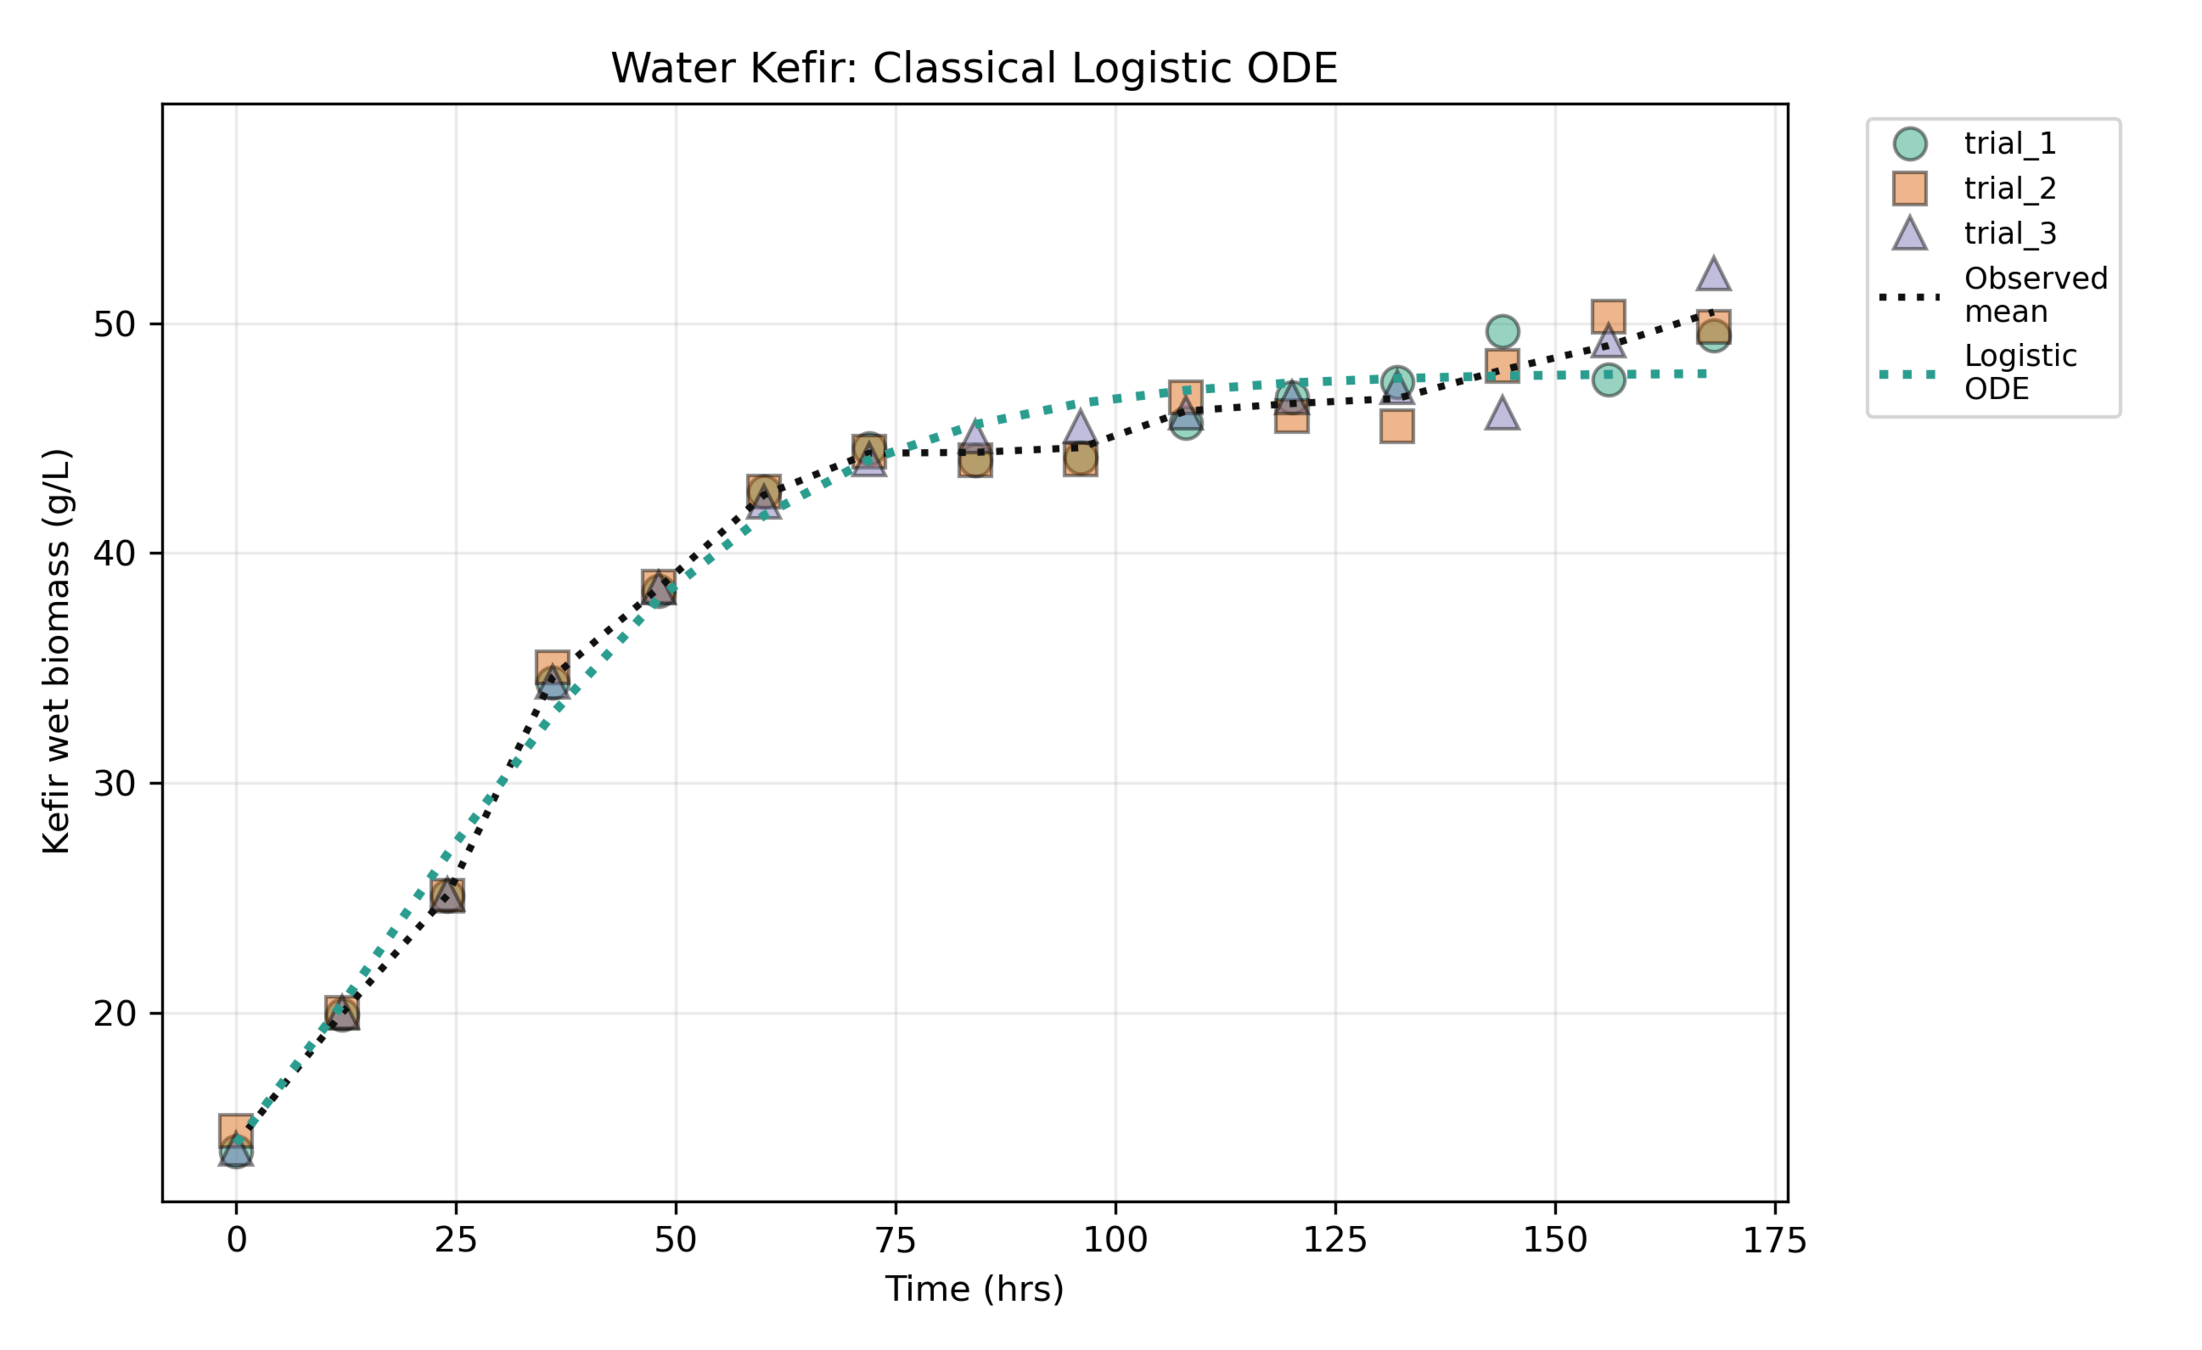
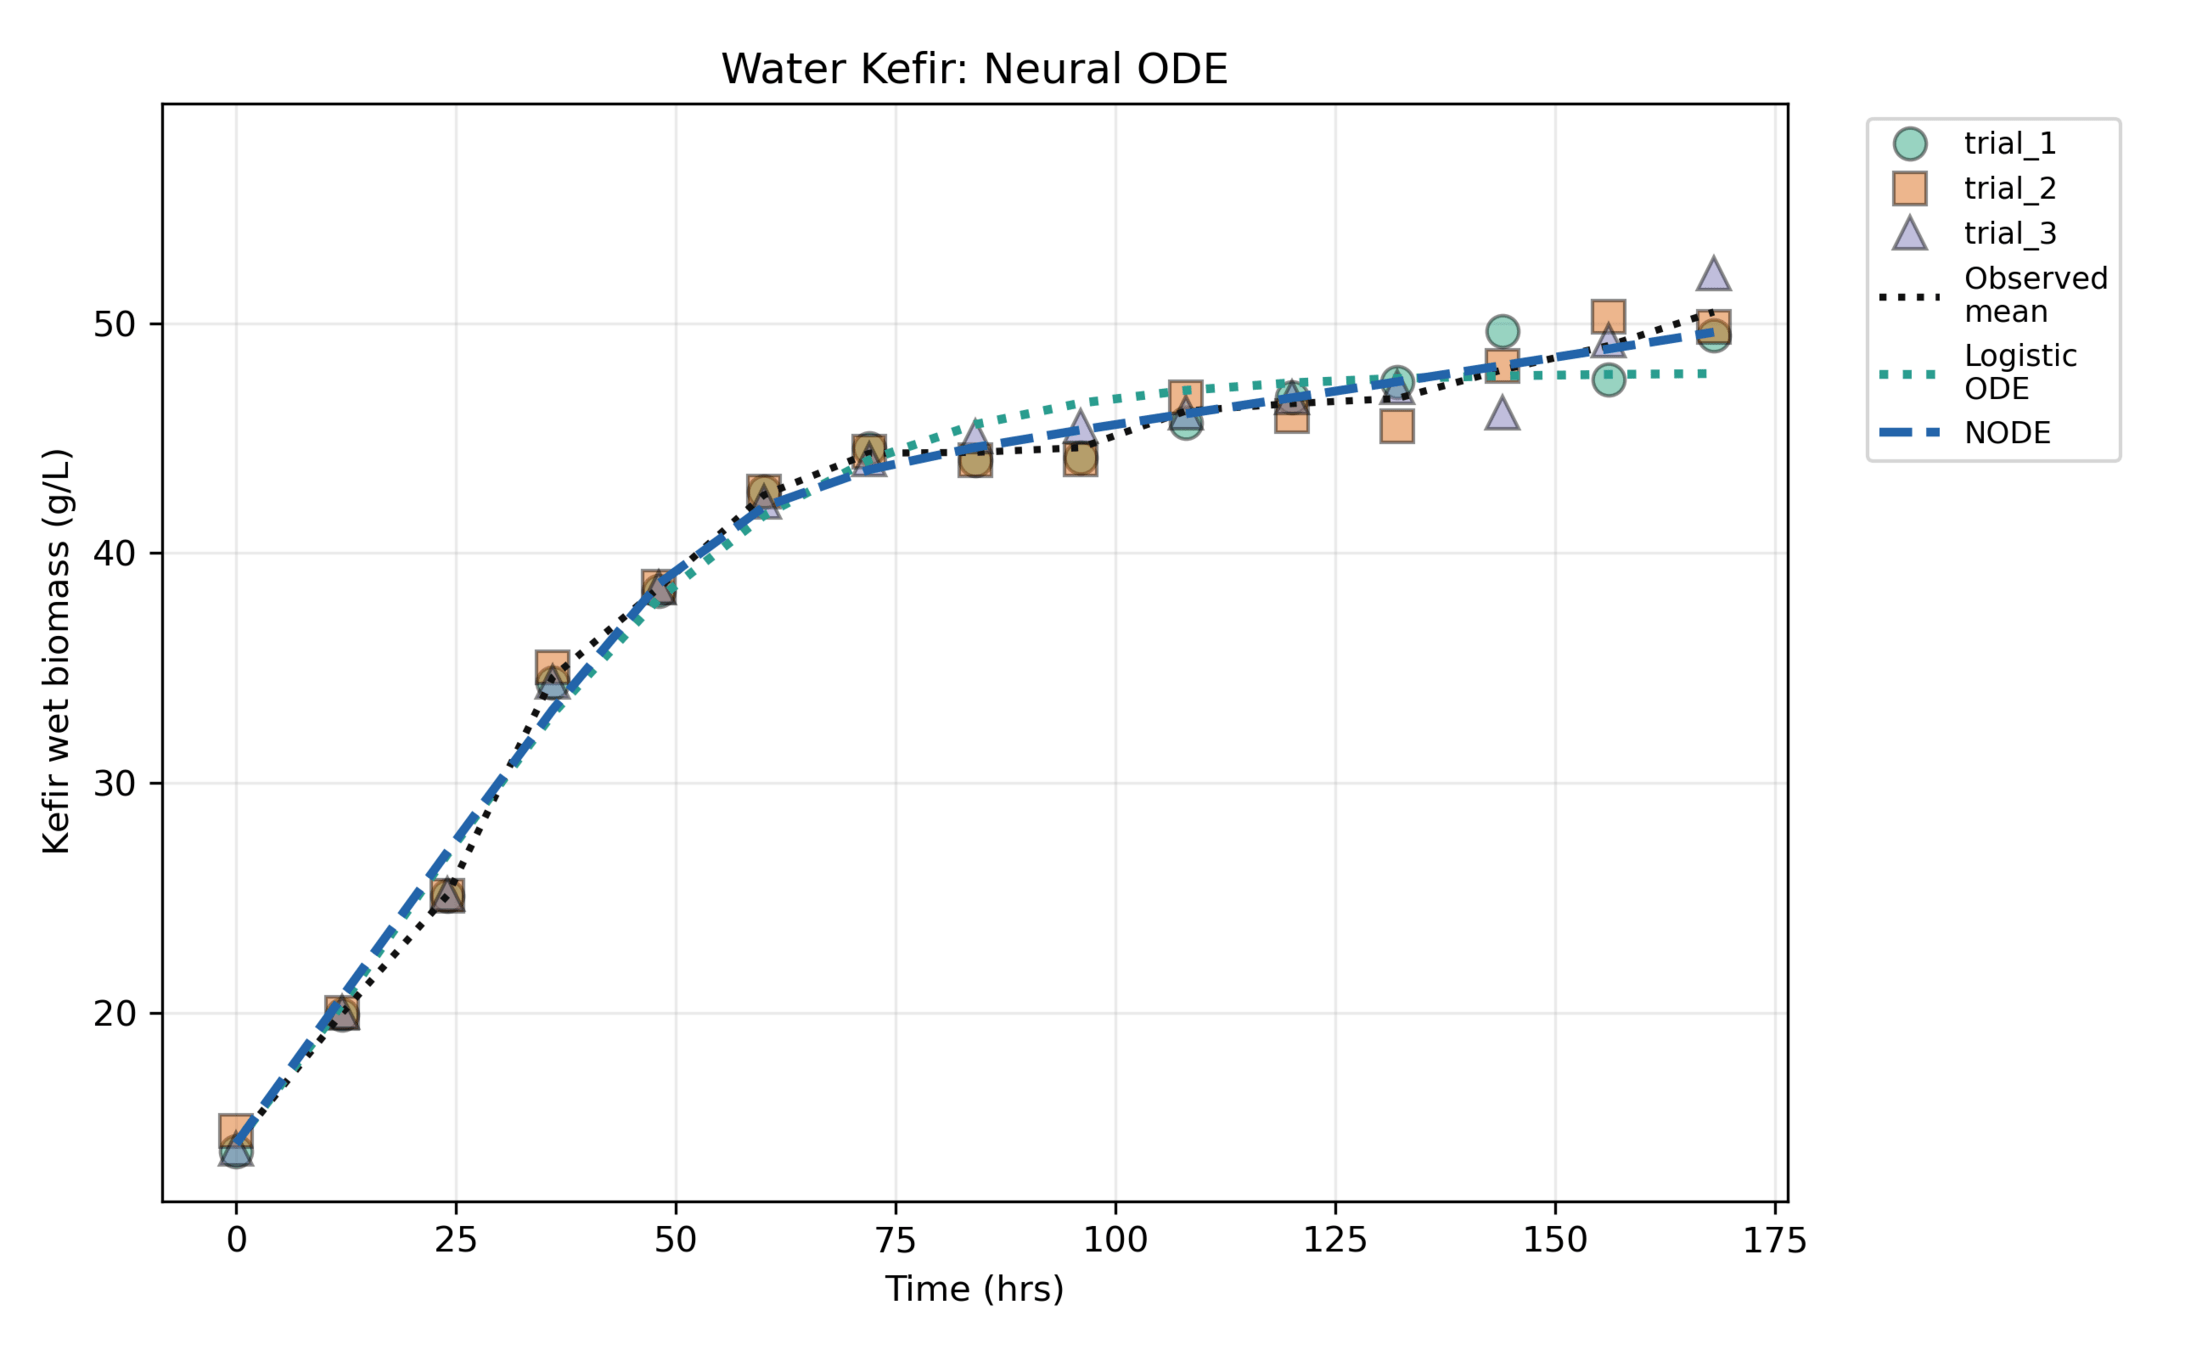
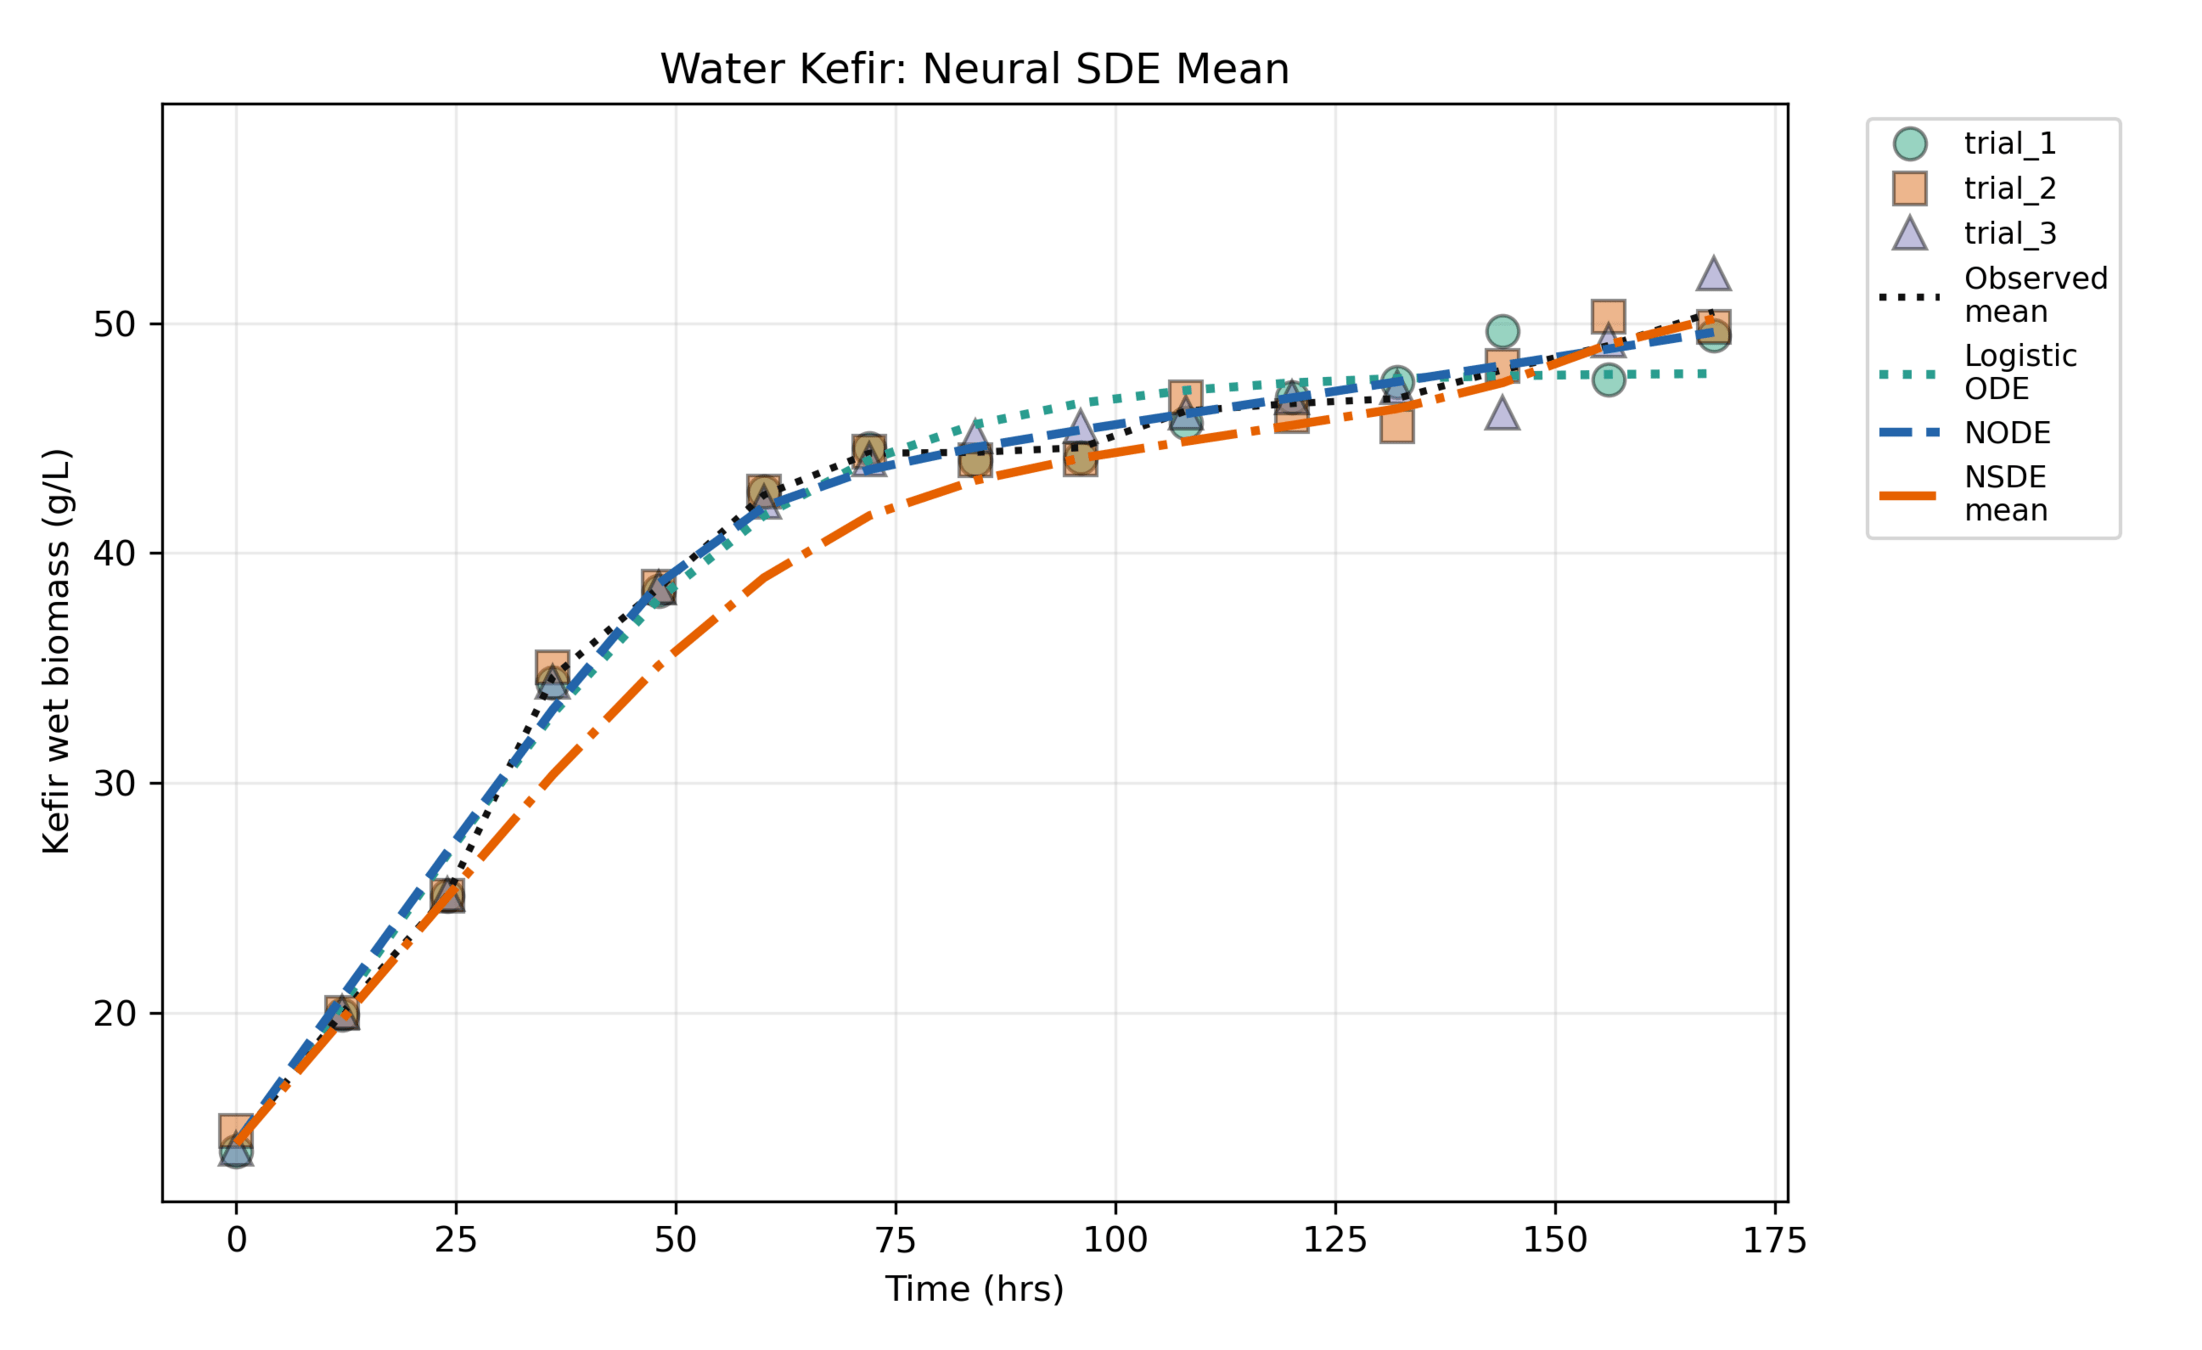
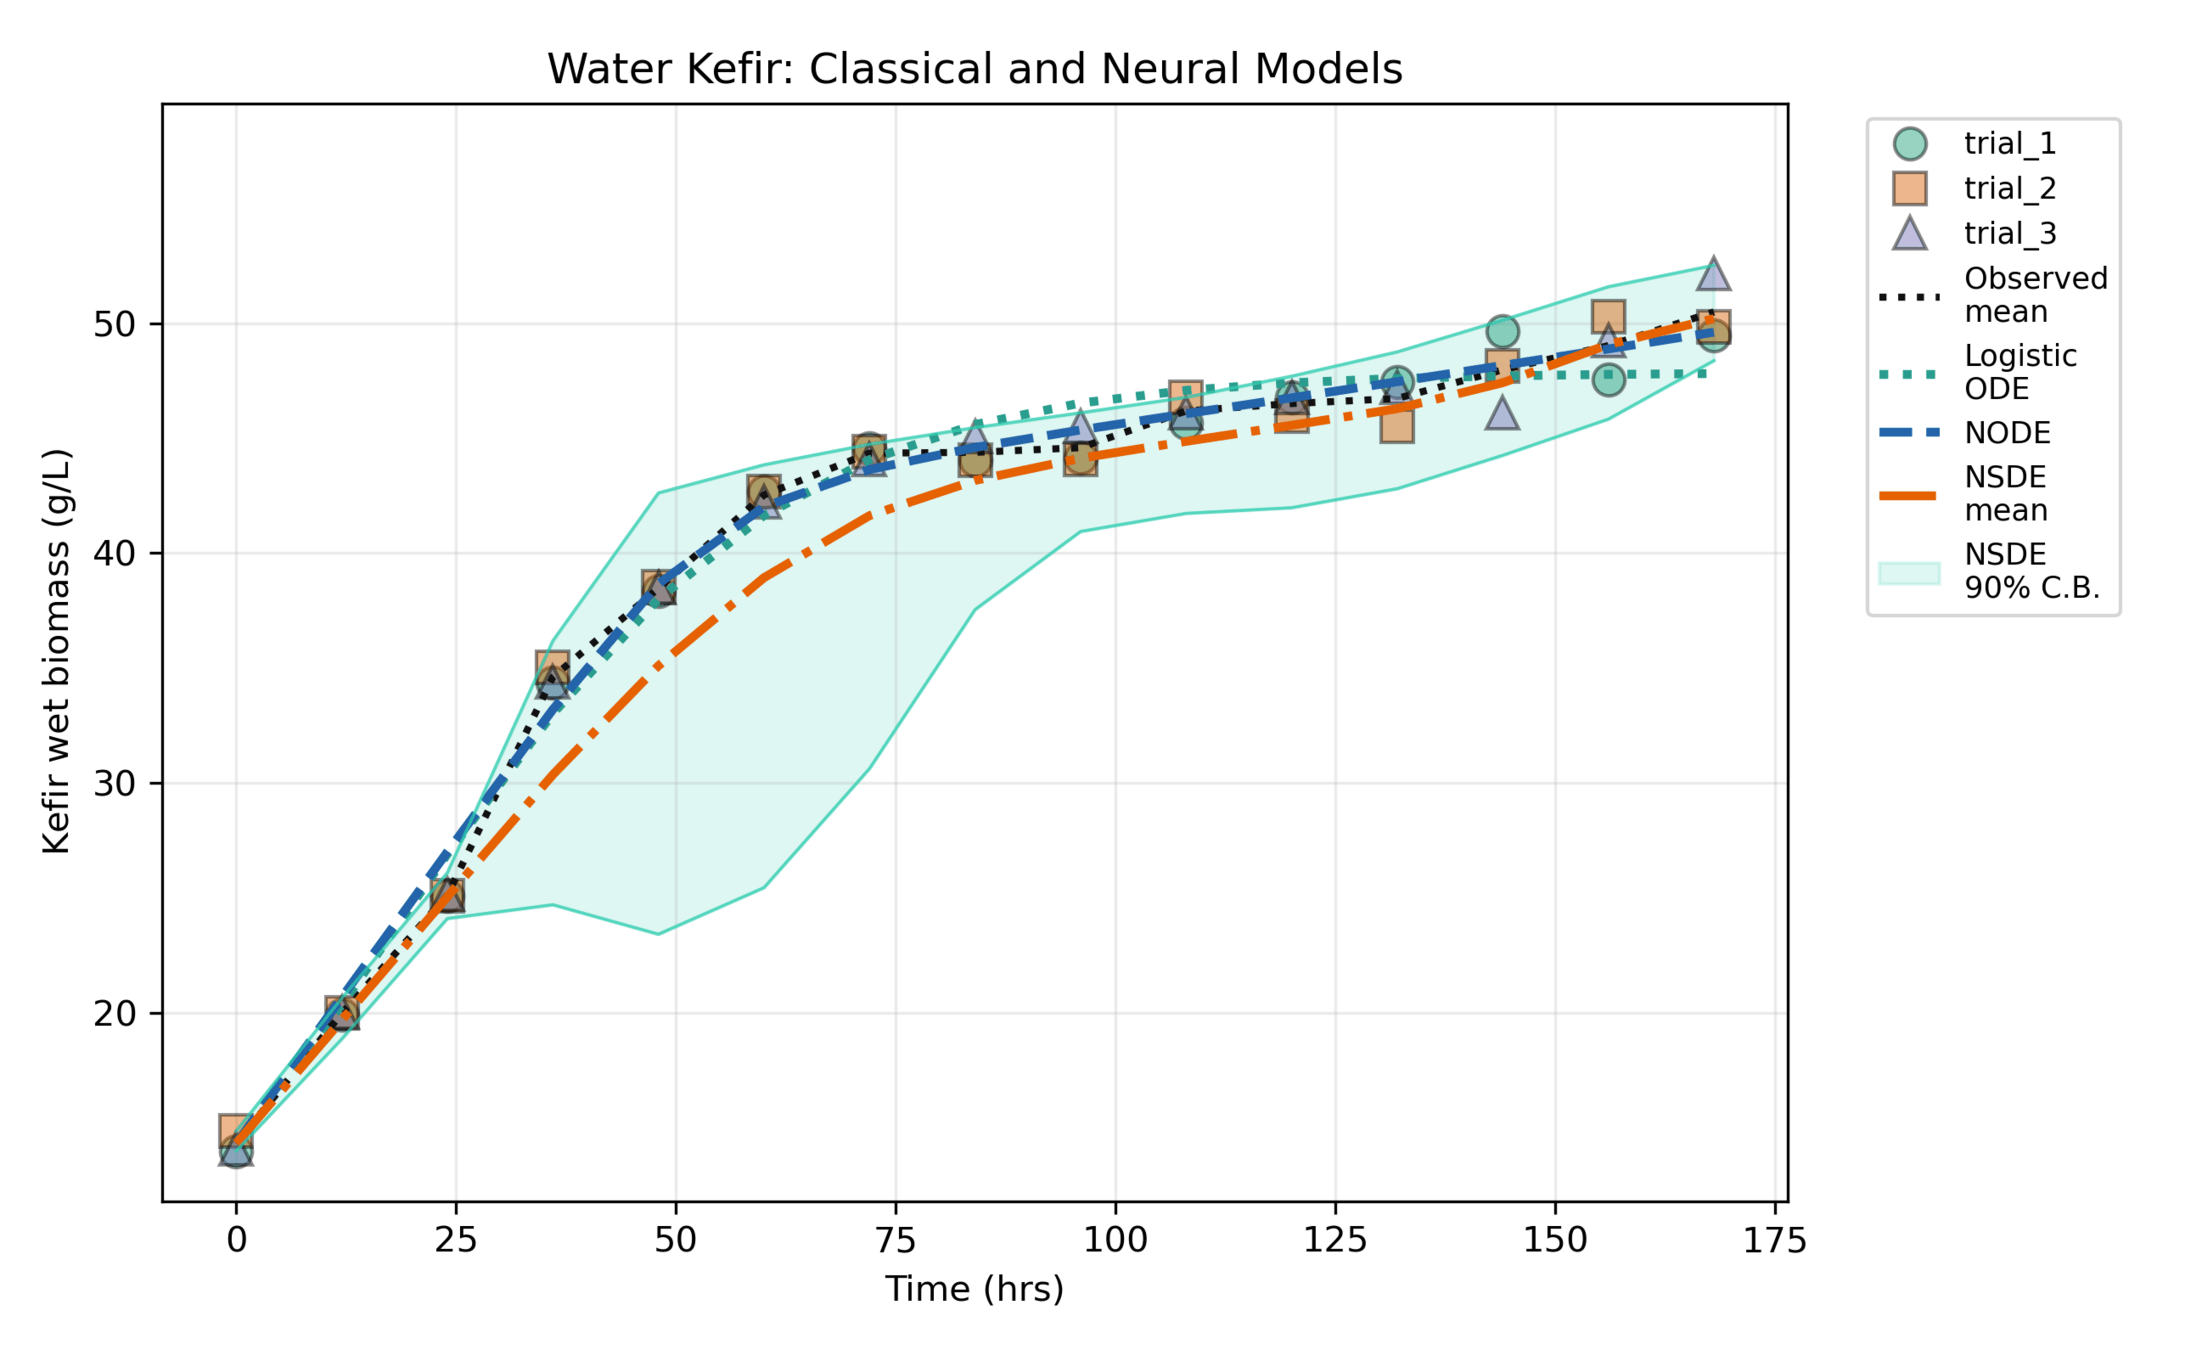
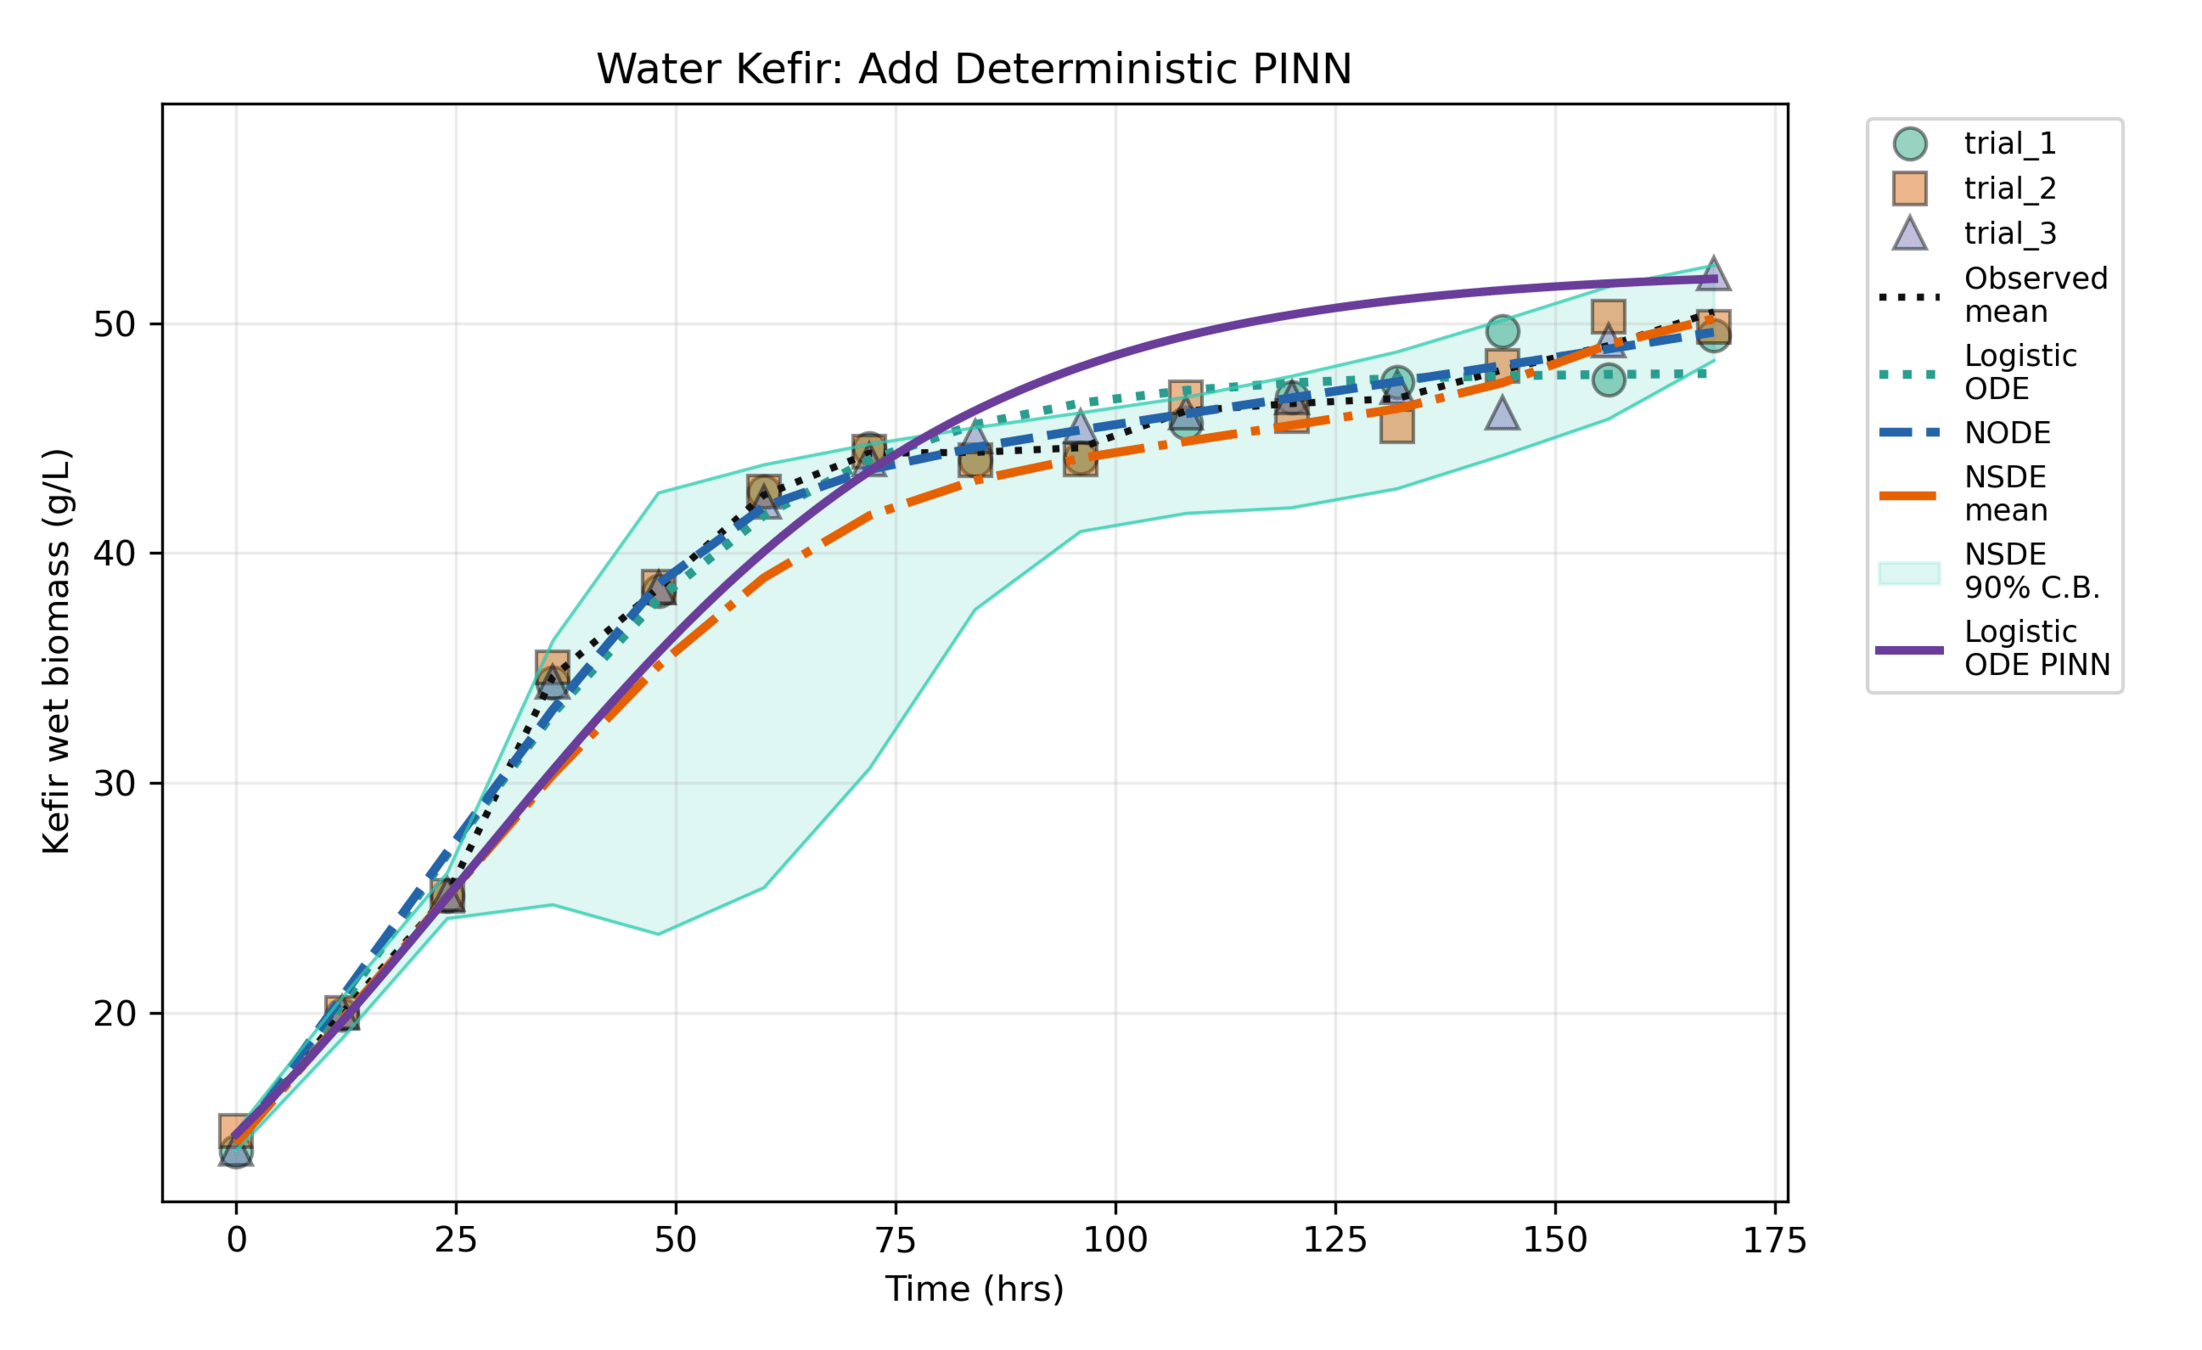
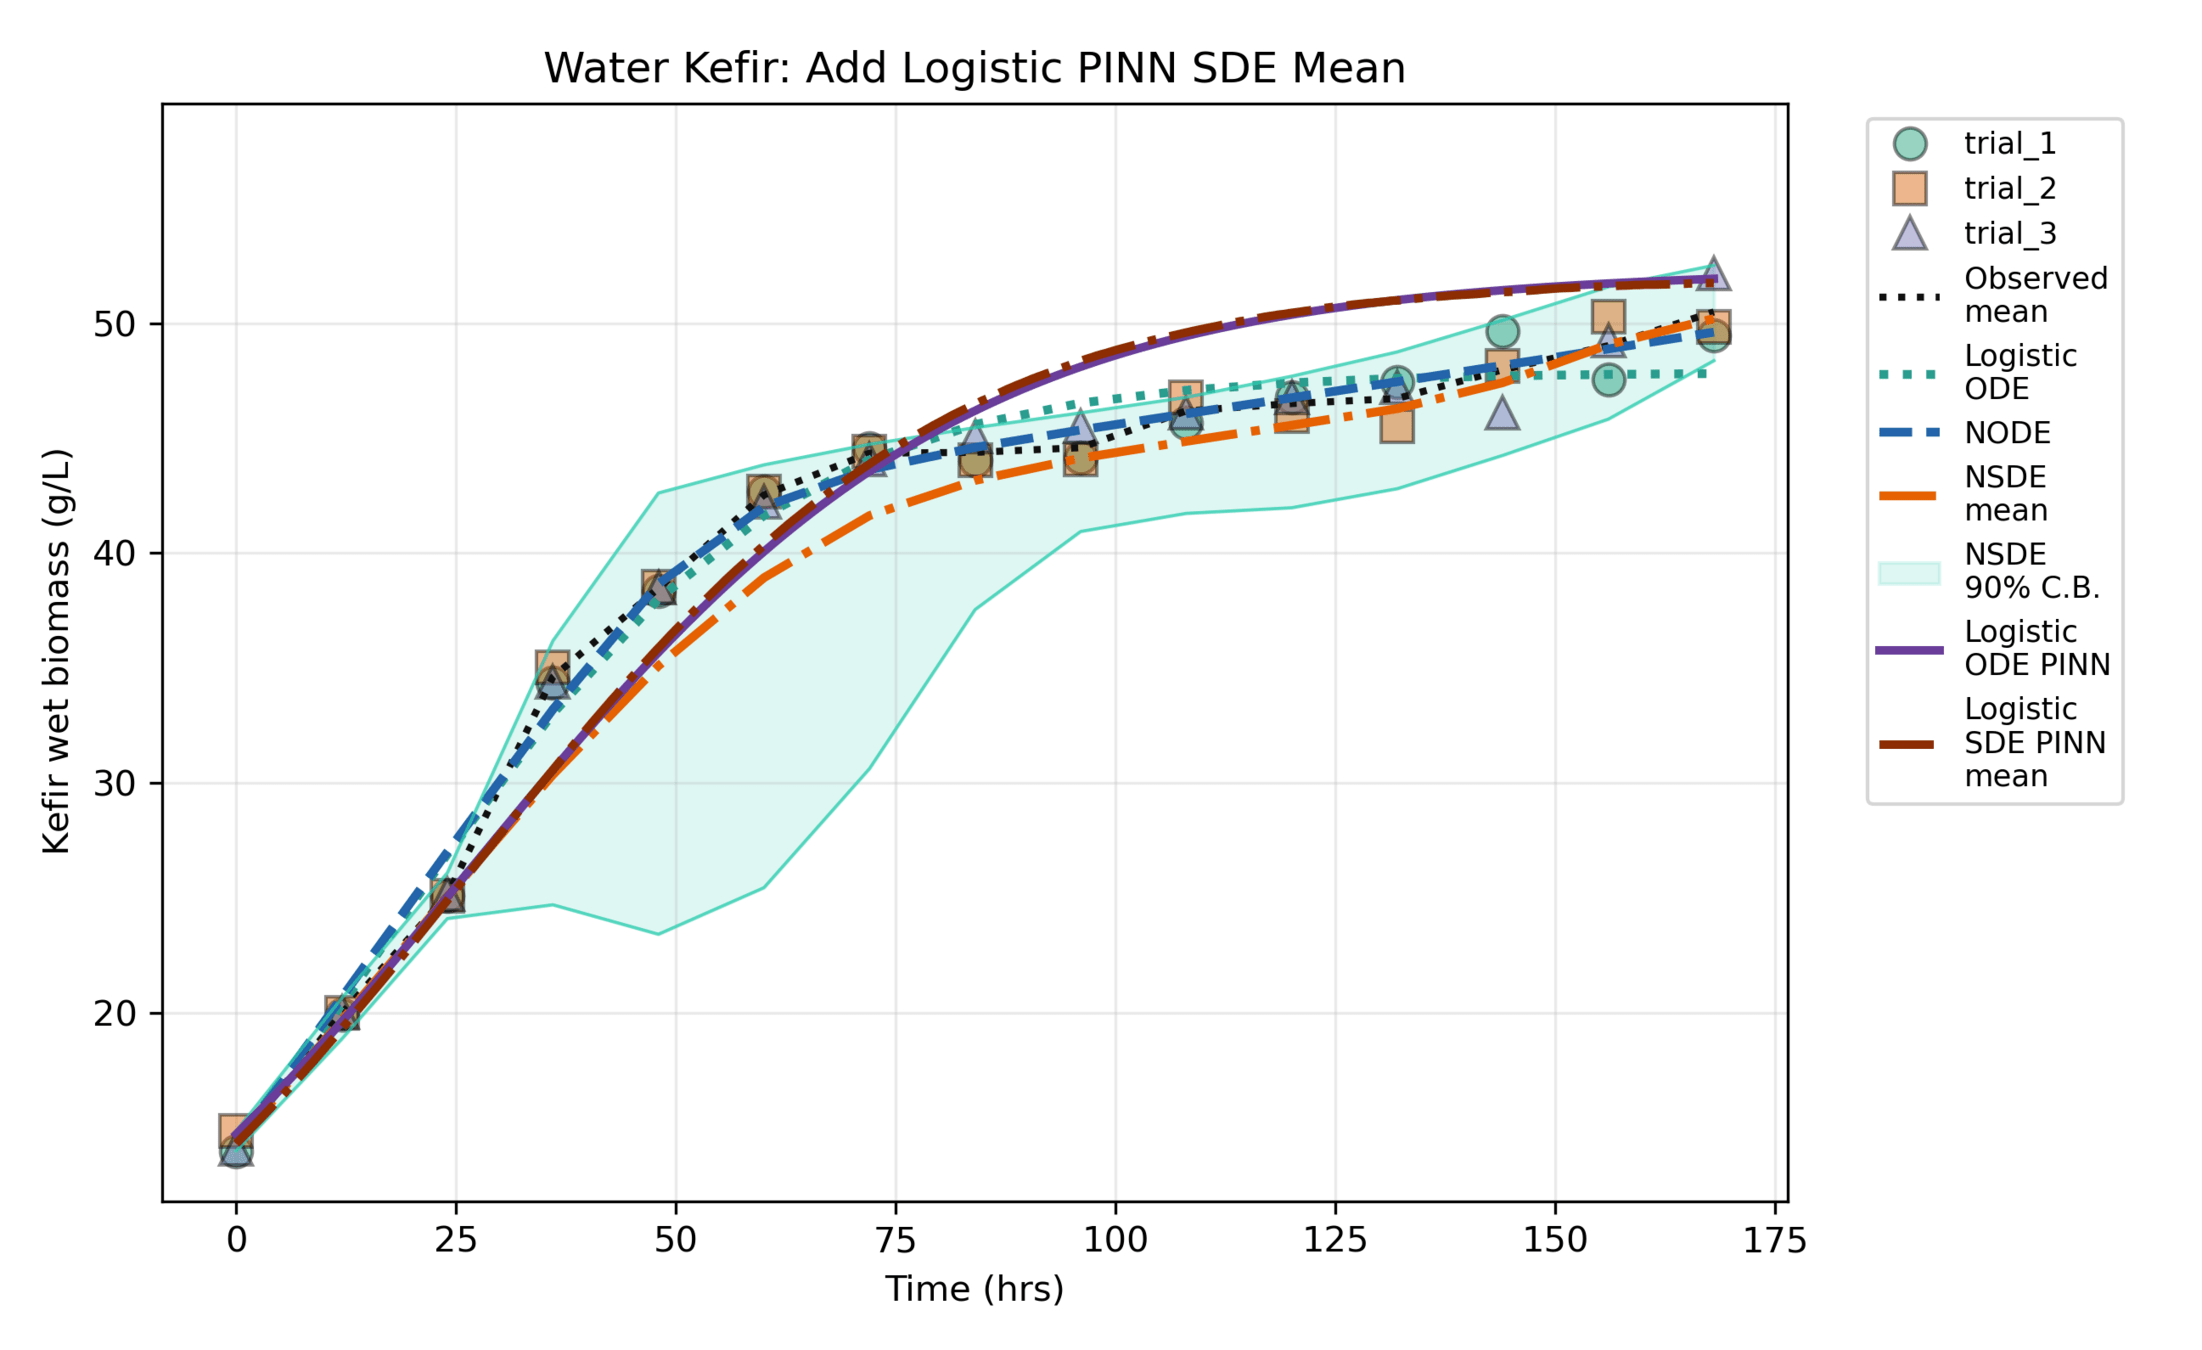
Ajuste de la ODE neuronal
\mathrm{SSE}
=
\sum_{(i,j)\in\Omega}(y_i^{[j]}-\widehat y_i^{[j]})^2,
\qquad
\mathrm{SST}
=
\sum_{(i,j)\in\Omega}(y_i^{[j]}-\bar y)^2.
\mathrm{RMSE}
=
\sqrt{\frac{\mathrm{SSE}}{n}},
R^2
=
1-\frac{\mathrm{SSE}}{\mathrm{SST}}
\widehat\sigma^2 = \frac{\mathrm{SSE}}{n}
\log \widehat L
=
-\frac{n}{2}
\left[
\log(2\pi)+1+\log(\widehat\sigma^2)
\right]
\mathrm{AIC}=2k-2\log\widehat L,
\qquad
\mathrm{BIC}=k\log(n)-2\log\widehat L
Criterios de evaluación
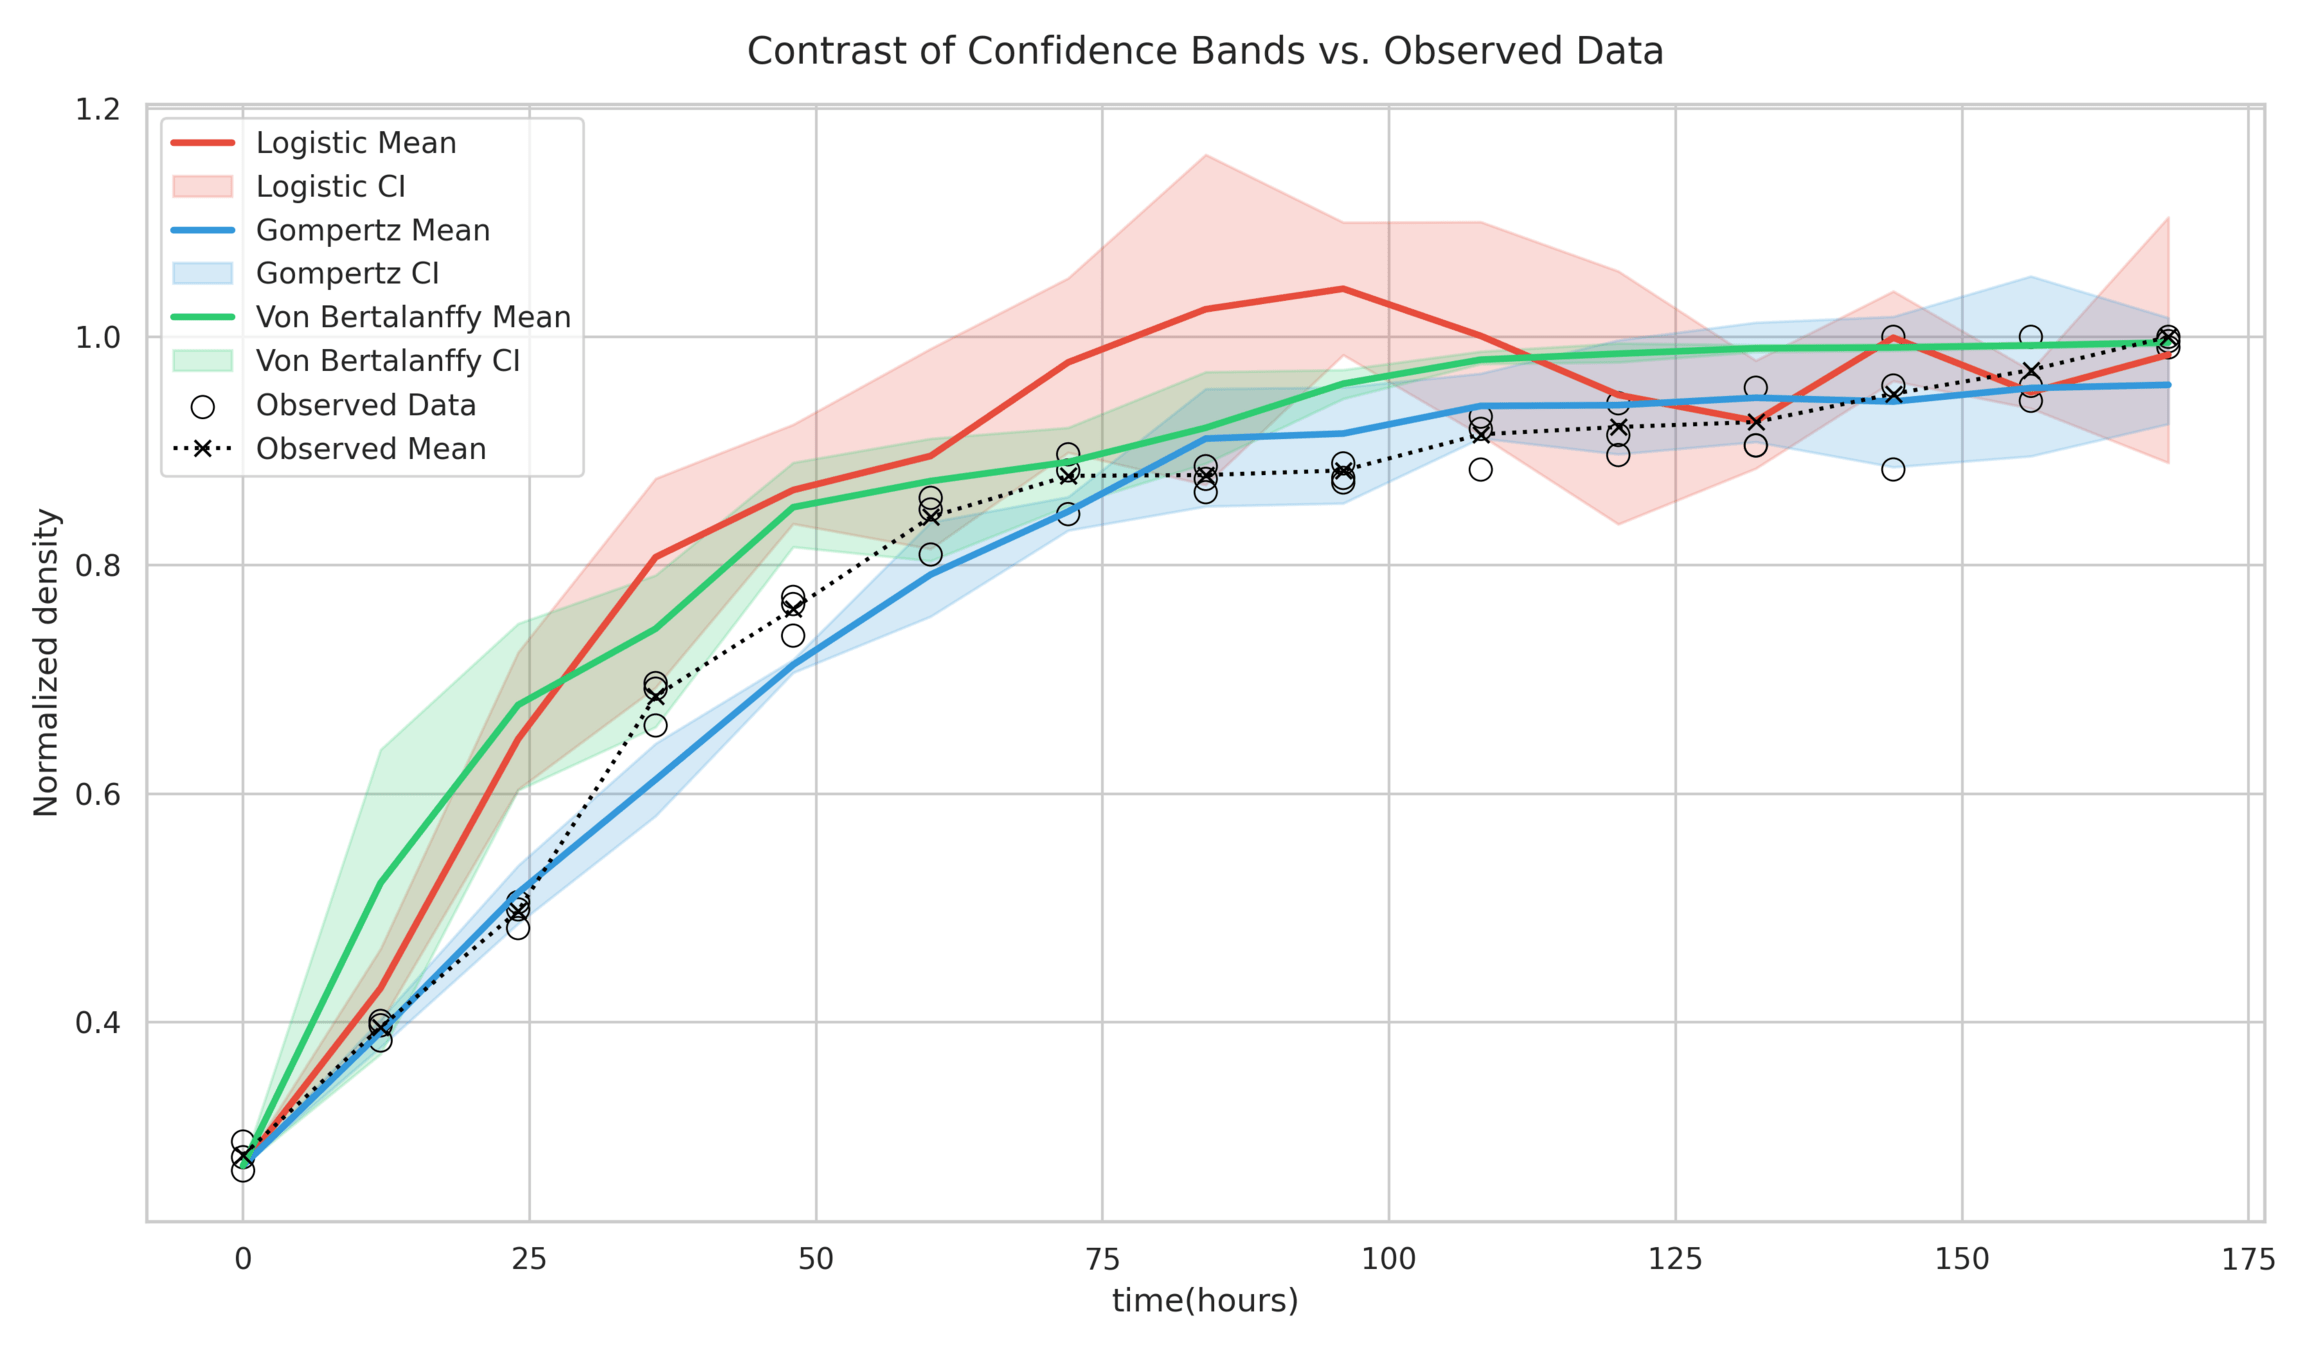
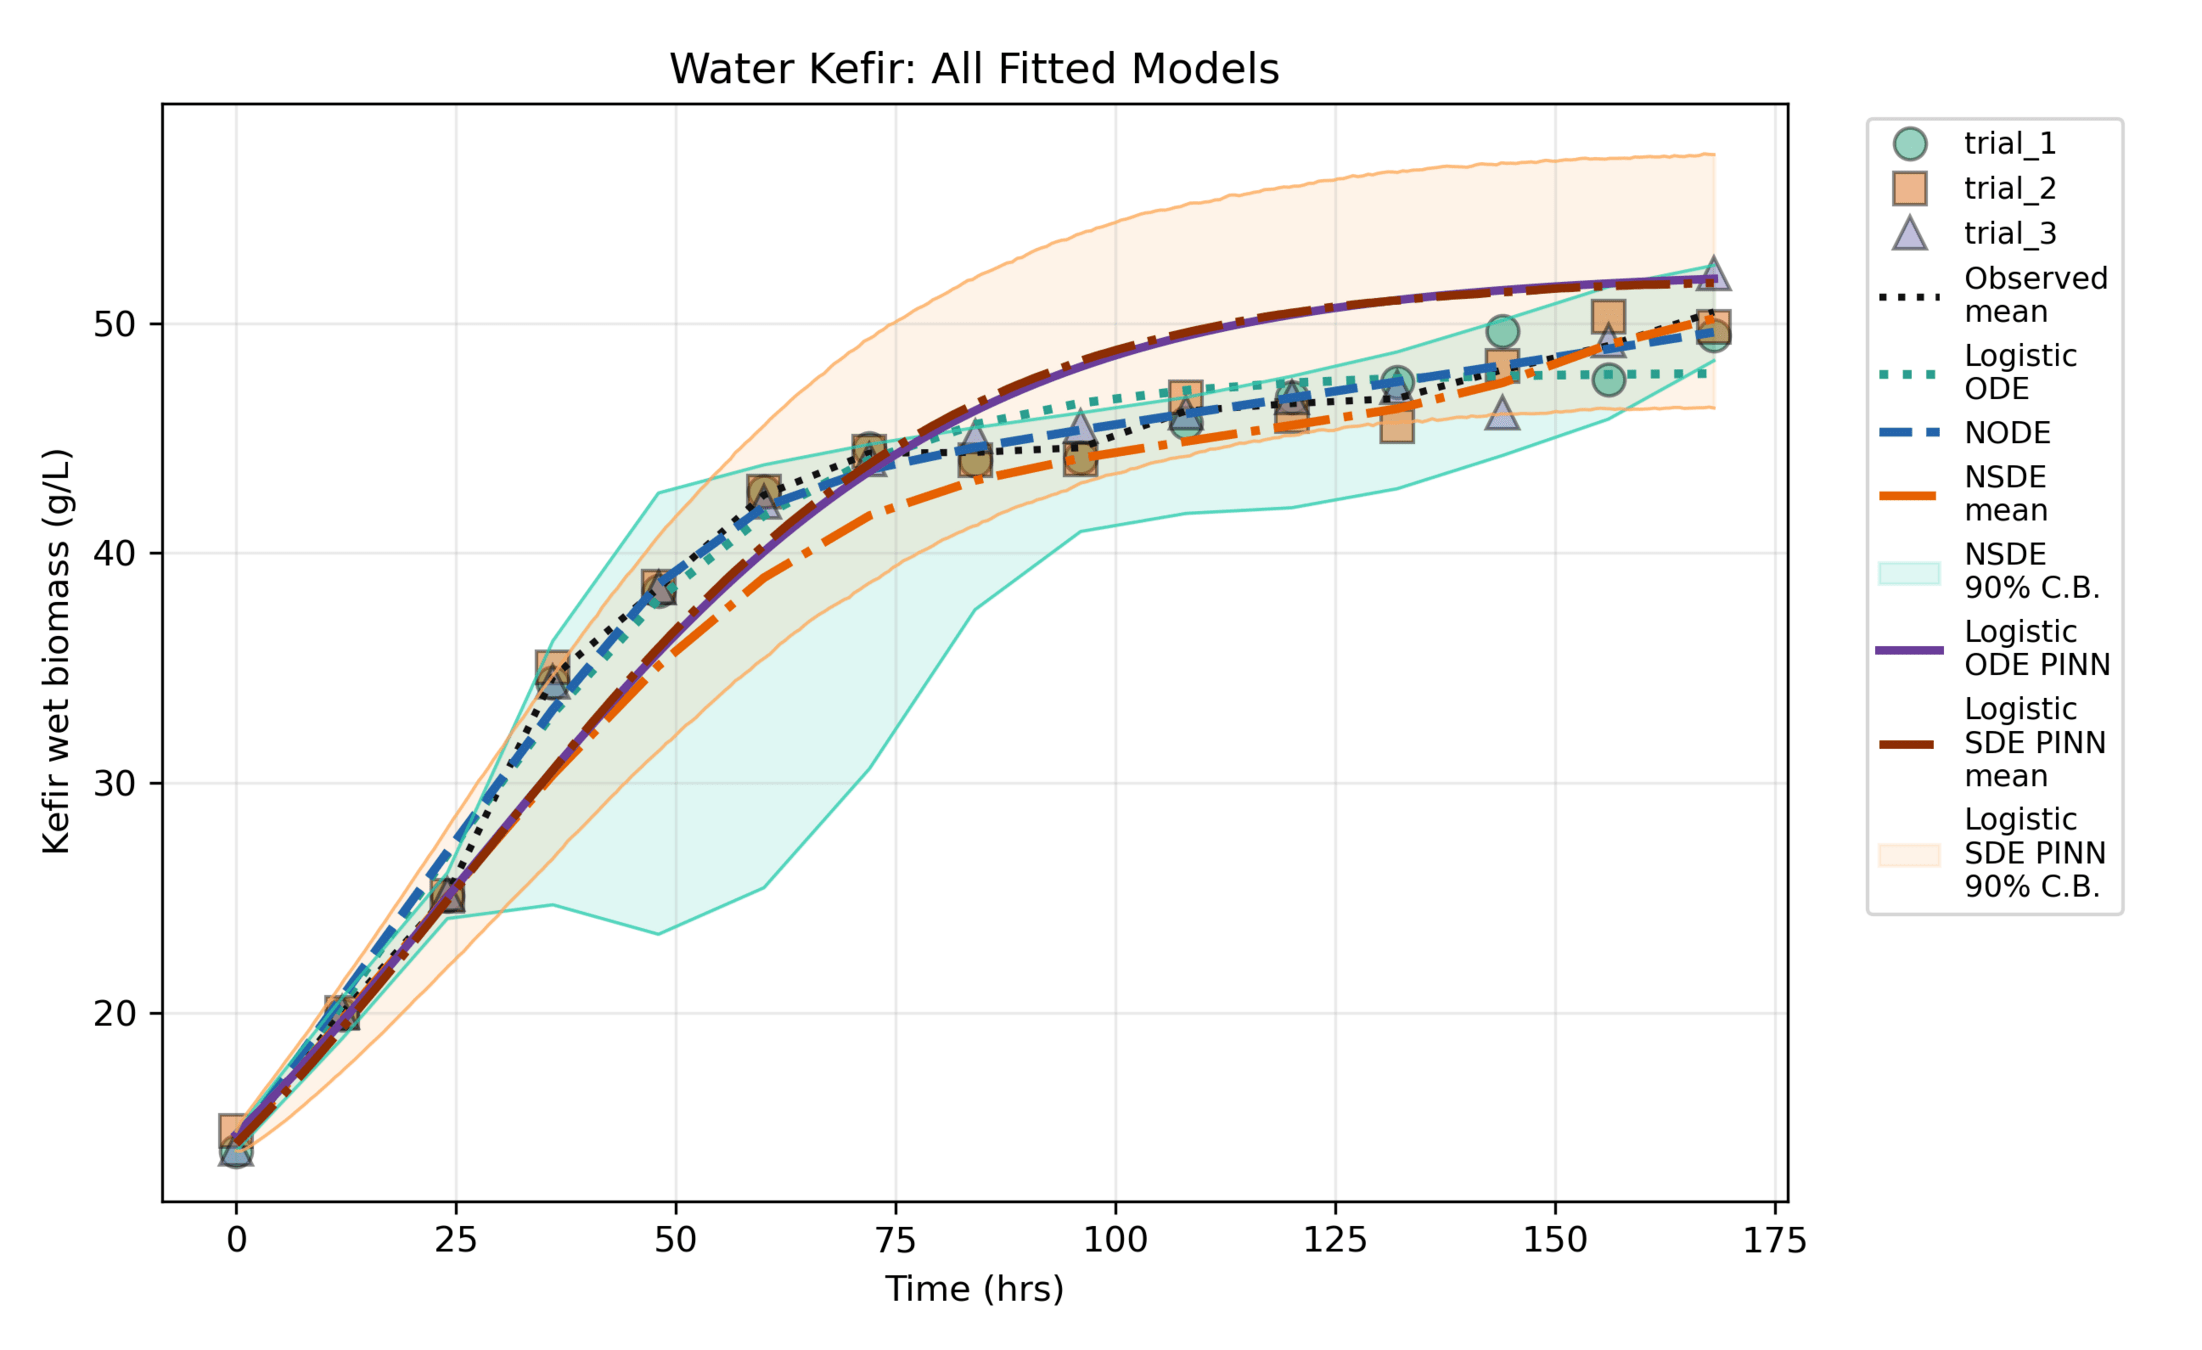
1.Baltazar-Larios, F., Delgado-Vences, F. & Ornelas, A. Parameter estimation and model selection for stochastic differential equations for biological growth. Environ. Ecol. Stat. 32, 195–227 (2025).
arXiv:2301.08294
2.Baltazar-Larios, F., Delgado-Vences, F., Diaz-Infante, S. & Gomez, E. L. Statistical inference for a stochastic generalized logistic differential equation. Commun. Nonlinear Sci. Numer. Simul. 108261 (2024) doi:10.1016/j.cnsns.2024.108261.
arXiv:2405.03815
3.Baltazar-Larios, F., Delgado-Vences, F. & Diaz-Infante, S. Maximum likelihood estimation for a stochastic SEIR system with a COVID-19 application. Int J Comput Math 1–23 (2022) doi:10.1080/00207160.2022.2148316.
Idea principal del artículo
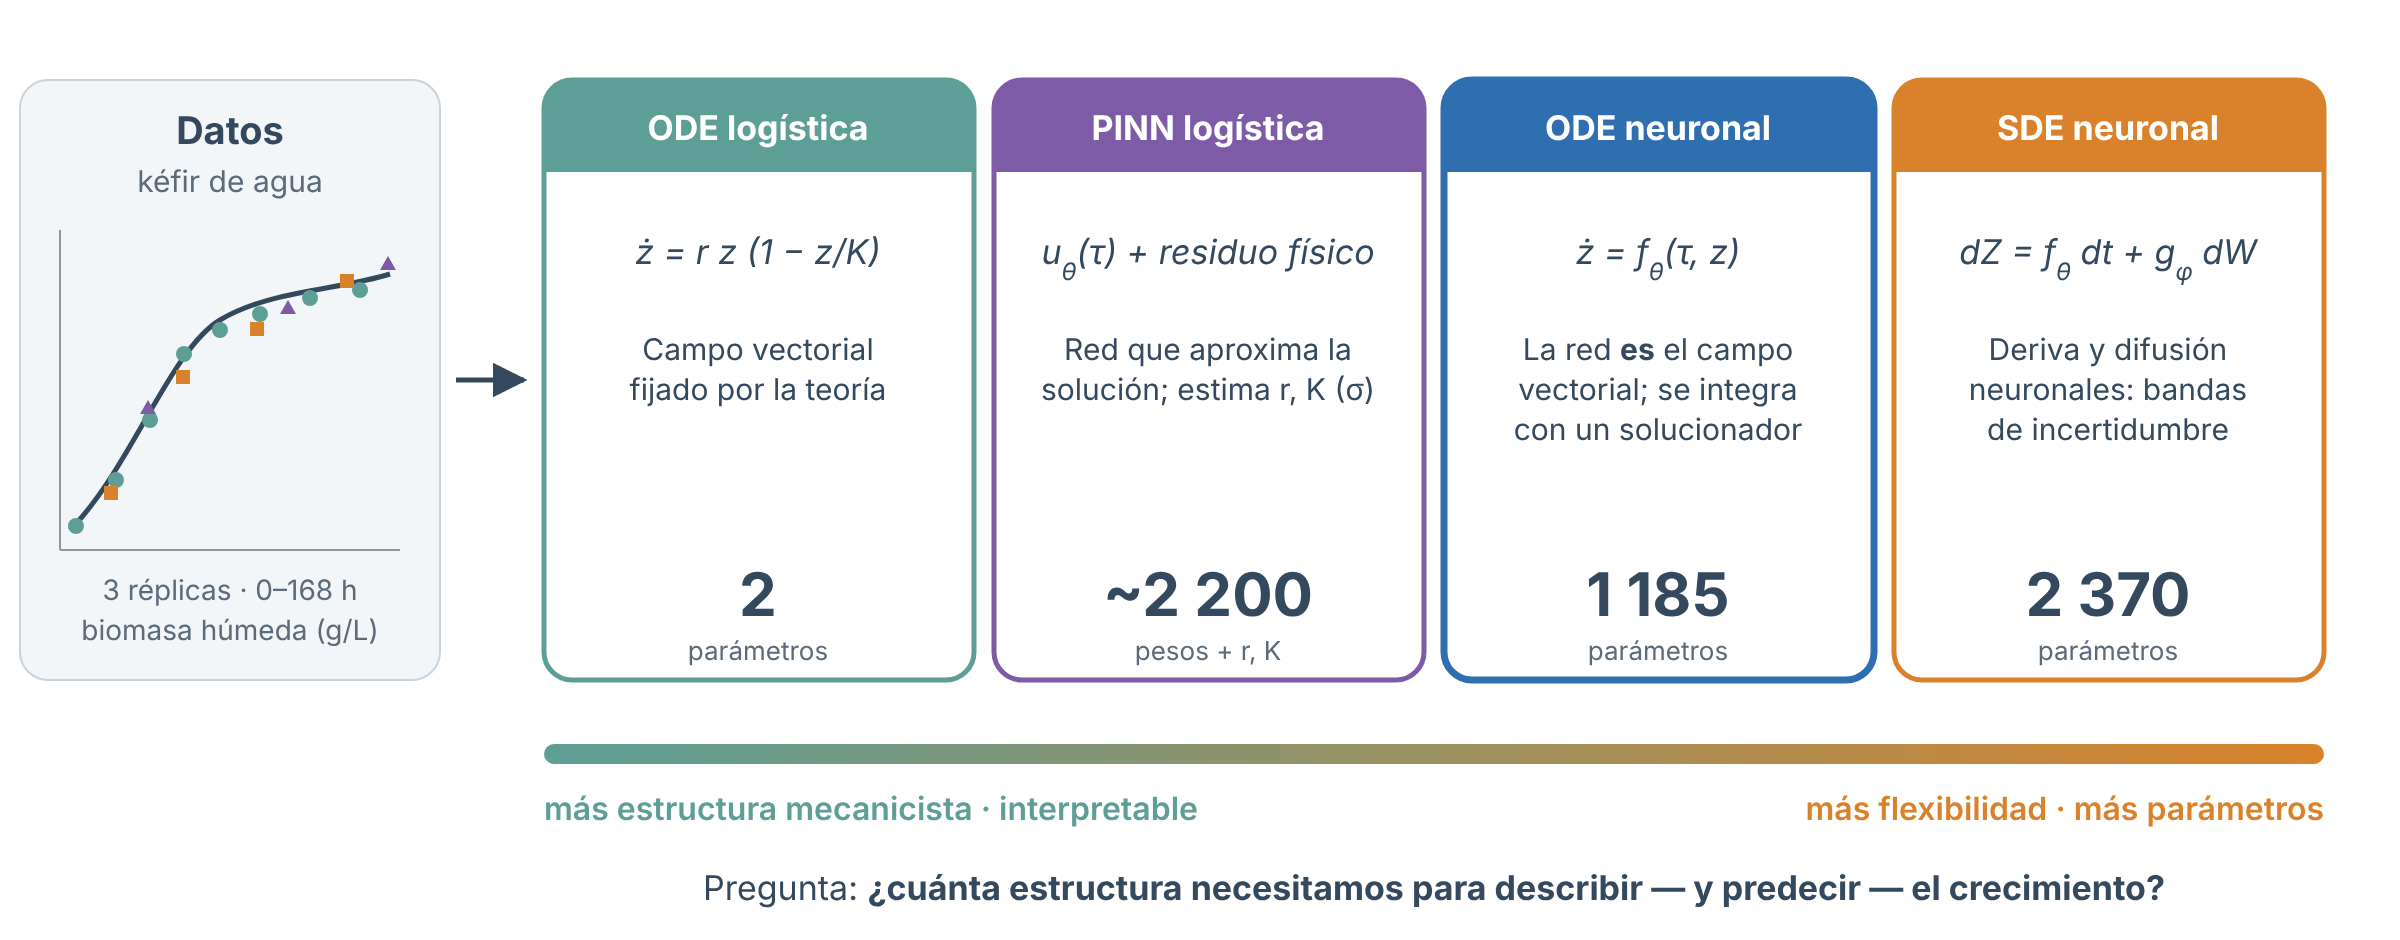
Comparamos cuatro formas de modelar el crecimiento del kéfir de agua —de la ODE logística a las ODE/SDE neuronales— para medir qué se gana y qué se pierde al sustituir la estructura mecanicista por redes neuronales: precisión, parsimonia, incertidumbre e interpretabilidad.
Avance del artículo
✓ Logrado
- Cuatro familias de modelos implementadas y ajustadas a 3 réplicas (repositorio kefir-models).
- ODE neuronal: mejor ajuste en muestra (RMSE 1.03, R² 0.991).
- SDE neuronal: mejor cobertura del intervalo de 90 % (93 %, anchura media 7.4).
- PINN logística: recupera r ≈ 0.035 h⁻¹ y K ≈ 52.3 g/L; la versión estocástica estima σ ≈ 0.017.
⚠ Limitaciones
- 1 185 parámetros frente a 2: AIC/BIC favorecen la logística (166 vs 2 502).
- Solo 3 réplicas y ~15 tiempos: riesgo de sobreajuste; las métricas son en muestra.
- fθ(τ, z) depende del tiempo: el modelo no es autónomo y no extrapola fuera de 0–168 h.
- Los pesos de la red no tienen interpretación biológica directa.
→ Pendiente
- NODE autónoma y compacta: fθ(z) con 16 neuronas por capa (~320 parámetros).
- Modelo híbrido (UDE): término logístico + corrección neuronal NNφ(z).
- Validación cruzada dejando una réplica fuera; error de predicción fuera de muestra.
- Extender a los tratamientos con ultrasonido: ¿cómo cambian r y K?
Presentación y código
Presentación SMM 2026
Repositorio kefir-models
Declaración de uso de IA
Diligencia, marco 4D de fluidez en IA
Herramientas: Claude Opus 5.5 (Anthropic), Codex con GPT-5.6 Luna (OpenAI) y Gemini 3.5 Flash (desarrollado por Google).
Uso: apoyo en redacción y traducción, edición de fórmulas en LaTeX, diseño de diapositivas y desarrollo del código y figuras del repositorio kefir-models.
Creación: el planteamiento, los modelos, la metodología y las conclusiones son del autor. Todas las derivaciones, resultados y código generados con IA fueron revisados, corregidos y verificados por el autor.
Transparencia: se declara aquí el uso de IA. El código y su historial son públicos en el repositorio para su revisión y reproducción.
Despliegue: el autor asume la responsabilidad total por la exactitud, la integridad y el uso de este material.
59 Congreso Nacional de la Sociedad Matemática Mexicana:SCD
By Saul Diaz Infante Velasco