L’un des défis fréquemment rencontré au sein d'un SI est de pouvoir assurer une transmission sans faille et un traitement rapide et efficace des flux de données.
Apache kafka késaco ?
-
Crée en 2009 par .
-
Un système de messagerie de publication-abonnement distribué.
-
Une file d'attente robuste qui peut gérer un volume élevé de données et vous permet de transmettre des messages d'un point final à un autre.

Pourquoi utiliser Kafka ?
- Reliability (Fiabilité) : un système distribué, partitionné, répliqué et ayant une tolérance aux pannes.
- Scalability: il scale rapidement sans temps d'arrêt.
- Durability: les messages persistent sur le disque aussi longtemps que possible (7jours par défaut).
- Performance: un débit élevé pour la publication et l'abonnement de messages. Il maintient des performances stables, même de nombreux To de messages sont stockés.
Kafka use cases
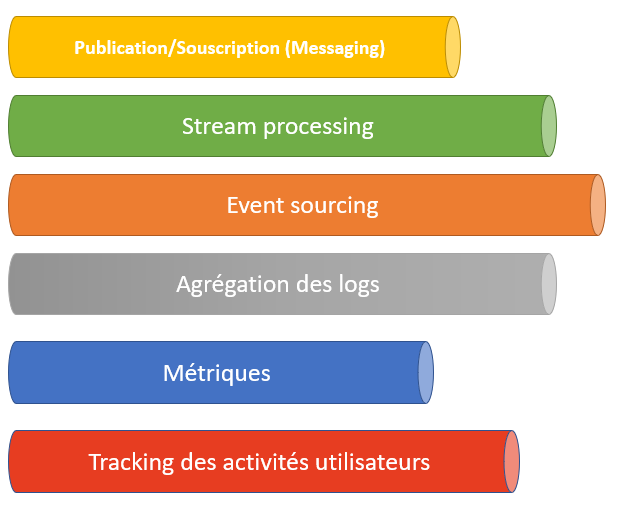
Kafka use cases
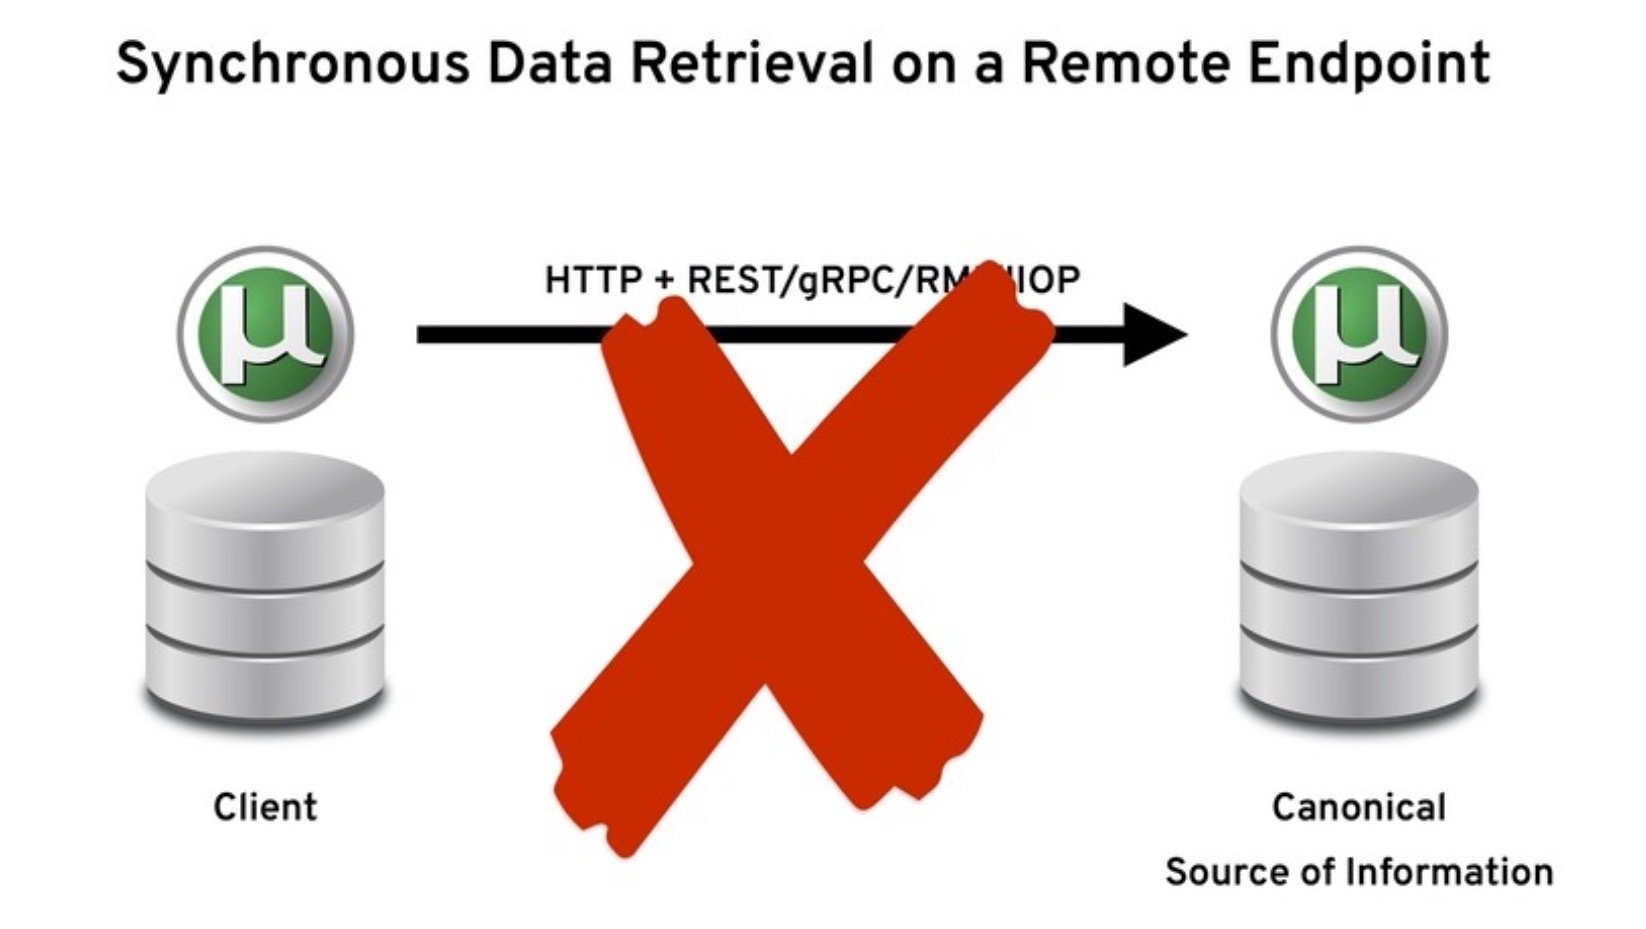
Interne
Découplage des microservices
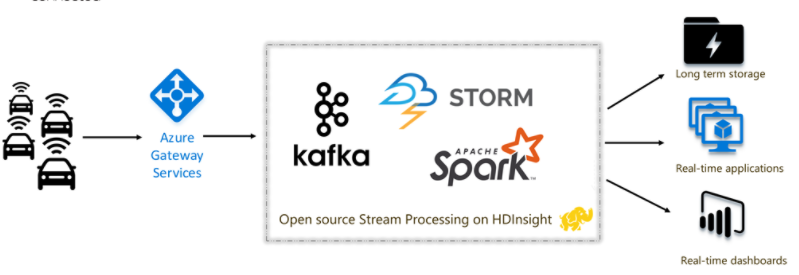
Ingestion des données
Kafka
Le besoin d'intégration des applications est primordial afin de leur permettre de communiquer entre elles au sein d'un SI.
Vision Architecture
Kafka
Ce qui nous donne ...
Cela impliquerait plusieurs facteurs:
Technologies : les standards SOAP, REST, JMS, Kubernetes
Programmations: Java, Javascript, PHP
Architectures: Monolithique, Microservices, Serveless
Communications: batch processing, (near) real time, publish-subscribe
Vision Architecture
Kafka
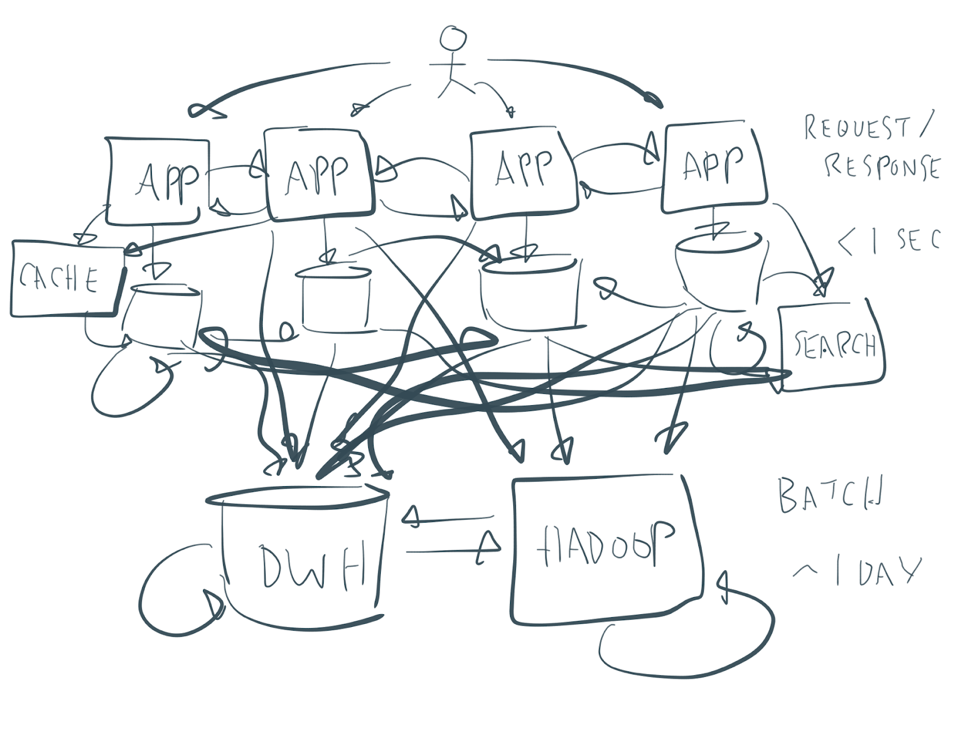
Spaghetti architectures
Kafka
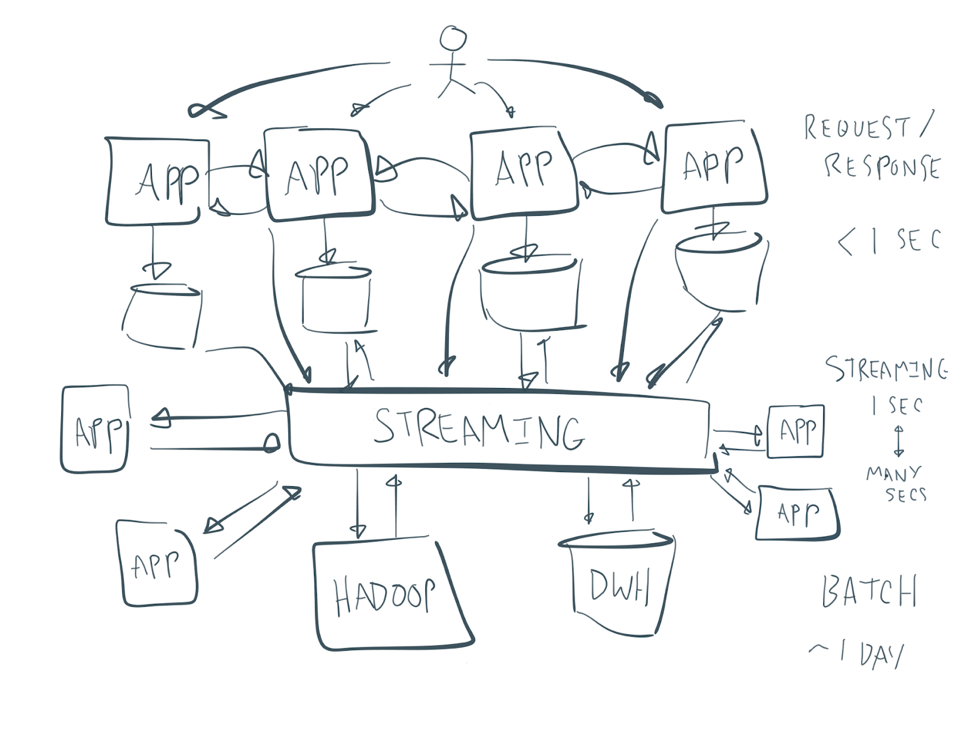
Streaming architecture
Une boîte centrale intégrée au milieu
Kafka Pros/Cons
Cons:
Demande beaucoup de temps pour comprendre son fonctionnement
Pros:
- Ingestion Big Data
- Multi producteur/Consommateur
- Tolérance aux pannes
- Scalabilité
Kafka
Quand ne pas l'utiliser
- En cas de petite quantité de messages échangés par jour,
- Lorsqu'il y a une simple file d'attente de tâches,
- En présence des batchs ETL, surtout quand il y a besoin de traitements real time,
- Si vous avez besoin de stocker des données à long terme.
Event sourcing
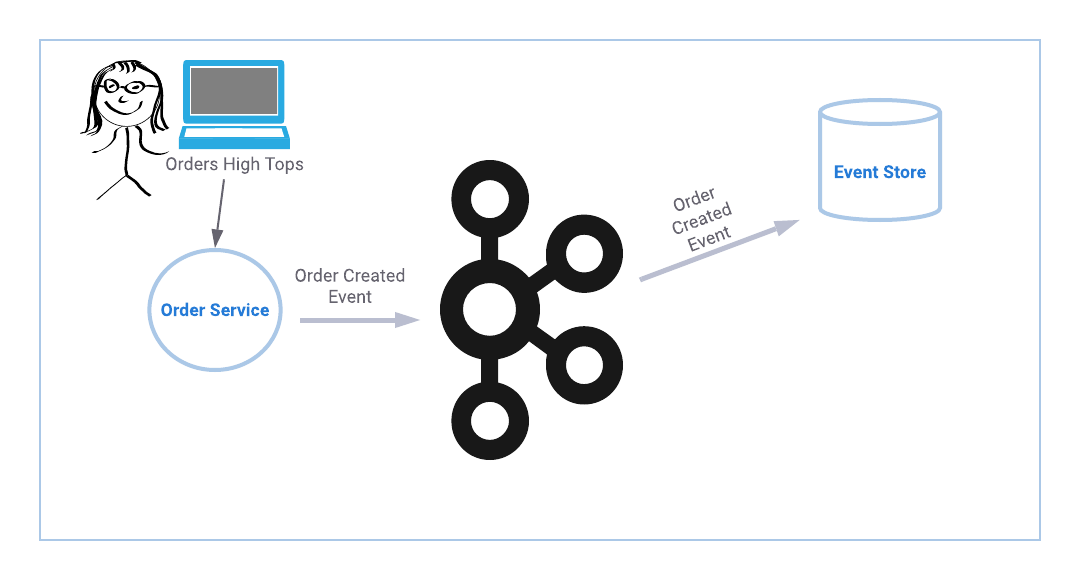
Un pattern d’architecture qui se traduit par un mécanisme de sauvegarde de chaque événement déclenché au sein d’une application
Event sourcing
Event sourcing
Les concepts clés
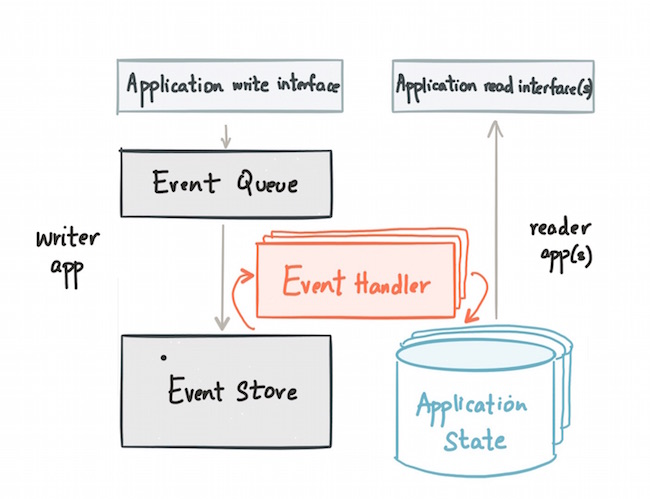
L’évènement: Un fait qui s’est produit dans le passé : il est immuable.
La commande: Une intention provoquée par l’extérieur (utilisateur, système) sur votre application.
L’event/state store (magasin d’évènements) : Sert à stocker l’ensemble des évènements produits par l’application.
La fonction de décision: Correspond au coeur de votre métier et contient l’ensemble de vos règles de gestion.
La fonction d’évolution: A pour objectif de faire muter l’état courant de l’application.
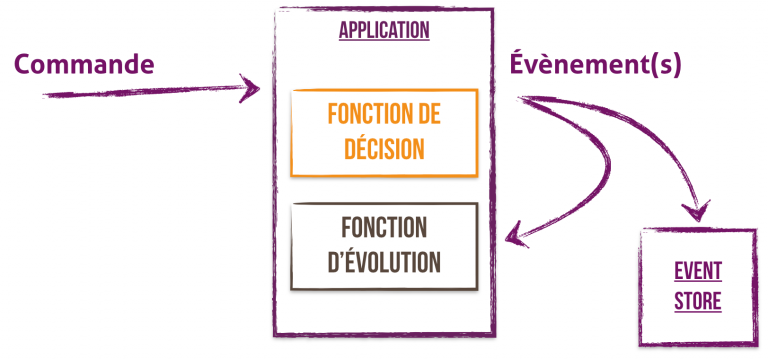
Event sourcing
Pros/Cons
Pros:
- Un audit efficace et rapide
- Contribution à l’analyse et correction de bugs
- Reprise des données
- Traitement asynchrone
Cons:
Complexité
Registry
Un premier pas vers la gouvernance des données
Un composant open source initialement développé par Confluent
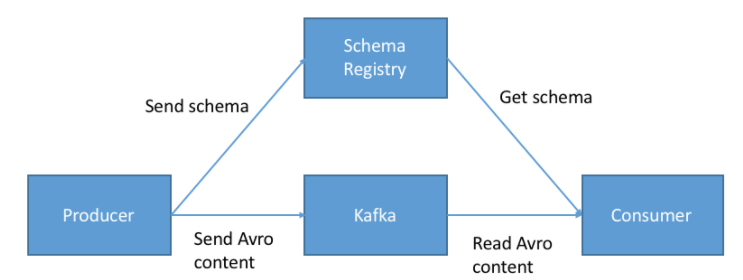
Un référentiel partagé de schémas qui permet aux applications d'interagir de manière flexible les unes avec les autres.
Registry
Un premier pas vers la gouvernance des données
Elle permet de :
- Enregistrer des schémas (format Avro),
- Les consulter,
- Les faire évoluer en gardant l’historique,
- Le versioning des schémas,
- La vérification de compatibilité entre les différentes versions.
Registry
Apache Avro
- Un système de sérialisation de données,
- Utilise JSON pour la définition des schémas, et sérialise les données dans un format binaire.
Types primitifs: null, boolean, int, long, float, double, bytes, string
Types complexes: record, enum, array, map, union, fixed
Registry
Apache Avro
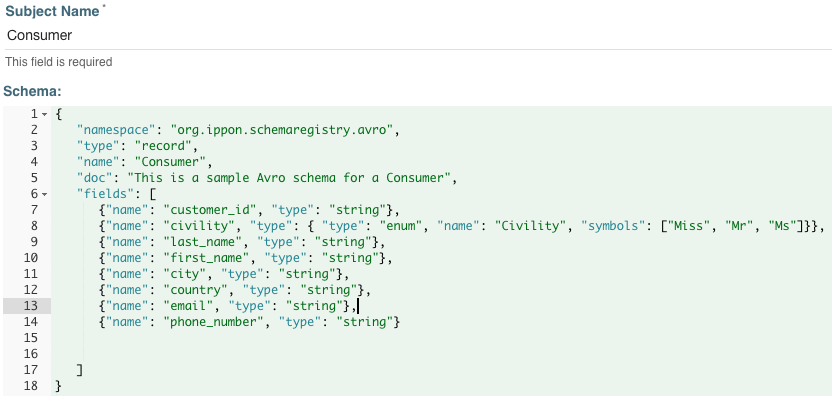
Registry
Compatibilité schémas
Backward (default)
Un nouveau schéma est rétro-compatible s'il peut être utilisé pour lire les données écrites dans tous les schémas précédents.
Forward
Un nouveau schéma est compatible en aval si tous les schémas précédents peuvent lire les données écrites dans ce schéma.
Full
Un nouveau schéma est entièrement compatible s'il est à la fois compatible en amont et en aval.
No compatibility
N'importe quel schéma à condition qu'il s'agisse d'un Avro valide.
Registry
Poison Pill
C'est un enregistrement qui a été produit sur Kafka et échoue toujours lorsqu'il est consommé, quel que soit le nombre de tentatives.
Consumer
{ok}
{ok}
Poison Pill
Poison Pill
Consumer
{ok}
Poison Pill
ERROR!
-
Un enregistrement corrompu
-
Un échec de désérialisation
Poison Pill
Comment éviter le problème ?
-
Spring Kafka à la rescousse! Configurer le ErrorHandlingDeserializer.
-
Attendre que la période de rétention du topic Kafka soit passée ?
-
Changer le groupe de consommateurs ?
-
Mettre à jour manuellement / automatiquement le décalage des messages (offsets)?
Dead letter
Dans la majorité des cas, logger les exceptions c'est suffisant mais parfois examiner les poisons pills s'avère nécessaire.
Configurer un ErrorHandlingDeserializer en combinaison avec un DeadLetterPublishingRecoverer et SeekToCurrentErrorHandler pour publier la valeur du message erroné dans un topic qui s'appelle dead letter.
Dead letter
Consumer
{ok}
Dead letter topic
{ok}
Publish
Kafka Stream
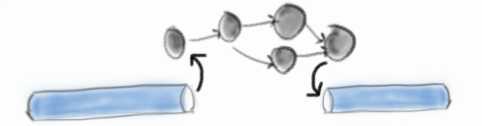
Une bibliothèque de traitement de flux
Utiliser dans des applications qui traitent les messages des topics Kafka.
Kafka Stream
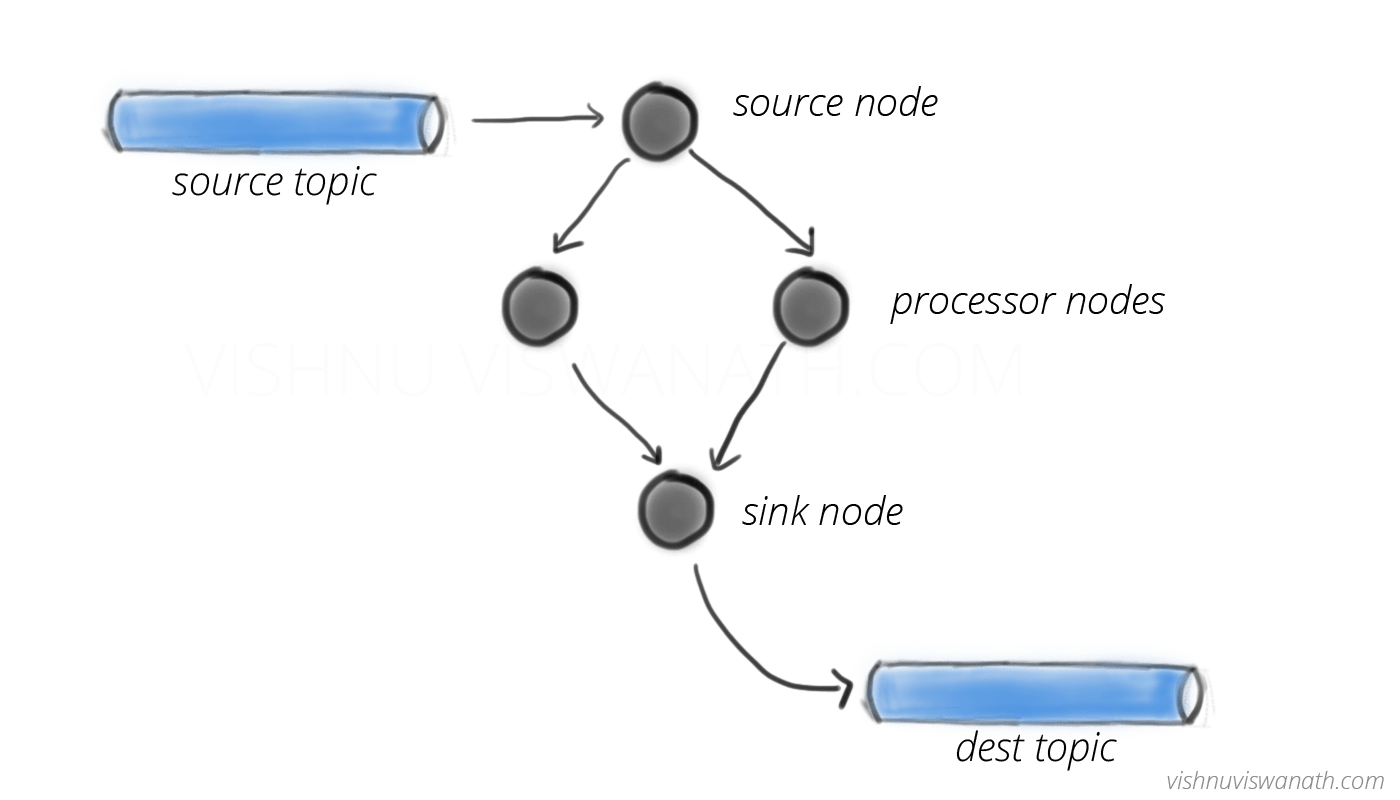
Kafka Stream
KStreams and KTables
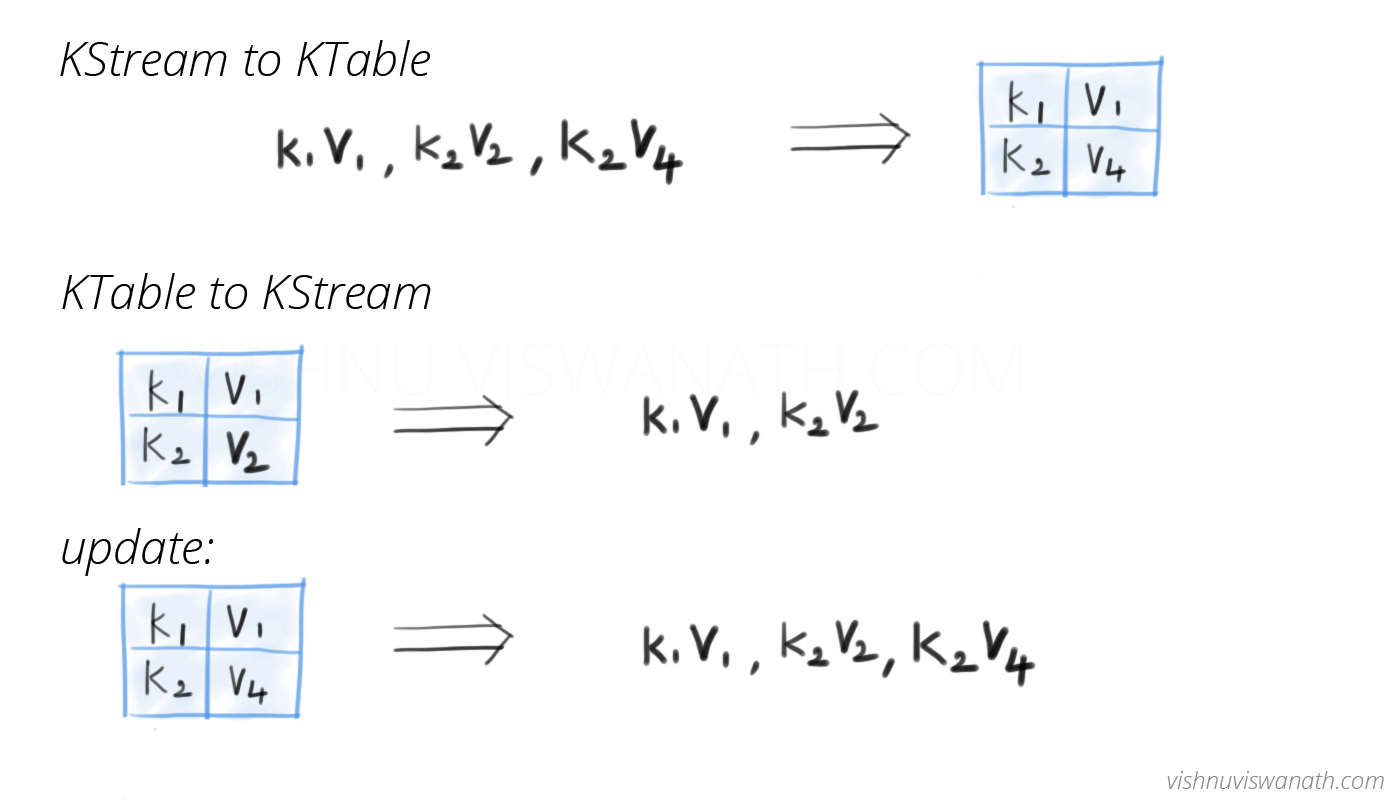
KStreams et KTables sont les deux principales abstractions qui représentent un flux de messages - qui sont des paires (clé, valeur)
Kafka
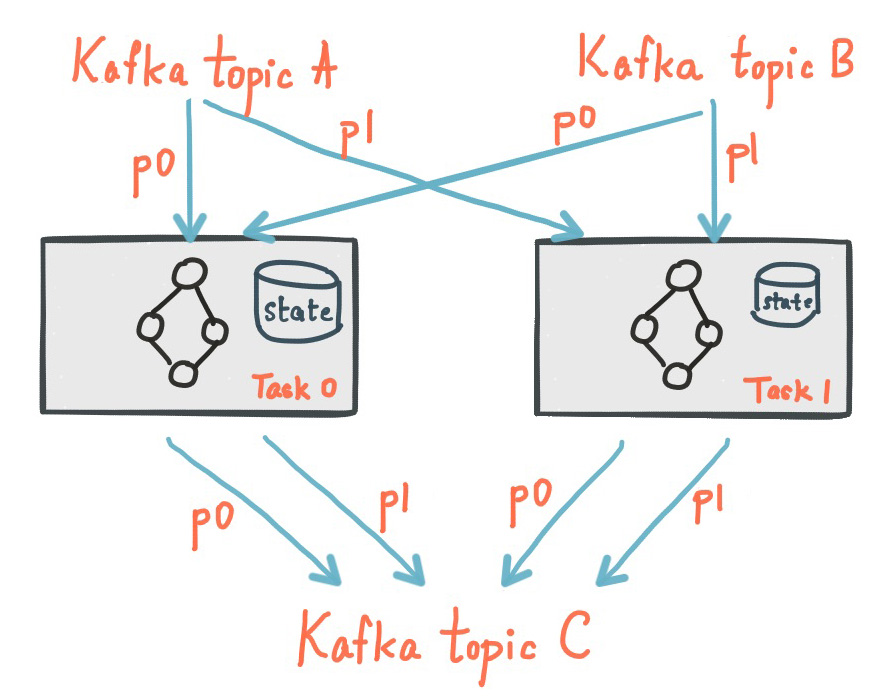
L'intérêt d'un state store
- Stocker et gérer les évènements de façon asynchrone,
- Suivre les traitements des évènements.
Bonne pratiques (DRAFT)
- Stratégie d'acquittement
- Retry Template
- l'idempotence
- mise à l'échelle horizontale
Merci de
votre
attention
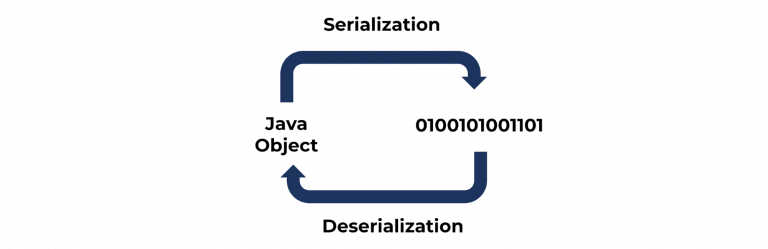
Sérialiser/Désérialiser