🧑🏻💻 Comment j'ai hacké des panneaux publicitaires ? 🖼️
Vincent Ogloblinsky - @vogloblinsky
Vincent Ogloblinsky
Compodoc maintainer


Web software architect

Indie hacker on side-projects


Démo
Agenda
1.
Le problème
2.
Trouver les 4 coins
3.
Le temps réel
4.
La précision
5.
Le rendu et l'art
6.
Développer avec une IA
7.
Ce que j'en retiens
Le problème
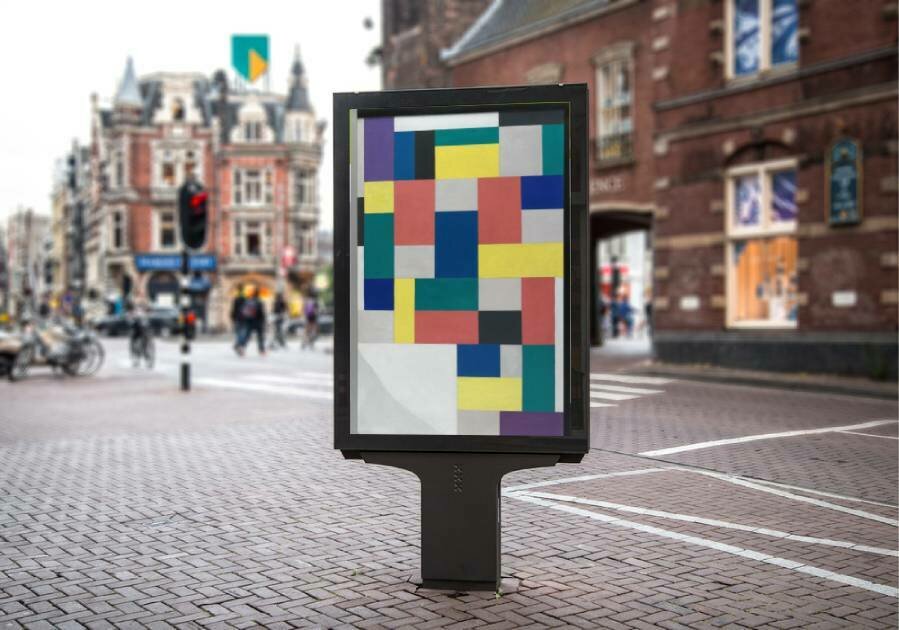
Le but : poser une œuvre à la place de la pub
Il faut savoir exactement où est la surface d'affichage, au pixel près.
De face : un rectangle
De biais : un quadrilatère
Dans les deux cas : 4 côtés, 4 coins.
Et vous, vous chercheriez quoi dans l'image ?
- un rectangle englobant, « comme YOLO »
- les pixels du panneau
- les 4 bords
- les 4 coins
Toutes ces idées, je les ai testées
Environnement technique
- Navigateur mobile : ONNX dans un worker, OpenCV.js, WebGL
- De vrais téléphones : iPhone 13 mini, Galaxy A52, TCL 403
- Une surface plate : 4 coins suffisent pour tout reconstruire
Déjà fait ?
No Ad (2011 - NY USA) : œuvres pré-assignées à des panneaux connus.
Ici, n'importe quel panneau.

Trouver
les 4 coins
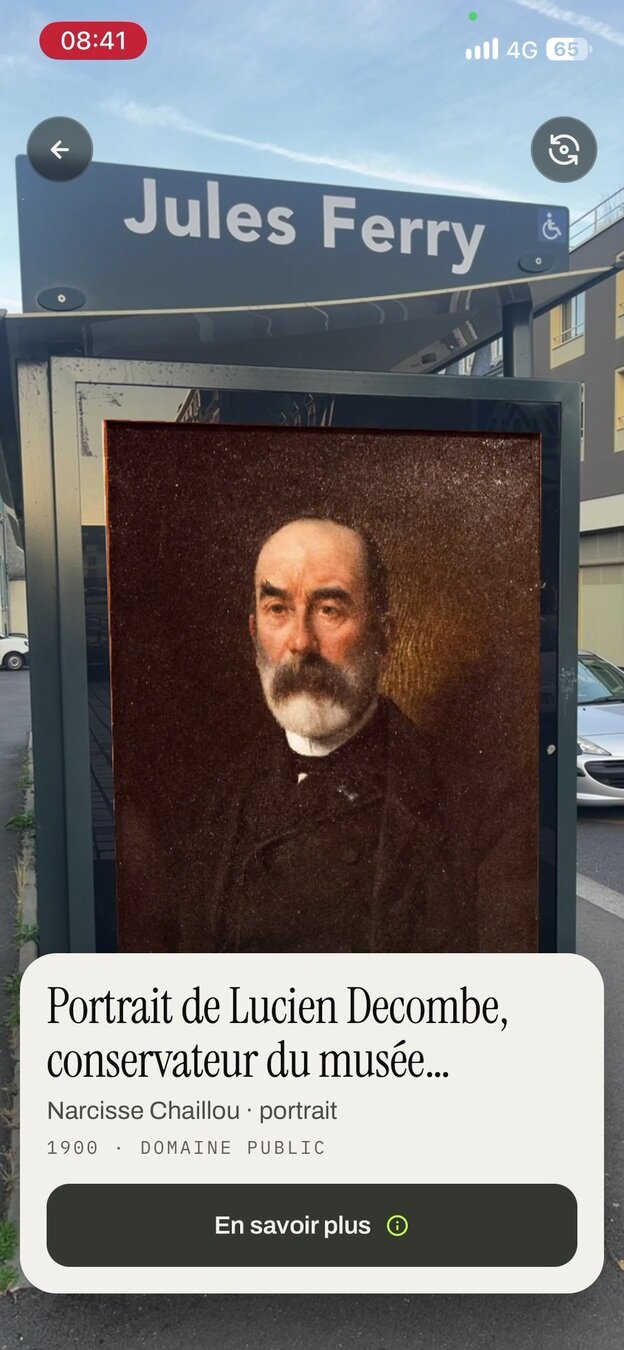
Ce qui existe : des CNN… pour une autre question
- CNN (réseau de neurones convolutif) entraînés sur des millions d'images : ImageNet, COCO, Open Images
CNN = un œil artificiel qui apprend tout seul, à partir d'exemples, à passer des pixels aux bords, des bords aux formes, et des formes aux objets. - YOLO (« You Only Look Once ») est une famille de CNN spécialisés dans la détection d'objets. Il ne répond que par une bbox : un rectangle droit, jamais en perspective
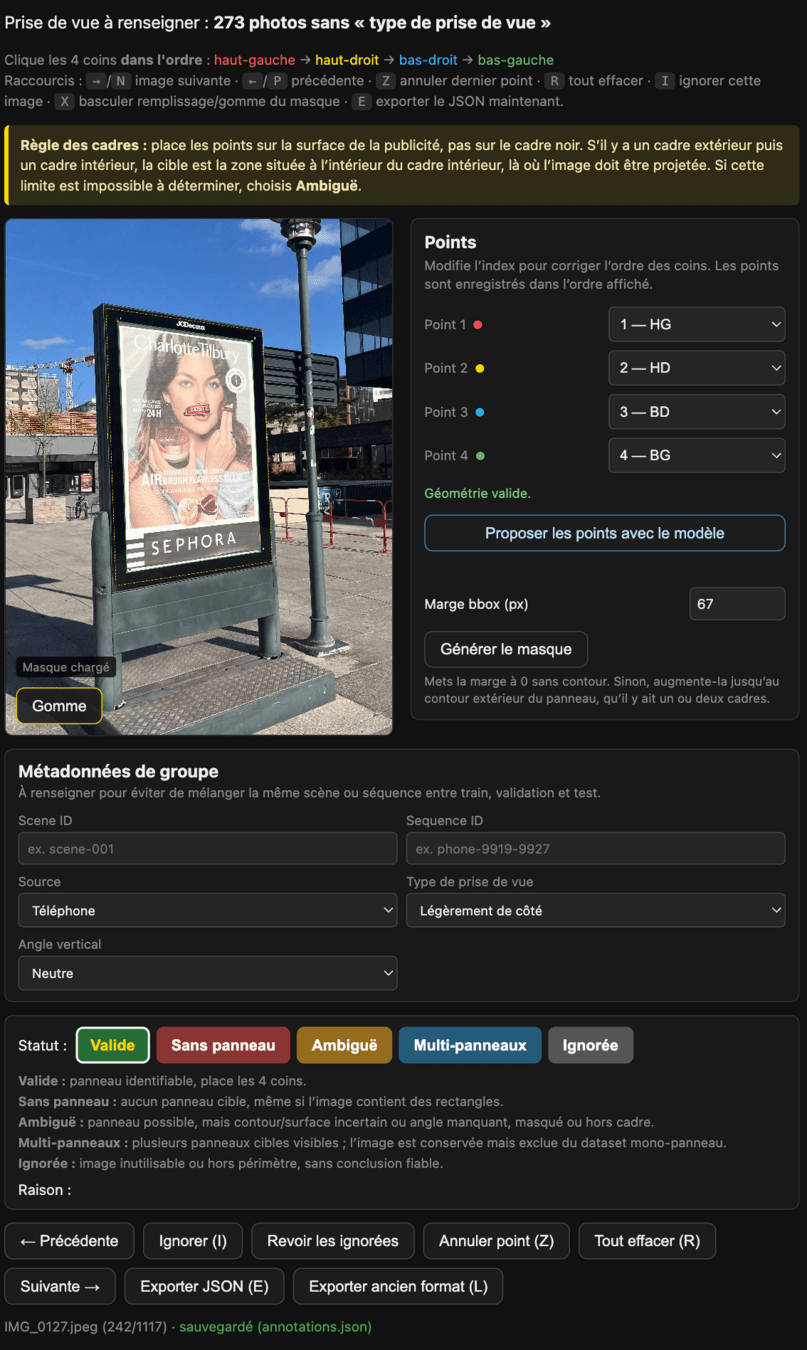
- Aucun dataset de panneaux pub annotés par leurs 4 coins
Donc : fabriquer mon propre dataset
Photos du web, d'Open Images, et de terrain à Rennes.
+ des images sans panneau, pour apprendre à ne rien voir
Un réseau de vision, c'est 2 parties
Regarde l'image et la résume, zone par zone : ici un bord, là un angle, là une surface claire.
Il décrit, il ne répond à aucune question. Grosse partie, apprise sur des millions de photos : on la réutilise.
Lit ce résumé et répond à la question posée, dans le format demandé.
Elle ne voit jamais l'image. Petite partie : on la change selon la question.
Même œil, autre question → autre réponse.
On garde l'œil, on change le cerveau
Entraînement sur mes ~500 photos de panneaux annotées : l'œil et le cerveau apprennent ensemble. Quand un coin est mal placé, l'erreur remonte du cerveau jusqu'à l'œil, qui s'ajuste un peu.
Pourquoi ça marche avec si peu d'images : l'œil a déjà vu des millions de photos. L'essentiel à apprendre, c'est notre question, au cerveau.
Vos réponses, mesurées
Même œil, autre question : seul le cerveau (la tête) change.
| Votre réponse | Ce que j'ai entraîné | Erreur / coin en px, image 224 × 224 |
|---|---|---|
| « Un rectangle, comme YOLO » | bbox, puis les coins dedans | 12,5 px |
| « Les pixels du panneau » | segmentation, puis coins du masque | 12,0 px |
| « Les 4 coins » | régression directe : 8 nombres | 11,7 px |
| « Les 4 bords » | une carte par côté, coins aux croisements | 7,7 px |
| « Les 4 coins » en mieux | une carte par coin (heatmaps) | 7,2 px |
Erreurs mesurées dans l'image réduite vue par le modèle (224 × 224), pas dans la photo d'origine.
Même jeu de test fixe de 119 images, même backbone.
Même cible, 11,7 px contre 7,2 px
Régression : des coordonnées
La tête répond directement la position : 8 nombres, un (x, y) par coin.
haut-gauche → (57, 50)
Une seule réponse, sans nuance.
Heatmap : une carte de chaleur
La tête répond une image par coin. Chaque case dit « le coin est-il ici ? », du froid au chaud.
Et quand le réseau hésite entre le bord du cadre et le bord de l'affiche ?
Analogie · « Où sont tes clés ? » Cuisine ou entrée… Une seule réponse : « dans le couloir ». Une carte : on entoure les deux, on va voir la plus probable.
À quoi ressemblent ces cartes
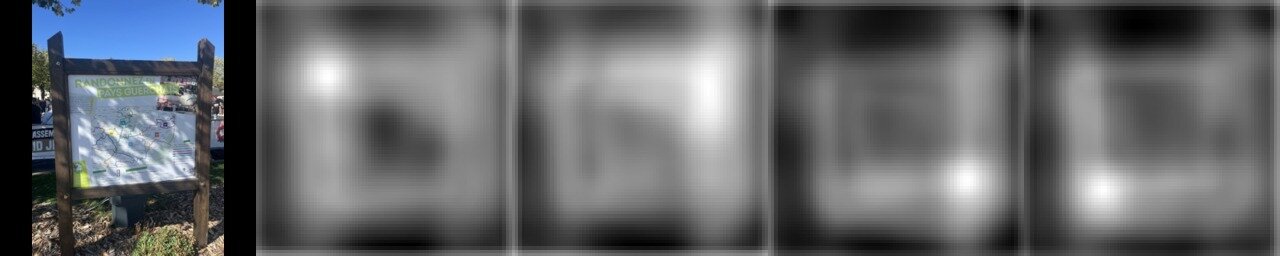
L'image, puis une carte par coin : haut-gauche, haut-droit, bas-droit, bas-gauche.
D'où vient le gain ?
on change
la tête
−4,5 px
on change
l'œil
−1,5 px
Erreur moyenne par coin, en px de l'image 224 × 224 vue par le modèle. On ne change qu'une chose à la fois.
Pourquoi changer la tête rapporte 3 fois plus que changer l'œil ?
L'œil décrit l'image zone par zone, comme une carte. La heatmap répond aussi par une carte : chaque case dit juste « c'est ici ». La régression doit tout résumer en 8 nombres.
Deux candidats ? Deux zones s'allument, on garde la plus forte. La régression, elle, coupe la poire en deux et tombe dans le vide.
À chaque photo, des milliers de cases sont corrigées, pas 8 nombres. Précieux quand on n'a que quelques centaines d'images.
Analogie · montrer le coin du doigt sur la photo, plutôt que dicter ses coordonnées GPS.
Choisir l'œil : un compromis
On ne peut pas tout avoir : un œil plus fin voit mieux, mais met plus de temps à regarder. Et sur téléphone, chaque milliseconde compte.
plus court = plus précis
plus court = plus rapide
Barres à l'échelle, à partir de zéro (0–9 px et 0–90 ms).
MnasNet-A1 : −1,5 px par rapport à ShuffleNetV2, pour seulement +3 ms avec une image d'entrée de 320px
EfficientNet-Lite0 : encore −0,6 px… mais +9 ms de plus. Ça ne vaut pas le coût.
Et plus léger ne veut pas dire mieux : MobileNetV3-Small, conçu pour le mobile, fait 11,1 px, aussi mal que la régression.
Le temps réel
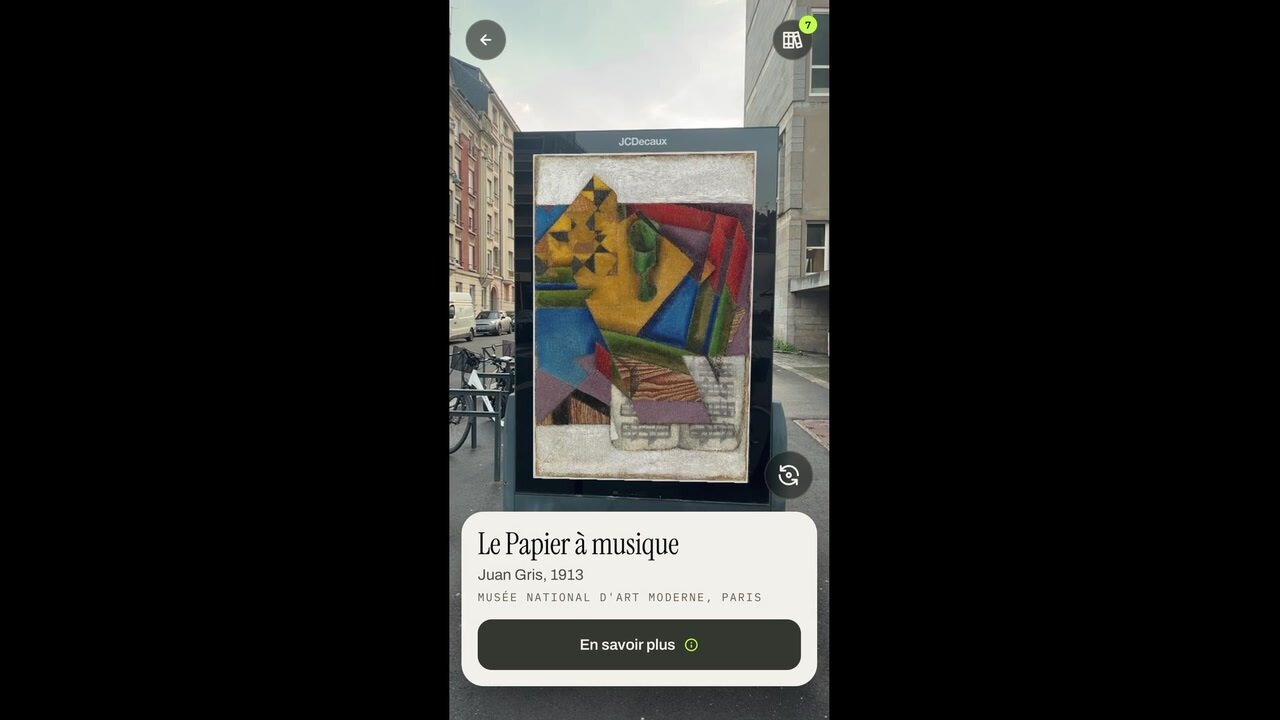
De la photo à la vidéo
Jusqu'ici : des photos. Maintenant : une vidéo, à ~25 images par seconde.
Un détective et un suiveur
CNN : 1 frame sur 10 flot optique + homographie : les autres
Entre deux images, un panneau plat bouge un peu, et de façon prévisible.
Analogie · on cherche un ami une fois dans la foule, puis on le suit des yeux.
Le « pipeline hybride » : un réseau de neurones + de la vision classique sans apprentissage.
Le moment « et merde ! 😡 »
Le suivi, censé alléger le travail, rendait l'app 7× plus lente que le CNN seul sur iPhone.
L'indice : démarrer le suivi et continuer le suivi coûtaient pareil. Le coupable est donc l'étape commune.
Préparer l'image = copier l'image de la caméra, puis la passer en noir et blanc (le suivi ne regarde que la luminosité).
toute l'image caméra,
en pleine résolution,
à chaque image
seulement la zone du panneau
(+ une marge), réduite
à 320 px maximum
(le CNN seul : 55 ms)
Profiler avant de juger une architecture.
Et encore…
Le flot (optique) = le suivi entre deux passages du CNN : on mesure de combien chaque point du panneau a bougé d'une image à la suivante.
Sur téléphone lent, à chaque passage du CNN, l'image se fige ~430 ms.
Téléphone immobile, les coins bougent quand même de quelques pixels : l'œuvre frétille.
L'affiche défile à l'intérieur du cadre.
La précision
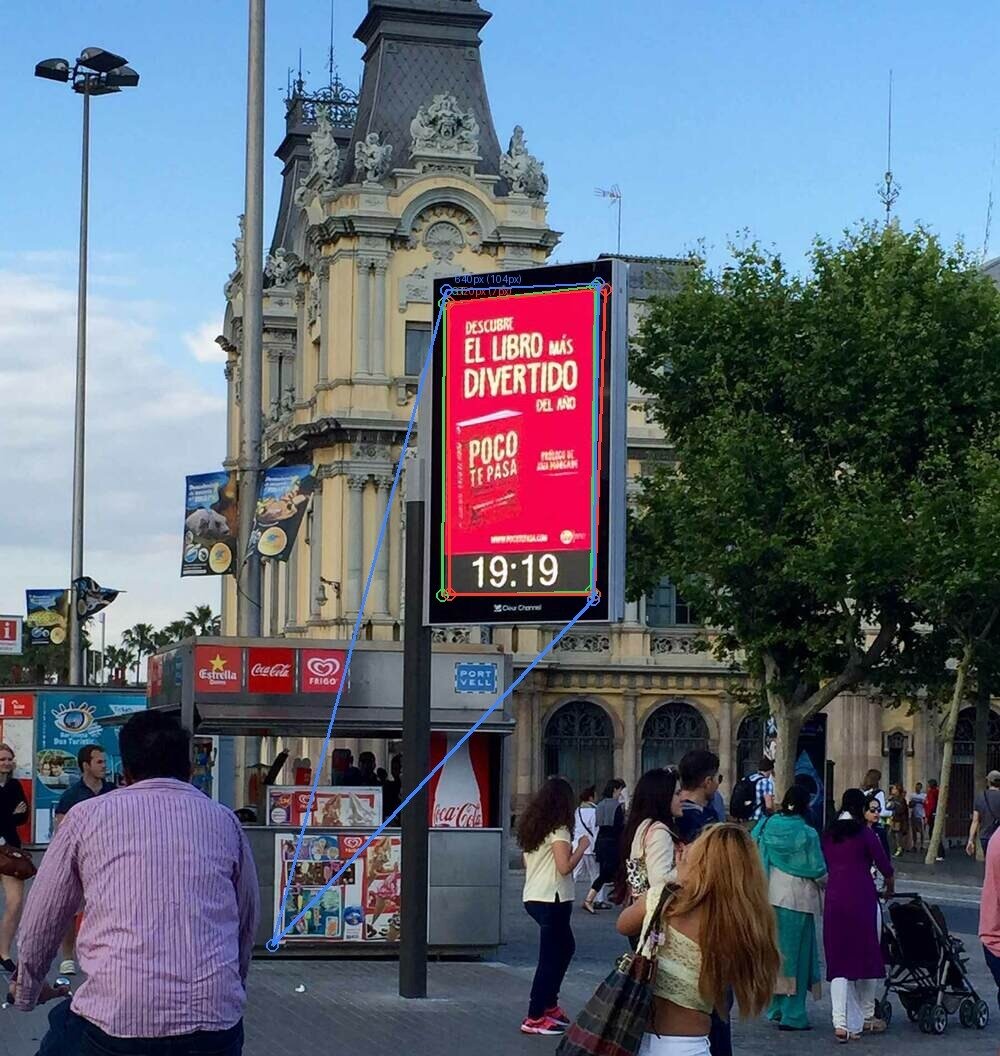
Pourquoi maintenant ?
Dans la rue : l'œuvre déborde du cadre, un liseré de pub dépasse.
Pourquoi ? Le modèle ne voit qu'une image réduite, et répond avec une grille de cases :
1080 × 1920 px
réduite
÷ 6
320 px de haut
découpée
÷ 4
80 × 80 cases
de vidéo (6 × 4)
Le modèle désigne une case, pas un pixel : ~15 px d'erreur, c'est à peine plus d'une demi-case.
Analogie · un point juste sur une carte au 1/100 000 devient une erreur de plusieurs maisons sur le plan du quartier.
Fausse bonne idée : « augmente la résolution »
Au-delà de 448 px, des coins partent sur un mât, un kiosque.
Les 4 cartes deviennent identiques : le backbone a appris à voir à une certaine échelle.
Un premier correctif « marchait » sur 3 exemples… et échouait sur les 119.
Ce qui marche : l'edge-fitting
Il le trouve dans toute l'image… à ~15 px près.
Il cherche juste autour, dans la vidéo en pleine résolution.
Un complément, pas un remplacement : seul, l'edge-fitting serait perdu parmi les milliers de bords d'une rue.
Le côté donné par le CNN (pointillés bleus) : proche du bord, mais pas dessus.
16 petits traits en travers du côté (en jaune). Chacun explore 18 px de part et d'autre.
Sur chaque trait, on garde l'endroit où l'image passe le plus brusquement du sombre au clair : c'est là qu'est le vrai bord.
Une droite passe au mieux par ces points (en vert), les points aberrants (reflet, poteau) sont écartés. On refait ça sur les 4 côtés : les coins = les croisements des 4 droites.
Résultat
Coût : ~90 ms sur iPhone… mais seulement 1 frame sur 10. Fluidité quasi intacte.
Analogie · le CNN montre du doigt le coin du tableau, de loin. L'edge-fitting s'approche et pose une règle le long de chaque bord.
Le CNN dit « à peu près où », la géométrie dit « exactement où ».
Puis la rue complique tout
L'abribus à double cadre : gris clair, puis bordure noire
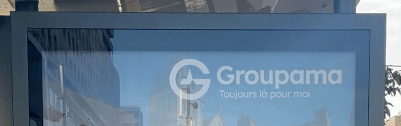
Le CNN pose le coin au milieu de la bordure noire. Ses deux bords tombent dans la zone de recherche.
Chaque recherche prend le bord le plus net du moment : la droite saute de l'un à l'autre, l'œuvre se décale de 25 à 40 px.
En allant vers l'intérieur, ne garder que les bords qui passent du sombre au clair. Seul le bord de l'affiche passe le test.
Le rendu
et l'art
4 coins → une œuvre
Homographie : la formule qui déforme un rectangle pour le poser sur les 4 coins du panneau. Calculée par la carte graphique (WebGL).
D'où viennent les œuvres ?
V1 : interroger Wikidata en direct
SPARQL = le langage pour interroger Wikidata, le « SQL » des données liées. À chaque scan, l'app demandait (simplifié) :
« Une peinture, avec image, au ratio du panneau, dans un musée proche. »
Ce qu'on a mesuré
10 musées maximum par requête, coupure à 12 s, relance d'un nouveau scan en cas d'échec. Ça tient… tant que le service va bien.
Wikidata est un service public et partagé, gratuit, sans garantie de temps de réponse. Ce n'est pas notre serveur.
Les tableaux ne changent pas de musée tous les jours. Interroger Wikidata une fois, chez moi, et embarquer le résultat dans l'app.
V2 : un catalogue embarqué
Construit une fois, chez moi
Un script « aspire » Wikidata (~5 min) puis les textes Wikipédia des œuvres (2 à 3 h).
→ un fichier JSON de ~950 Ko (~270 Ko compressé), livré avec l'app.
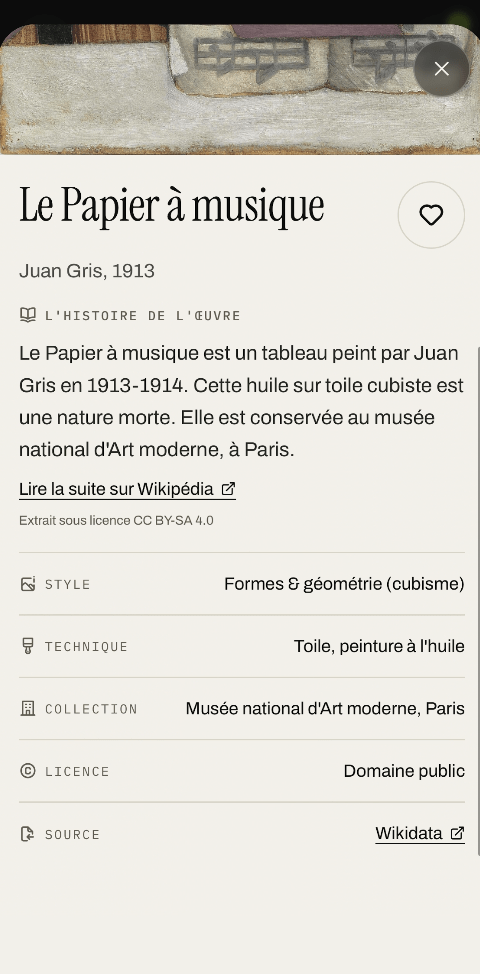
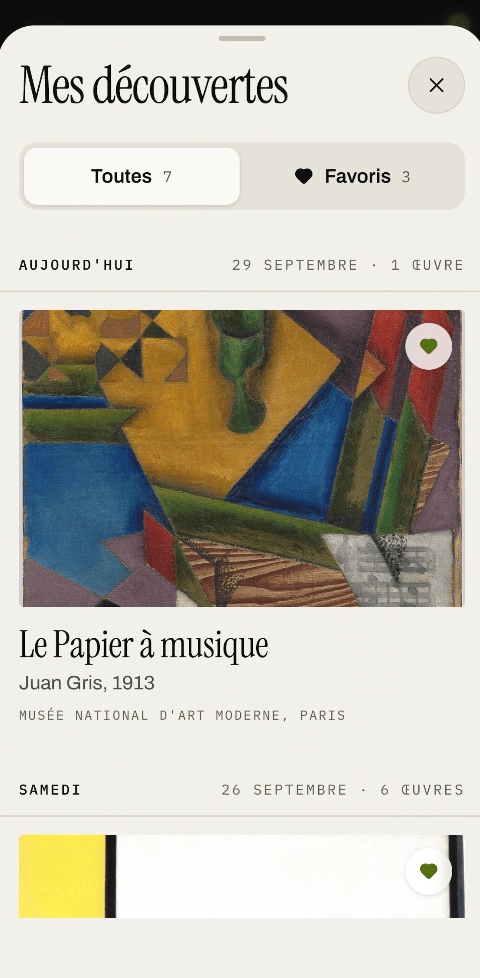
Au scan : tirage local et instantané, même sans réseau. Seule la photo vient encore de Commons, en miniature.
Mettre à jour = relancer le script.
Le tirage, à chaque scan
Au final
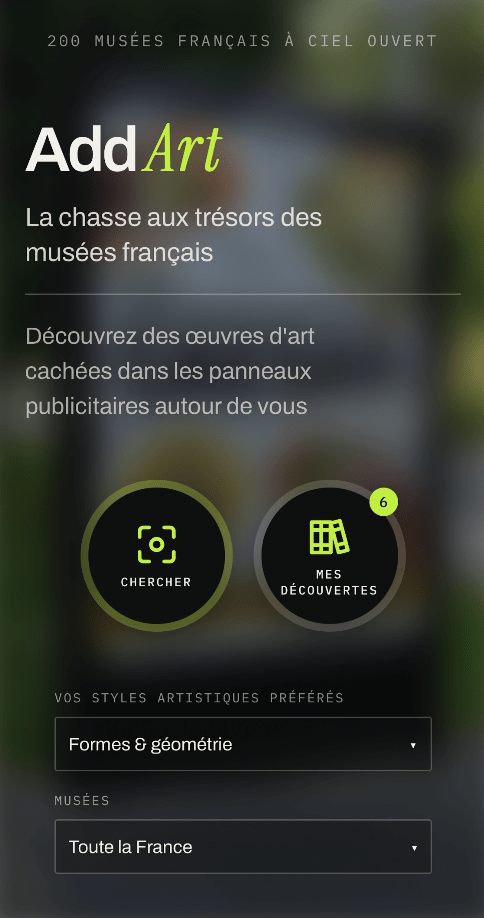
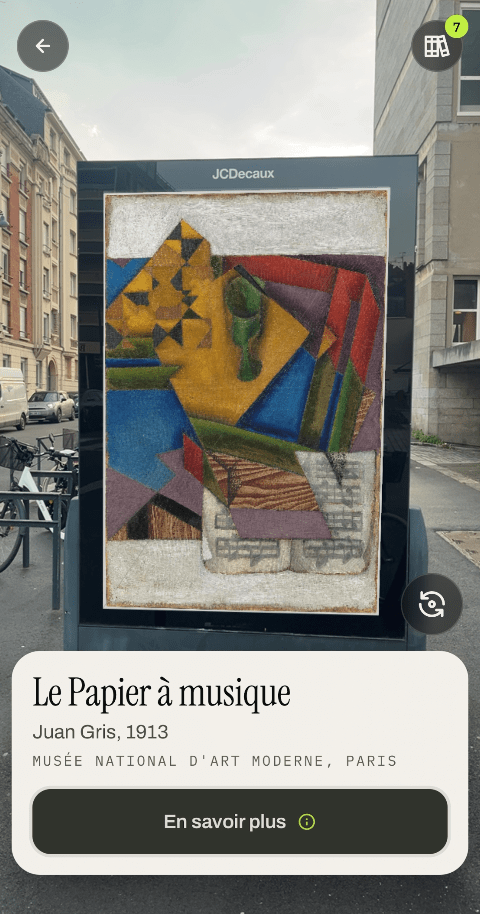
Développer
avec une IA

Beaucoup moins de temps qu'il y a 1 ou 2 ans
Ce qui a changé : pas la quantité de code, la vitesse d'itération
L'IA
- l'outillage : annotation, banc de test sur téléphone, évaluation
- l'exploration large : 5 têtes, ~10 backbones
- l'analyse des résultats, l'expérience suivante
Moi
- le terrain : filmer, tester dans la rue
- l'annotation
- « il y a un truc qui cloche »
- les arbitrages
Le nouveau problème : piloter
5 hypothèses et 3 expériences par jour : qu'est-ce qui est prouvé ? écarté ? pourquoi ?
knowledge/ : un mini graphe de connaissances en Markdown, dans le repo.
(moi)
+ hypothèse
mesurée
(moi)
Deux règles contre l'enthousiasme
« L'auteur n'est pas une preuve. »
Une hypothèse reste une opinion tant qu'aucune expérience ne l'a testée.
On ne supprime pas une hypothèse réfutée.
Elle explique pourquoi on n'a pas pris ce chemin.
Ce que j'en retiens
- Le plaisir de donner vie à une idée folle
celle qu'on ne lance jamais : vision, deep learning, mobile, web, données d'art - On va encore plus vite qu'avant
investiguer → prototyper → déployer → mesurer → améliorer → livrer - Mais attention
au « yes man » de l'IA, aux super-pouvoirs qu'on croit avoir…
les utilisateurs finaux auront le dernier mot
Thanks for your attention !
Any questions ?
Slides : https://bit.ly/4e2XF38
Crédit photos - Unsplash.com