Как деанонимизировать автора по предлогам
стилометрия как «детективная филология» и её границы
Даниил Скоринкин
ЕУСПб, 19 октября 2026

Что объединяет эти 3 книги?
Они написаны под псевдонимами

И становились объектами стилометрических исследований
Стилометрия — это
использование частотностей некоторых атомарных элементов текстов (чаще всего слов или их фрагментов) для сопоставления текстов между собой — например, для задач определения авторства, но не только
(это моё рабочее техническое определение)
Наш план на сегодня:
- Как происходит типичный стилометрический эксперимент (от постановки задачи до результата)
- Как работает стилометрический метод и можно ли ему верить?
- Как люди до этого додумались? Немного истории стилометрических исследований
- Где применяют сегодня: обзор современных стилометрических исследований
- Стилометрия за пределами атрибуции авторства
1. Типичный стилометрический эксперимент
-
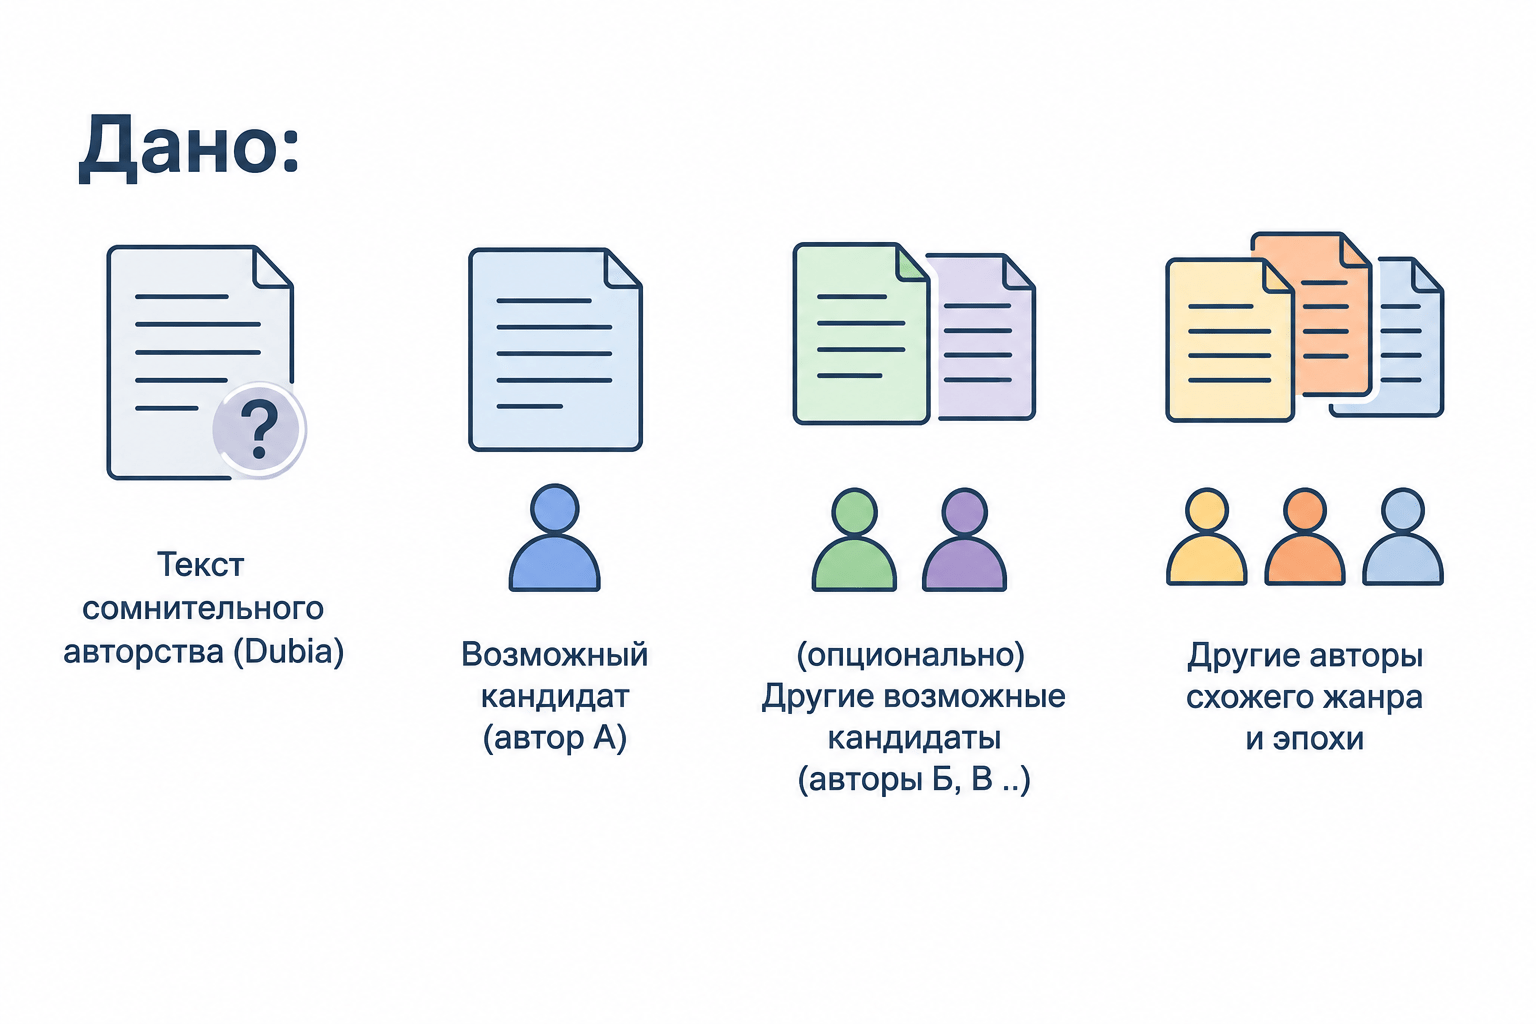
Текст сомнительного авторства (Dubia)
-
Возможный кандидат (автор А)
-
(опционально) Другие возможные кандидаты (авторы Б, В..)
-
Другие авторы схожего жанра и эпохи
Дано:
Автор А, книга А (A_A)
Автор А, книга Б (A_Б)
Автор А, книга В (А_В)
Автор Б, книга А (Б_A)
Автор Б, книга Б (Б_Б) Автор Б, книга В (Б_В)
Автор В, книга А (В_A)
Автор В, книга Б (В_Б) Автор В, книга В (В_В)
Книга, про которую мы сомневаемся (Dubia)
Собираем тексты для эксперимента:
Получаем некоторые* показатели близости
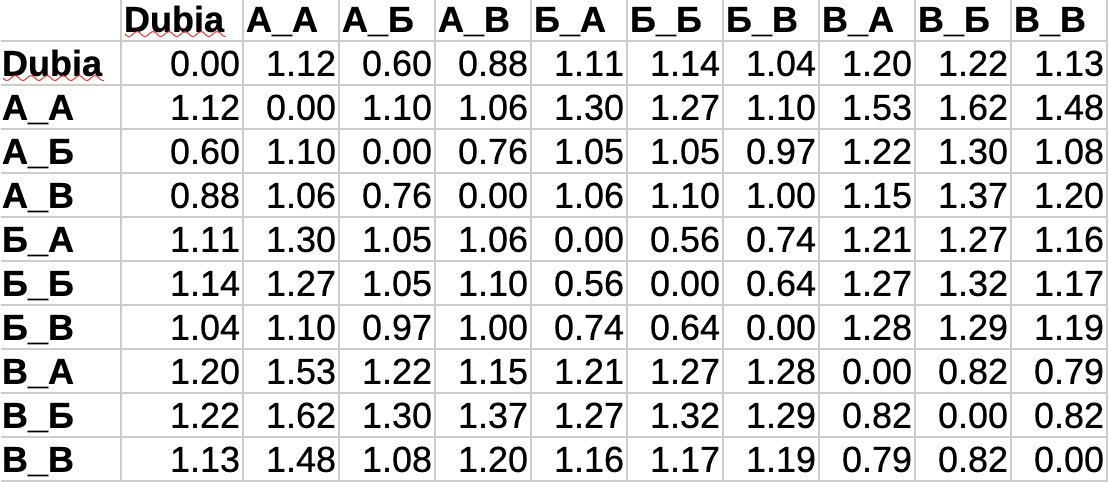
* как они получаются — станет ясно чуть позже
Делаем какую-то кластеризацию на основе близостей /как-то оцениваем соотношение близостей
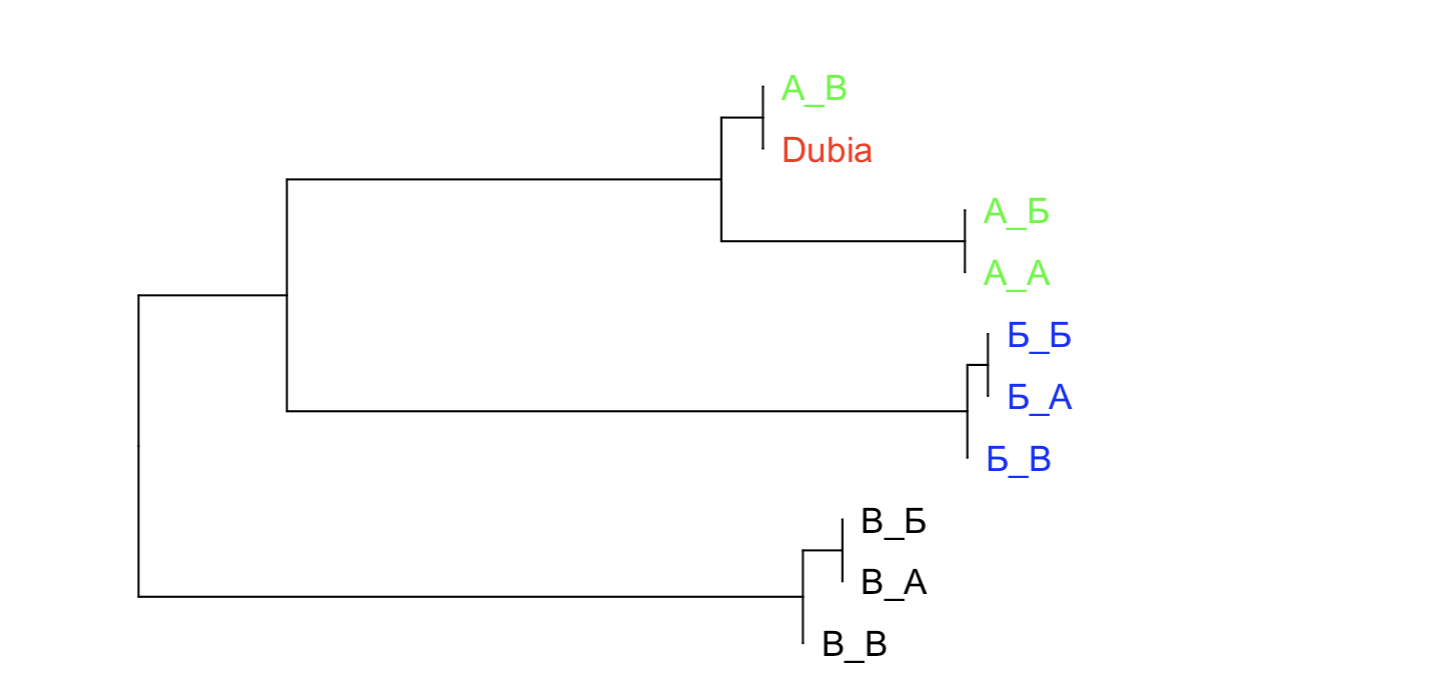
Делаем какой-то вывод
Реальный пример с Джоан Роулинг

2. Как это работает?
Автор А, книга А (A_A)
Автор А, книга Б (A_Б)
Автор А, книга В (А_В)
Автор Б, книга А (Б_A)
Автор Б, книга Б (Б_Б) Автор Б, книга В (Б_В)
....
??
Так что же
происходит между?
Что происходит посередине?
Стилометрические исследования во всем их разнообразии имеют две общие черты: тексты должны быть каким-то образом преобразованы в числа, а числа — исследованы статистическими методами
M. Eder, M. Kestemont, J. Rybicki. ‘Stylo’: a package for stylometric analyses
Как получаются эти числа?
Режем тексты на единицы, которые будем считать
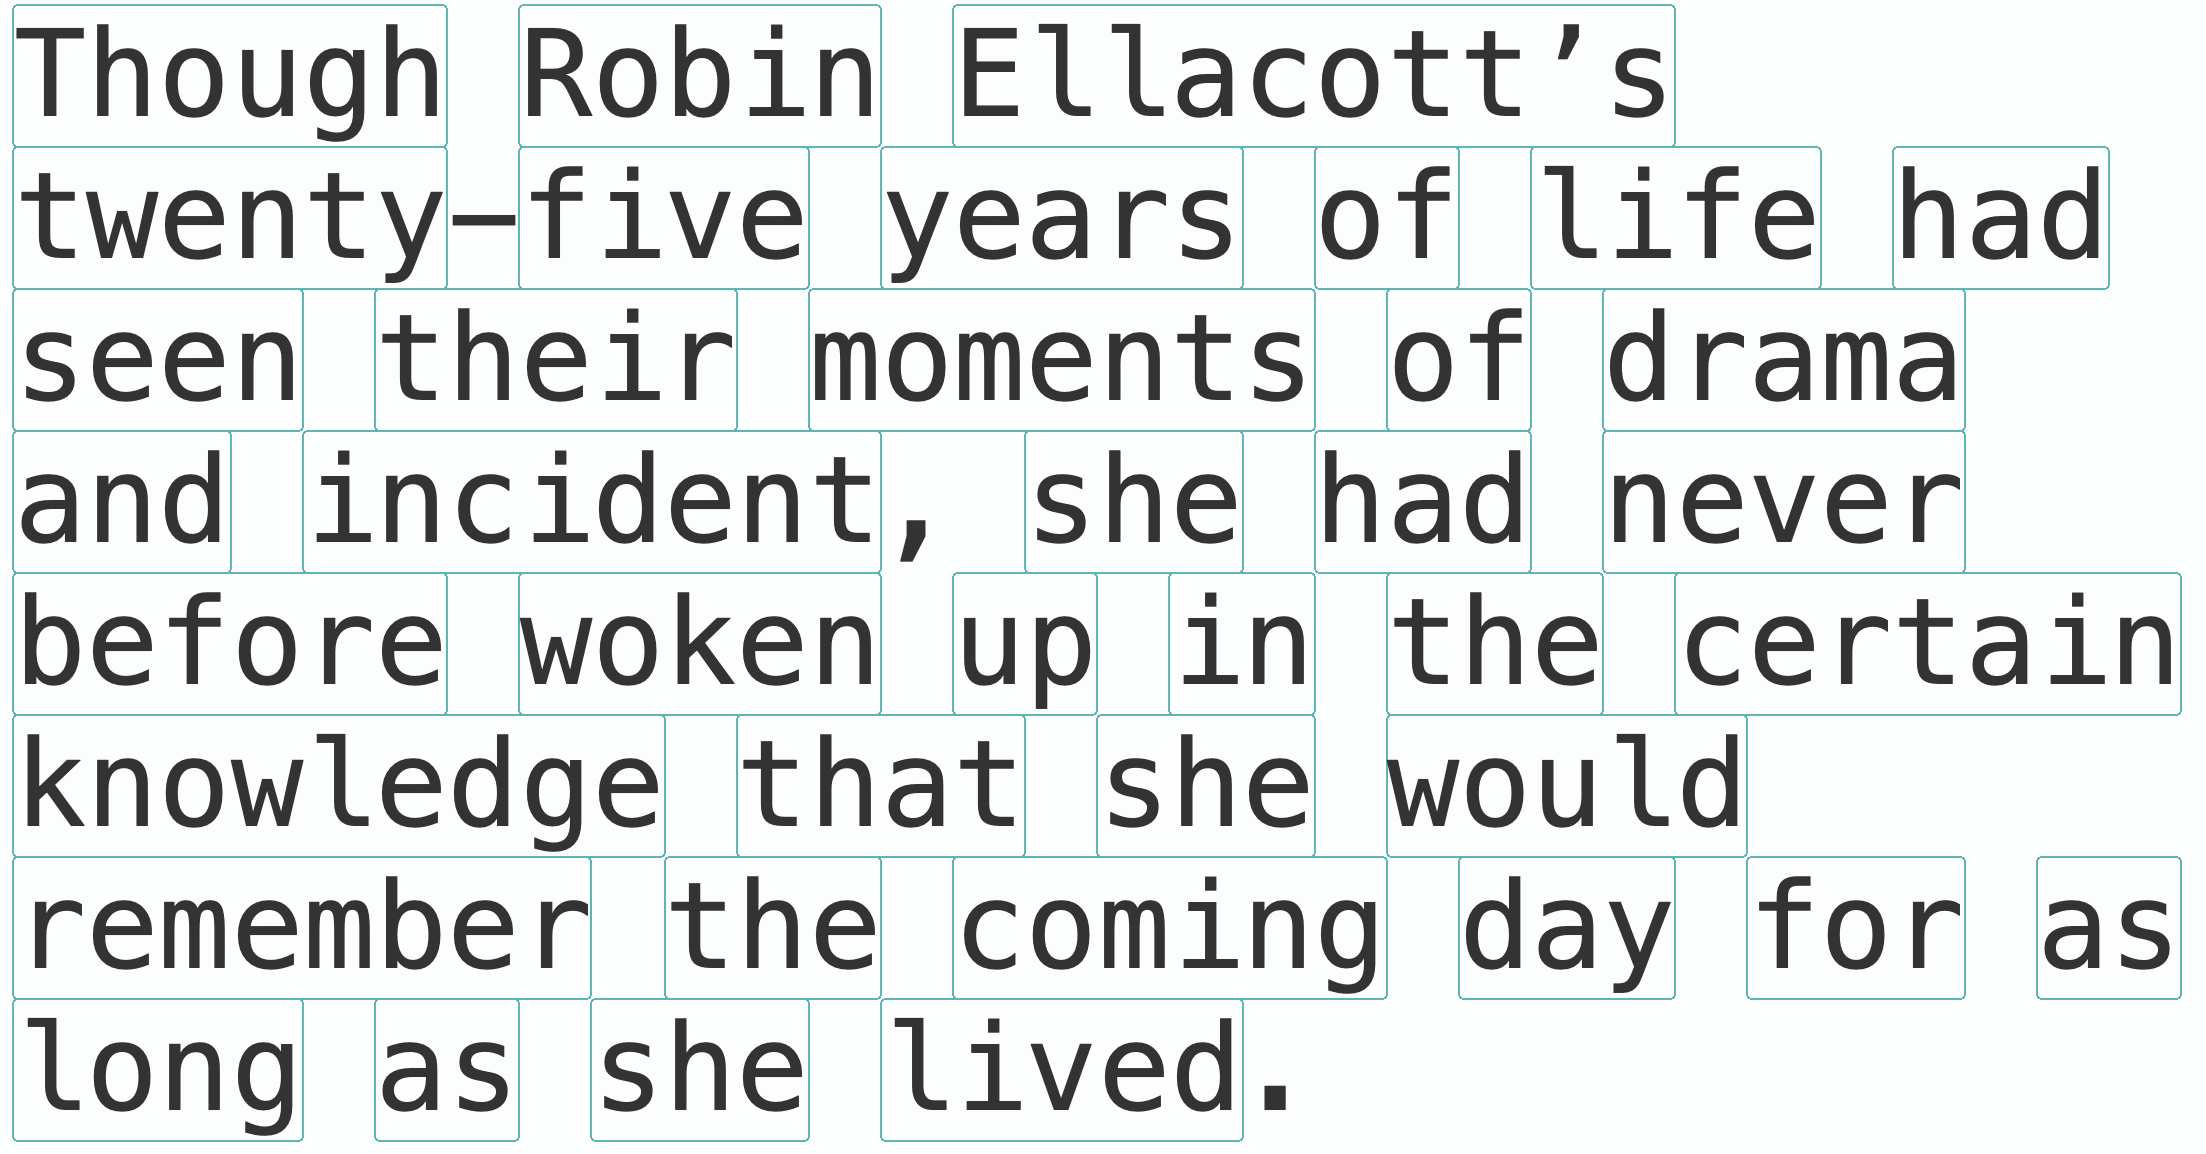
Считаем частотности единиц
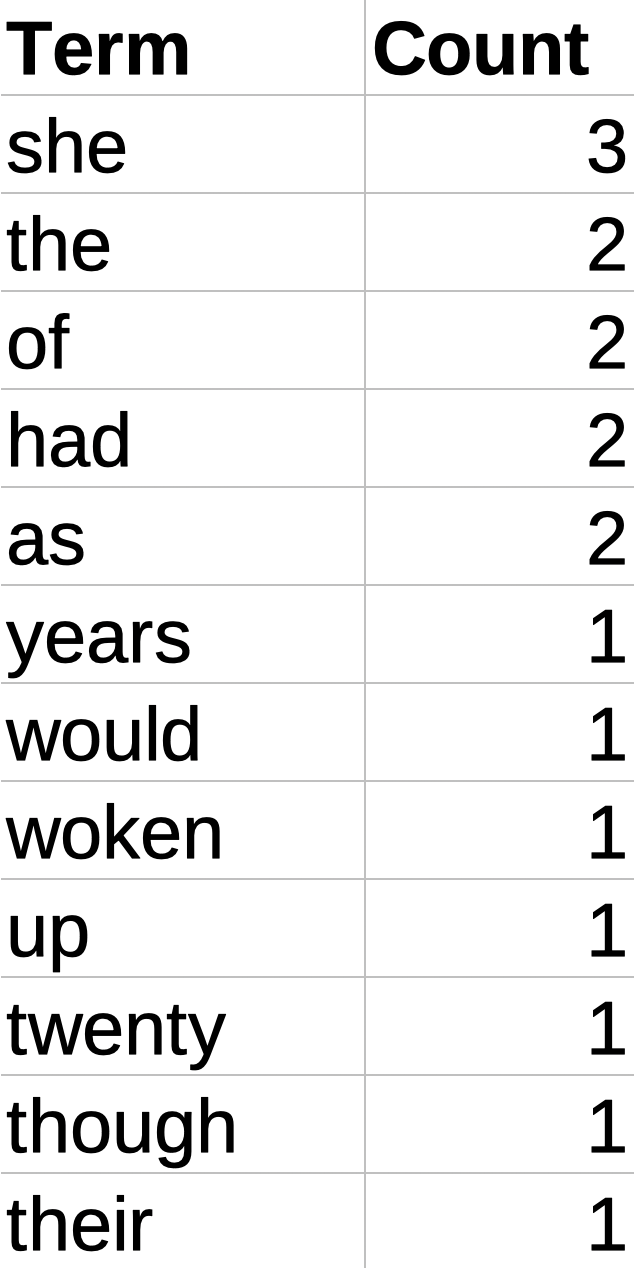
Каждый текст — столбик из чисел:

Каждый текст — вектор частотностей:
Что можно сделать с векторами?
Давайте на время упростим до 2 измерений:
Давайте на время упростим до 2 измерений:

ось 'and'
ось 'the'
И вот мы уже можем измерять расстояния между текстами
Стилометрия делает примерно то же самое, только не с 2-мя словами, а с топ 100/300/500 слов...
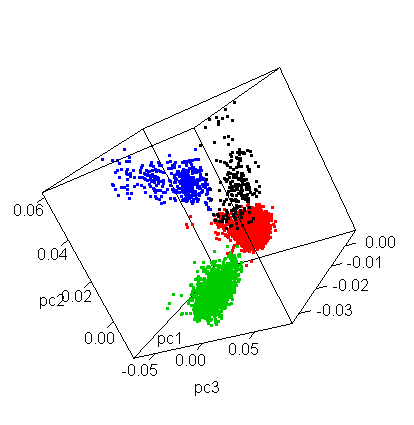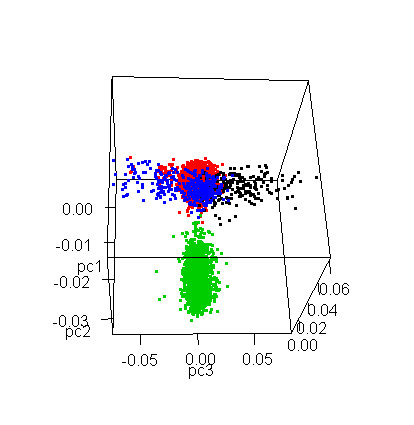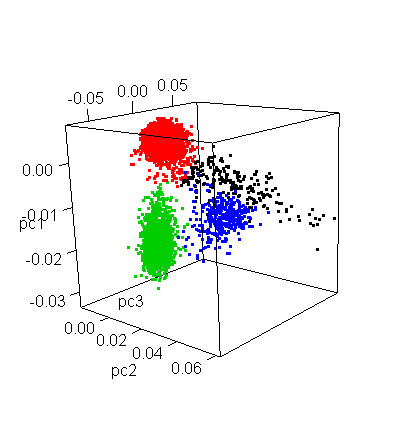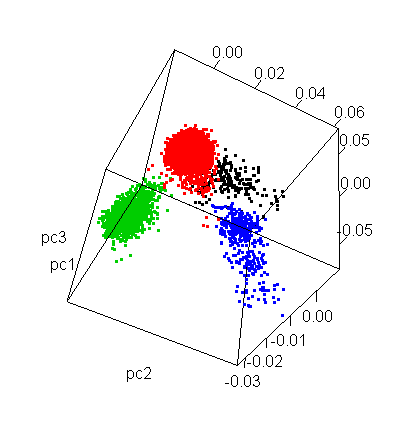
И оказывается, что топ N самых частотных слов в качестве features для векторов... ...группируют тексты по авторству

Для визуализации близостей чаще используется дендрограмма
Но все что понадобилось для ее создания— относительные частотности вот этих слов:
the and to of a was i in he said you that it his had on at her with as for not him they she were but be have up all out is from them me been what this about into like back my there would we could one now know if their so or no do down your an did by are when who looked more over then see again time just don^t still very think got will off re go eyes than before right here get away thought i^m came too through only long way going face come some can
И что, это правда работает?
Неужели частотности (в основном служебных) слов позволяют отличить одного автора от другого?
Да, и мы можем в этом убедиться вместе
Работает на русском:

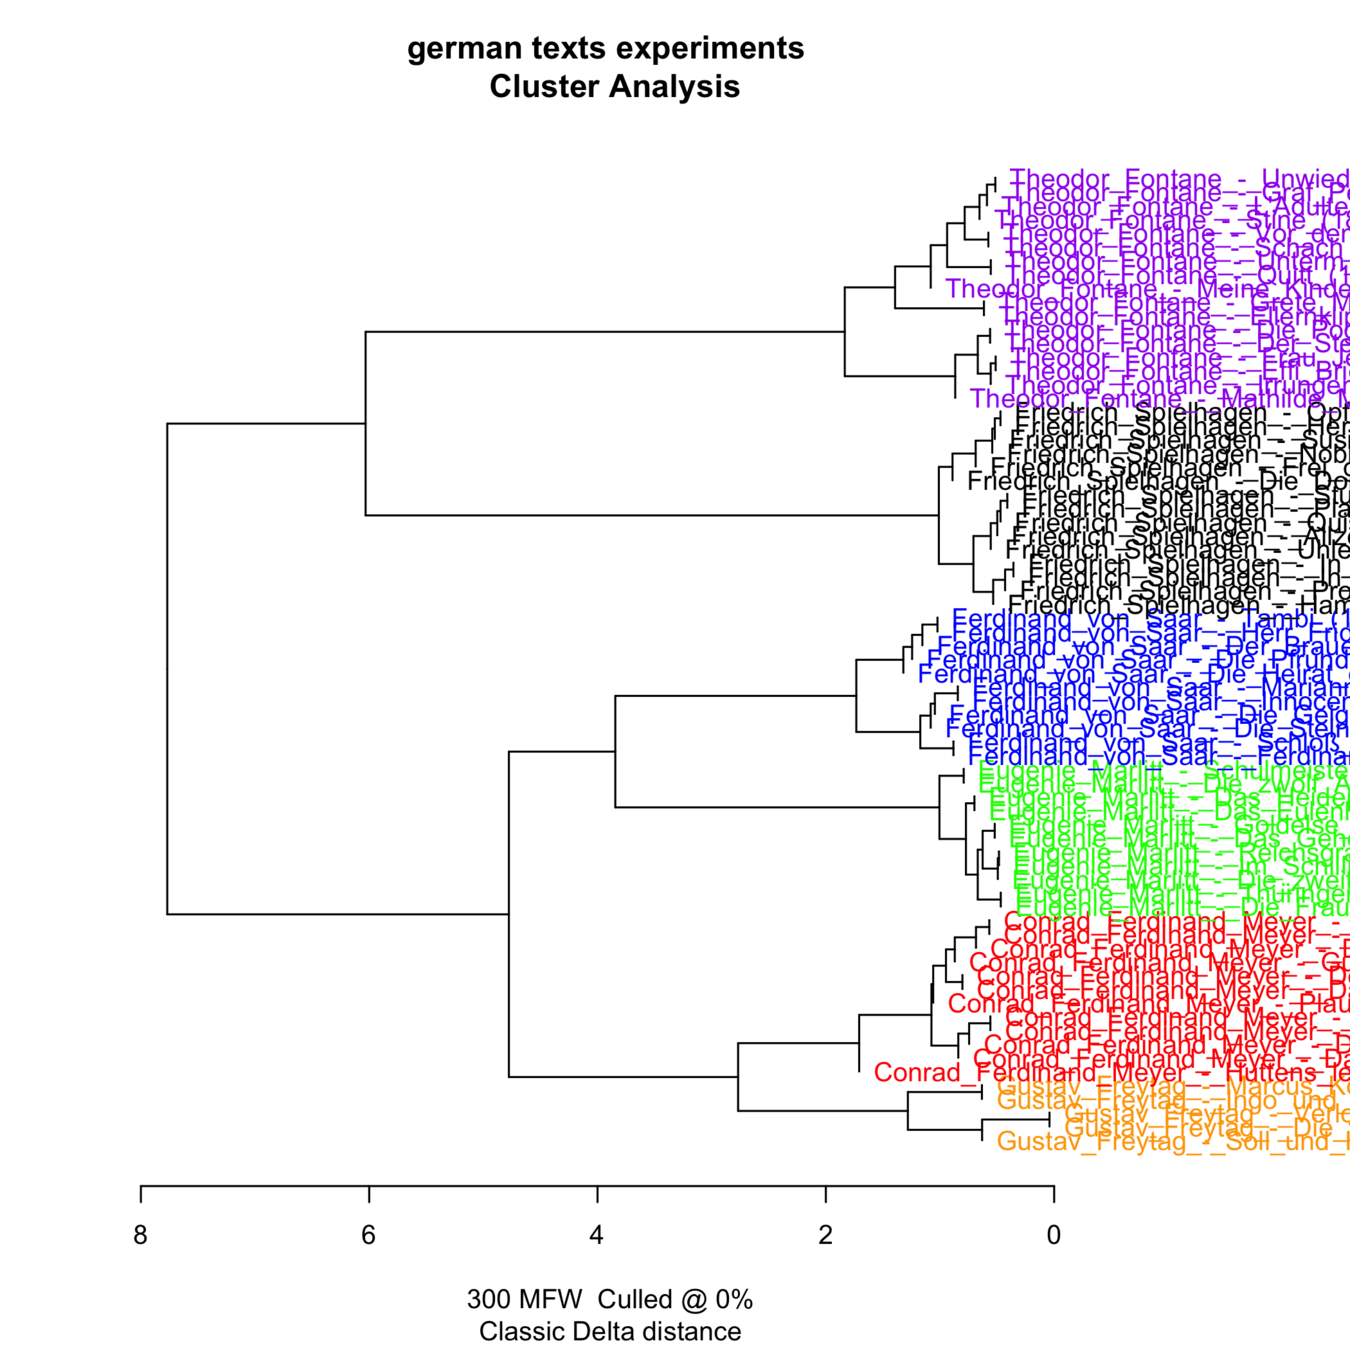
Работает на немецком
Работает на армянском

Работает на китайском

Но всегда ли это работает?
Disclaimer
- ⚠️ Стилометрия — это не магия и не «волшебная пуля»
- ⚠️ Есть случаи, когда никакая статистика вам автора не определит
- 🟢 Но при определенных условиях метод работает универсально (т.е. не на каком-то конкретном подобранном наборе авторов/ книг, а регулярно при соблюдении ряда условий)
Ограничения
- Наличие текстов-кандидатов
- Размеры текстов!
- Хронологическая однородность
- Однородность жанра/рода текста
2. Размер текста
(имеет значение)
It becomes quite obvious that samples shorter than 5000 words provide a poor "guessing", because they can be immensely affected by random noise. Below the size of 3000 words, the obtained results are simply disastrous. Other analyzed corpora showed that the critical point of attributive success could be found between 5000 and 10000 words per sample (and there was no significant difference between inflected and non-inflected languages).
Eder, M. (2015). Does size matter? Authorship attribution, small samples, big problem.
Digital Scholarship in the Humanities.
Жанровая и хронологическая неоднородности могут искажать результаты
"Not unexpectedly, it works least well with texts of a genre uncharacteristic of their author and, in one case, with texts far separated in time across a long literary career. Its possible use for other classificatory tasks has not yet been investigated".
John Burrows, ‘Delta’: a Measure of Stylistic Difference and a Guide to Likely Authorship, Literary and Linguistic Computing, Volume 17, Issue 3, September 2002, Pages 267–287, https://doi.org/10.1093/llc/17.3.267
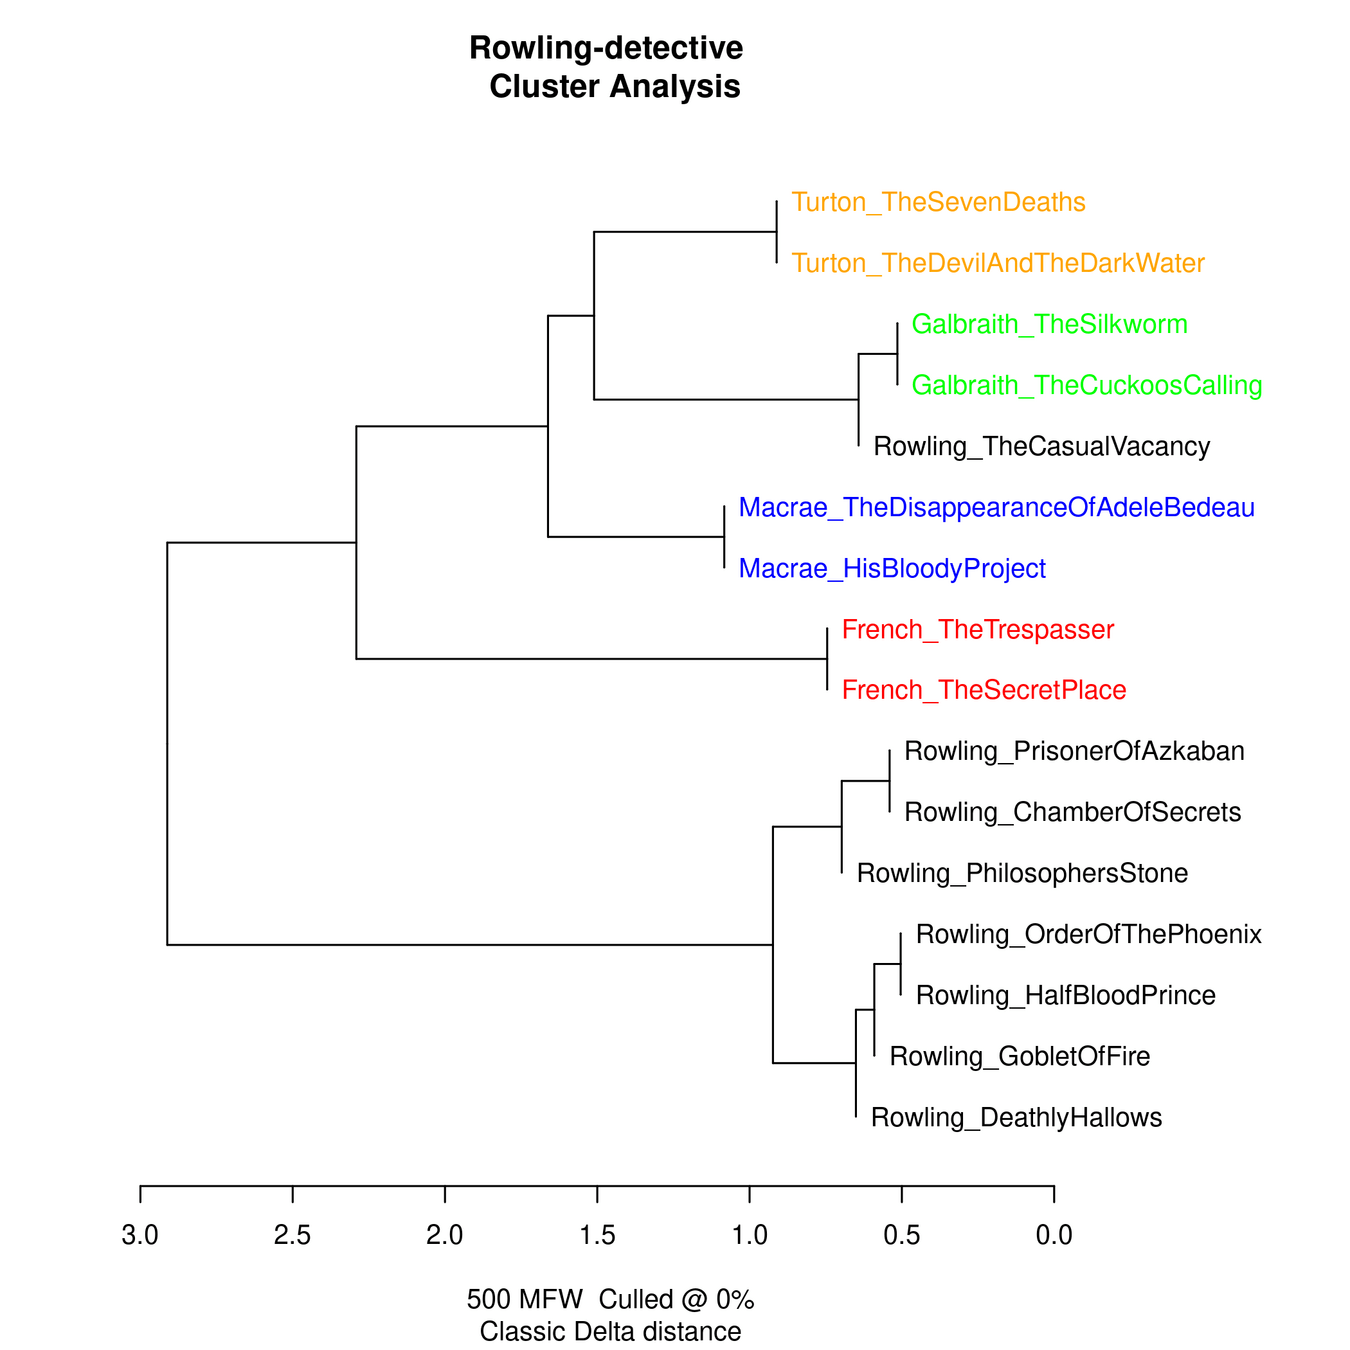
Более честный эксперимент с Роулинг:
Прочие нюансы метода
- Нормализация частотностей относительно друг друга
- Выбор вида расстояния между векторами
- Выбор единицы подсчета
Нормализация частотностей относительно друг друга
Посмотрим еще раз на вектор частотностей:
Наблюдаем классический закон Ципфа:

Поэтому в стилометрии частотности нормализуют
В классическом для стилометрии методе Delta для этого используется
Z-преобразование
Z-score (стандартный показатель)
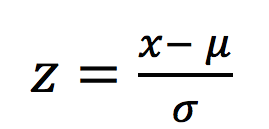
где
- x – частотность слова в тексте
- µ - общая частотность слова по корпусу
- σ - стандартное отклонение частотности слова по корпусу
(вычисляется для каждого слова в каждом тексте)
Z-преобразование

5. Выбор вида расстояния между векторами

Если измерять расстояние просто по прямой — будет

Бывают и другие:
Классический метод Delta использует манхэттенское

6. Выбор единицы подсчета
Словоформы (уже видели)
Цепочки символов длины N (символьные N-граммы)
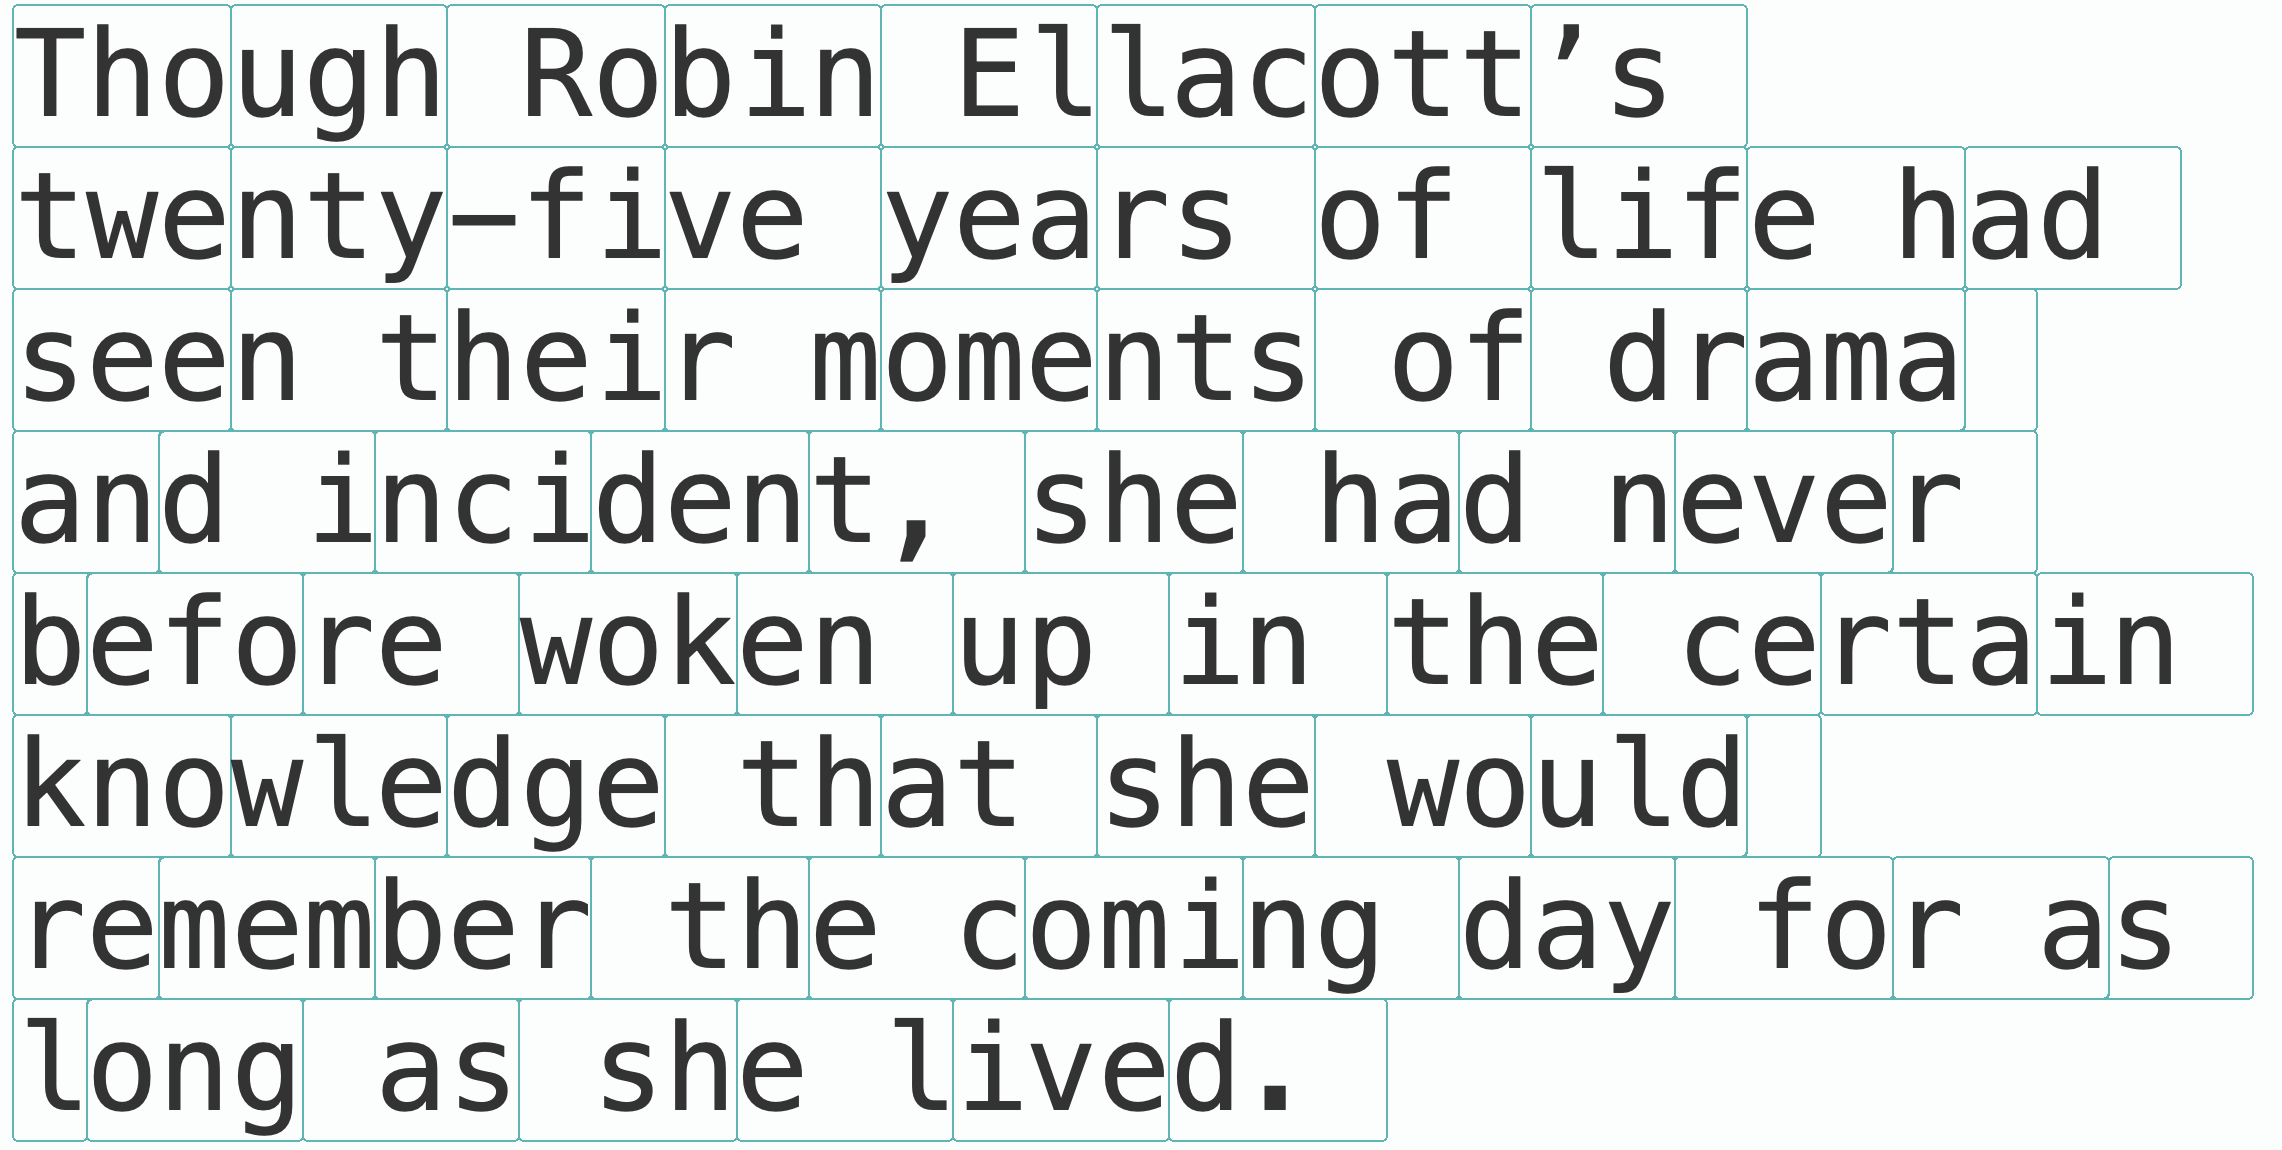
Леммы
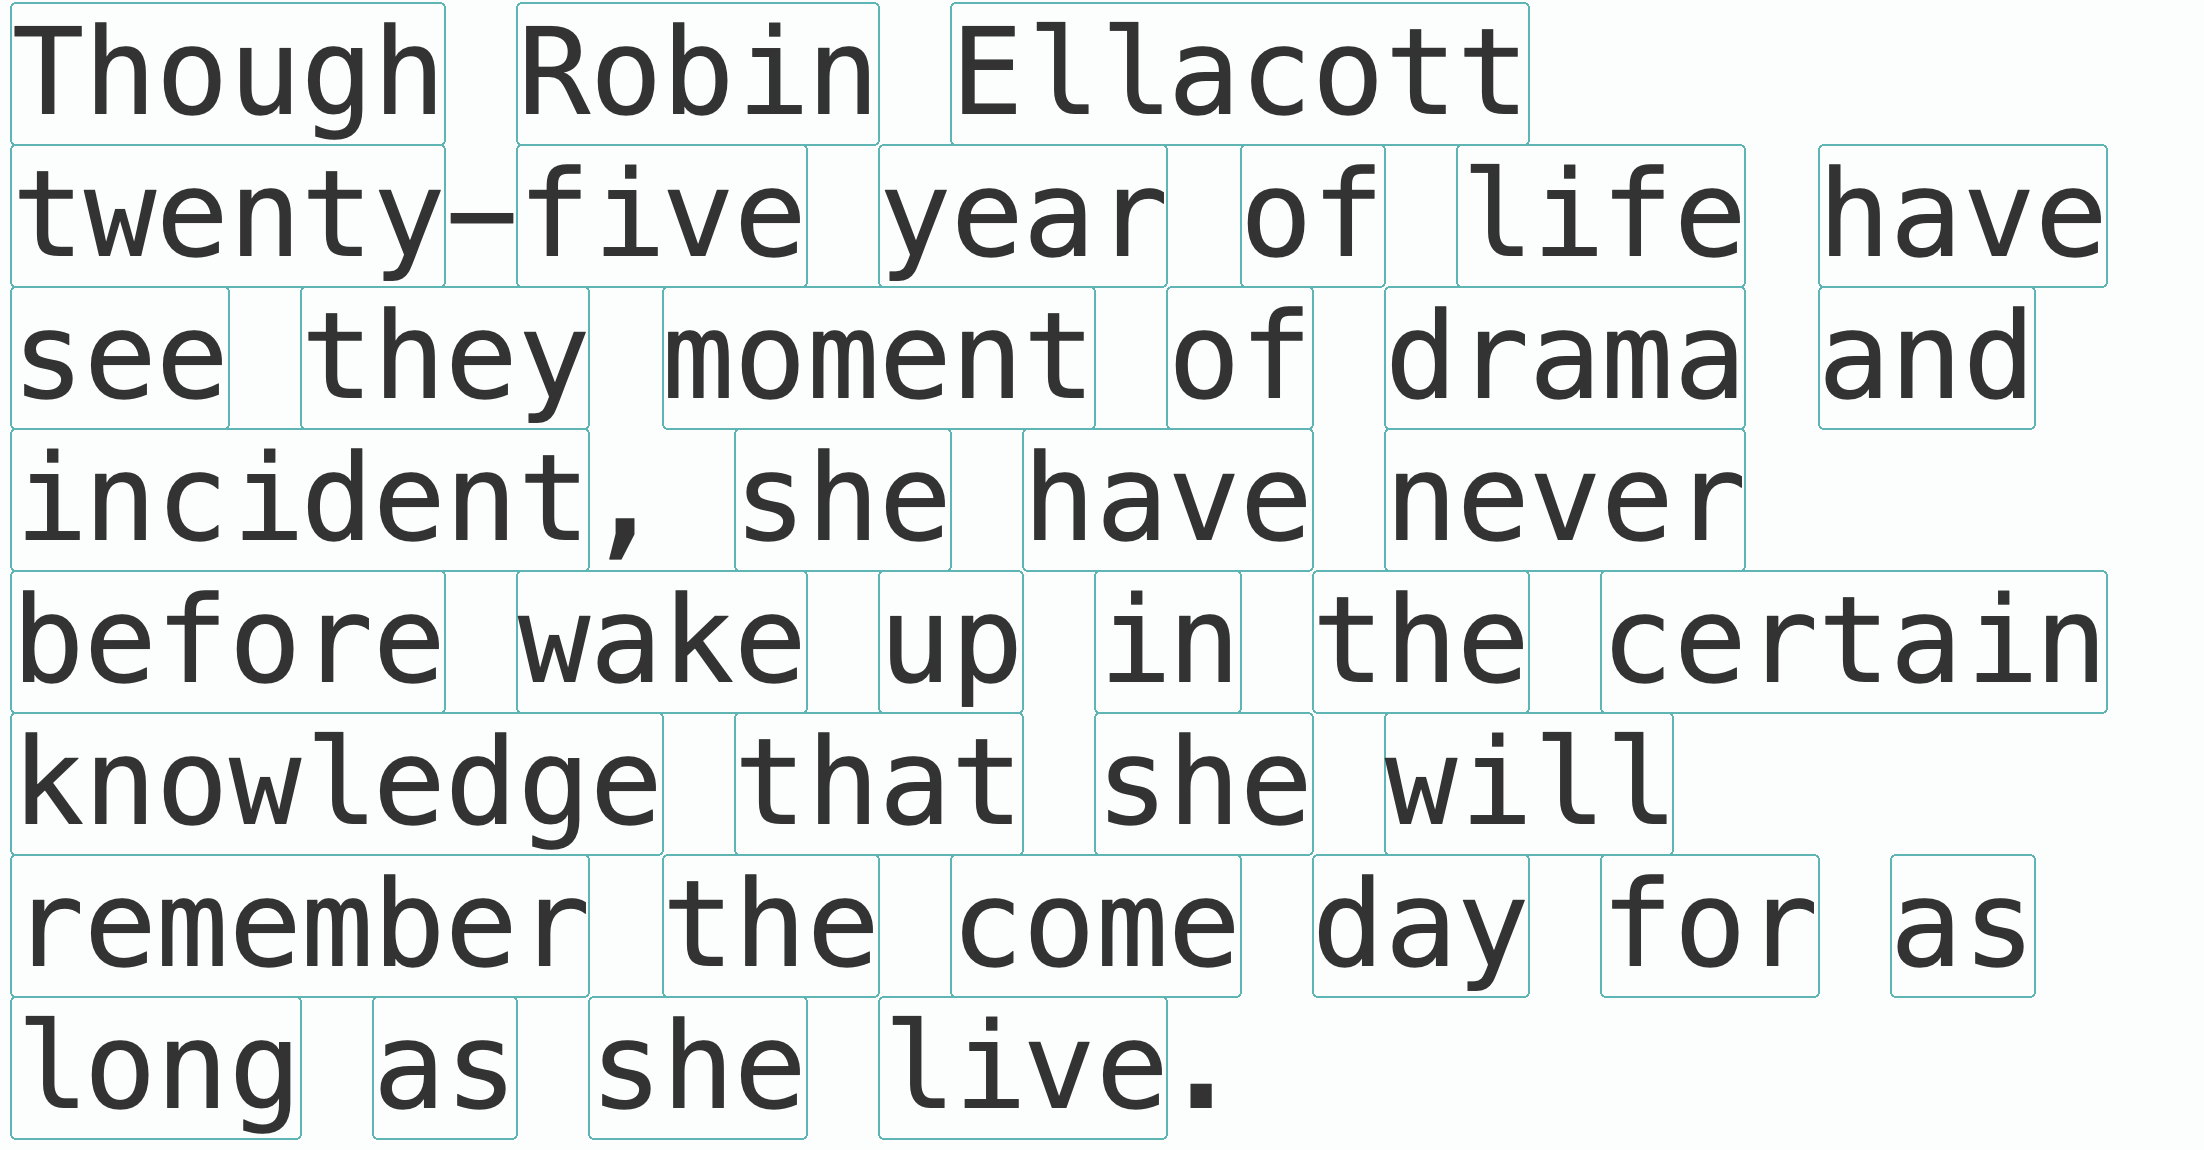
- Словоформы
- Леммы
- (конь/я/ю/ем/ями/ям/ем)
- N-граммы (цепочки) символов
- 'ая', 'овый', 'остью'
- Части речи
- Синтаксические структуры
- (в стихах) метр
- ...
на самом деле — все что угодно
Что можно посчитать

- Словоформы
- N-граммы (цепочки) символов
- 'ая', 'овый', 'остью'
- Леммы
- (конь/я/ю/ем/ями/ям/ем)
- Остальное — иногда
в рамках экспериментов
Что из этого реально работает для атрибуции
Способы отображения стилометрической близости:
Dimensionality reduction methods (PCA MDS tSNE etc)
Hierarchical clustering dendrograms
'Philogenetic tree'-like
dendrograms

Способы отображения стилометрической близости:
Weighted graphs
(Weighted networks)

Но все визуализации получаются на основе одной таблицы близости

Но все визуализации получаются на основе одной таблицы близости
Сделаем остановку для вопросов
3. Как люди до этого додумались?
Две классические задачи "детективной филологии", в решении которых развивалась стилометрия:
-
Авторство
-
Датировка
Первые измерения
-
1851 — математик А. де Морган предлагает длину слова как признак авторства
-
1887 — Томас Менденхолл (T. Mendenhall), The Characteristic Curves of Composition, первая известная работа по количественному определению авторства

Конец 19 в: Филологи-классики придумывают слово Stylometrie
-
1880 — W. Dittenberger, Sprachliche Kriterien für die Chronologie der Platonischen Dialoge
-
1890 — W. Lutosławski, Principes de stylométrie
-
1897 — W. Lutosławski, The origin and growth of Plato's logic; with an account of Plato's style and of the chronology of his writings

Стилеметрия в России
-
1915 — Морозов Н.А. Лингвистические спектры
(вдохновлен Лютославским) - Видимо, первый осознал важность служебных слов именно для атрибуции
- 1916 — Марков А.А. Об одном применении статистического метода

Записки федералиста
- Серия знаковых статей эпохи Американской революции
- 12 спорных (Хэмилтон или Мэдисон)
- Статья Ф.Мостеллера и Д. Уоллеса Inference in an Authorship Problem (1963)
- '...определить авторство записок федералиста и предложить стандартный метод для решения проблем авторства'

Word counts are the variables used for discrimination. Since the topic written about heavily influences the rate with which a word is used, care in selection of words is necessary. The filler words of the language such as an, of, and upon, and, more generally, articles, prepositions, and conjunctions provide fairly stable rates, whereas more meaningful words like war, executive, and legislature do not.
Mosteller, F. & Wallace, D. (1963): Inference in an Authorship Problem.
Mosteller, Wallace, 1963
- "The function words of the language appear to be a fertile source of discriminators, and luckily the high-frequency words are the strongest".
- These data make it possible to say far more than ever before that the odds are enormously high that Madison wrote the 12 disputed papers. <...>

Дж.Ф. Барроуз:
Most readers and critics behave as though common prepositions, conjunctions, personal pronouns, and articles — the parts of speech which make up at least a third of fictional works in English — do not really exist. But far from being a largely inert linguistic mass which has a simple but uninteresting function, these words and their frequency of use can tell us a great deal <...>
Preface to Computation into Criticism, 1987

Джон Барроуз придумывает метод Delta


А как работает Delta мы уже знаем:
- Подсчет частотностей слов / символьных n-грамм
2. Нормализация частотностей Z-преобразованием
3. Измерение манхэттенского расстояния между нормализованными векторами
Правда, Берроуз шел к этому эмпирически, по филологическмоу наитию

Мильтон на фоне Мильтона же:

Другой автор (Афра Бен) на фоне Мильтона:

Считаем расхождение для каждого слова в нашем списке:

Суммируем все расхождения — это и есть Delta:

Суммируем все расхождения — это и есть Delta:

Burrows’s Delta <...> corresponds to the Manhattan distance of the word frequencies' z-scores
Stefan Evert, Thomas Proisl, Fotis Jannidis, Isabella Reger, Steffen Pielström, Christof Schöch, Thorsten Vitt,
Understanding and explaining Delta measures for authorship attribution, Digital Scholarship in the Humanities, Volume 32, Issue suppl_2, December 2017, Pages ii4–ii16, https://doi.org/10.1093/llc/fqx023
Но почему это работает?
Да черт его знает...
"I think we should lock linguists and philologists in a room and not let them leave it until they explain what is happening"
(Ян Рыбицкий на одном из стилометрических докладов во время конференции DH 2019 в Утрехте)
4. Современные исследования
Кто такая Элена Ферранте

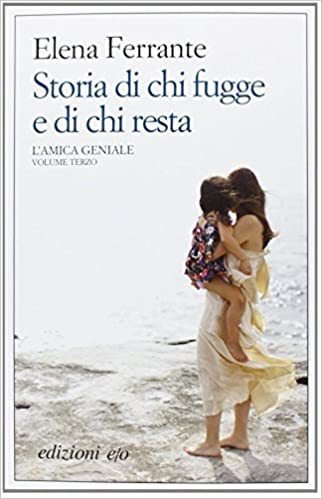
История вопроса
- Книги Элены Ферранте выходят с 1992 года
- В 2000-е Ферранте стала очень популярной — сначала в США, потом уже в Италии
- В 2005 журналист Луиджи Галелла сравнивал книгу Ферранте с романом писателя Доменико Старноне и нашел текстовые сходства
- В 2006 тот же журналист опубликовал количественное исследование книг Ферранте, Старноне и др. итальянских авторов, сделанное физиком Витторио Лоретто; Доменико Старноне снова оказался ближе всех
- В 2016 журналист Клаудио Гатти исследовал финансовые потоки издательства E/О — и указал на переводчицу Аниту Райа (Anita Raja)


150 современных итальянских авторов, сеть стилометрической близости


Результаты параллельных исследований
Blended Authorship Attribution: Unmasking Elena Ferrante Combining Different Author Profling Methods (G. Mikros):
all profling results were highly accurate (over 90%) indicating that the person behind Ferrante is a male, aged over 60, from the region Campania and the town Saviano. The combination of these characteristics indicate a single candidate (among the authors of our corpus), Domenico Starnone.


Все следы ведут к Старноне

И тольео некоторые к Аните Райа..

И тольео некоторые к Аните Райа.. которая замужем за Старноне
Кто написал "Убить пересмешника"?
Харпер Ли

Харпер ли?
Споры вспыхнули в 2015:

Причины подозрений
(не связанные с текстом)
- После публикации «Убить пересмешника» Ли не публиковала ни одной книги 55 лет
- Рукопись была «случайно найдена» адвокатом Ли.
- В 2015 году Ли было 88 лет, она сильно болела и жила в доме престарелых
- Власти Алабамы даже провели расследование дееспособности Ли
- Противоречивые версии того, что это за манускрипт: черновик «Убить пересмешника»
или «отдельное произведение в той же вселенной»
Причины подозрений
(связанные с текстом)
- Многим «новая» книга показалась «слабой» по сравнению с классической «Убить пересмешника».
- Сюжетно новый текст является продолжением (главный герой – взрослый человек), хотя утверждается, что он был написан ранее.
- Большое разочарование в Аттикусе Финче, который в «новой» книге оказывается своего рода расистом (хотя был символом борьбы с расизмом)
Возник вопрос: написаны ли эти две книги одним человеком?

Харпер Ли и Трумен Капоте


Почему Капоте
- Друг детства Харпер Ли (выросли в одном городе, которой и стал прототипом Мэйкома из "УП")
- Капоте — прототип Дилла из "УП"
- Когда Харпер Ли публиковала "УП", Капоте ничего крупного не публиковал
- После 1960 не публиковалась уже Харпер Ли
- Зато Капоте написал свою знаменитую true-crime книгу "In Cold Blood" — и известно, что Харпер Ли ездила с ним собирать материал
- Гипотеза: "Капоте — со-автор или даже основной автор "УП". Харпер Ли отблагодарила его помощью в работе с In Cold Blood"
Это и отправились проверять стилометристы

Одна из визуализаций результата
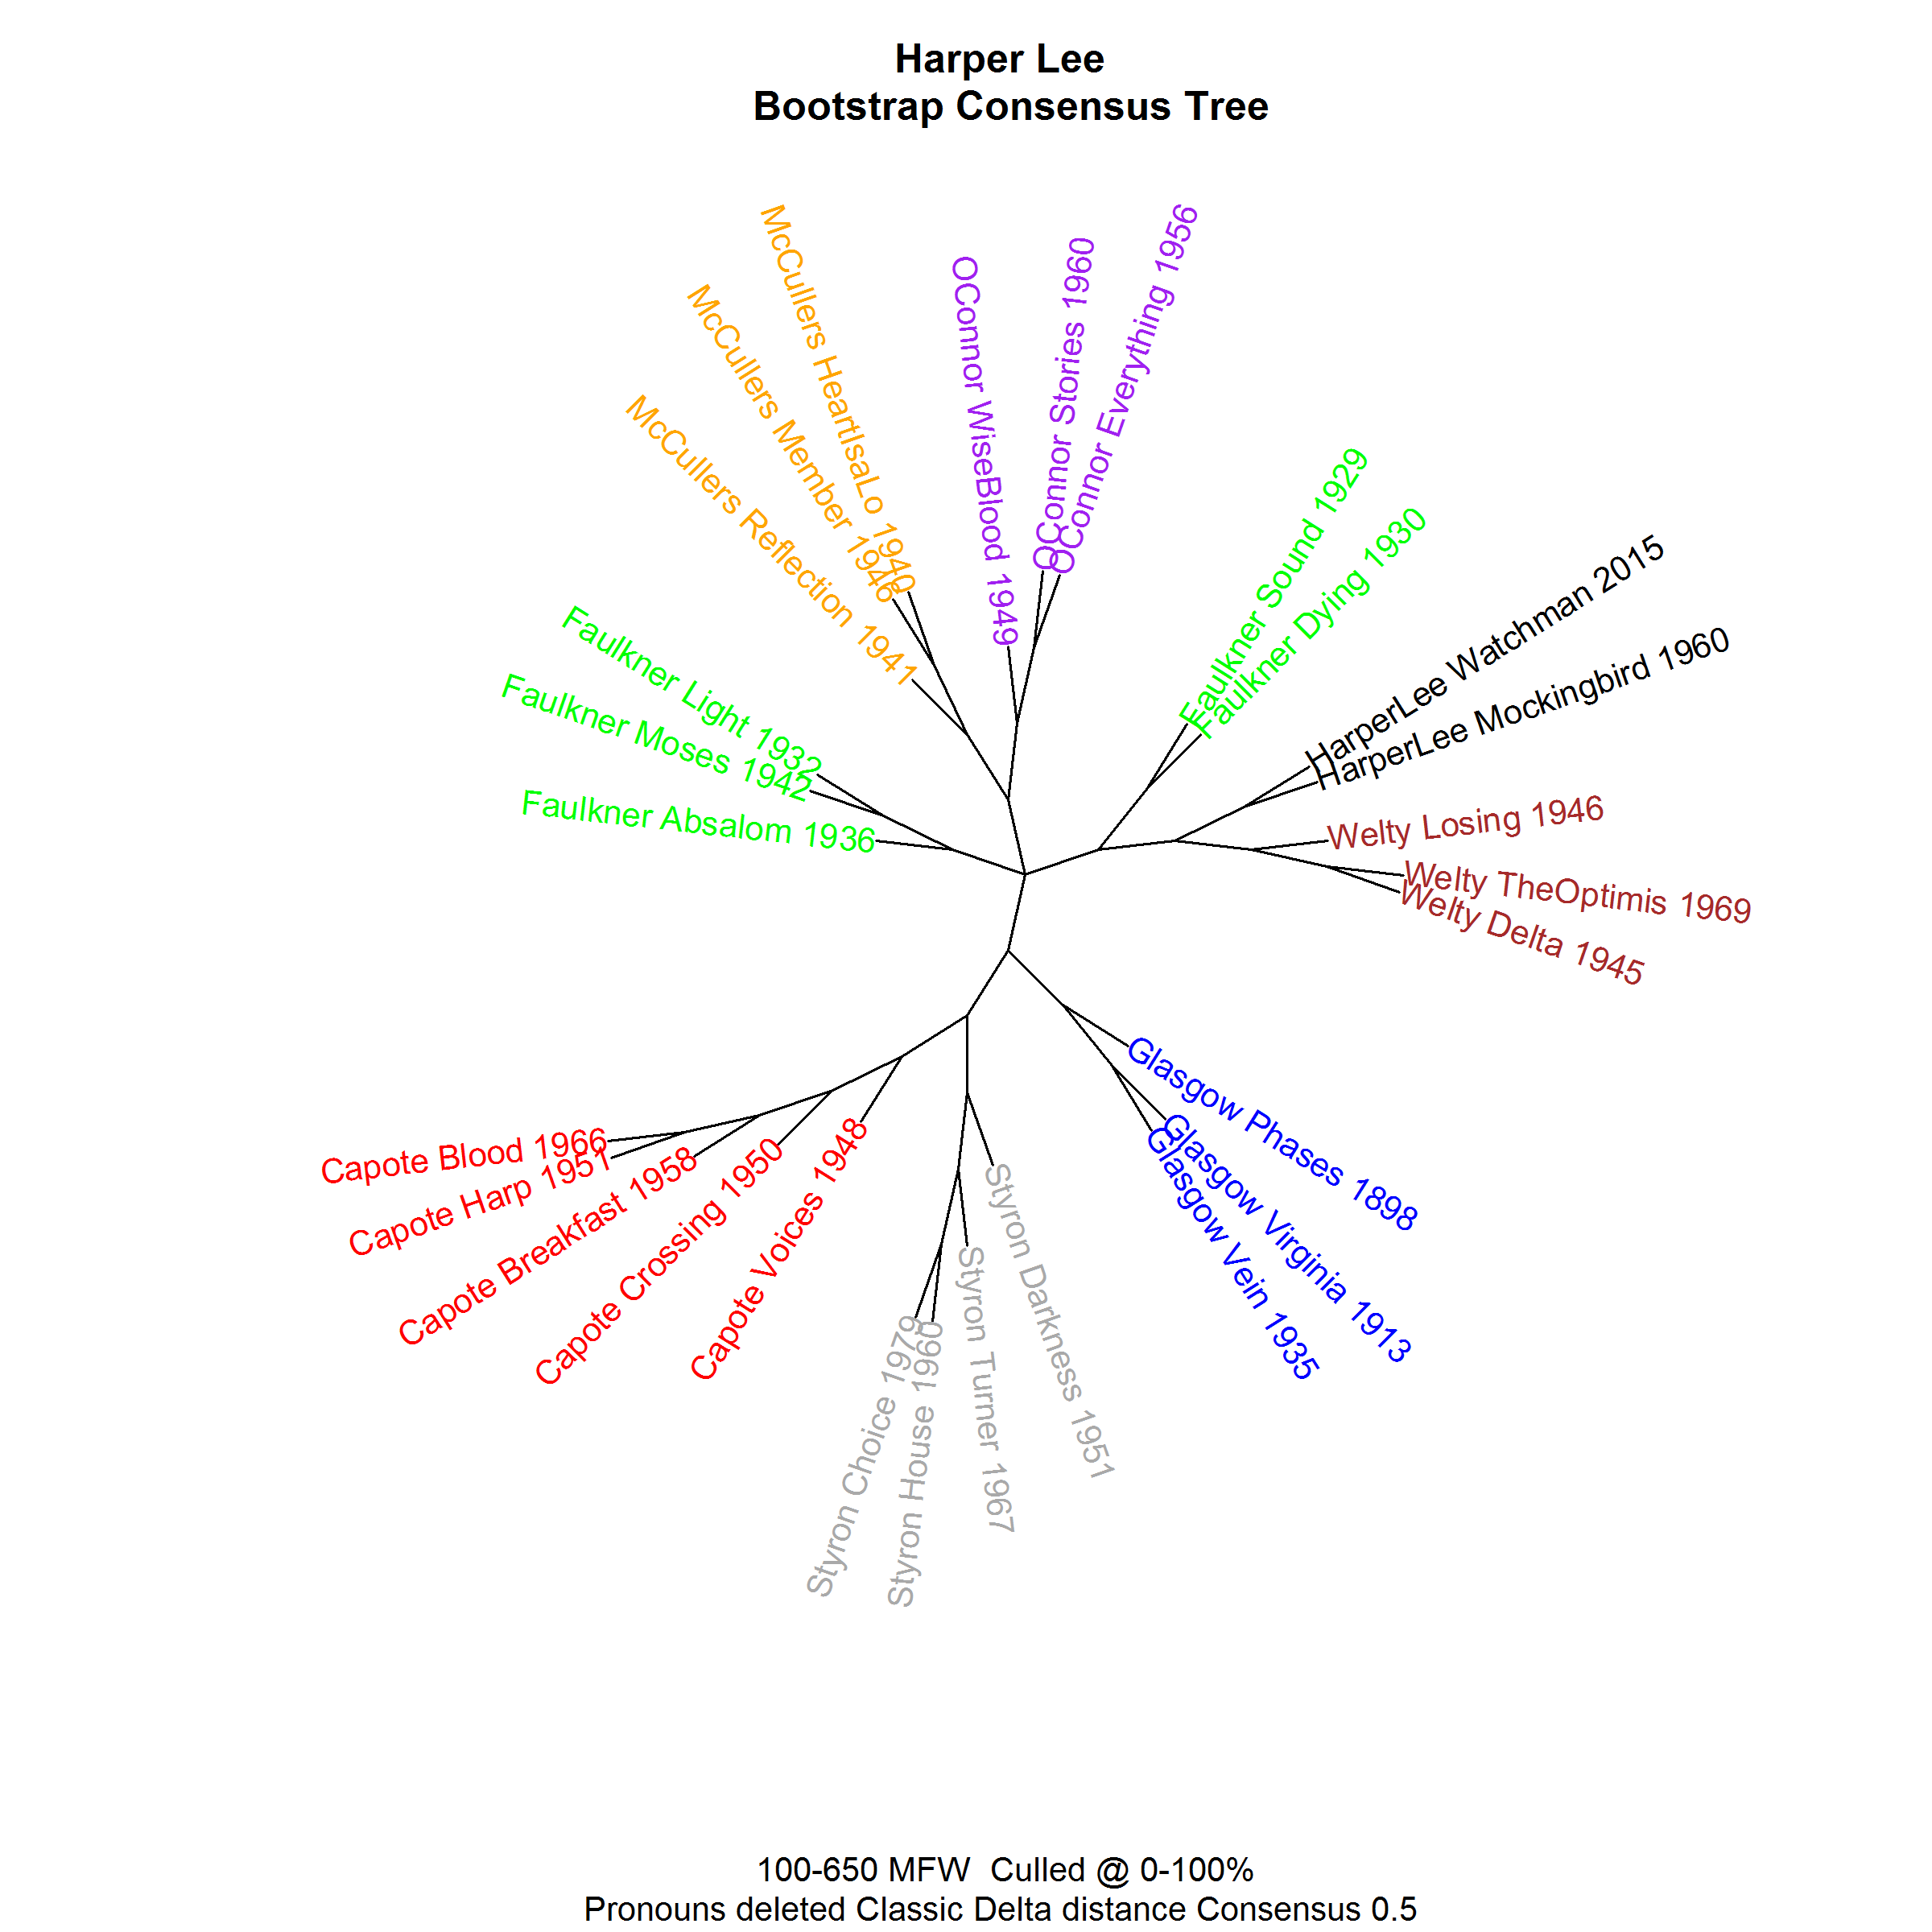
То же самое в виде сети стилометрической близости:
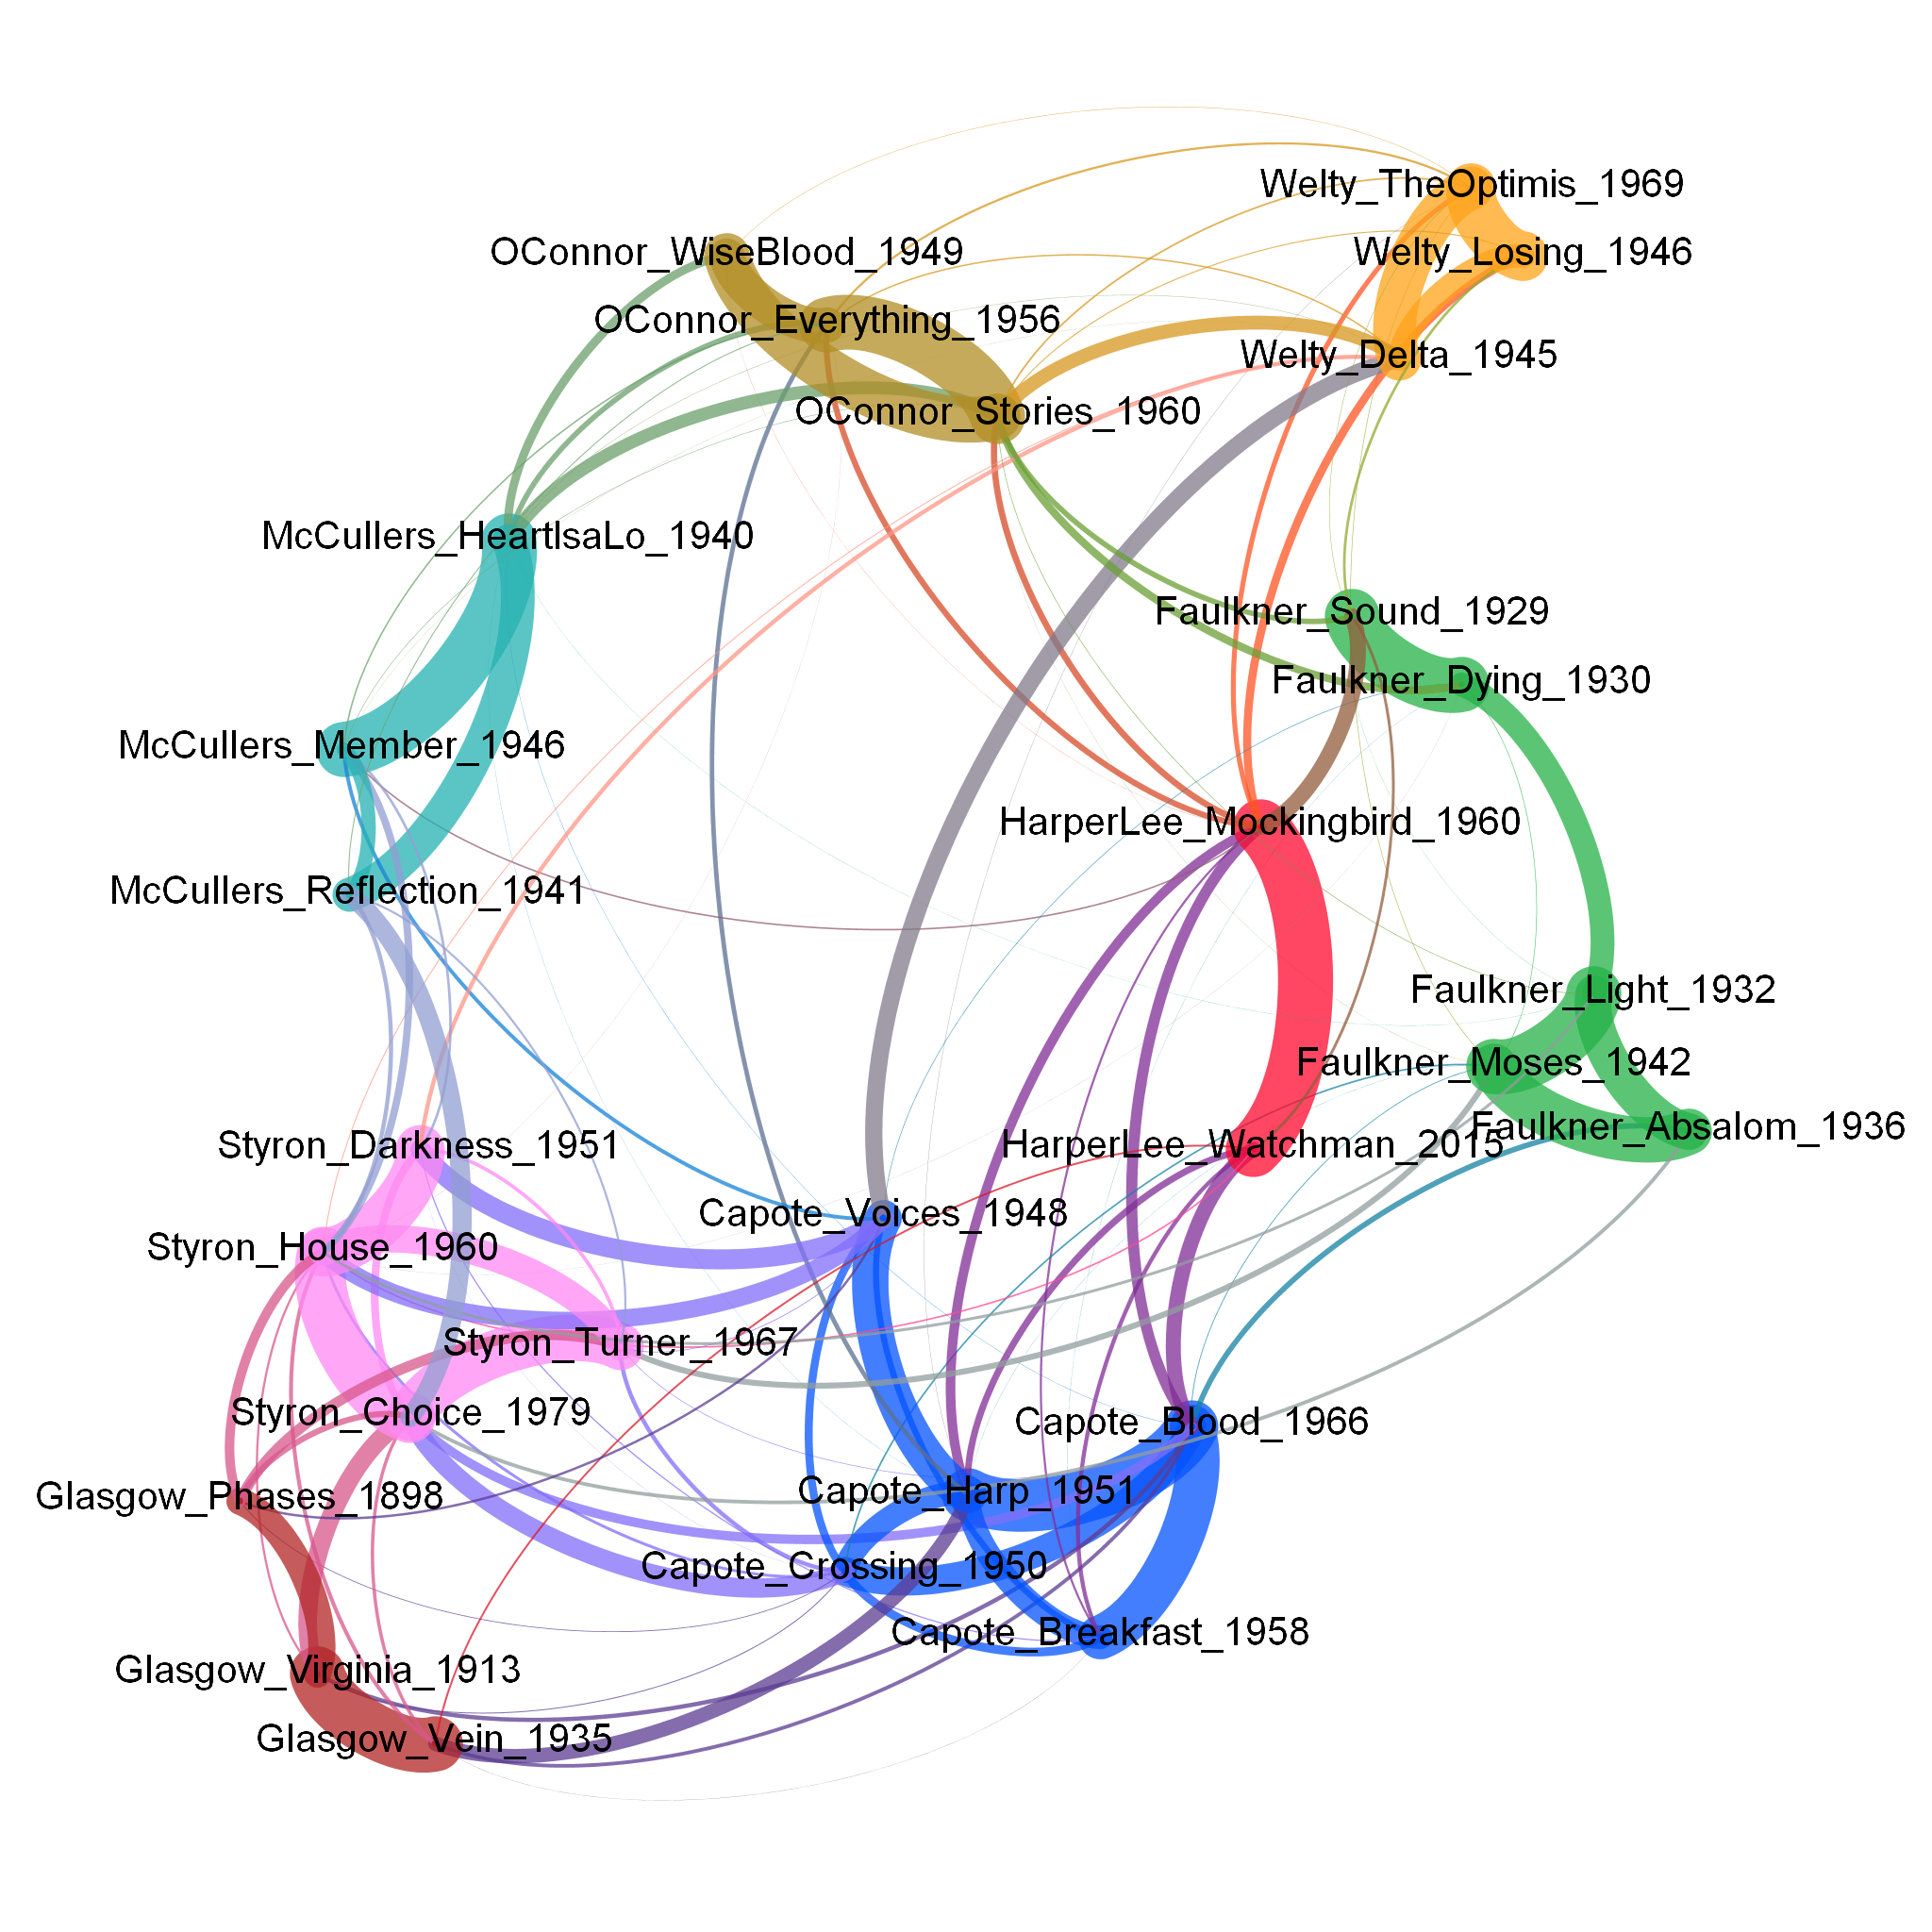
Что читать об этом
- Go Set A Watchman while we Kill the Mockingbird In Cold Blood — публикация 2015 года, где есть Ли и Капоте
- Go Set A Watchman while we Kill the Mockingbird in Cold Blood, with Cats and Other People — продолжение 2016 года, где появляется еще и Хохофф
Современные исследования за пределами атрибуции
But the study of literature and authorship is not only who wrote what, and who didn’t
Maciej Eder, Jan Rybicki (2016). Go Set A Watchman while we Kill the Mockingbird in Cold Blood, with Cats and Other People
Не только авторство
- Коллаборация над текстом
- соавторство
- Перевод и влияние переводчика
- Влияние редактора
- Внутриавторская вариативность
- Жанровая кластеризация
- Датировка и эволюция стиля автора (стилохронология)
Коллаборация над текстом
Оригиналы и переводы
Оригиналы на французском:

Переводы на английский

Google Translate и DeepL тоже так могут:

Хотя раньше стилометрический сигнал машинного перевода был виден
Кейс с переводом двумя переводчицами
"Ночь и день" Вирджинии Вулф, перевод на польский

Anna Kołyszko -> Magda Heydel

метод: rolling.classify ()
- динамический анализ (хорошо для исследования коллаборации авторов)
- считается Delta-расстояние в текстовом окне
- Подробнее см. rolling stylomety

а вот мой тест этого метода

Anna Kołyszko -> Magda Heydel

J. Rybicki, M.Heydel. The stylistics and stylometry of collaborative translation: Woolf’s Night and Day in Polish // Literary and Linguistic Computing 28 (4), 708-717
rolling.classify() увидел переход:
Коллаборация автора и редактора
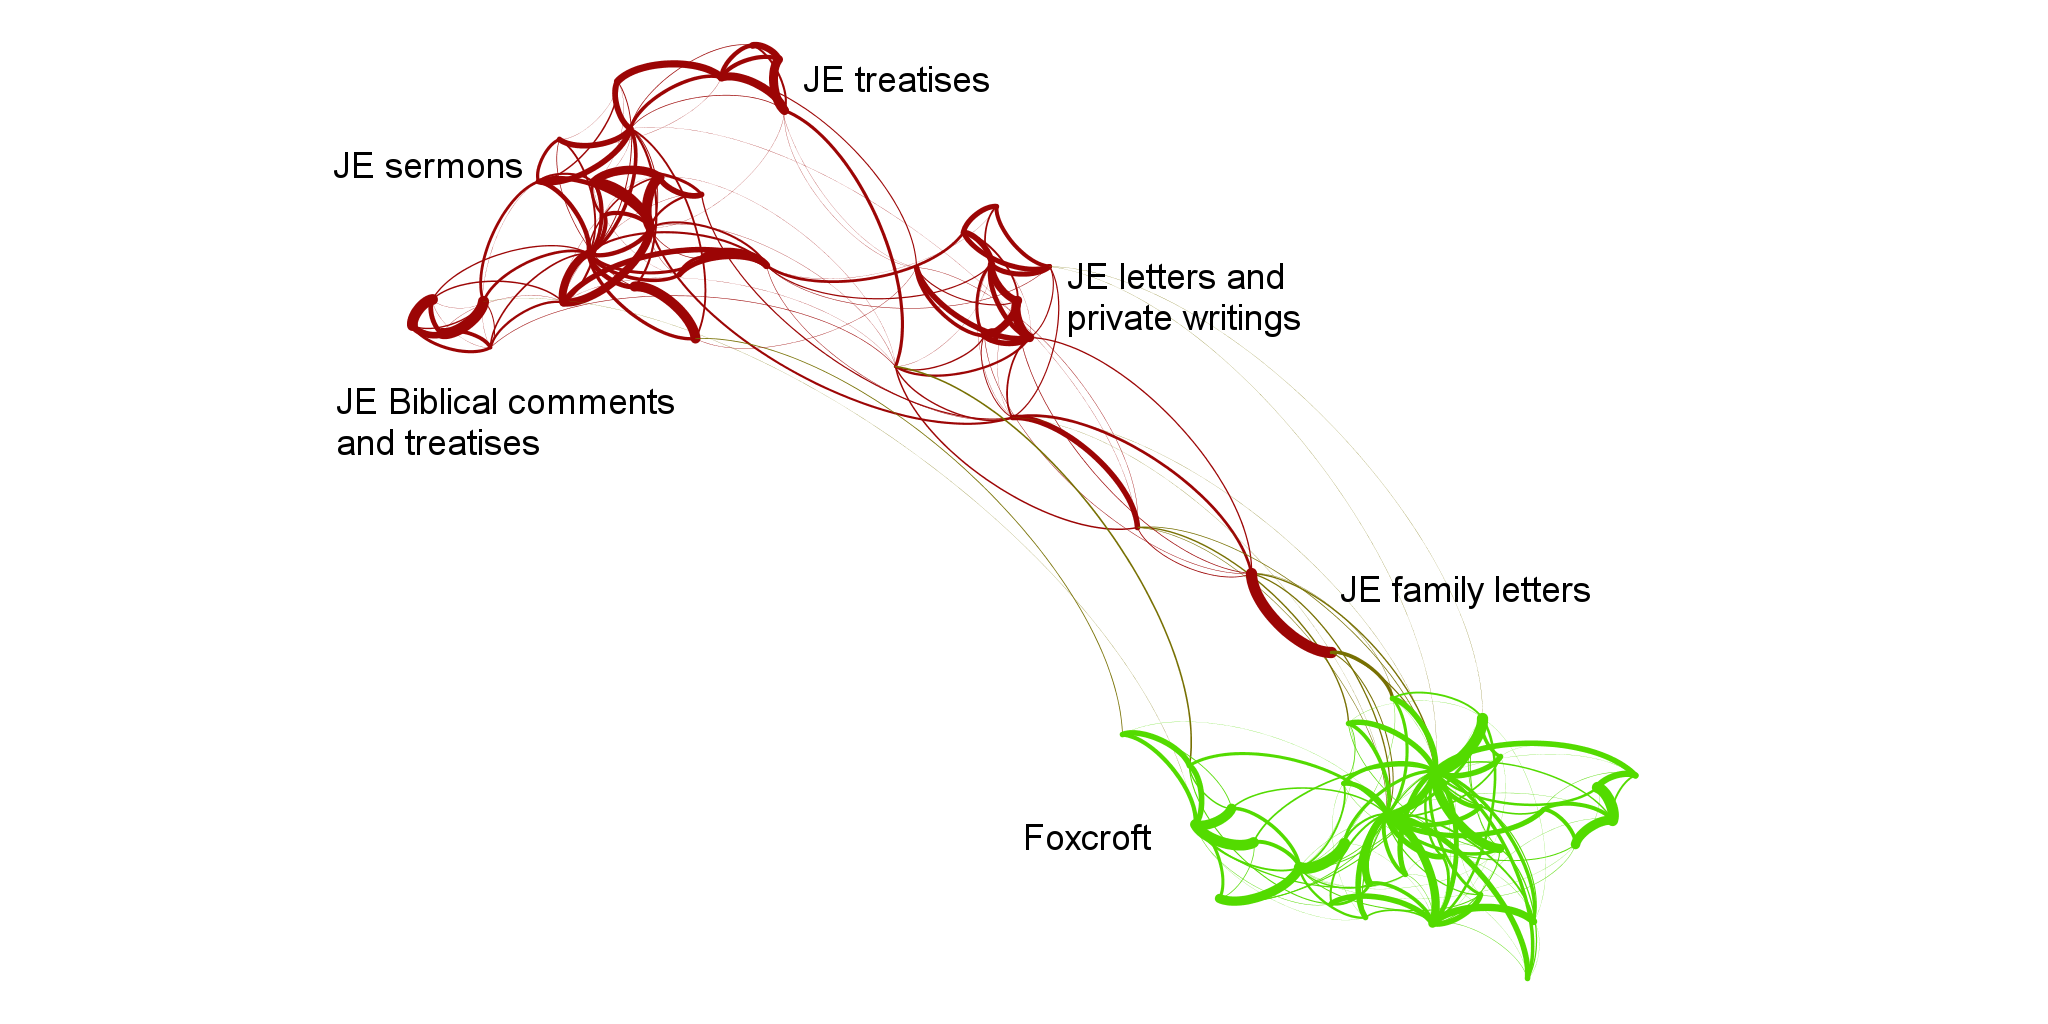
Choiński, M., Rybicki, J. (2016). Jonathan Edwards and Thomas Foxcroft: In Pursuit of Stylometric Traces of the Editor. In Digital Humanities 2016: Conference Abstracts. Jagiellonian University & Pedagogical University, Kraków, pp. 147-149.
Молодой Эдвардс: никакого влияния
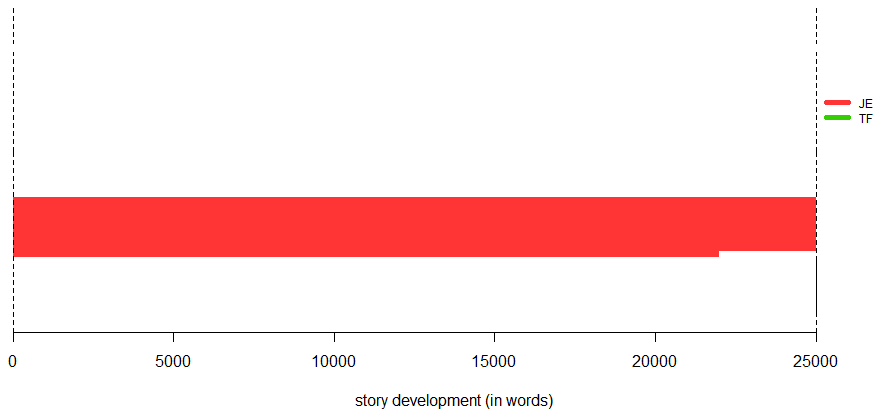
Consecutive segments of Edwards's Mind (1723); throughout the work, Edward's signal (red) dominates over the (absent) signal of Foxcroft.
Пожилой Эдвардс: влияние секретаря становится видно
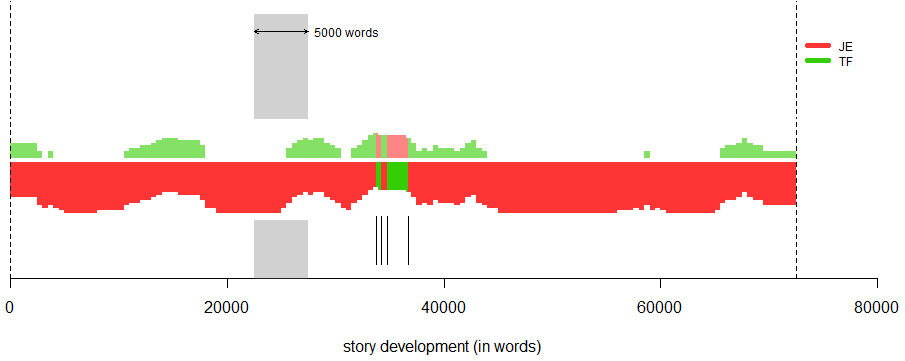
Consecutive segments of Edwards's Humble Inquiry (1749); in many other fragments, dominated by Edwards (red), Foxcroft's impact is still visible. The lower band shows the strongest signal; the upper, the second strongest.
Внутриавторская стилометрия
-
Знаковый португальский поэт XX века
-
Мастер модернизма
-
Использовал не менее 72 «гетеронимов»
-
3 основных:
-
Альберто Каэйро (легенда: пастух-самоучка)
-
Альваро де Кампуш (легенда: отставной морской офицер, живущий в Глазго)
-
Рикардо Реиш (легенда: доктор, любитель классики, латинист)
-
-
… и «собственно Пессоа» (ортоним Пессоа), не тождественный человеку-Пессоа
Кейс Пессоа

-
Caeiro escrevia mal o português, Campos razoavelmente mas com lapsos como dizer "eu próprio" em vez de "eu mesmo", etc., Reis melhor do que eu, mas com um purismo que considero exagerado.
[Каэйро пишет по-португальски плохо, Кампуш — относительно неплохо, но с ошибками вроде "eu próprio" вместо "eu mesmo", а Реиш пишет лучше чем я, но с той степенью пуризма, которая мне кажется избыточной]
(письмо Фернандо Пессоа к Адольфо Монтейро, 13 января 1935)
Кейс Пессоа
Первый тест: Пессоа и гетеронимы
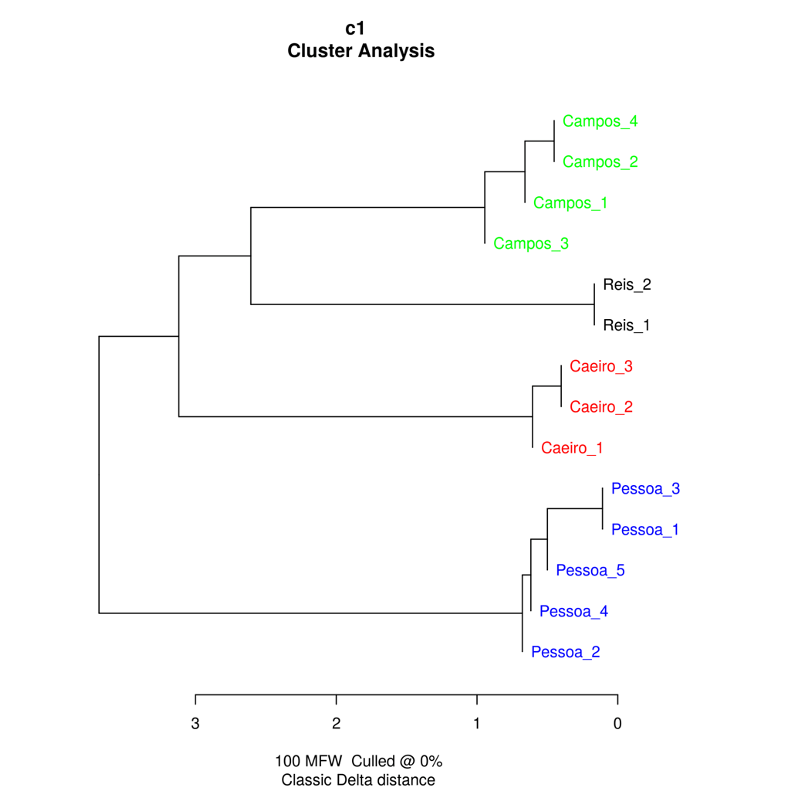
Skorinkin D., Orekhov B. Hacking stylometry with multiple voices: imaginary writers can override authorial signal in Delta. In: Digital Scholarship in the Humanities, 2023
Взболтать, перемешать, снова взболтать…
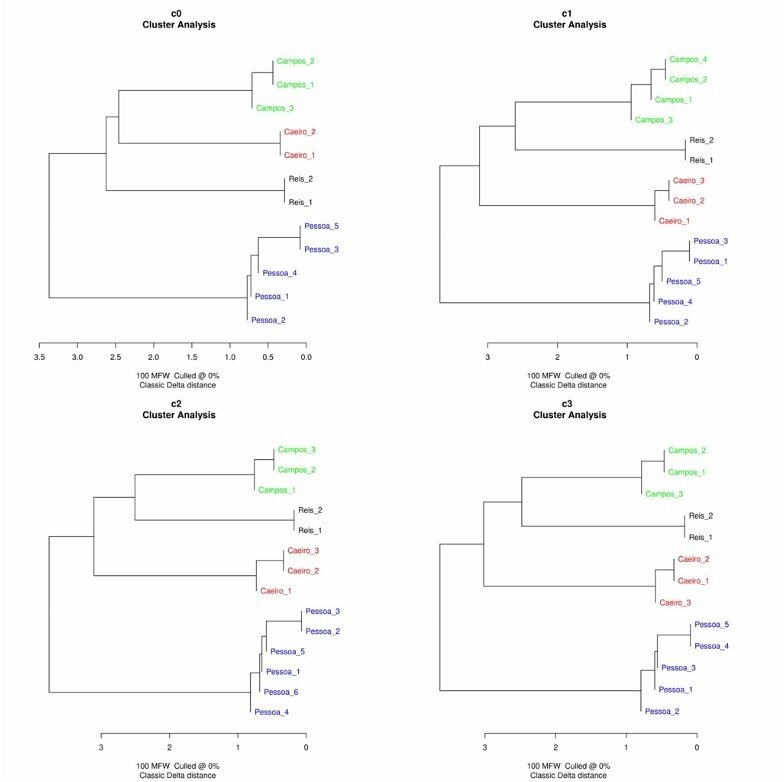
Skorinkin D., Orekhov B. Hacking stylometry with multiple voices: imaginary writers can override authorial signal in Delta. In: Digital Scholarship in the Humanities, 2023
Внутри корпуса поэтических текстов Пессоа стилометрия ловит сигнал гетеронима
Добавим других лузофонных поэтов той же эпохи
Первый тест: Пессоа и гетеронимы
Skorinkin D., Orekhov B. Hacking stylometry with multiple voices: imaginary writers can override authorial signal in Delta. In: Digital Scholarship in the Humanities, 2023
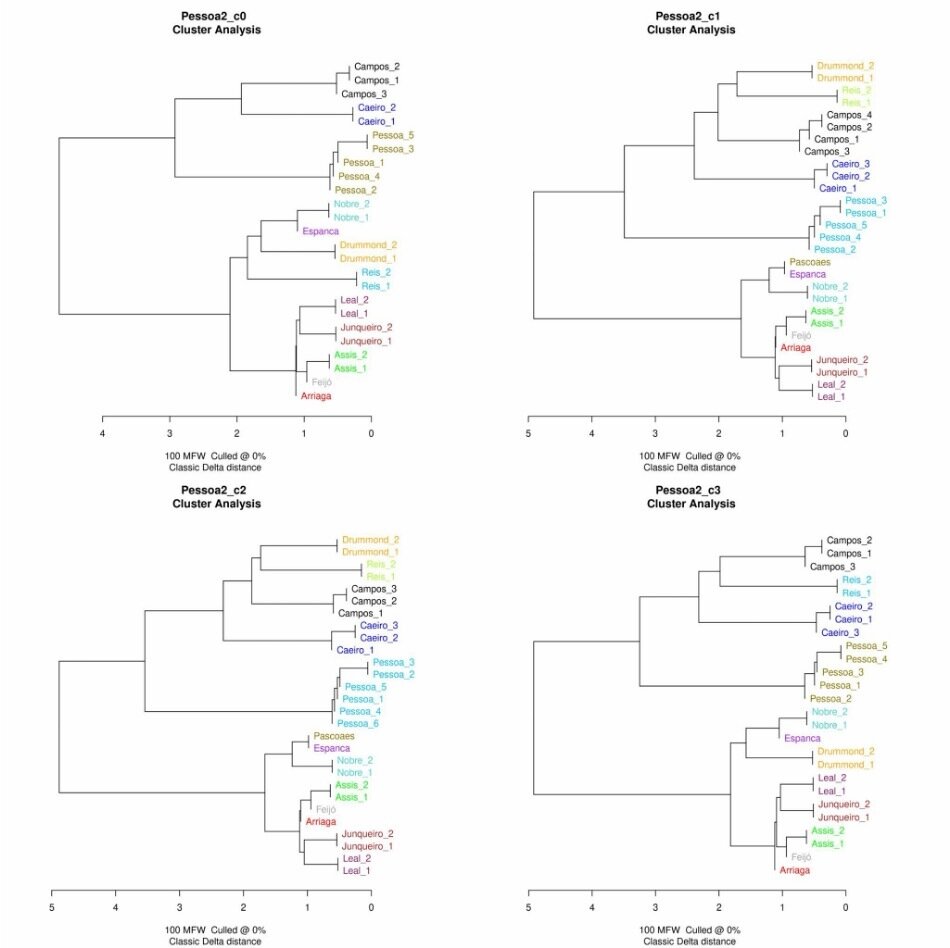
Сетевая визуализация одного и экспериментов

Skorinkin D., Orekhov B. Hacking stylometry with multiple voices: imaginary writers can override authorial signal in Delta. In: Digital Scholarship in the Humanities, 2023
Реальная матрица стилометрич. близости
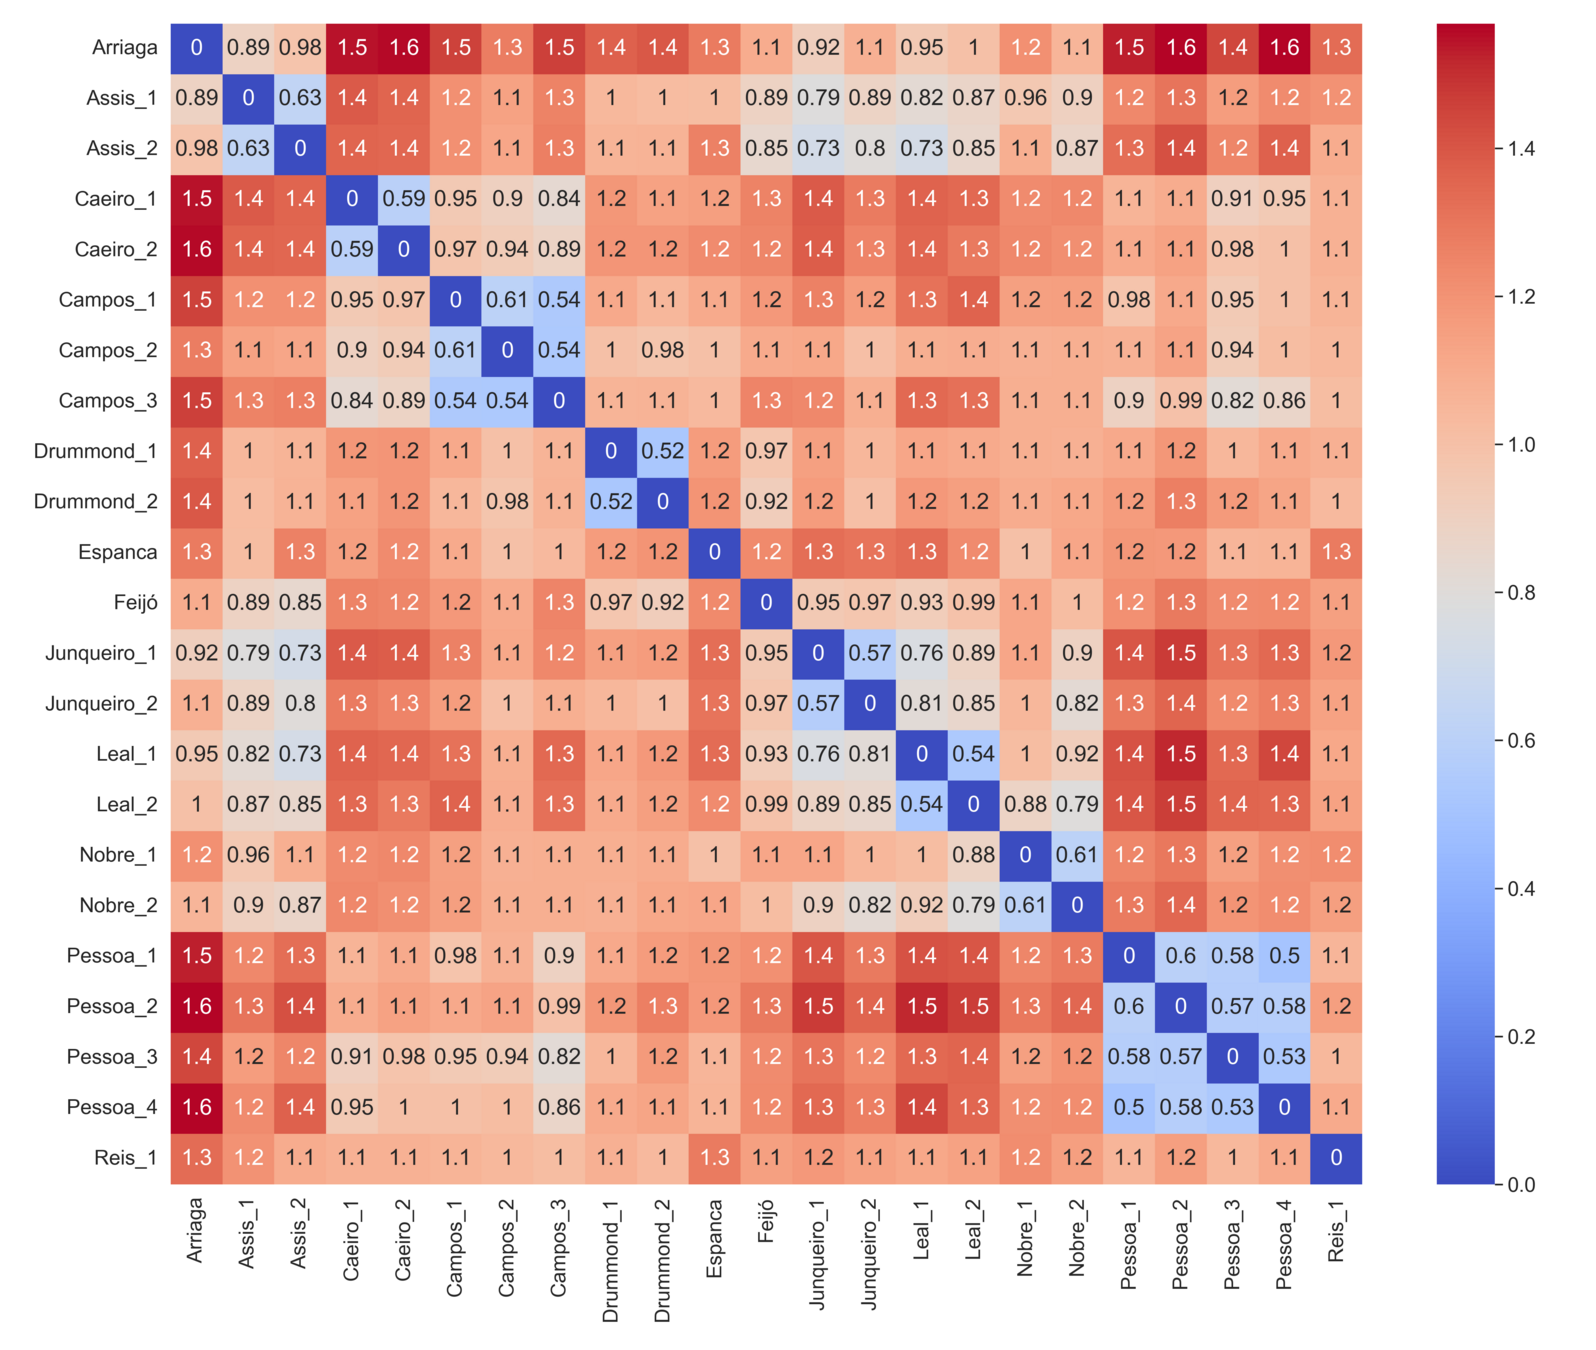
Skorinkin D., Orekhov B. Hacking stylometry with multiple voices: imaginary writers can override authorial signal in Delta. In: Digital Scholarship in the Humanities, 2023
Распределение расстояний (внутриавтрские, межавторские, и меж-гетеронимные)
Skorinkin D., Orekhov B. Hacking stylometry with multiple voices: imaginary writers can override authorial signal in Delta. In: Digital Scholarship in the Humanities, 2023
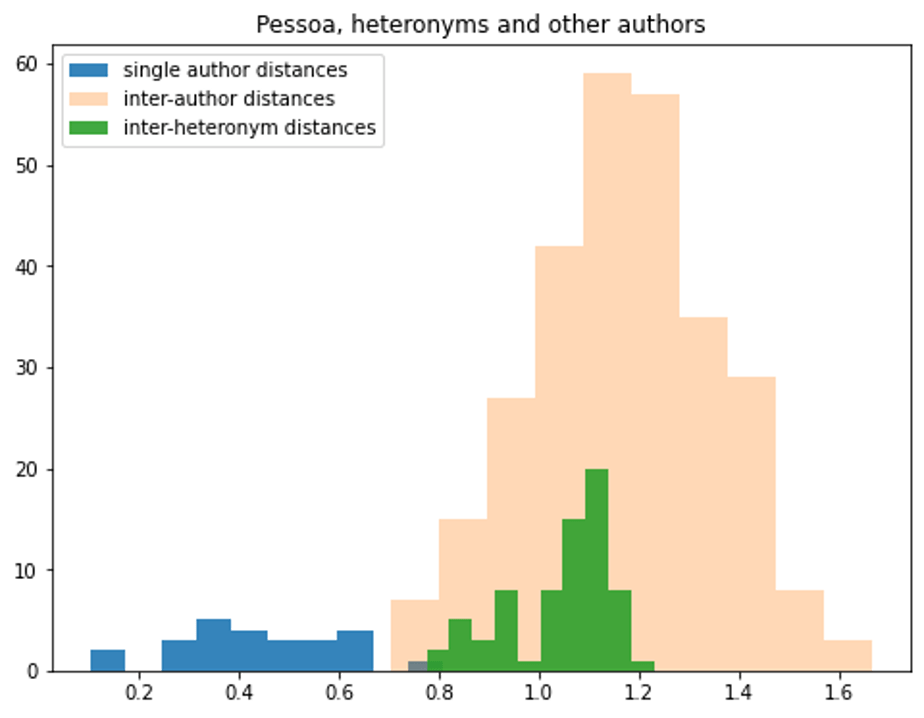
Другие внутриавторские кейсы
Диккенс: датировка

Maciej Eder, Jan Rybicki
Шекспир: датировка + жанры

Агата Кристи: датировка и...

...псевдоним

Мэри Вестмакотт ≈ Роберт Гэлбрейт
Толстой: датировка + циклы?

Заметим, что хронологический сигнал проявляется чаще прочих факторов
И тут конечно можно вспомнить истоки стилометрии — как Лютославский и ко занимались хронологией диалогов Платона
Об этом же говорит и Бёрроуз в самом начале статьи про Delta
Not unexpectedly, it works least well with texts of a genre uncharacteristic of their author and, in one case, with texts far separated in time across a long literary career. Its possible use for other classificatory tasks has not yet been investigated.
John Burrows, ‘Delta’: a Measure of Stylistic Difference and a Guide to Likely Authorship, Literary and Linguistic Computing, Volume 17, Issue 3, September 2002, Pages 267–287, https://doi.org/10.1093/llc/17.3.267
P.S. А что там со сгенерированными текстами?
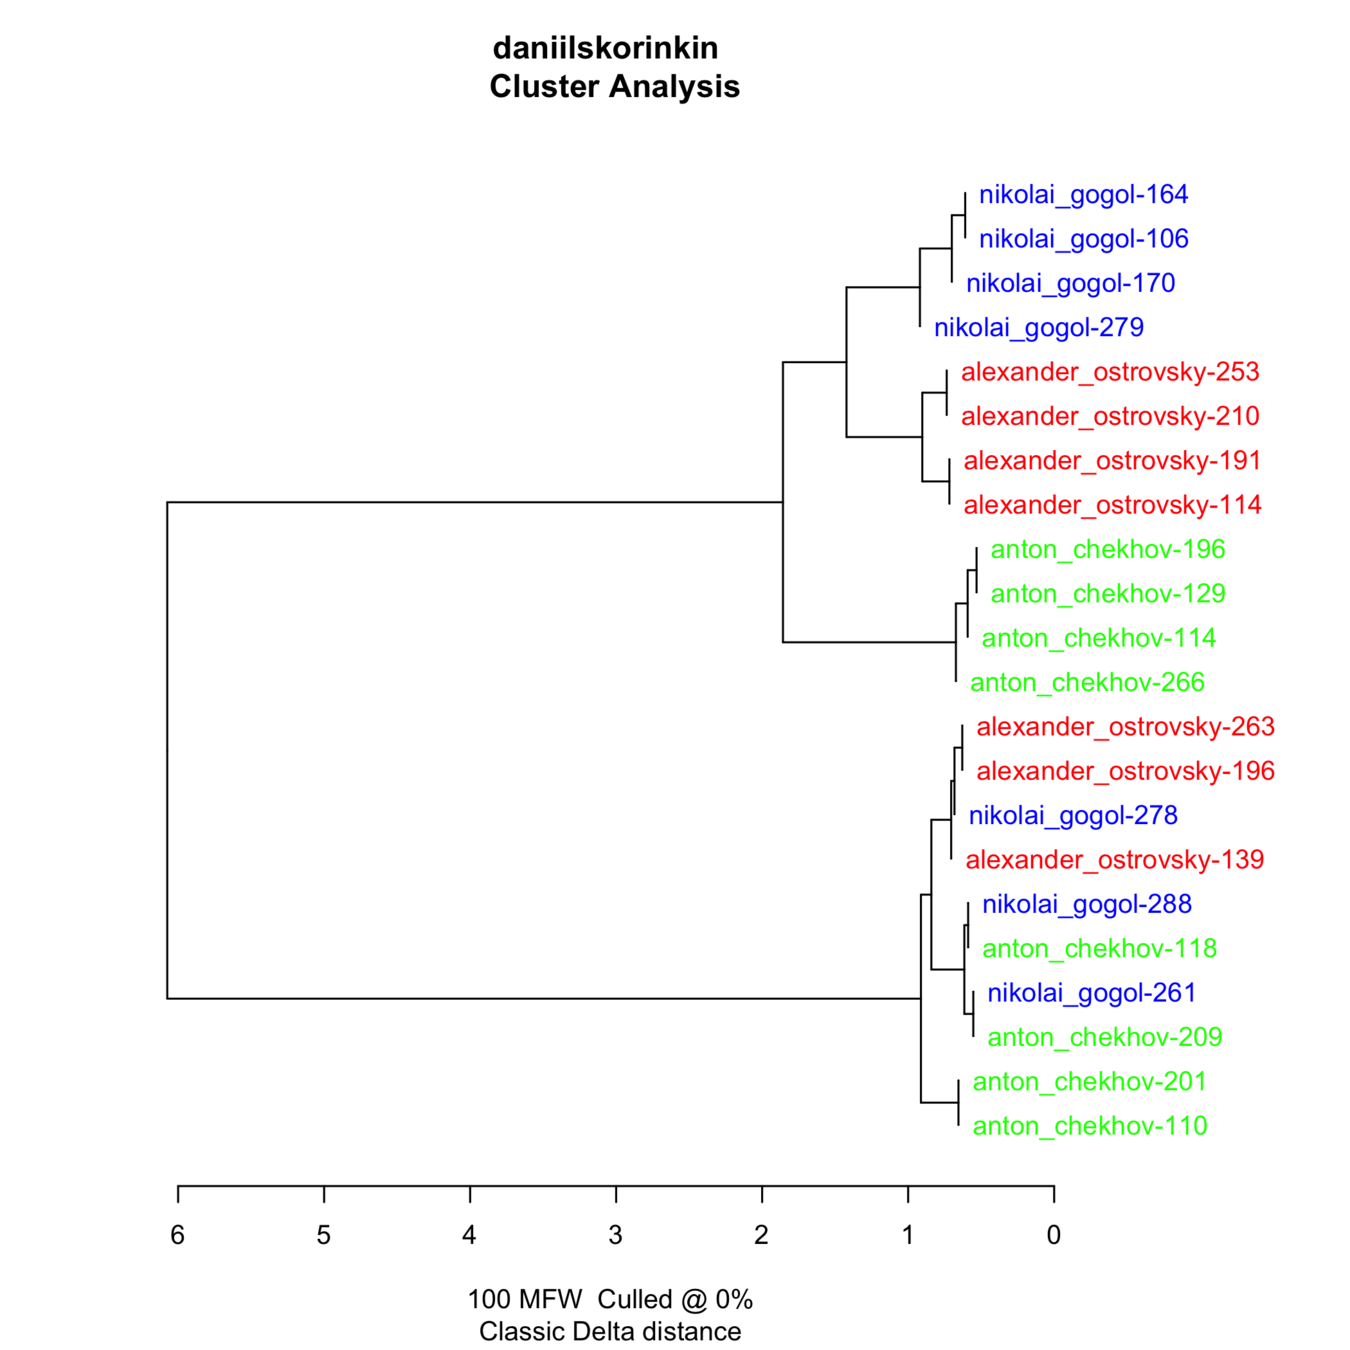
Как вы думаете, что тут происходит?
Нижняя ветка — пьесы "в стиле" этих авторов от GPT-4
Эксперимент Симоне Реборы (2023) с GPT-3

Rebora, S. (2023). GPT-3 vs. Delta: Applying stylometry to large language models. In La memoria digitale: Forme del testo e organizzazione della conoscenza. Atti del XII Convegno Annuale AIUCD (pp. 292–297). aiucd.it/wp-content/uploads/2023/06/2023_aiucd_la_memoria_digitale_v1.pdf#page=305
Эксперимент Георгоса Микроса с GPT-4o (2025)
Mikros, G. (2025). Beyond the surface: Stylometric analysis of GPT-4o’s capacity for literary style imitation. Digital Scholarship in the Humanities, 40(2), 587–600. https://doi.org/10.1093/llc/fqaf035
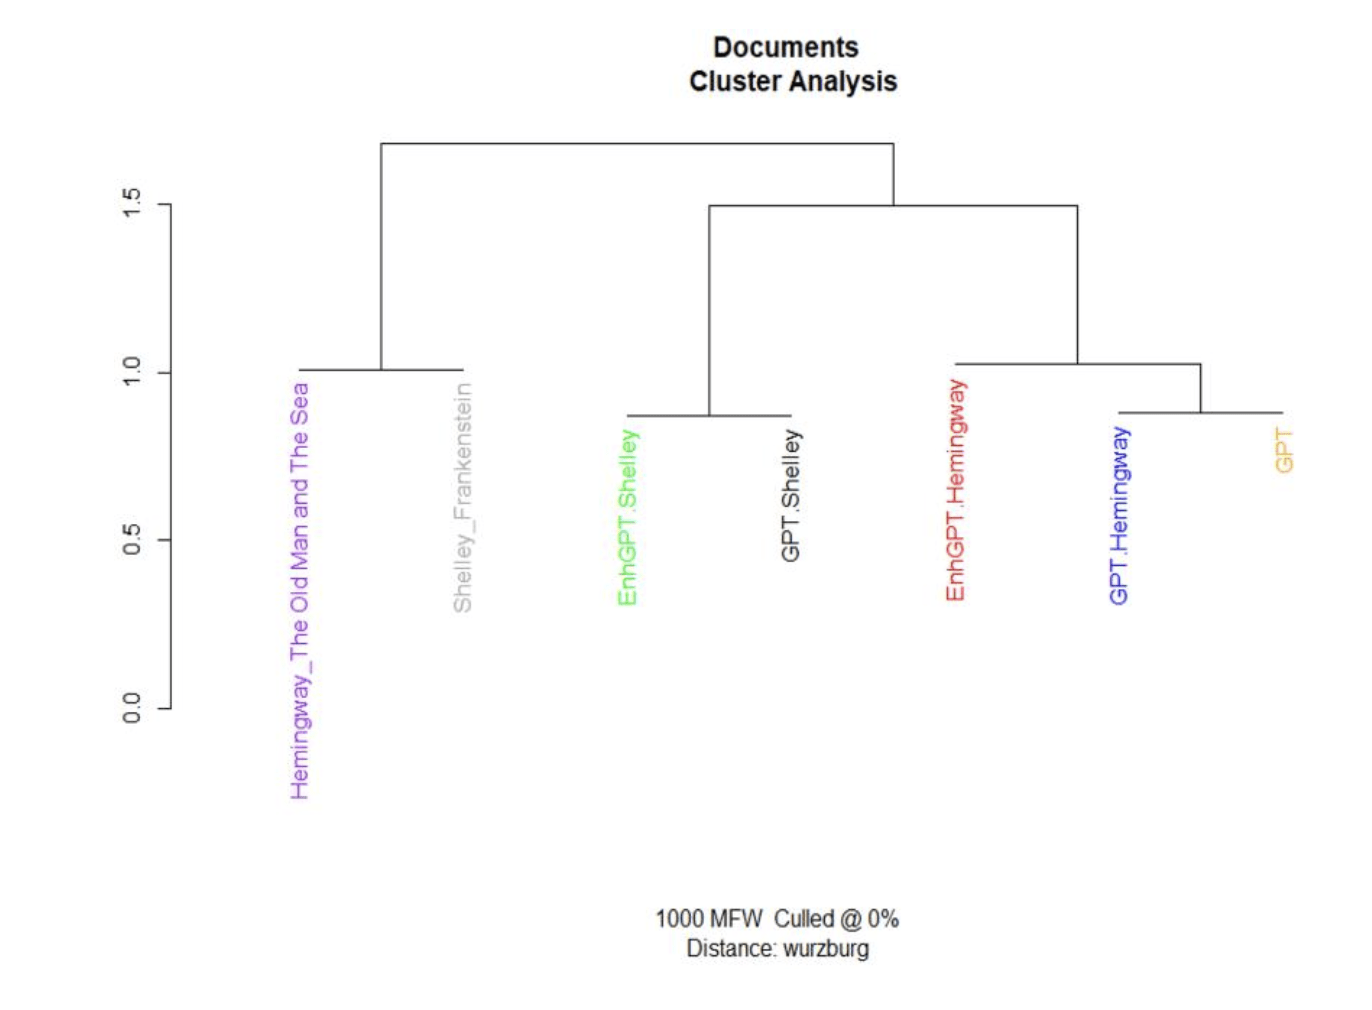
живые авторы
В режиме zero-shot стилизации ("напиши в стиле Чехова") LLM скорее не обманывают стилометрию
Пограничный кейс: до-обучение LLM в режиме fine-tuning (например через LoRA-адаптер). Его надо доисследовать
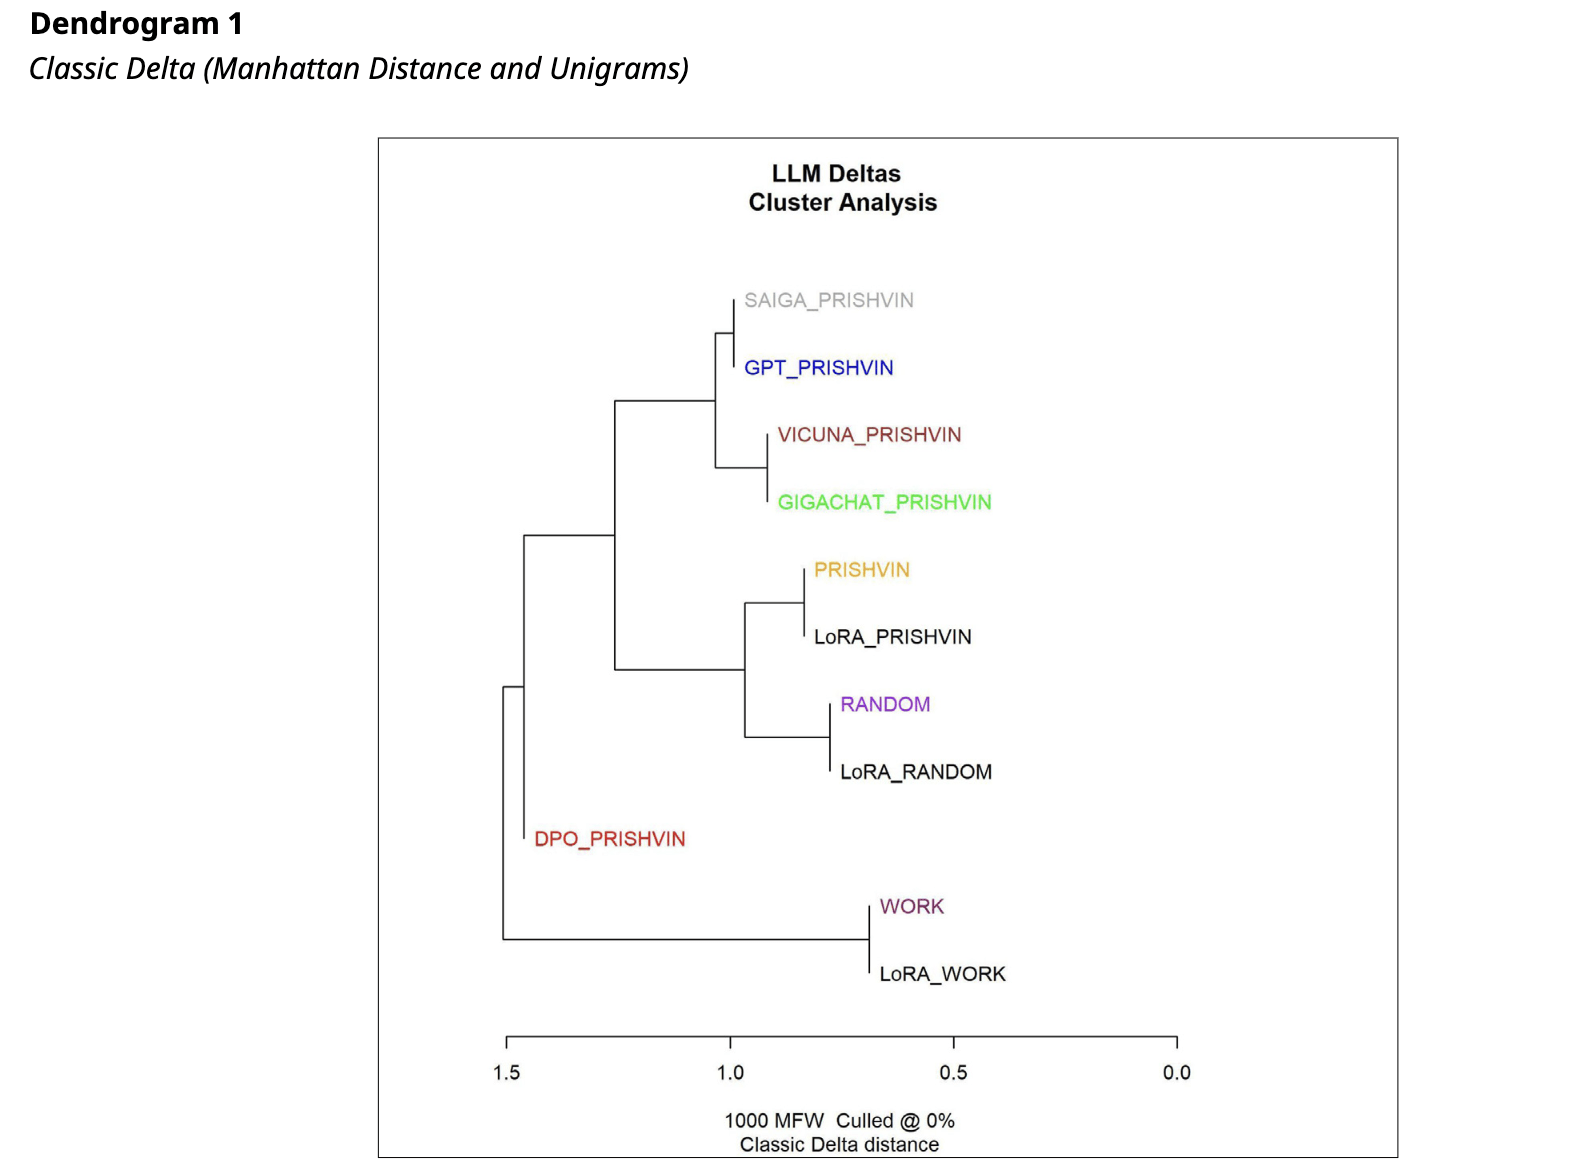
настоящий и искусственный Пришвин (Mistral-7B с LoRA-адаптером)
Salnikov, E., & Bonch-Osmolovskaya, A. (2025). Detecting LLM-generated text with Trigram–Cosine Stylometric Delta: An unsupervised and interpretable approach. Journal of Language and Education, 11(3), 138–151. https://doi.org/10.17323/jle.2025.22211
Еще более примитивная модель, целиком специально обученная на авторе X, обманет стилометрию
ещё легче
(но едва ли обманет человека)
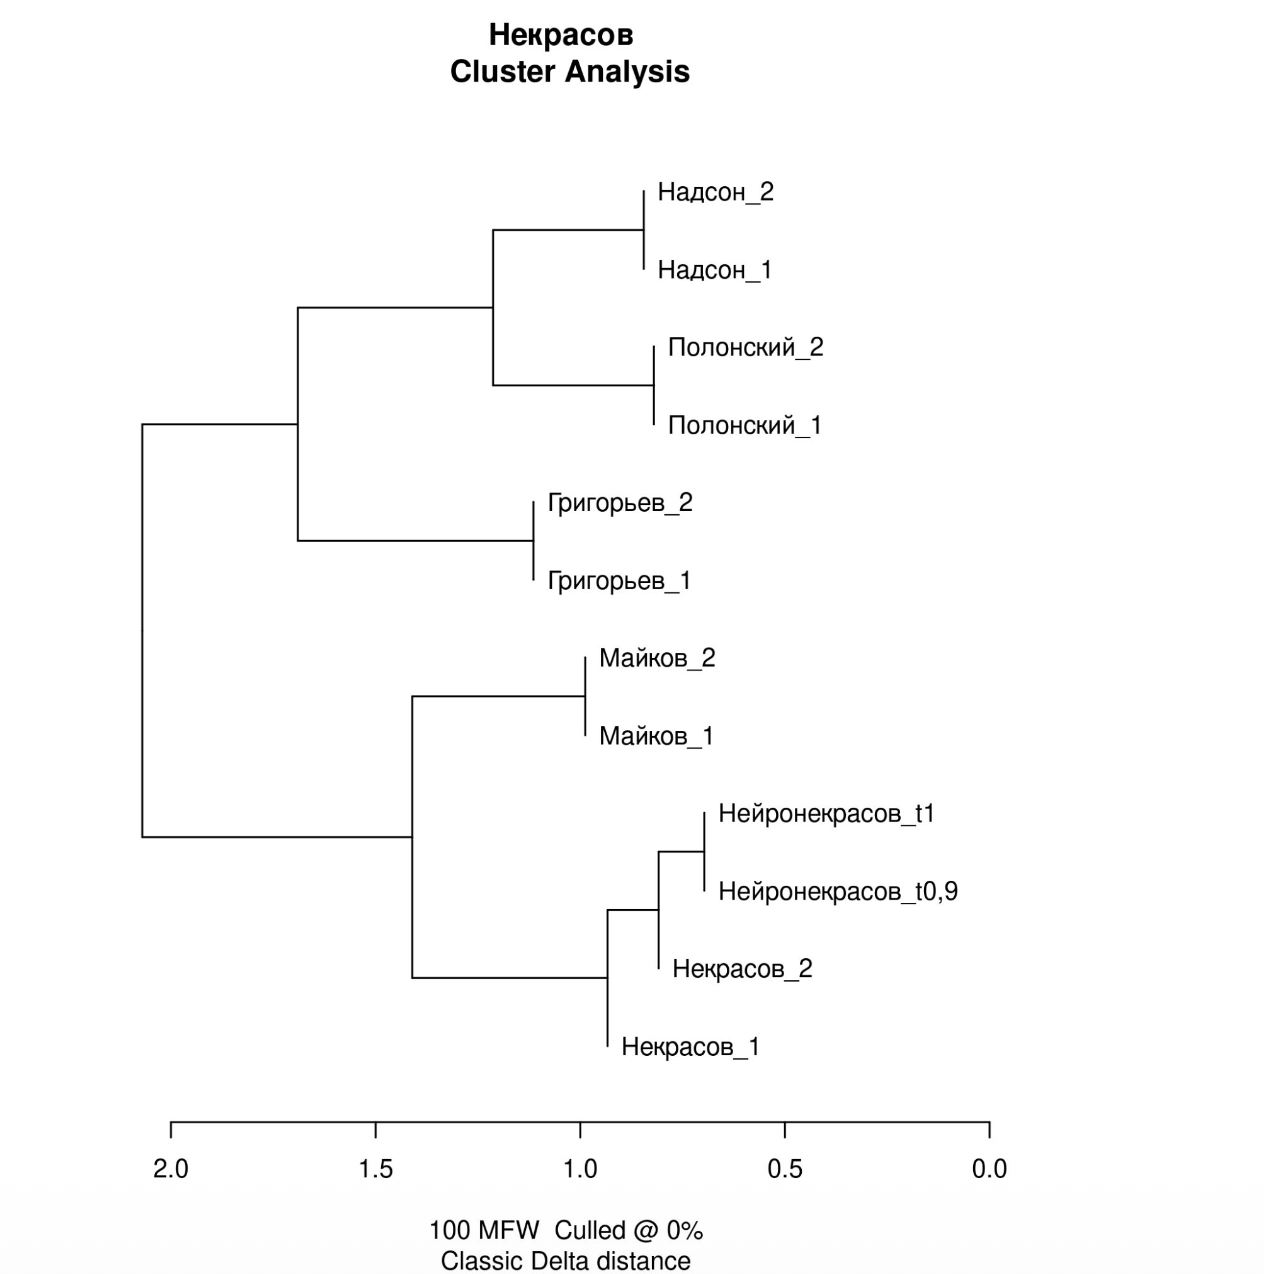
LSTM-модель обманывает Delta с Некрасовым
Спасибо за внимание
Некоторые ссылки
-
Style-markers in authorship attribution: A cross-language study of the authorial fingerprint (great paper by Maciej Eder)
His other papers
... and the papers of his colleagues Jan Rybicki (including the Translation studies)
A lecture by Jan Rybicki: youtu.be/XoZ2HMYw2U4
the Stylo tool: https://computationalstylistics.github.io/
Как работают метрики Delta: Understanding and explaining Delta measures for authorship attribution
Стилометрия и Шекспировский вопрос
Шекспир

...и Марлоу

Генрих VI: последовательный анализ


Code stylometry

Стилометрия и medical conditions
Стилометрия и афазия: Случай Славомира Мрожека
Родился в 1930 на юге Польши
Начал писать в начале 1950-х
1958 — первая пьеса
1963 — эмиграция в Италию
1996 — возвращение в Польшу
2002 — инсульт
2006 — выход автобиографического романа "Балтазар"
2008 — переезд в Ниццу
2013 — смерть
Исследование Яна Рыбицкого:
Rybicki, J. (2025) ‘Back to Writing after Aphasia: a Stylometric Case Study’, in DH 2025 Book of Abstracts. DH 2025, Lisbon
Запись доклада: dh2025.adho.org/july-16th
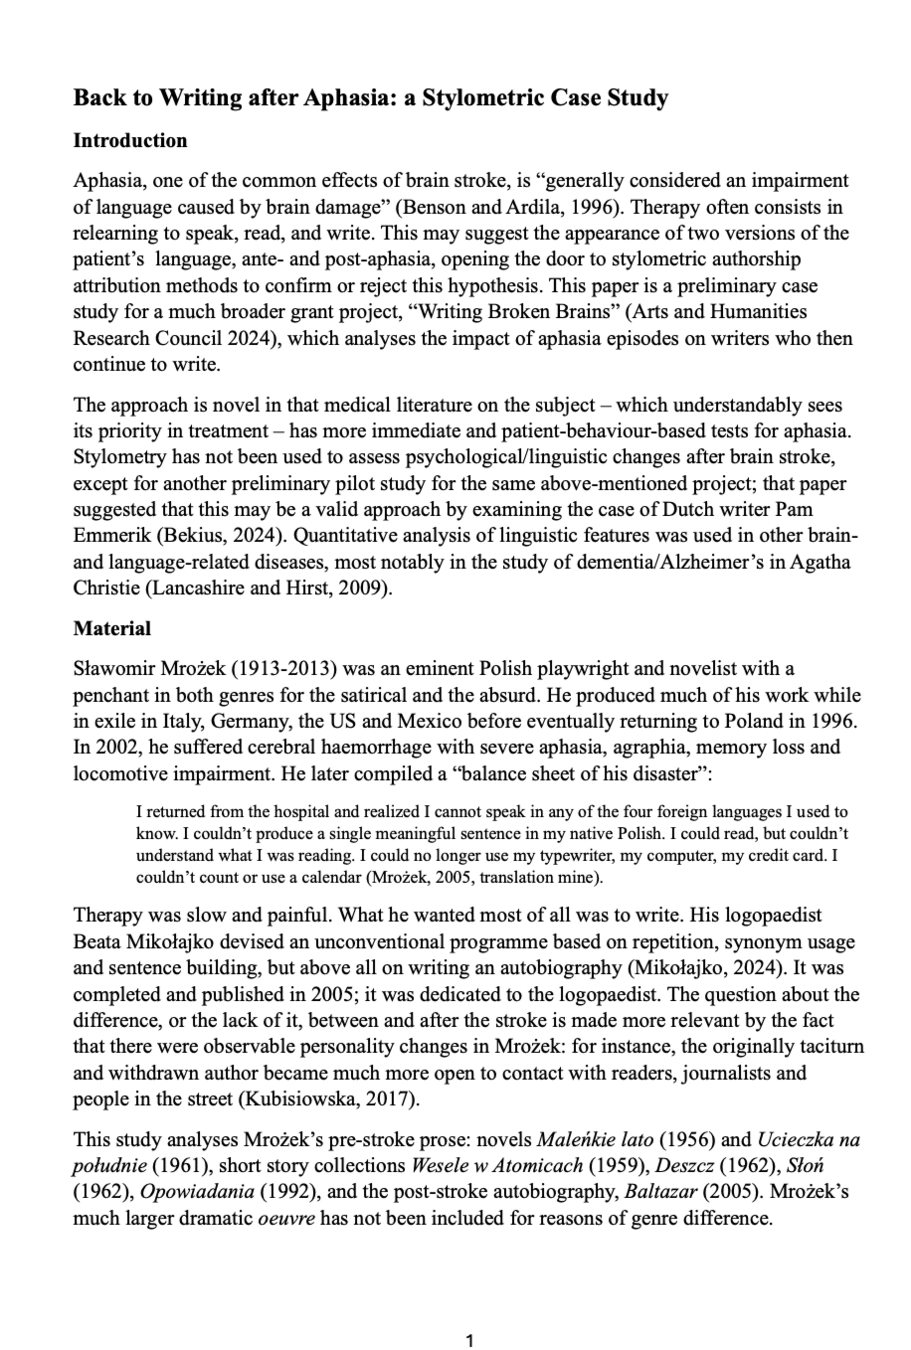
Rybicki, J. (2025) ‘Back to Writing after Aphasia: a Stylometric Case Study’, in DH 2025 Book of Abstracts. DH 2025, Lisbon
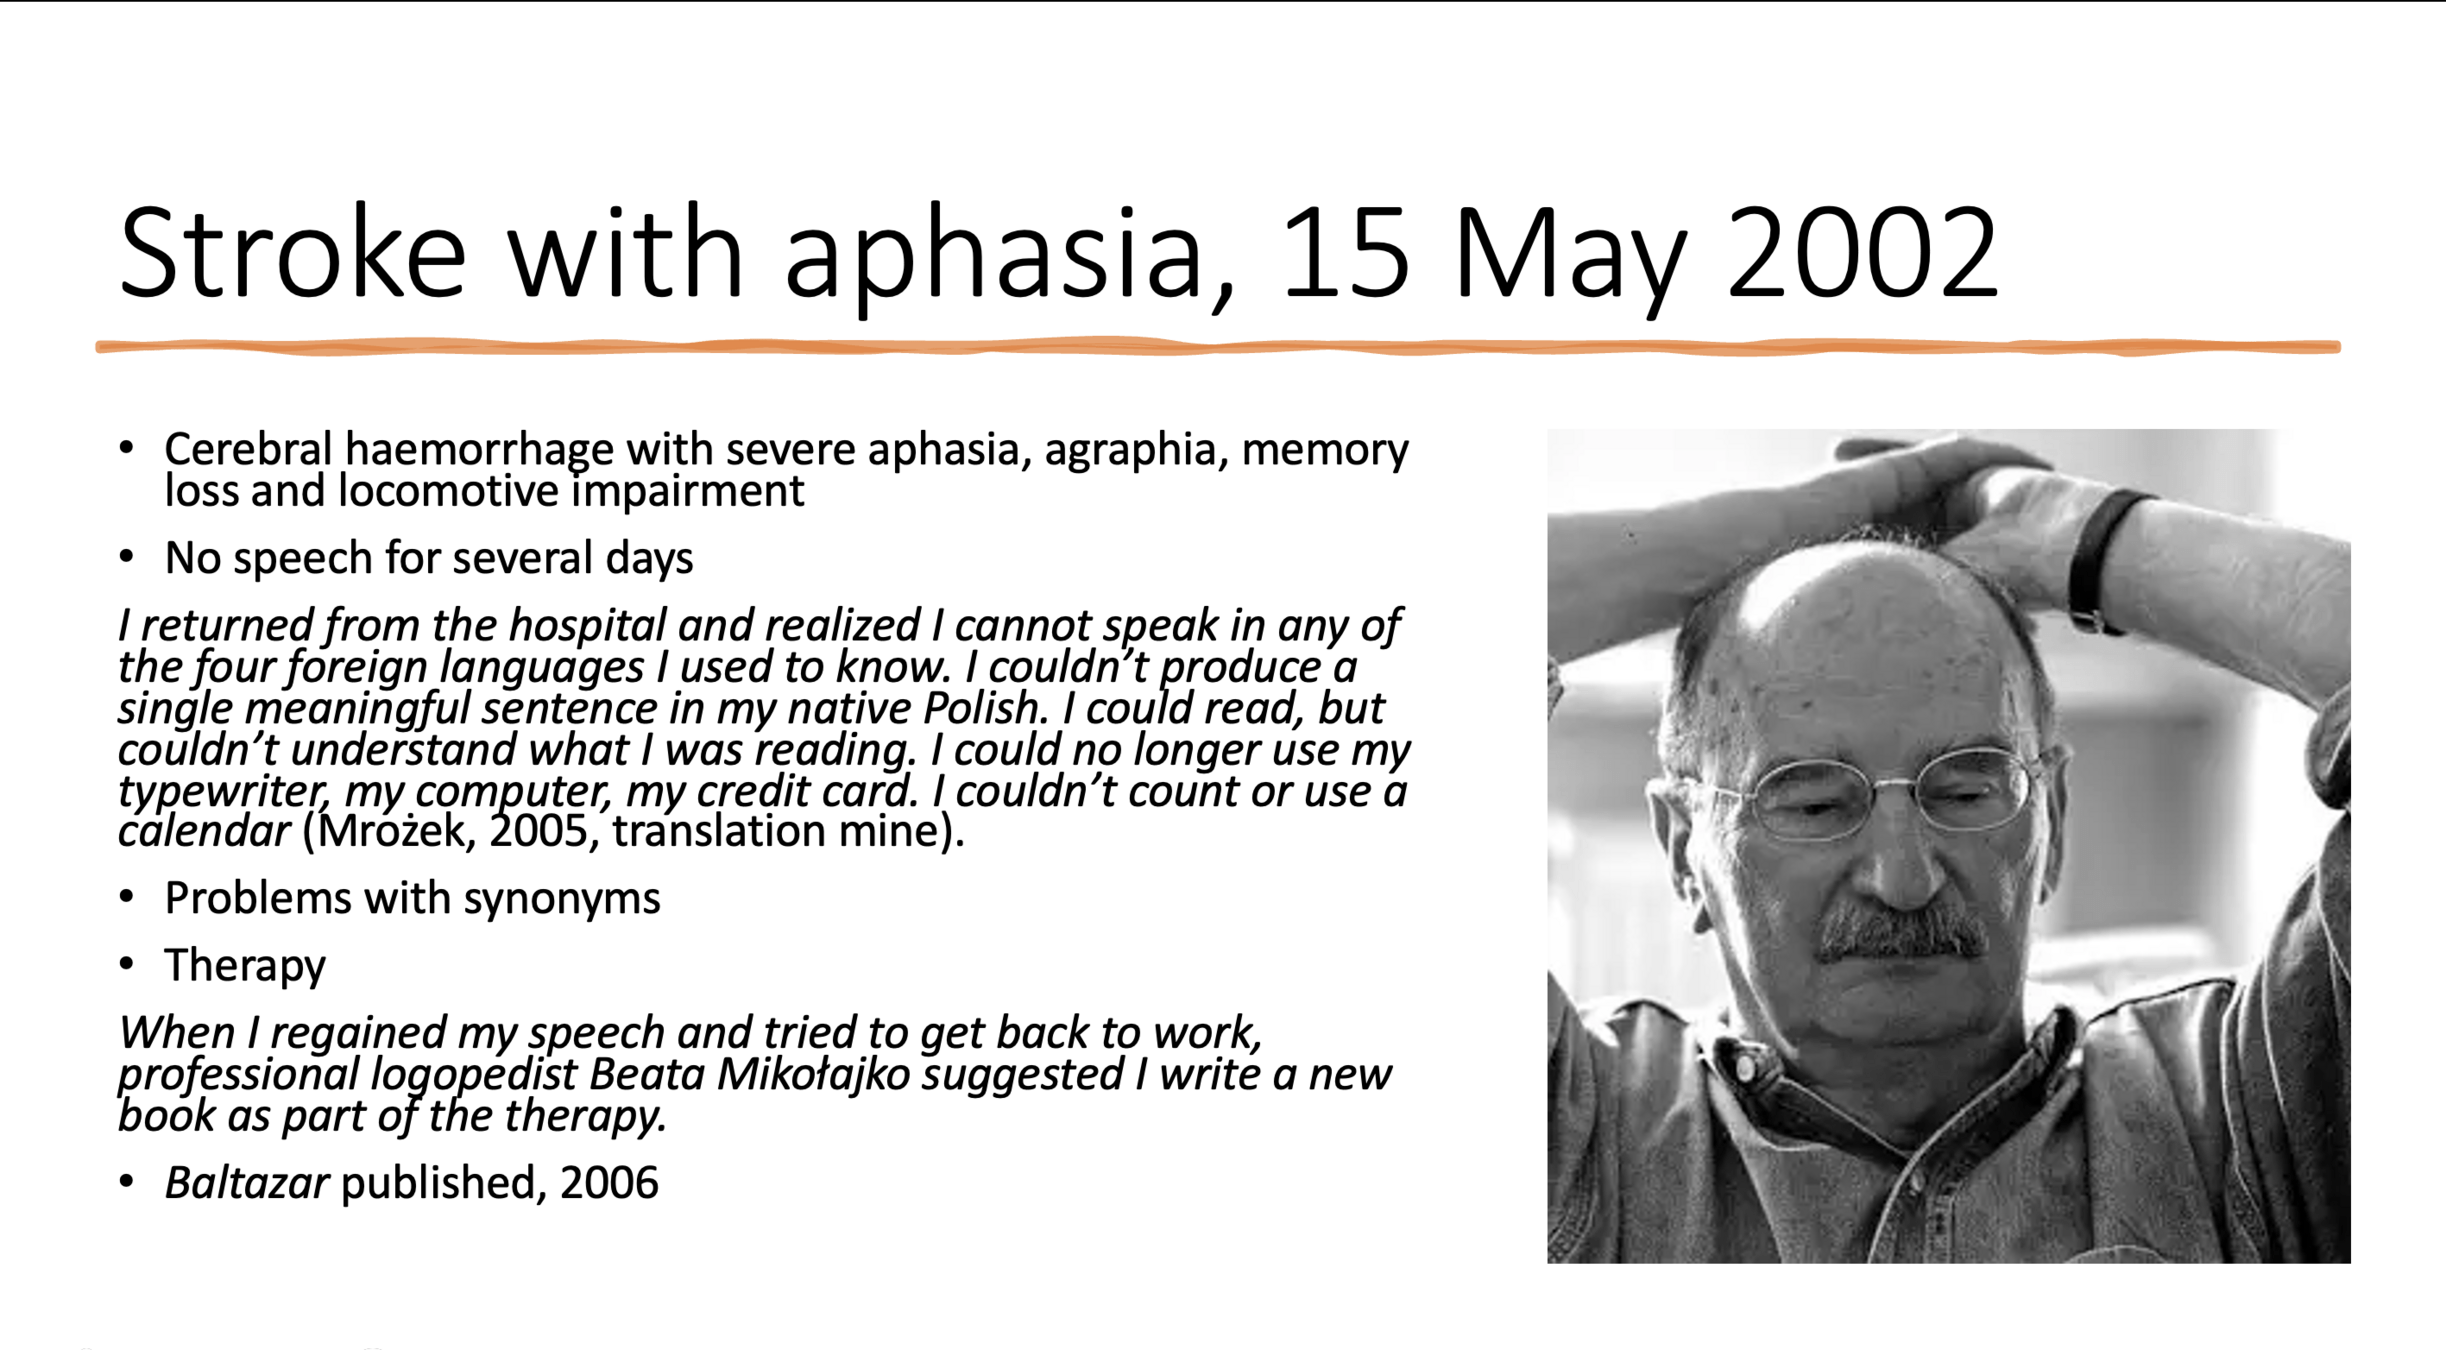
Исследовательский вопрос:
Мрожек до и после афазии — стилометрически один и тот же автор?
Ответ: в целом — да
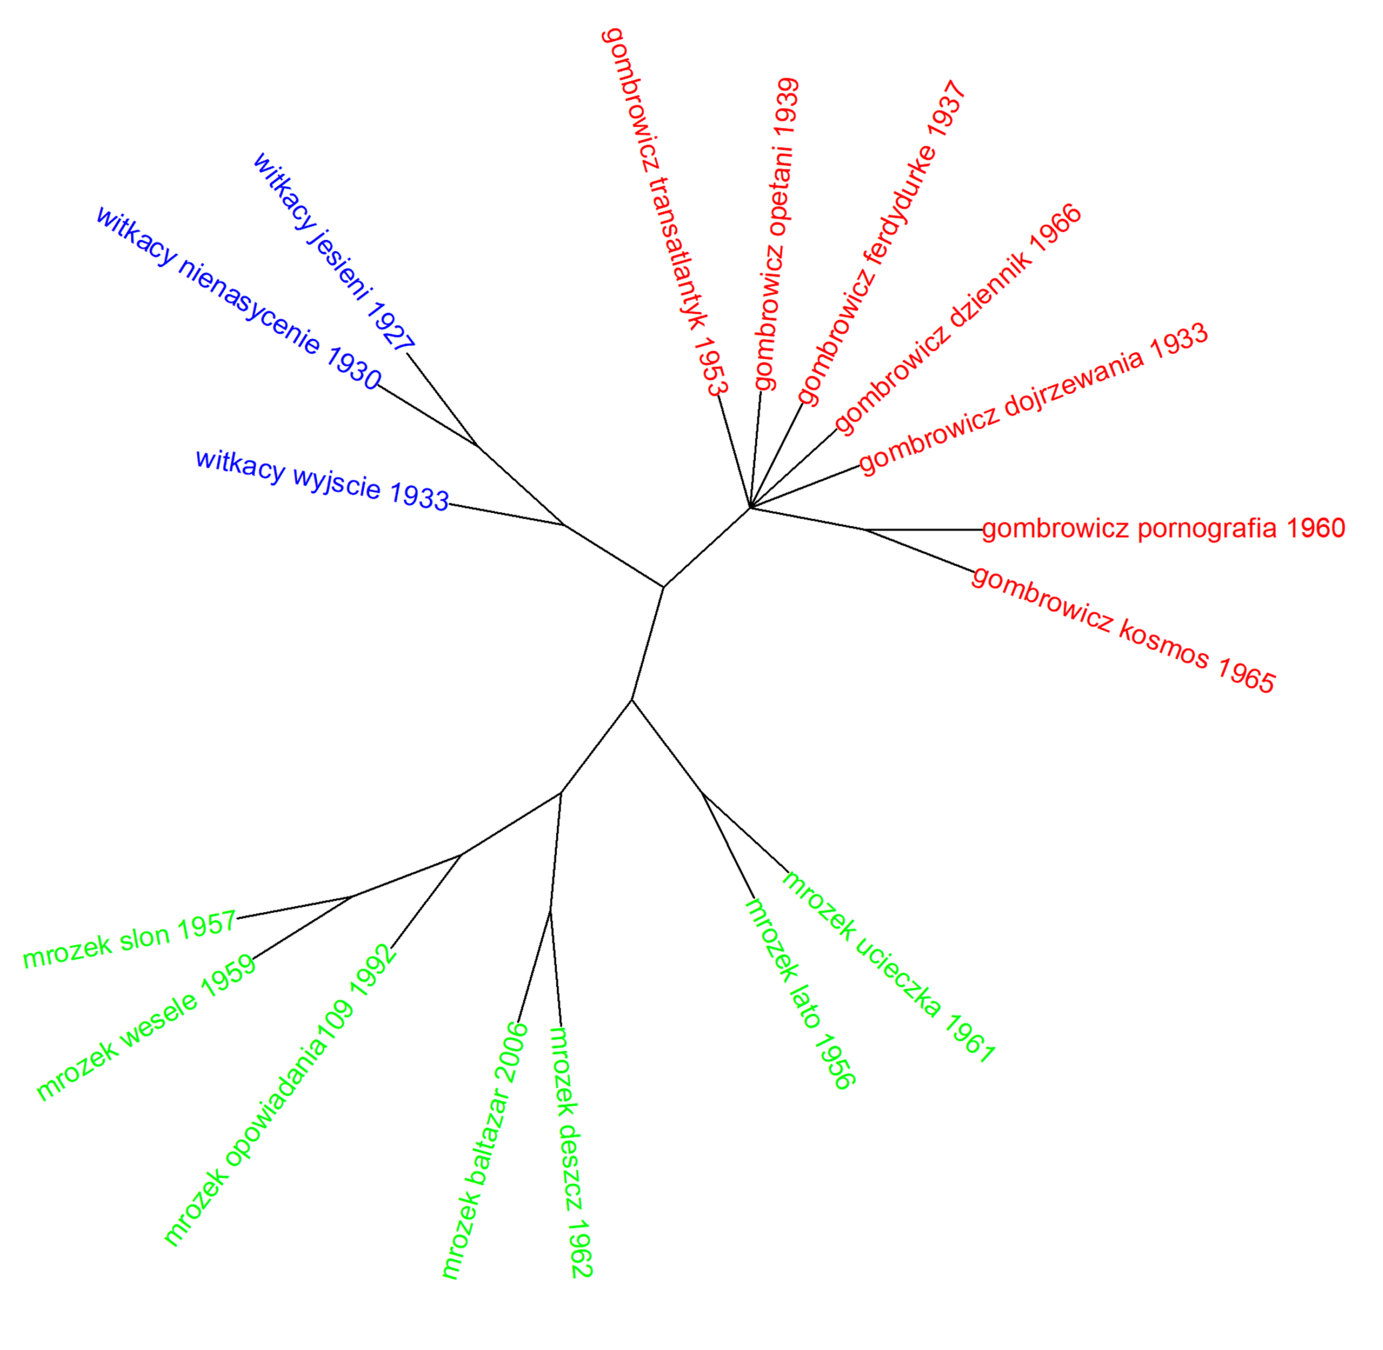
Сравнение с другими польскими абсурдистами, современными Мрожеку
Ответ: в целом — да
Сравнение с другими польскими абсурдистами, современными Мрожеку
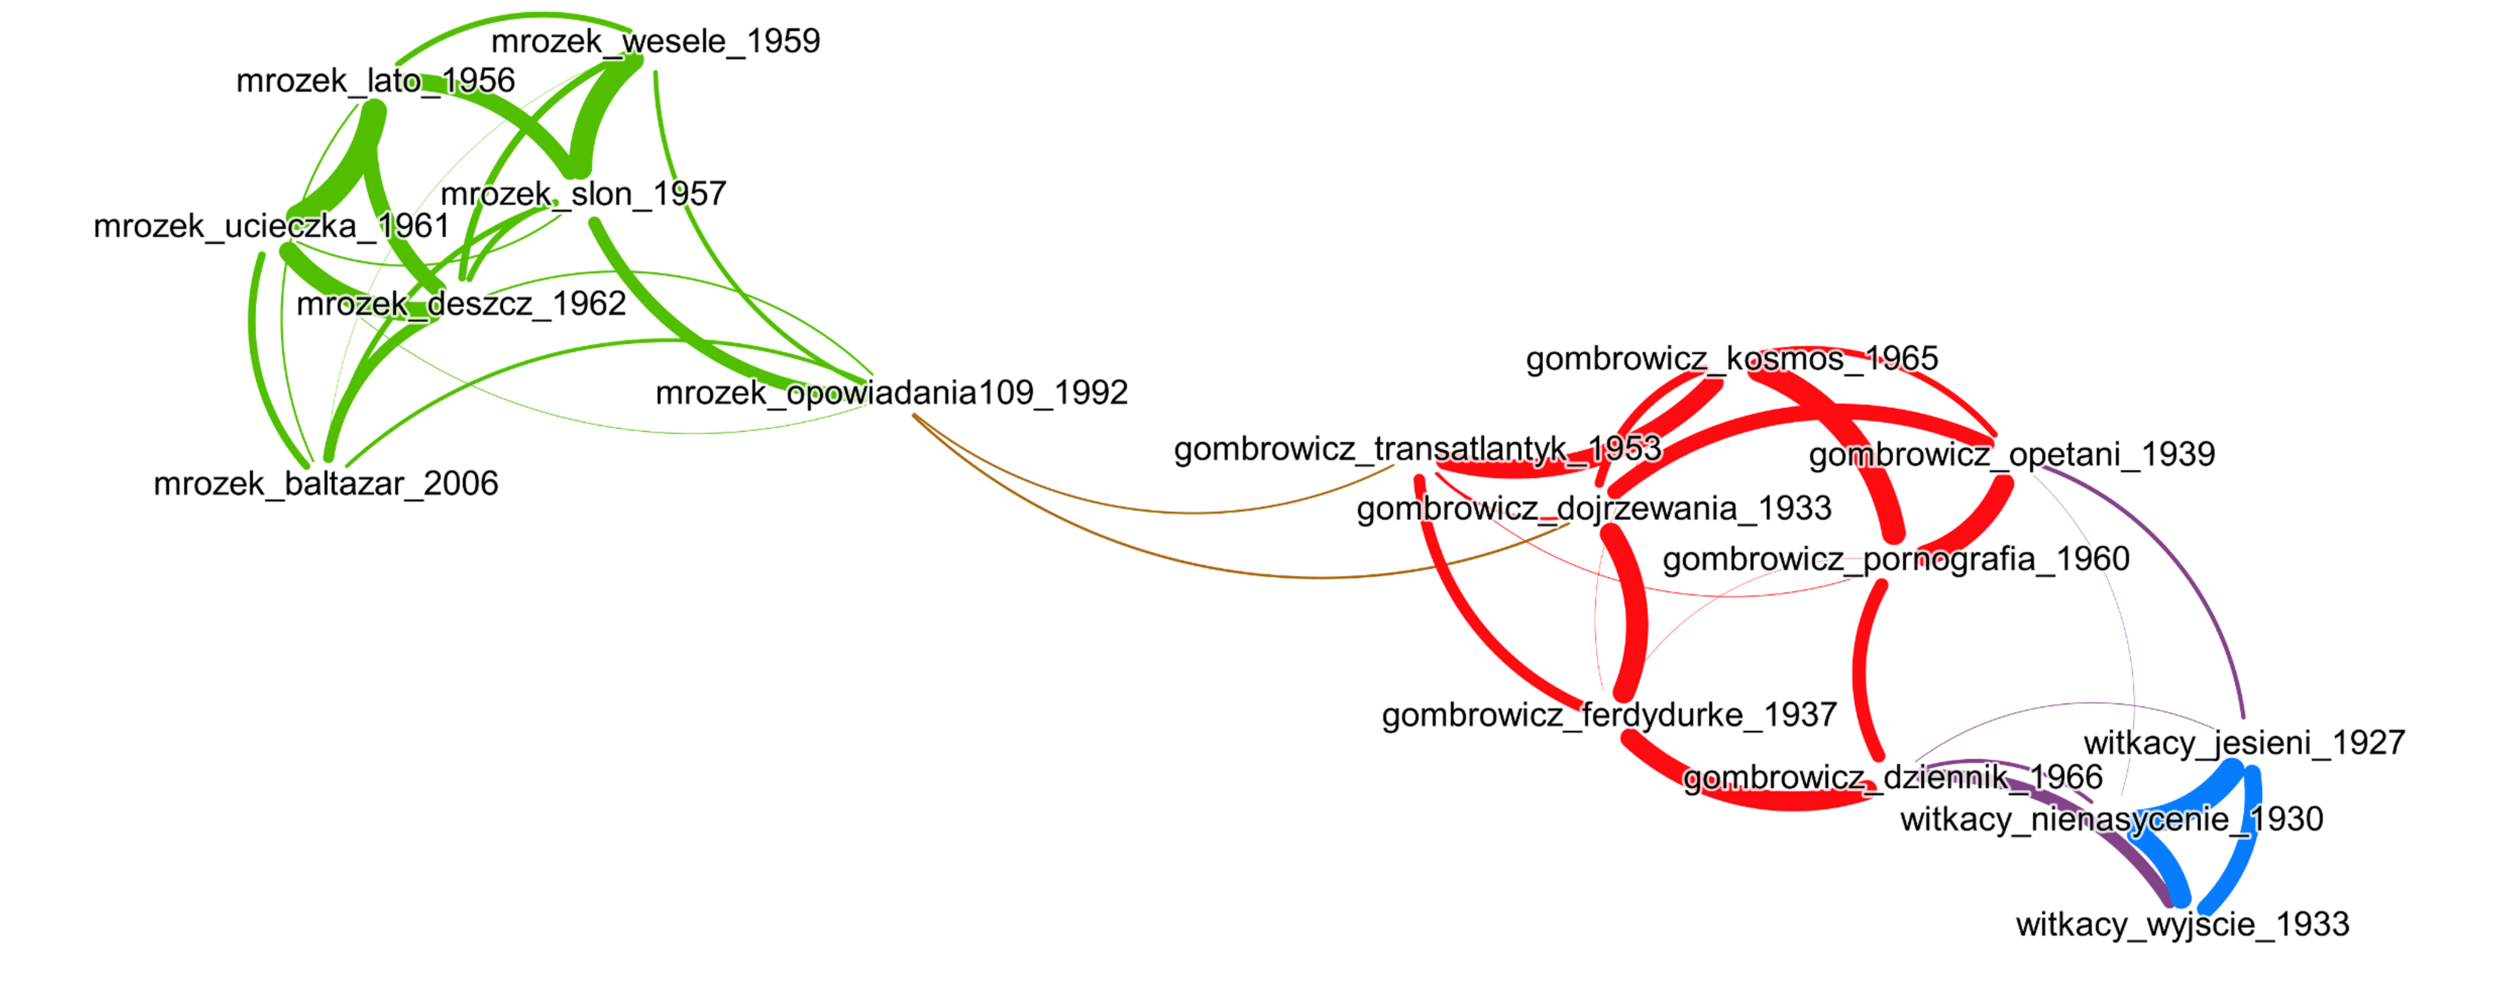
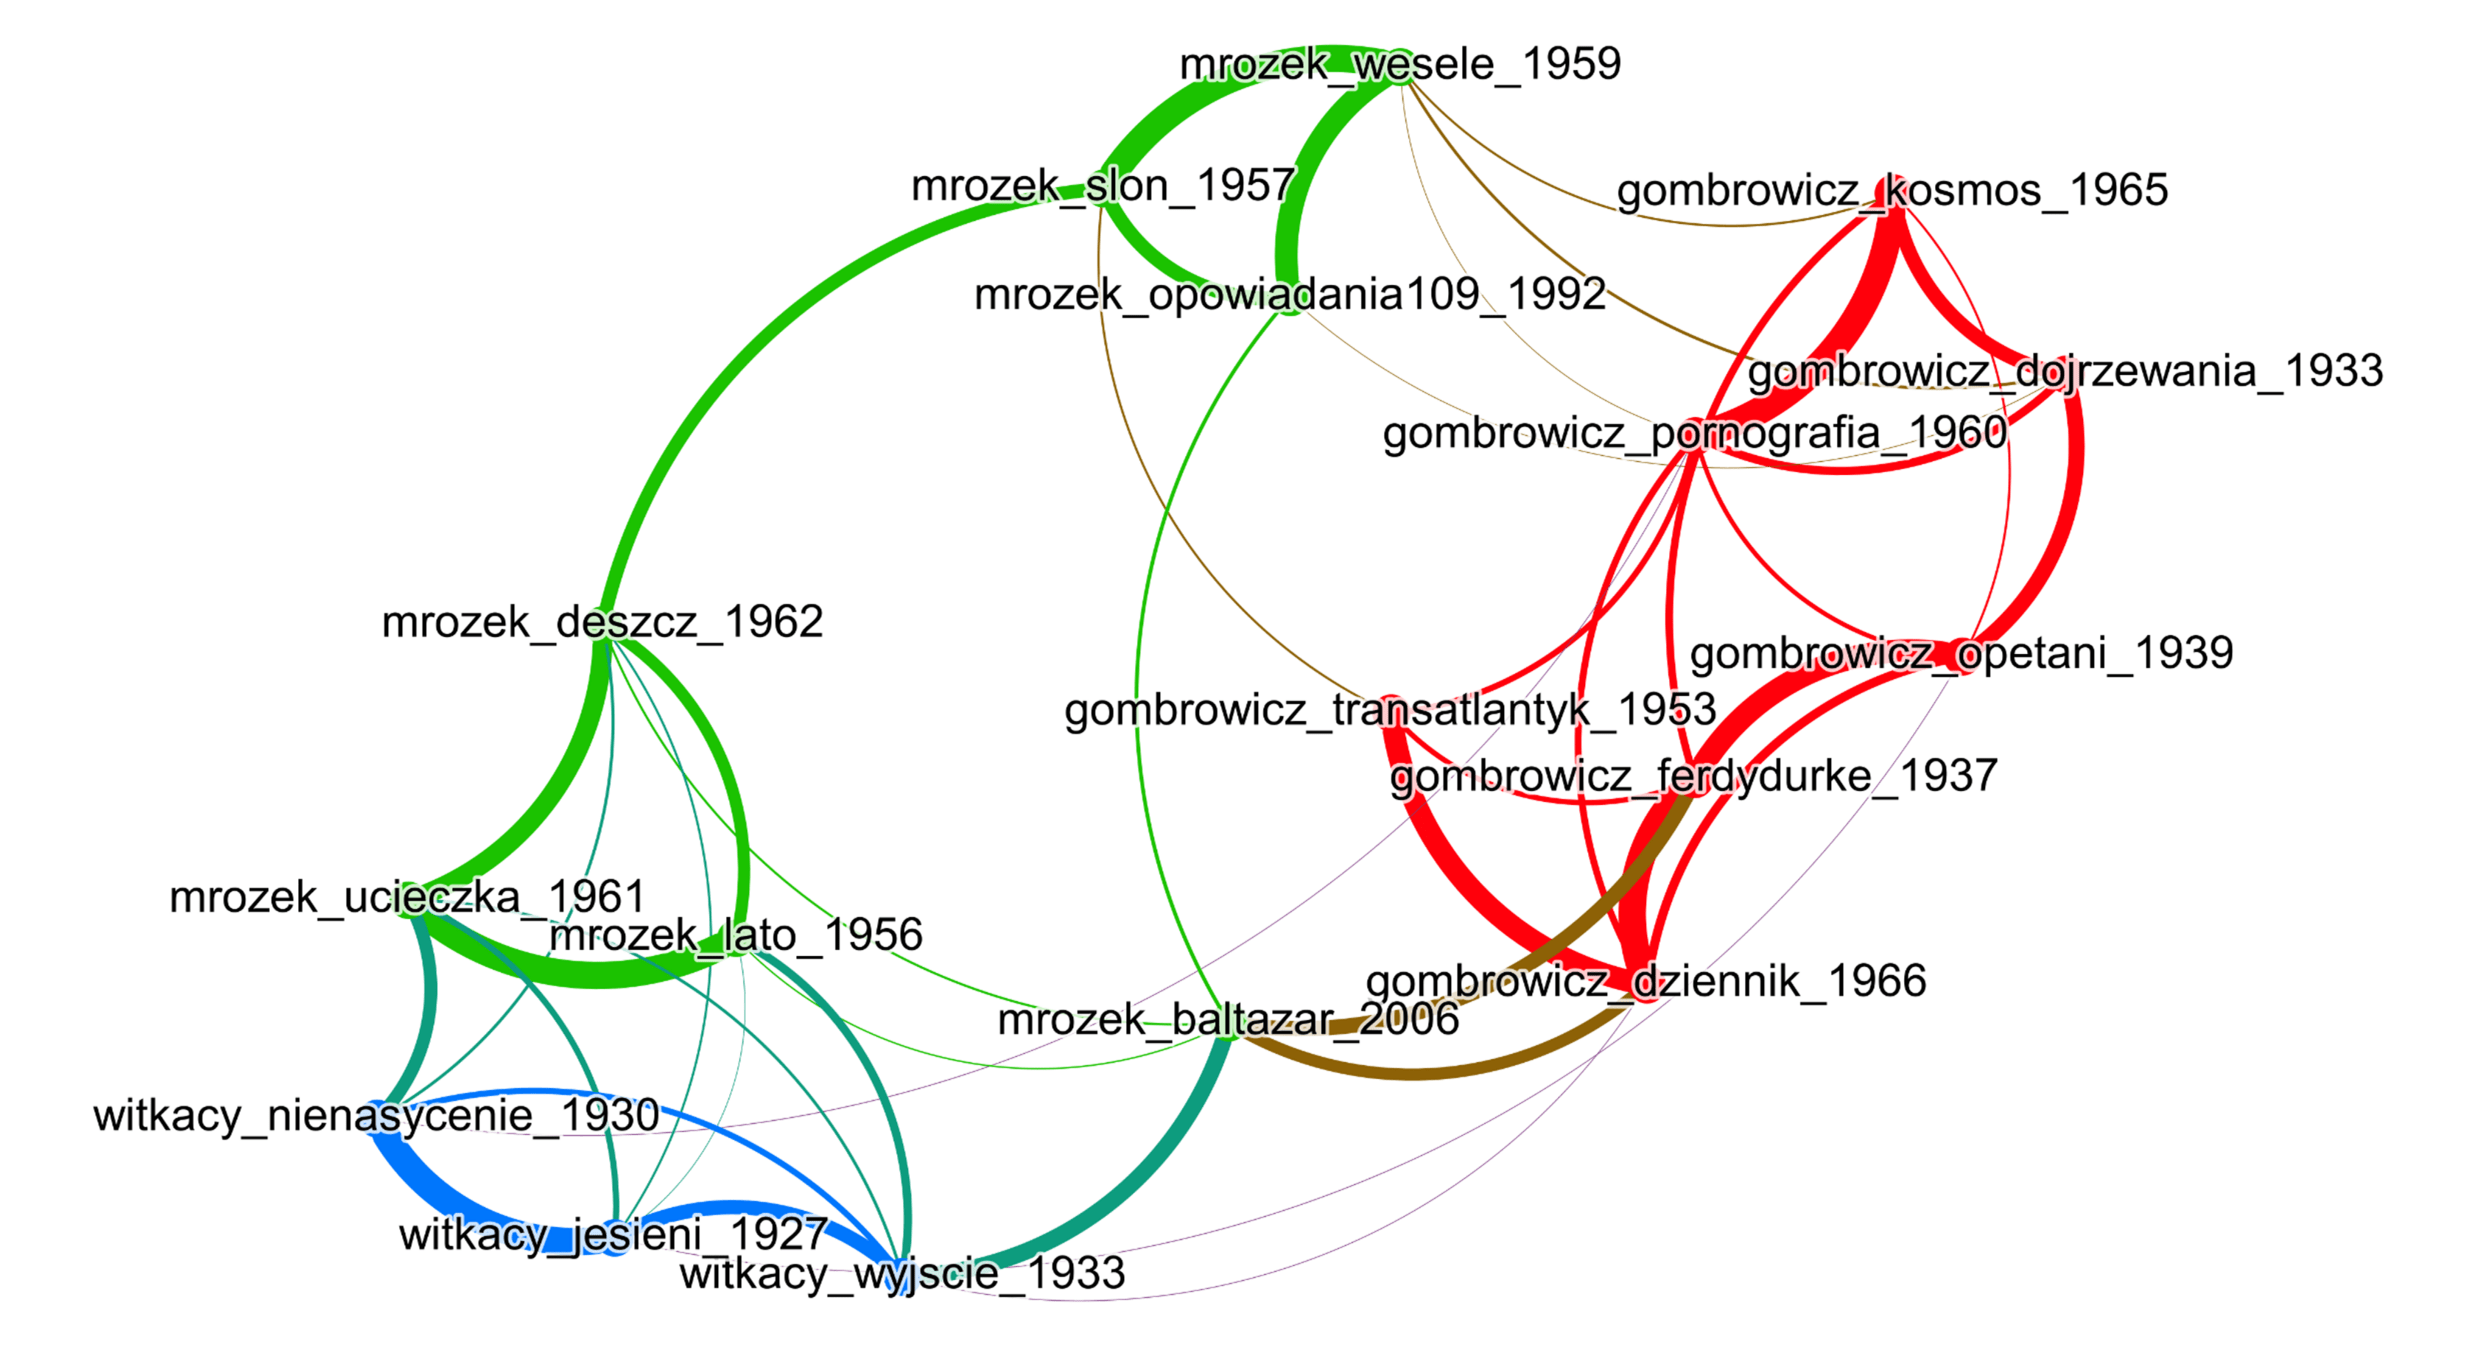
Попытка сузить стилометрическеий фокус: неопределенные местоимения
"The same approach was also used to compare the same texts for usage of indefinite pronouns" [Rybicki 2025]
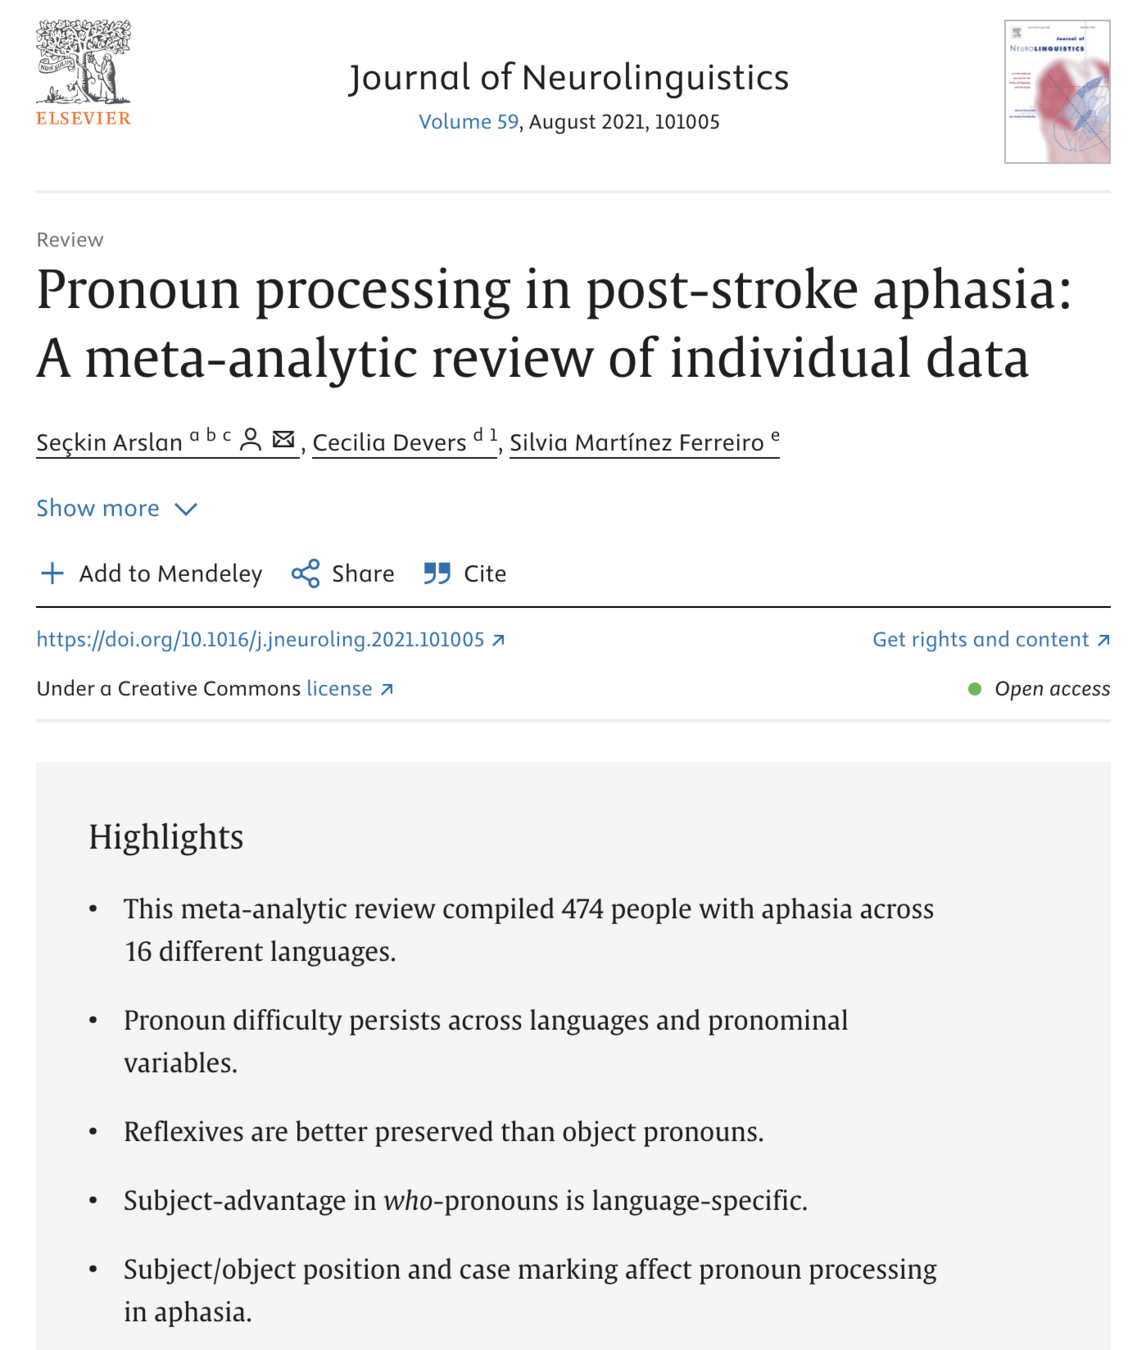
"Pronouns are one of the most widely studied grammatical phenomena in aphasia <...> There is a consensus among authors that aphasia adversely impacts pronoun processing; <...> overuses of pronouns often result from inappropriate uses of indefinite pronouns or pronouns without appropriate antecedents"
[Arslan, S., Devers, C. and Ferreiro, S.M. (2021) ‘Pronoun processing in post-stroke aphasia: A meta-analytic review of individual data’, Journal of Neurolinguistics, 59, p. 101005.
Стилометрия только на неопределенных местоимениях
Другие исследования в этом направлении
-
Barrios Rudloff, J. et al. (2023) ‘Detecting Psychological Disorders with Stylometry’, in Computational Humanities Research. Paris, France. Available at: https://doi.org/10.31234/osf.io/s5cm3.
-
Trifu, R.N. et al. (2024) ‘Linguistic markers for major depressive disorder: a cross-sectional study using an automated procedure’, Frontiers in Psychology, 15. Available at: https://doi.org/10.3389/fpsyg.2024.1355734.
-
Ehlen, F. et al. (2023) ‘Linguistic findings in persons with schizophrenia—a review of the current literature’, Frontiers in Psychology, 14. Available at: https://doi.org/10.3389/fpsyg.2023.1287706.
-
Lancashire, I., & Hirst, G. (2009). “Vocabulary Changes in Agatha Christie’s Mysteries as an Indication of Dementia: A Case Study.” 19th Annual Rotman Research Institute Conference, Cognitive Aging: Research and Practice, 8-10.
Стилометрия ЕУСПб
By danilsko
Стилометрия ЕУСПб
2026-10-19 ЕУСПб Лекция