






He Wang PRO
Knowledge increases by sharing but not by saving.
2026/11/7 16:00 | 桃李大讲堂 | @内蒙古大学
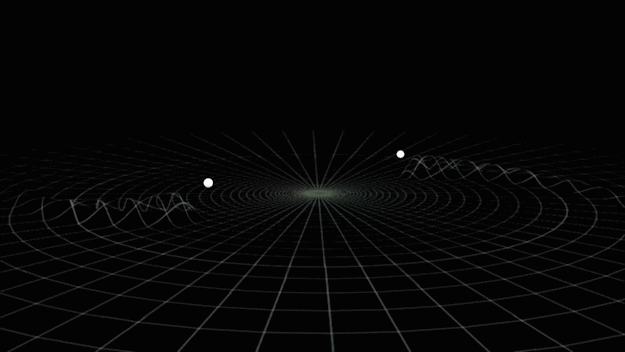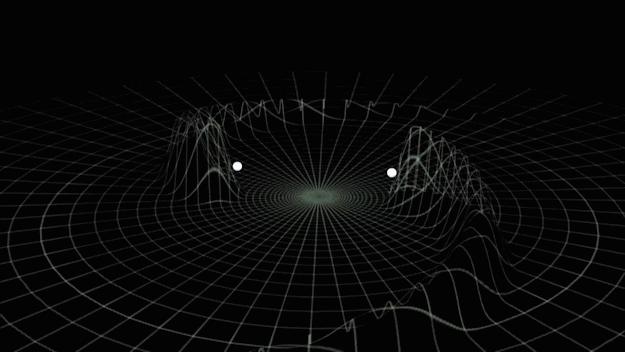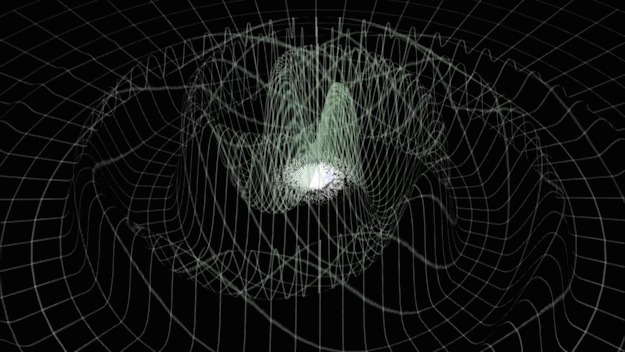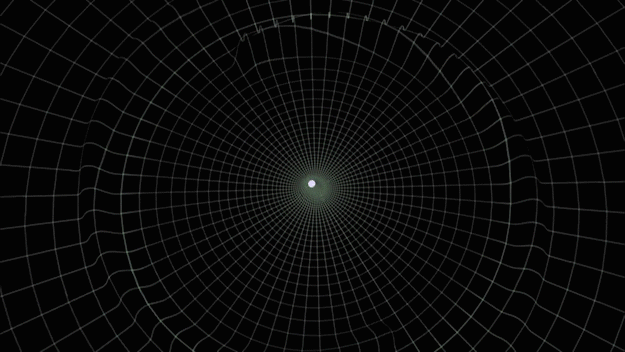
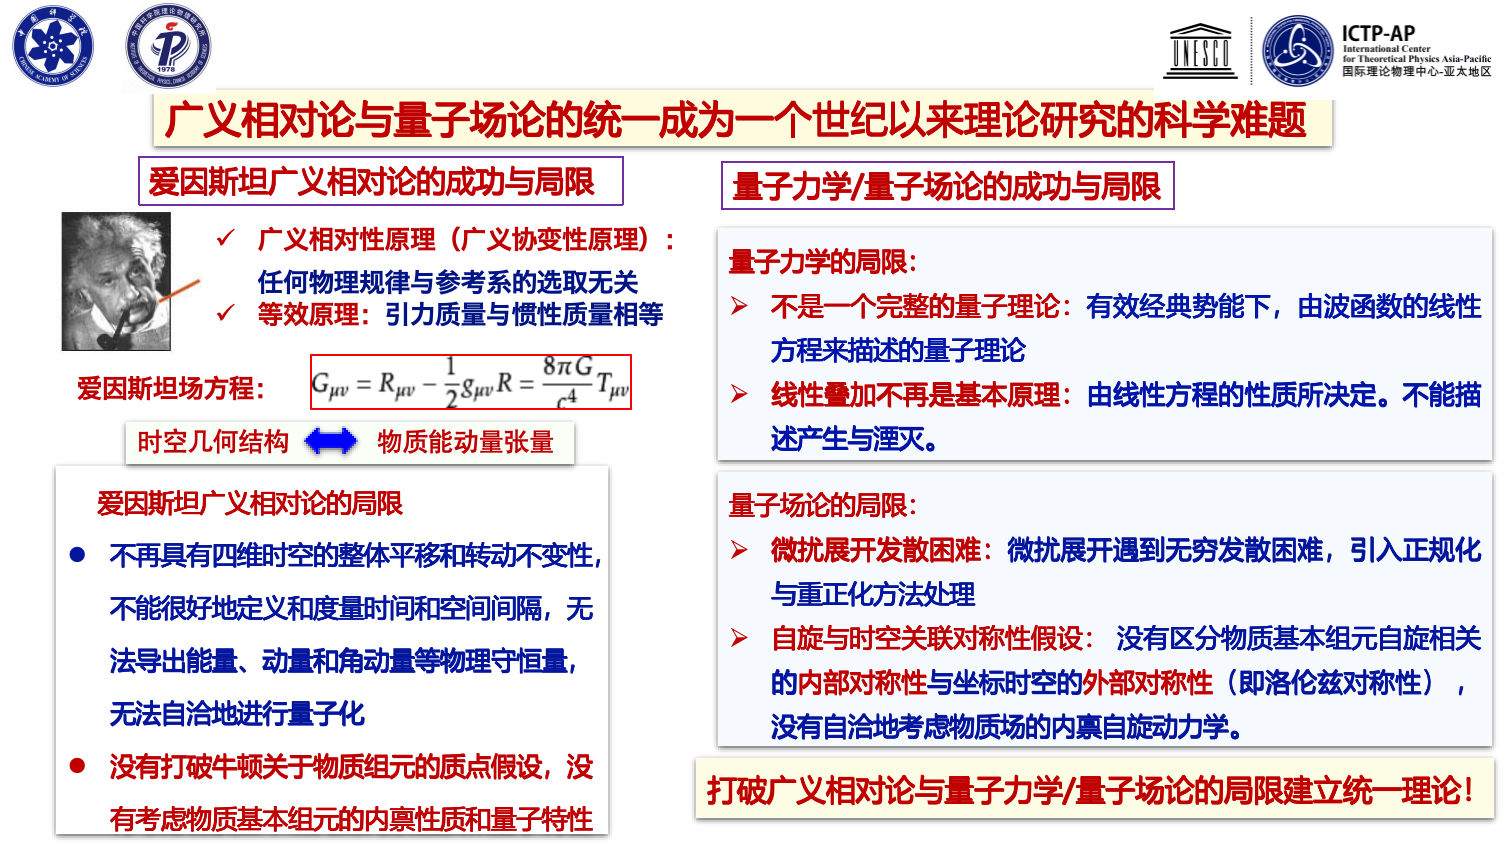
我们到不了那里,也不能把黑洞搬进实验室。那我们凭什么说,它们曾经发生过一次碰撞?
双黑洞并合模拟示意
只凭这张图,你愿意下结论吗?如果不愿意,你希望再看到哪一项检查?
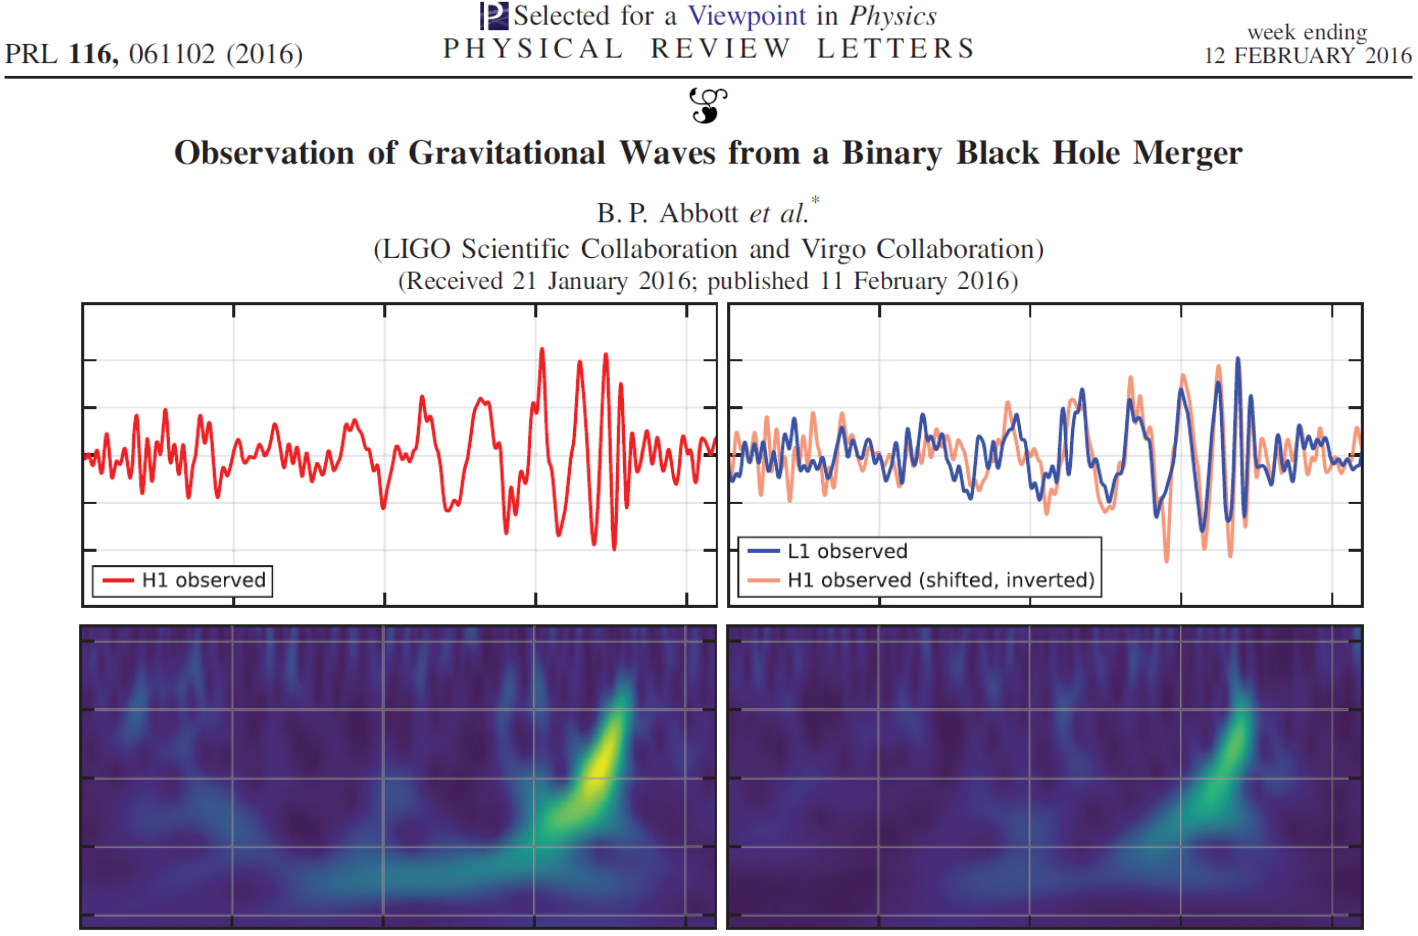
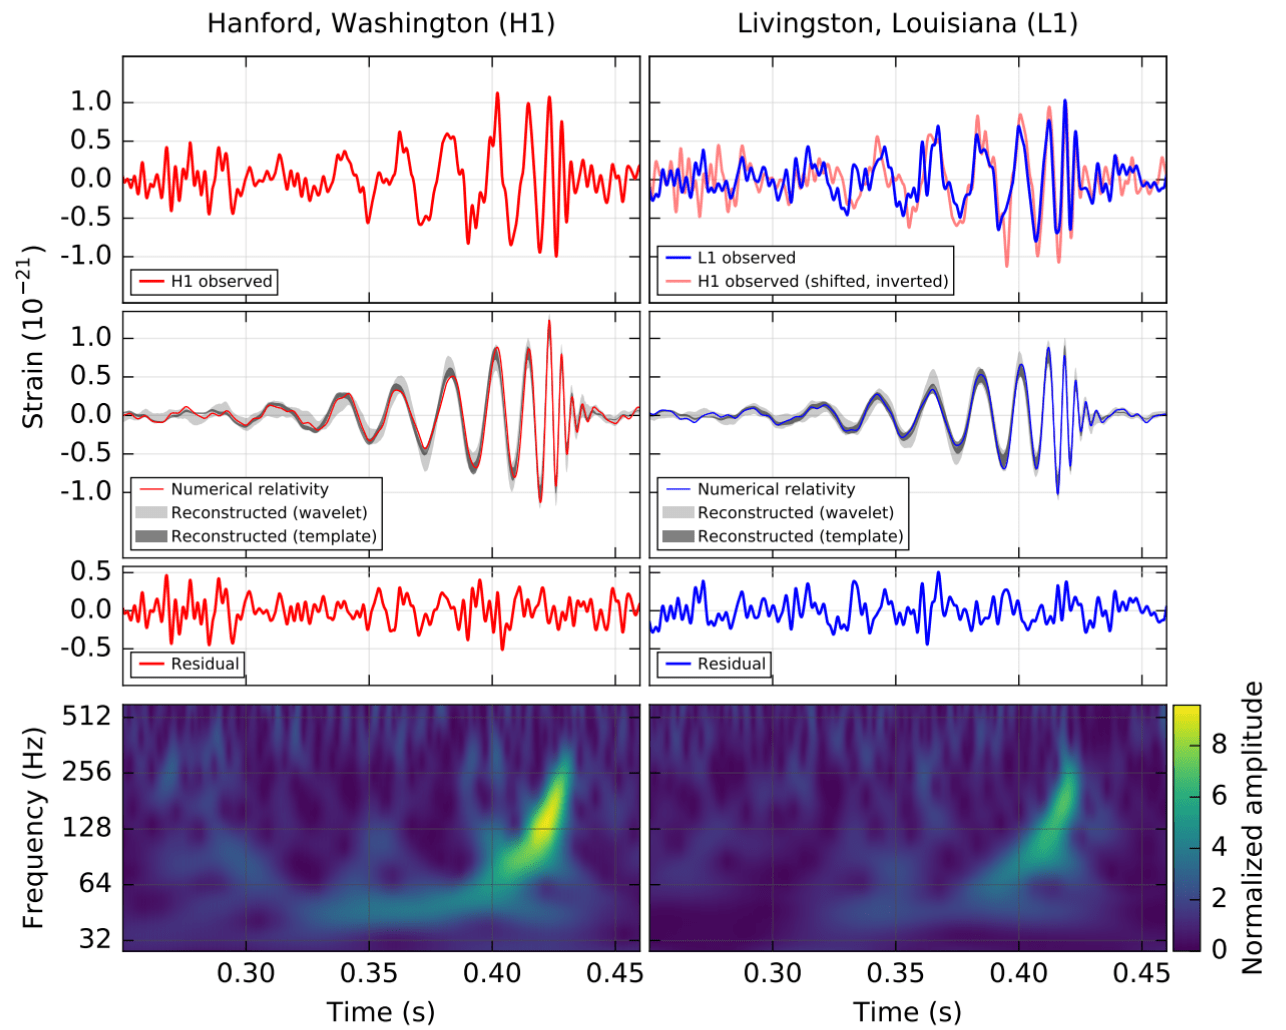
第一例双黑洞并合 GW150914 引力波信号
我们依靠一组互相支持的检查。两台探测器都出现变化,也还需要统计分析和仪器排查,才能判断解释有多可信。
第一例双黑洞并合 GW150914 引力波信号
重要的变化,是从‘我觉得应该如此’,走到‘如果如此,我们应该观察到什么;如果观察不同,该修改哪里’。
科学研究把疑问转为有证据约束、可以公开讨论和修正的解释。
观点
我的观点....
理由
因为...的理由
证据
在...证据的基础上
承认和回应
我承认这些质疑、反对和不同的想法,并用这些论据提出回应
论据
让我的理由和观点连接的原理是....
From: 《研究是一门艺术》
“科学理论”是核心特征?
一个科学理论应该逻辑内部一致,并与已有的科学知识相协调,不能自相矛盾,也不应与已被广泛验证的理论冲突。一致性也是科学理论“质量好坏”的基本评判指标之一。
常见的误解:
科学理论是初步的想法,当积累到足够的数据和证据时,它最终将转变为科学定律。
(理论并不会因为积累了更新或更好的证据而转变为科学定律。)
某实验或观测证明了某科学理论。
(理论只能被证伪,无法被证明,顶多只能说该证据支持了某理论。)
“盲人摸象”
From: Astro小花裙(冷笑话).cn
不同观测、模型与方法互相检查,逐步修正共同图景。我们需要知道已经解释了什么、哪里仍然未知,以及接下来怎样补上缺口。
科学关心一个解释是否可靠。
一个人为什么愿意为一个问题投入时间?
想成为研究生的常见动机:
过年回家,你是否享受着亲朋好友簇拥下的某种光环?
为了提升文凭和学历
为了提升找工作的机会
为了提升薪酬水平
为了面子
为了父母
为了逃避
...
想成为研究生的常见动机:
为了提升文凭和学历
为了提升找工作的机会
为了提升薪酬水平
为了面子
为了父母
为了逃避
...
2008年中科院晨兴数学中心的结业课程上
(From 马寅哲: “一位远去的师者”)
过年回家,你是否享受着亲朋好友簇拥下的某种光环?
我们做科研的动机“该”是什么?
Individualism
Collectivism
能有我自己名字命名的某理论/定理/效应
我们做科研的动机“该”是什么?
Individualism
Collectivism
能有我自己名字命名的某理论/定理/效应
为了造福人民
有使命感
我们做科研的动机“该”是什么?
Individualism
Collectivism
能有我自己名字命名的某理论/定理/效应
实现个人价值
让别人看得起
为了造福人民
为了取悦自己
有使命感
我们做科研的动机“该”是什么?
Individualism
Collectivism
能有我自己名字命名的某理论/定理/效应
实现个人价值
让别人看得起
为了造福人民
为了取悦自己
科学职业道路
为了寻找观点
为了自我挑战
有使命感
我们做科研的动机“该”是什么?
Individualism
Collectivism
好的科研动机,应该能让你持续产出,在长期坐冷板凳时不至于自我怀疑,
也能在同行的审视与质疑中站得住脚。
能有我自己名字命名的某理论/定理/效应
实现个人价值
让别人看得起
为了造福人民
为了取悦自己
科学职业道路
为了寻找观点
为了自我挑战
有使命感
我们做科研的动机“该”是什么?
现实需要、成就感与好奇心可以并存
一个残酷的事实:
VS
以为的研究生生活
现实的研究生生活
又一个残酷的事实:
你准备好毕业了吗?
是:
能否独立推进一个问题
能否被“下一个系统”接受
能与他人合作,也能承担独立判断
逐渐能够界定问题、判断证据,并独立推进下一步
The aim, as far as I can see, is the same in all sciences. Put simply and curiously, the aim is to make known something previously unknown to human beings. It is to advance human knowledge, to make it more certain or better fitting. The aim is ... discovery. (Elias 1986)
研究进程的非线性本质:
理想线:是对“解决问题”的线性想象。
现实线:是遭遇“研究难题”的真实写照——大量时间耗费在界定真问题、寻找方法、试错与论证上。
平台期不是停滞,而是思维在黑暗中为突破蓄力。每一次“心跳复苏”,都对应着一个核心“研究难题”的攻克。
Q:您在研究中是如何保持好奇心和热情的?对我来说,
如果我发现实验中出现了错误,我必须重新进行所有实验,那真的很崩溃。
---------------------------------------------------------------------------
何恺明:我认为研究本就充满了挫折、失败和沮丧。实际上,它包含了你能想到的所有负面词汇,这就是事实。如果你没有经历过这些,那意味着你并没有进行最好的研究。
我的生活就是这样,我有大约95%的时间都很失望,然后我会花5%的时间完成那篇论文,接着进入下一个循环,不断经历沮丧、挫败和焦虑,直到下一项工作完成。享受那5%的时光,如此反复。
试错和排除解释可以增加认识;长期停滞也可能提示缩小问题、调整方法或寻求合作
科研工作者 vs 创业者 (1/2)
日常状态:在不确定性的海洋中航行
核心能力: 高度重叠的技能树
在不确定性中推进,让投入保持可持续
一线科研工作者 vs 前线士兵 (2/2)
From: 《心灵奇旅》
心流
在不确定性中推进,让投入保持可持续
一线科研工作者 vs 前线士兵 (2/2)
身体健康是革命的本钱
From: Nature:超1/3博士生焦虑抑郁
1. 题目:我正在研究_______。
2. 问题:因为我想要找出什么(what)/为什么(why)/如何(how)_______。
3. 重要意义(理由):为了帮助读者了解_______。
不够痛的“优化型”问题
Eg:
1. 我正在研究冷却系统修复的诊断过程。
2. 因为我要尝试找出修复专家是如何诊断故障原因的。
3. 为了帮助读者了解如何设计一个可以自动诊断及预防故障的电脑系统。
从一个仅仅有趣的问题到这个问题更广泛的意义:
1. 我正在研究基于AI的引力波信号探测和识别方法。
2. 因为我要尝试找出深度学习模型如何在强噪声背景下有效地区分真实引力波信号与噪声瞬变。
3. 为了帮助读者了解如何构建一个能够在真实探测环境中实现快速、稳健、低误报的引力波自动探测系统。
意义可以来自解释异常、澄清概念、补知识缺口
或改善方法,
真正更有意义的问题,源于并回应真实的痛点。
From: 《研究是一门艺术》
真正痛的“生存型”问题
我研究什么;想弄清什么;为什么值得弄清。
一般你要为读者回答以下五种问题:
观点
我的观点....
理由
因为...的理由
证据
在...证据的基础上
承认和回应
我承认这些质疑、反对和不同的想法,并用这些论据提出回应
论据
让我的理由和观点连接的原理是....
From: 《研究是一门艺术》
论证的核心架构:
From: 《研究是一门艺术》
主张:我认为怎样;理由:为什么;证据:哪些观察或推导支持;替代解释:还有什么可能;回应:哪些检查能够区分。
Eg:
承认:我们承认在GW150914之前,已有对脉冲双星PSR B1913+16的观测,其轨道衰减间接证据支持了引力波的存在。这似乎意味着“窗口”早已打开。
回应:然而,间接验证不同于直接探测。....
观点
我的观点....
理由
因为...的理由
证据
在...证据的基础上
承认和回应
我承认这些质疑、反对和不同的想法,并用这些论据提出回应
论据
让我的理由和观点连接的原理是....
From: 《研究是一门艺术》
主张:我认为怎样;理由:为什么;证据:哪些观察或推导支持;替代解释:还有什么可能;回应:哪些检查能够区分。
理解数据驱动AI,可以先从它怎样利用经验开始。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source)
从数据中学习模型,是理解当下AI的一条主线。
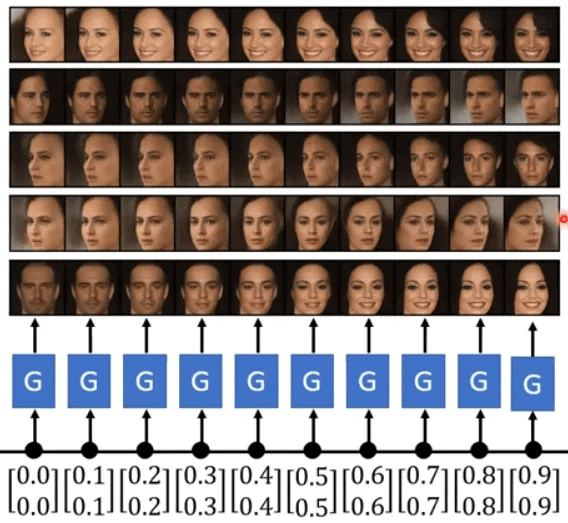
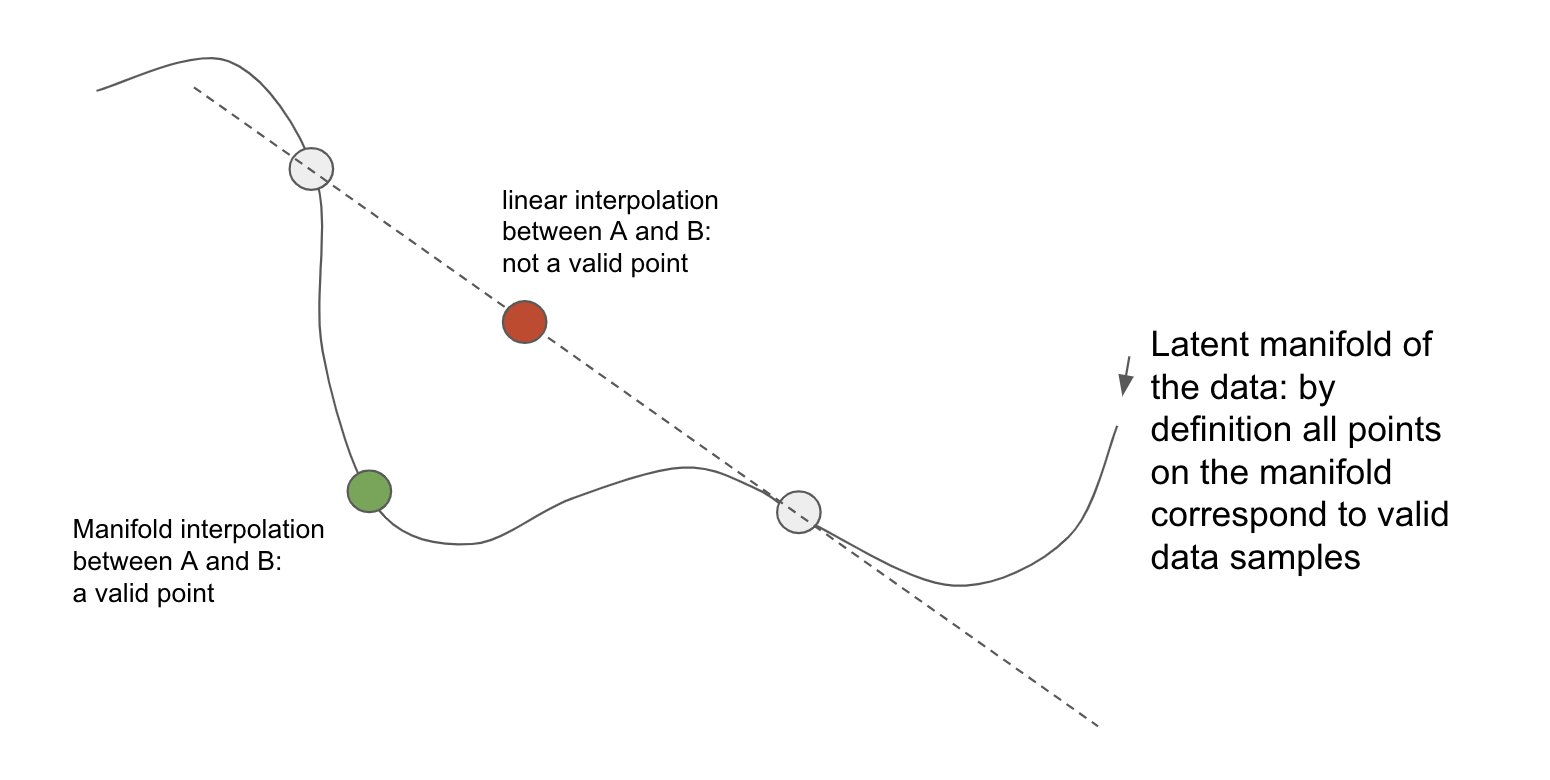
例如人脸 morph 的例子就很好:像素空间线性插值和 latent space 插值不是一回事。深度模型真正强的地方,往往是先把数据组织成一个有结构的 representation manifold,再在这个空间里做平滑泛化。
为什么一串新的图像,仍然可以保持合理的变化?
例如人脸 morph 的例子就很好:像素空间线性插值和 latent space 插值不是一回事。深度模型真正强的地方,往往是先把数据组织成一个有结构的 representation manifold,再在这个空间里做平滑泛化。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source)
Representation Space Interpolation
在学习到的表示空间中插值
能生成合理候选,为进一步探索提供了起点。
G:生成模型
同样的两个端点,沿不同结构变化,会得到不同结果。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source)
建模让复杂经验变得可组织、可预测、可生成。
在学习到的表示空间中插值
Deep learning 的强大之处,很多时候不是“凭空外推”,而是学到了一个 representation,使得原来复杂的数据关系在这个 manifold 空间里变得更平滑、更容易插值。
新例子可以与训练经验共享结构。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source)
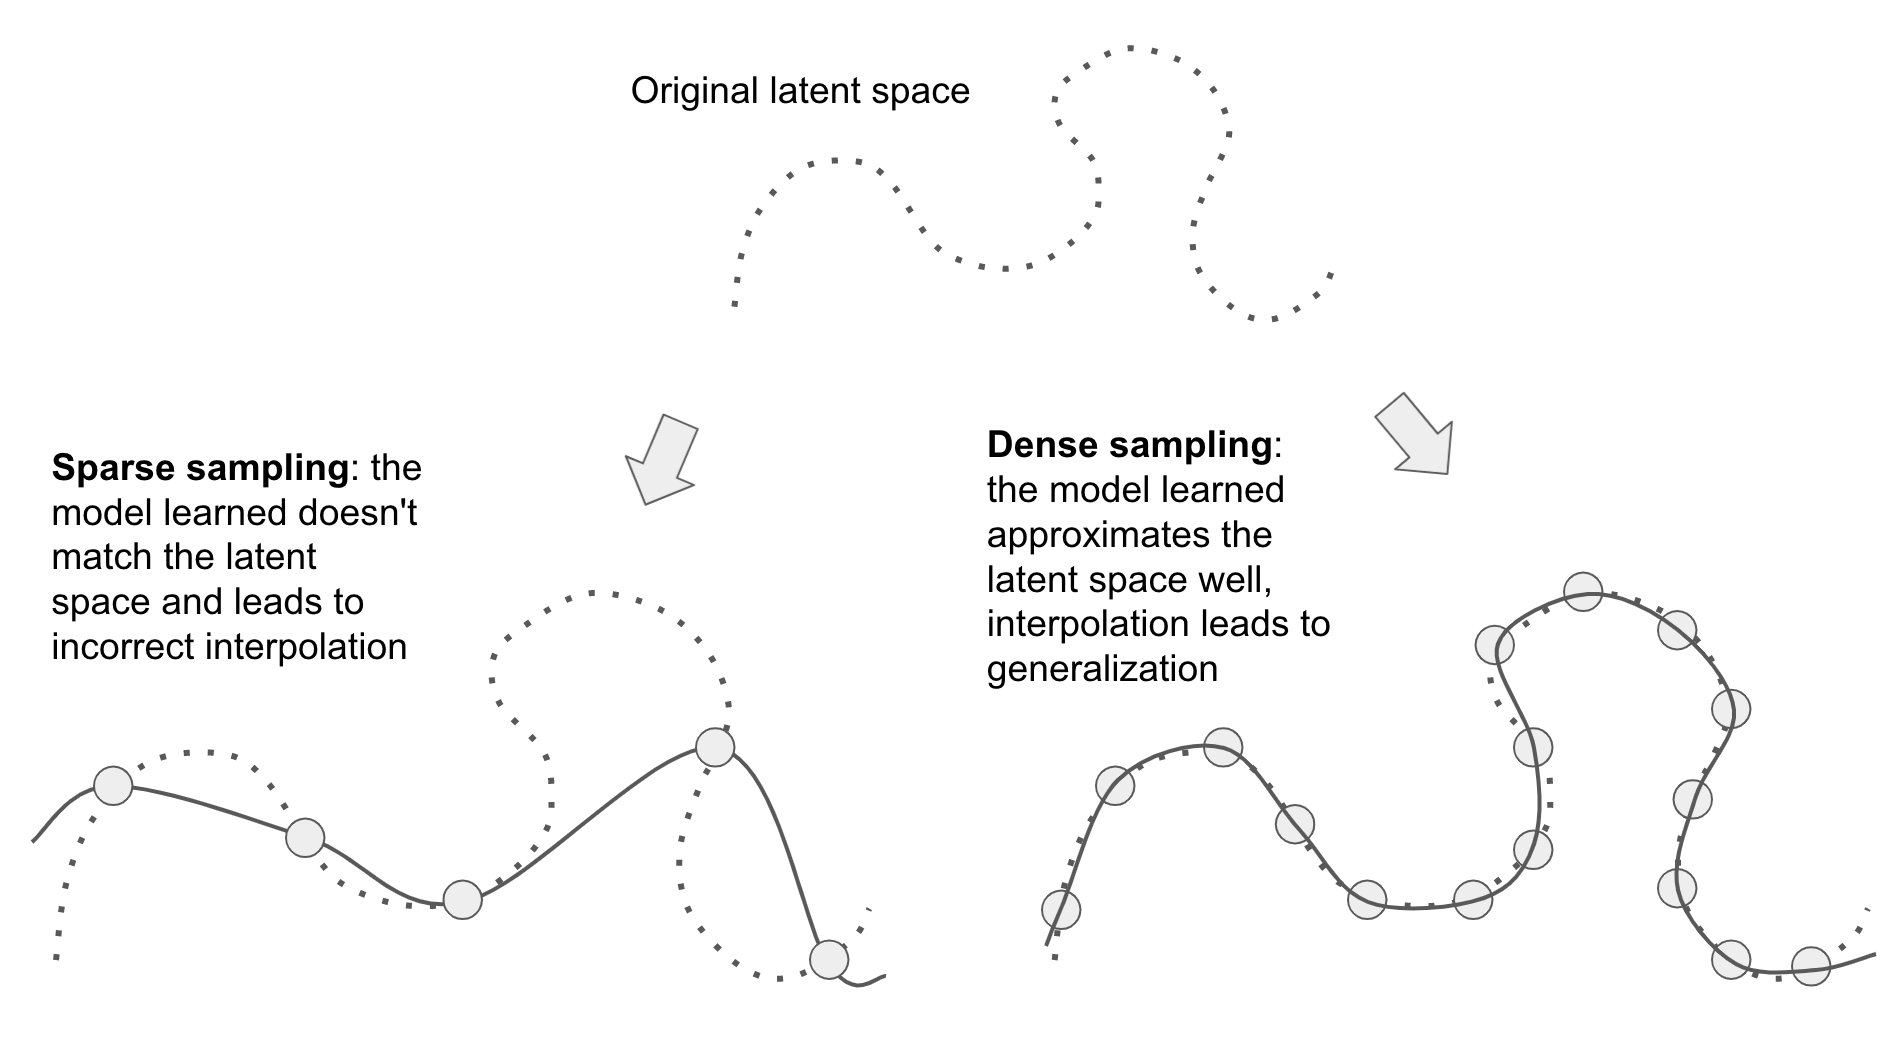
Underlying data manifold / latent structure
也就是现实数据真正分布的“结构”。
Sparse data → wrong geometry → poor generalization
训练数据太稀疏时,模型只能从少量样本猜测这个结构,因此学到的 manifold 可能偏离真实 manifold。
Dense coverage → better representation → reliable interpolation
数据覆盖越充分,模型越容易学到接近真实 manifold 的表示,因此在已覆盖结构附近做 interpolation 时,泛化会更稳定。
Generalization is not magic — it comes from structure shared between training and unseen data.
AI 之所以可以在“没见过”的样本上表现好,并不意味着它真的见到了一个完全陌生的世界。很多时候,新样本虽然没出现过,但仍然落在训练数据已经覆盖的同一个结构上。
LLMs appear highly general because their training distribution is extraordinarily broad.
GPT 看起来能回答一个“从没见过的问题”,不一定意味着它在严格数学意义上做了很远的 extrapolation;很可能是因为互联网规模的训练数据已经让 latent space 覆盖了极其丰富的语言、代码和知识结构。
所以,
新例子可以与训练经验共享结构。
Deep Learning is Not As Impressive As you Think, It's Mere Interpolation (Source)
模型提出候选;独立检查帮助我们判断候选是否可用。
Underlying data manifold / latent structure
也就是现实数据真正分布的“结构”。
Sparse data → wrong geometry → poor generalization
训练数据太稀疏时,模型只能从少量样本猜测这个结构,因此学到的 manifold 可能偏离真实 manifold。
Dense coverage → better representation → reliable interpolation
数据覆盖越充分,模型越容易学到接近真实 manifold 的表示,因此在已覆盖结构附近做 interpolation 时,泛化会更稳定。
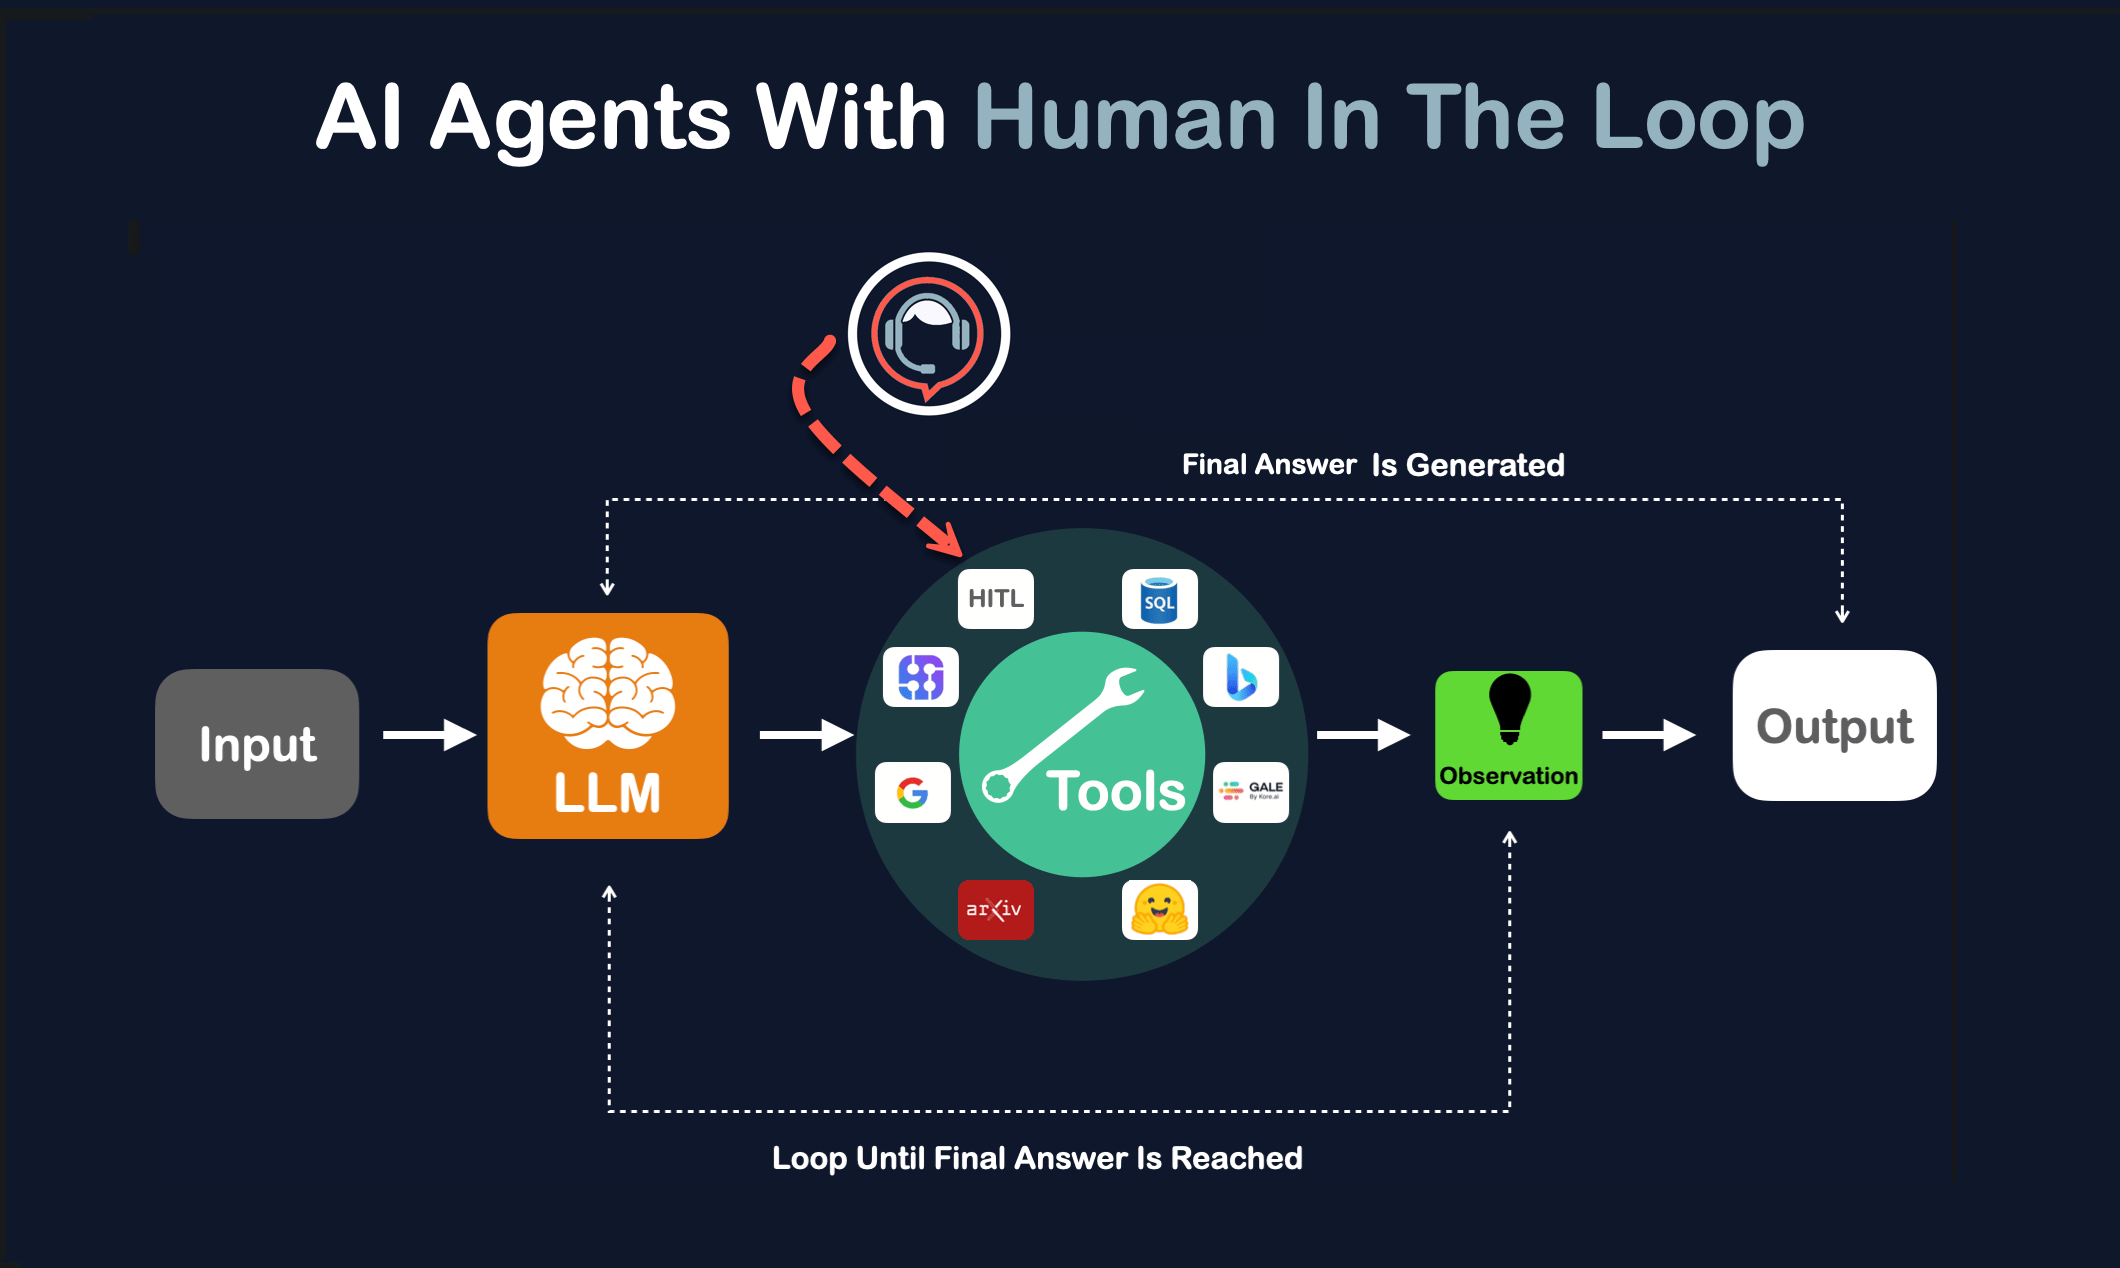
把模型放进能够行动并接收反馈的工作过程。
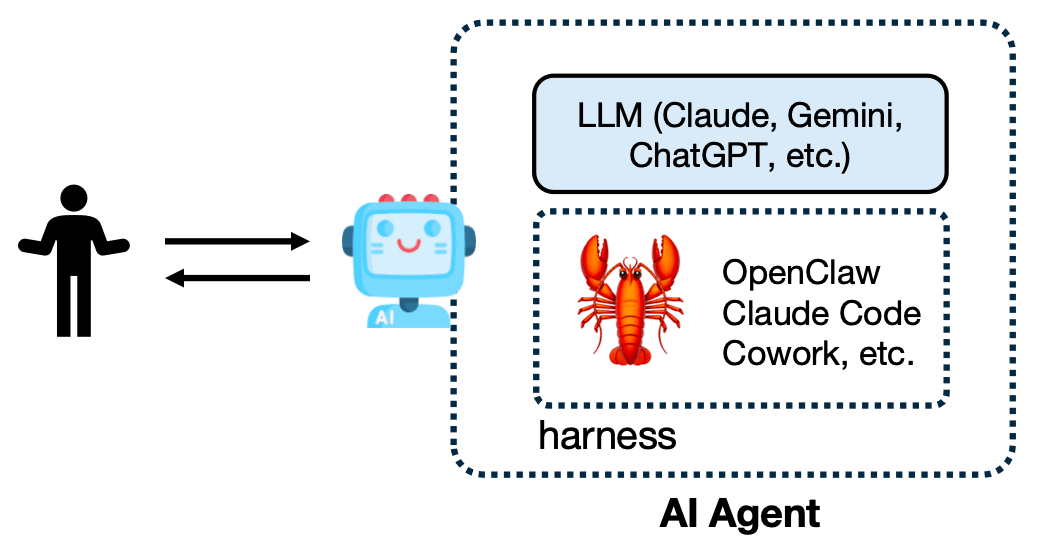
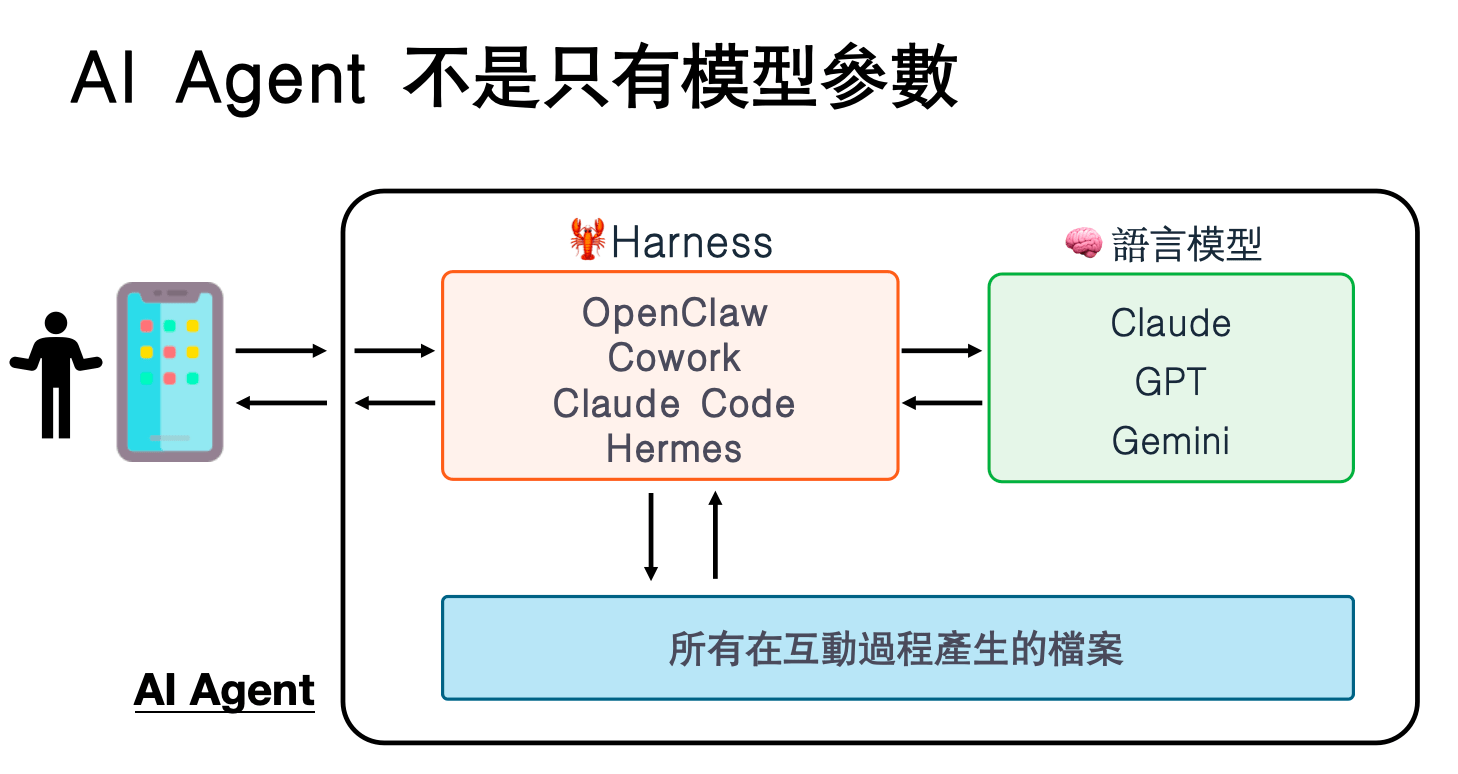
一个常见的LLM智能体框架:模型、工具、环境与反馈循环。
以“修复已有程序错误”为例。
你的任务是修复 `parser.py` 中的 bug。
目前 `extract_emails` 函数无法正确提取帶有 `-` 或 `_` 的 email 地址,例如 `test-user@domain.com`。
请修改 `parser.py`,使 `verify.py` 的测试能够完全通过。
You are an AI Agent. You can interact with the environment by writing code blocks.
If you write a ```bash\n...\n``` block, the system will execute it and return the output.
If you write a ```python\n...\n``` block, the system will execute it and return the output.
To finish the task, output 'DONE'.Provided tool;
沒有提供 “parser.py”
…… 我自己寫一個
parser.py
def extract_emails(text): ……
# Example test cases to verify the fix
test_string_1 = ……
DONE
“做完了”需要对应可查看的产物与明确的检查。
[CONTEXT]
You are running in a Linux environment (Google Colab). You need to find and modify the correct files to achieve the goal.

[INSTRUCTIONS]
1. Before modifying anything, you MUST inspect the current working directory, system environment, and file tree.
2. List all potentially relevant files.
3. Do not blindly modify files without looking at their contents first.


[DONE-WHEN]
You are done ONLY when the specific success criteria mentioned in the task are met, and the expected artifacts exist.
目前的环境
怎么工作
怎样算是完成
如果:增加一些额外的 prompt
以“修复已有程序错误”为例。
“做完了”需要对应可查看的产物与明确的检查。
…
First, I will list the files.
```bash
ls -R
```
保留执行记录:
--- Bash Execution ---
parser.py
verify.py
…
I will now display the content of `parser.py`.
```bash
cat parser.py
```--- Bash Execution ---
import re
def extract_emails(text):
……```bash
cat <<EOF > parser.py
def extract_emails(text):
……
EOF
```--- Bash Execution ---…
I will execute `verify.py`.
```bash
python verify.py
```--- Bash Execution ---
VERIFY_SUCCESS读文件
找文件
改程序
跑测试
看结果
可靠的工作流程,需要可靠的反馈。
一次任务的效果,取决于这些条件怎样配合。
可以把它理解为让智能体持续工作的配套机制。
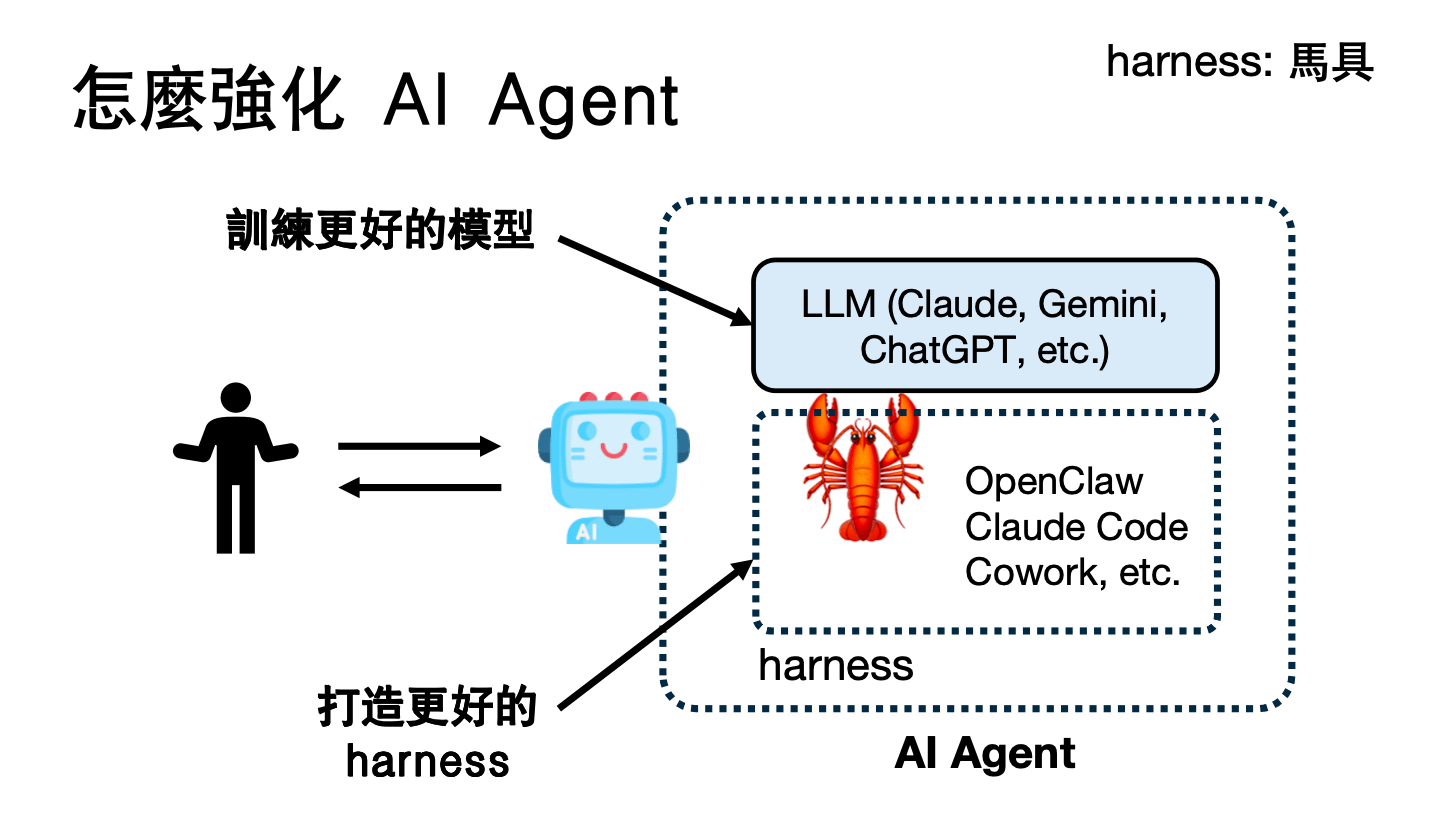
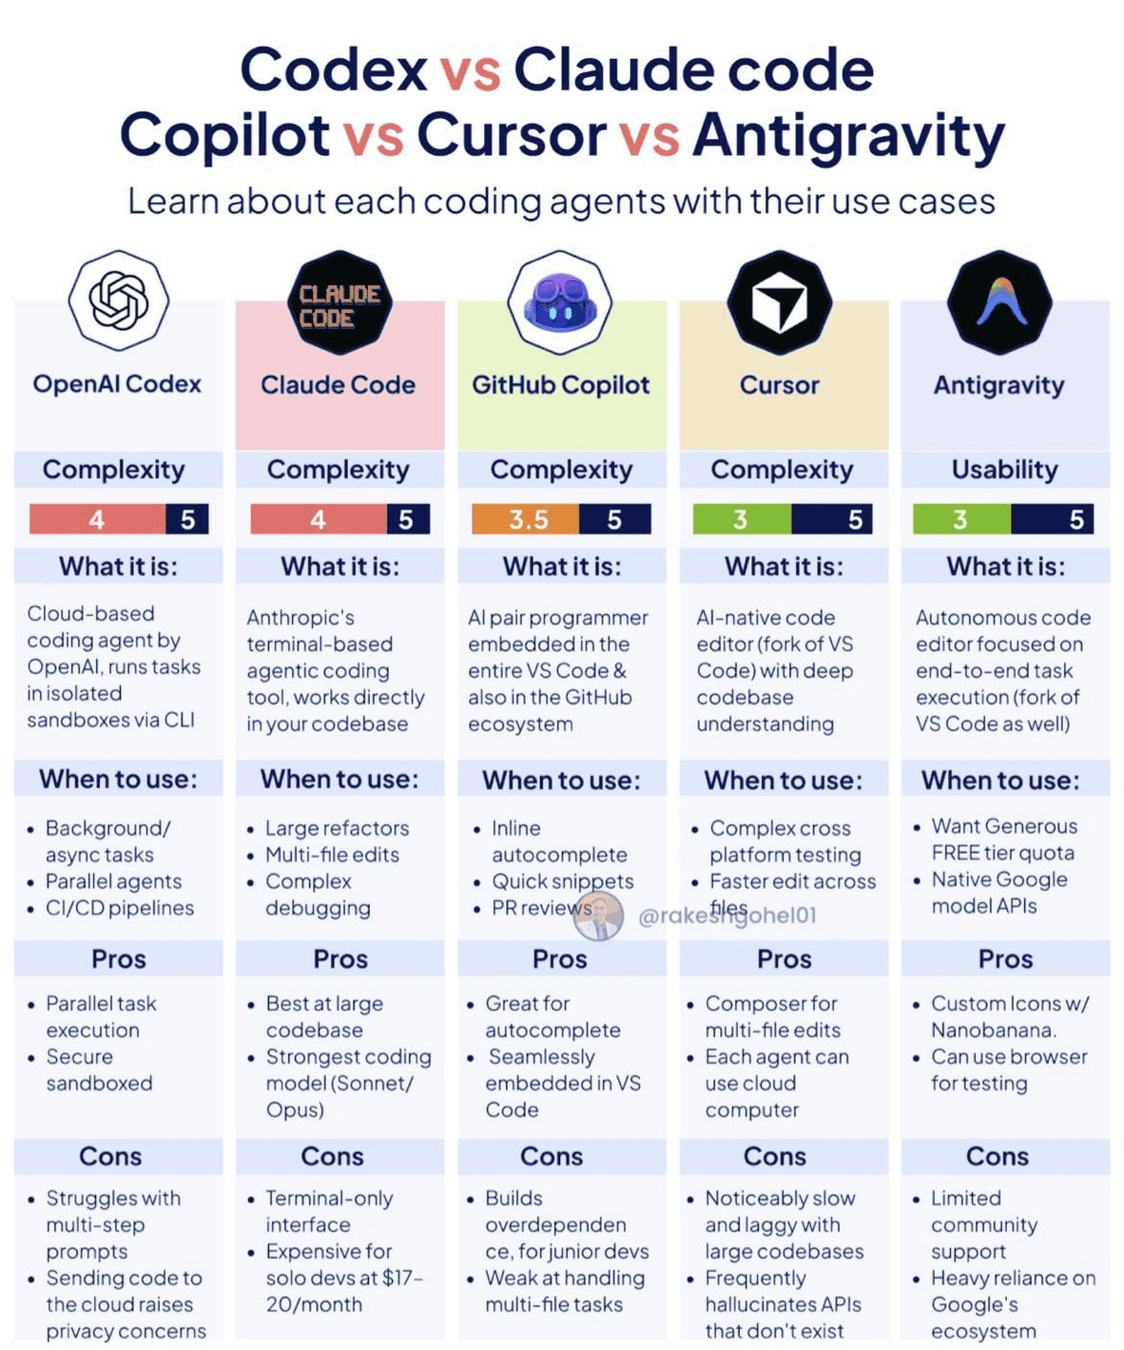
选择更好的模型
选择更好的 Harness
Claude Code、Codex CLI、OpenClaw……
\(\boxed{\text{AI Agent}=\text{LLM}+\text{Harness}+\text{Environment}}\)
Harness: equipment for controlling a horse
AI Agent 不是只有模型参数
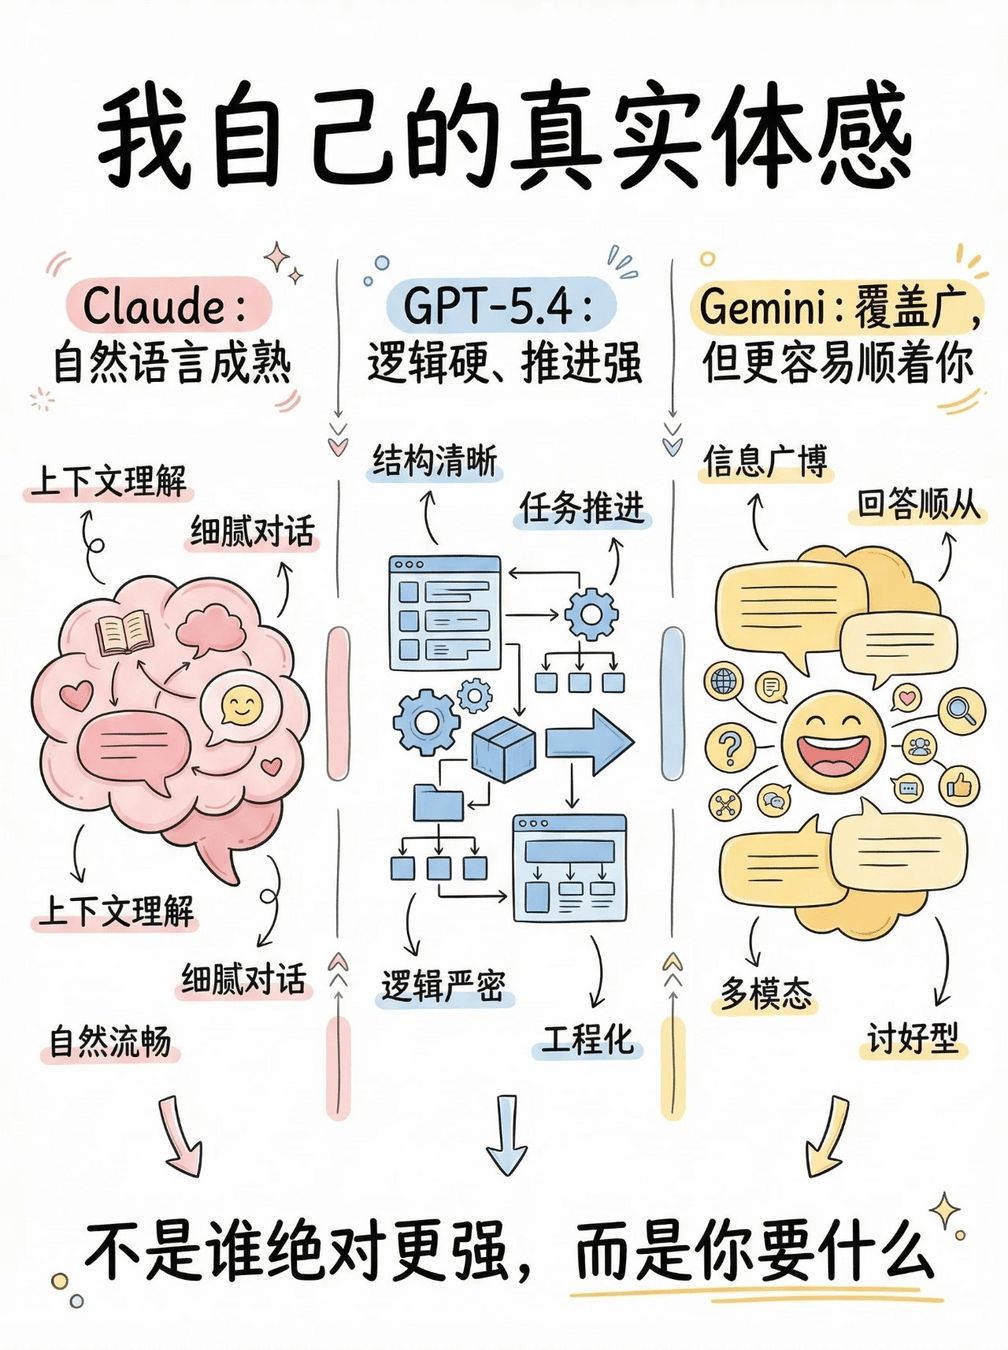
不要迷信只有一个”最好的模型”。
先用一个能力足够的模型,认真试一次真实任务。
用真实任务认识模型的能力与边界。
同一个模型,工作方式也会影响任务结果。
看它实际做过什么,以及完成了什么。
我想做一个实验。你可以随意问我任何一个问题,我会尽可能真实且完整地回答。基于我的回答,你再继续问下一个问题。我们会这样来回进行,持续下去,直到挖掘出我内心深处的构思——包括谬误、局限、潜能、需要改进的地方,或者任何潜藏在我潜意识中的东西。我的目的、已有材料与实际限制 (prompt提示词)
AI提出的候选判断(观点,理由,
论据,证据)
你要抵达的明确目标与完成标准
(往往不可知)
所有用于训练模型的已知的知识,经验,以及收集的数据信息
训练后的 AI agent (LLM+Harness)所覆盖的连续表征的信息空间
借助LLM、工具与反馈可以尝试的思路和行动
探索过程示意
Navigating the Space of Ideas
AI直觉,来自真实任务中的尝试、反馈与修正。
科学、学术与人生
让好的模型与工作流程,服务于你真正想做的事。
你最想借助AI做成的一件事,是什么?
for _ in range(num_of_audiences):
    print('Thank you for your attention! 🙏')
太极实验室 2026 年度“大学生创新实践训练计划’
(引力波数据分析与 AI for Science 方向)
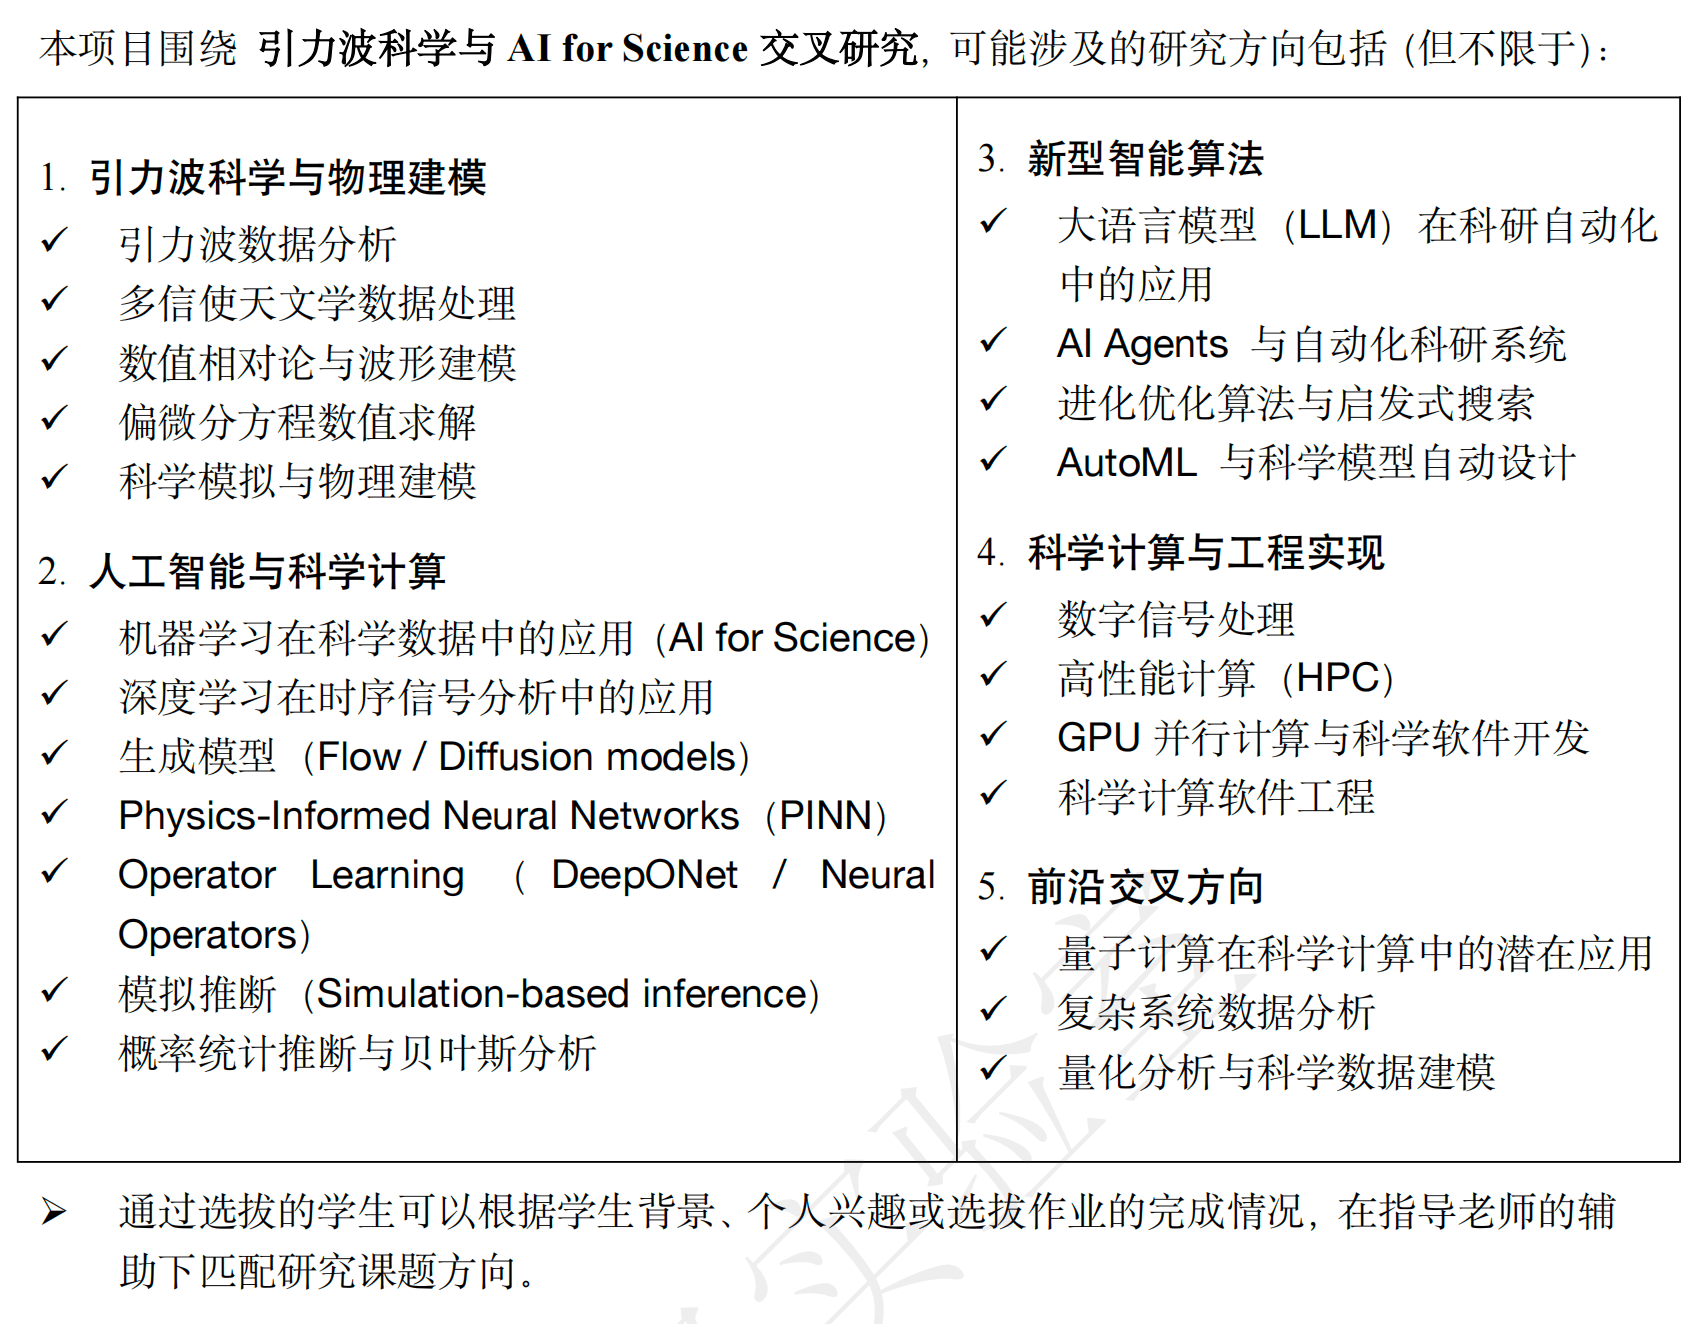
中国科学院大学引力波宇宙太极实验室(北京)引力波数据分析与机器学习课题组长期面向全国高校学生开放科研训练机会,现面向全国优秀学生招募参加太极实验室2026年度“大学生创新实践训练计划”,本课题组致力于探索引力波天文学、数值模拟与人工智能技术的交叉研究,重点发展新一代 Al for Science 方法,用于解决复杂物理系统建模、信号处理与科学数据分析问题,欢迎对 引力波科学、人工智能算法与科学计算 充满兴趣的同学加入,在真实科研项目中接受系统训练,并参与国际前沿研究。
https://github.com/iphysresearch/UndergradResearchLab/blob/main/2026科创计划及选拔题目.pdf
# End
By He Wang
2026/11/7 16:00 | 桃李大讲堂 | @内蒙古大学