Como treinar o seu dragão de
Victor Sanches Portella
https://victorvsp.github.io/
Bilhões de Parâmetros
Setembro, 2026

A matemática por trás da IA moderna
Sobre o que (não) é essa palestra?
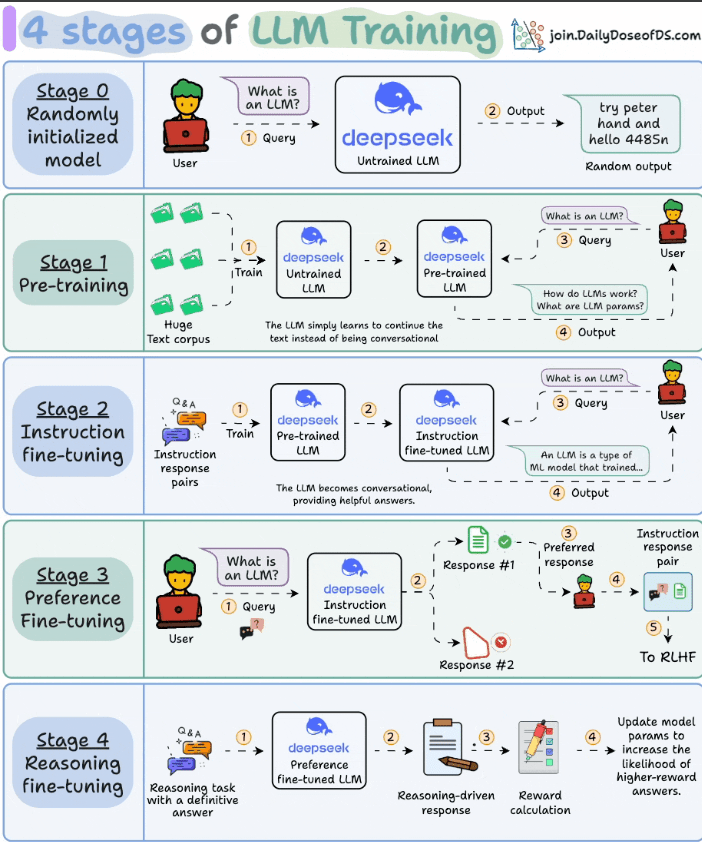
Treinamento de modelos e suas fases
Treinando Dragõezinhos
Regressão em 1 dimensão
Dados: \((x_i, y_i)\) pares de números
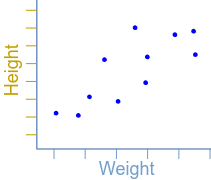
Tarefa: Dado um novo valor \(x\), predizer um valor \(y\) baseado nos dados
Regressão linear em 1 dimensão
Dado \(x\), predizemos
f(x) = a \cdot x + b
Parâmetros: \(a\) (inclinação) e \(b\) (interseção do eixo \(y\))
Como escolher \(a\) e \(b\)?
Como escolhemos uma reta?
Como comparar modelos? - Função de perda
O erro de predição da reta nos dados é
L(a,b) = \sum_{i = 1}^n \big( (a \cdot x_i + b) - y_i \big)^2
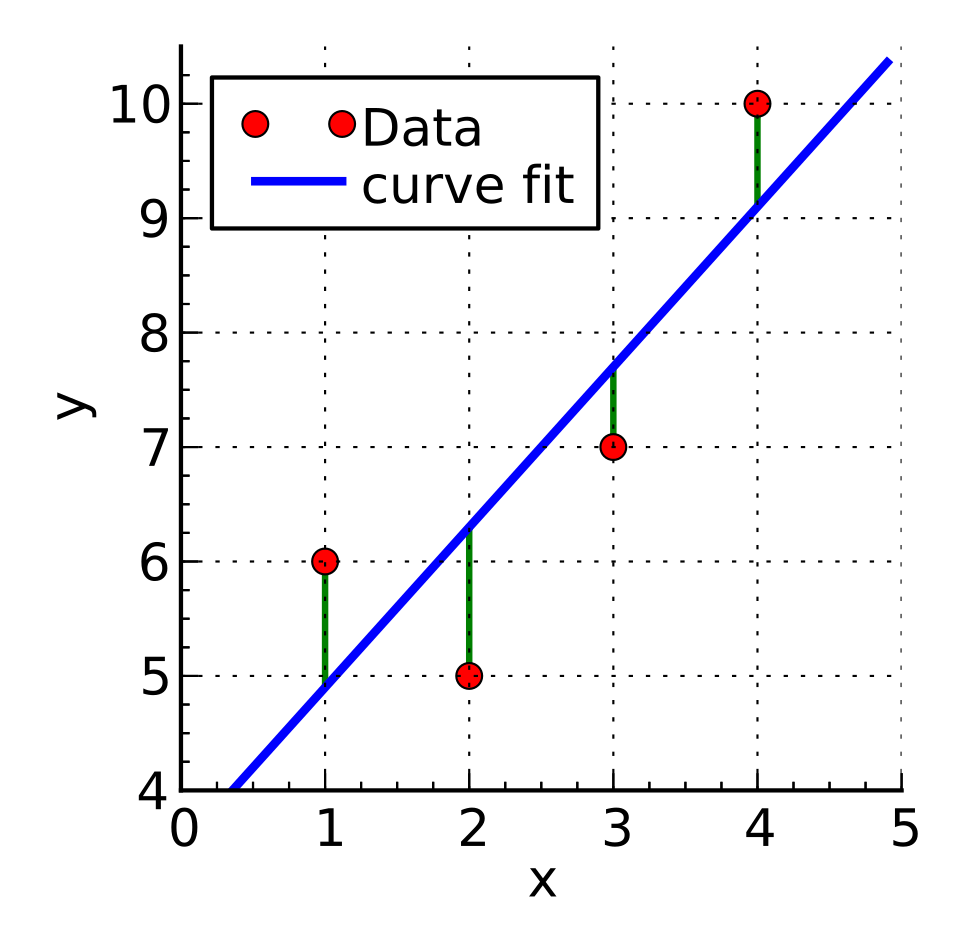
Como escolher \(a\) e \(b\)?
Aqueles que minimizam \(L(a,b)\)!
Valor real \(y_i\) para \(x_i\)
Predição do modelo para \(x_i\)
Achando o melhor modelo
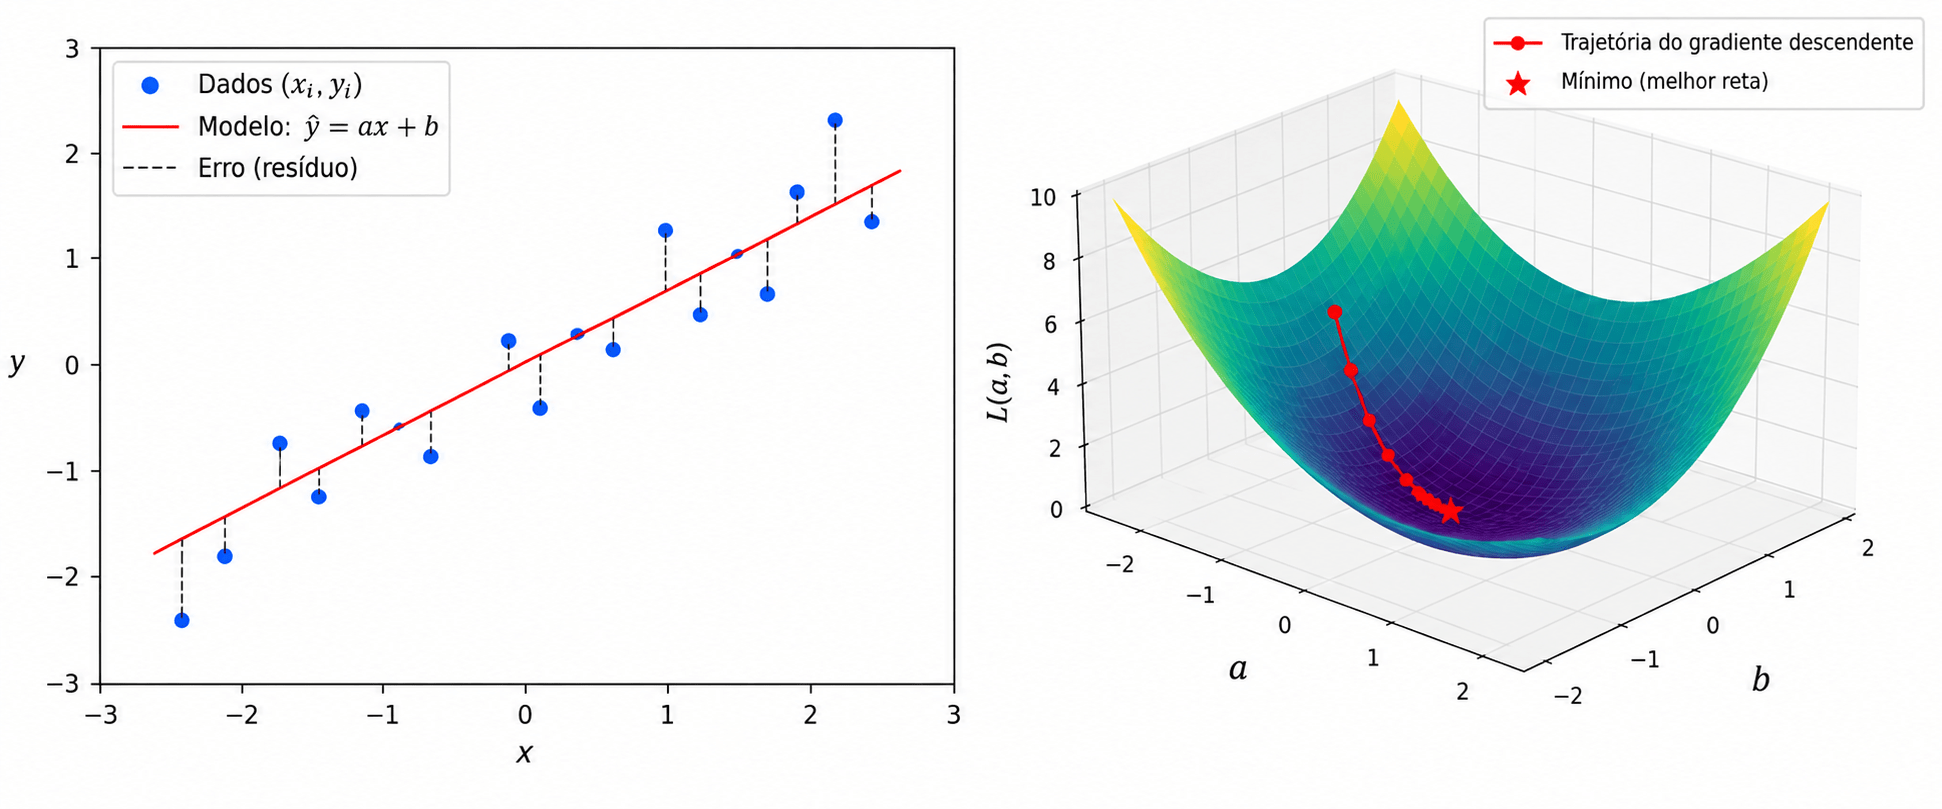
Treinar modelo
Achar parâmetros \((a,b)\) que minimizam \(L(a,b)\)
=
Regressão linear tem fórmula fechada!
Convexidade, modelo simples, erro quadrático...
Dados além de uma dimensão
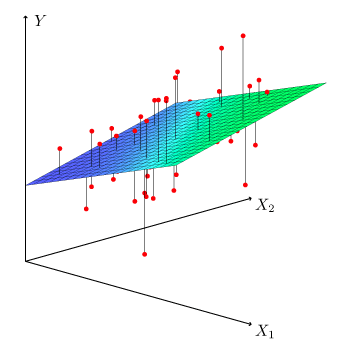
E se os dados \(x_i\) forem vetores?
Predizer altura a partir de peso, país, salário, etc...
Basta ainda minizar o erro como função dos parâmetros!
L(w) = \sum_{i = 1}^n \big( w^{\mathsf{T}} x_i - y_i \big)^2
Vetor de parâmetros
(w_1, \dotsc, w_d)
Um parâmetro para cada entrada do \(x\)
Para além de regressão linear
Regressão linear ainda tem solução "simples"
Tempo \(O(d^3)\)
Sistema de equações com \(d\) variáveis
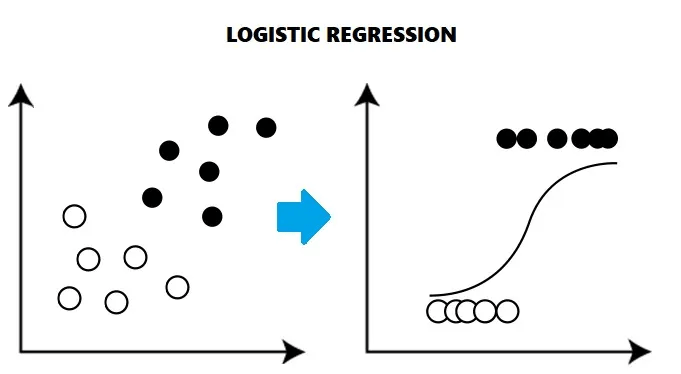
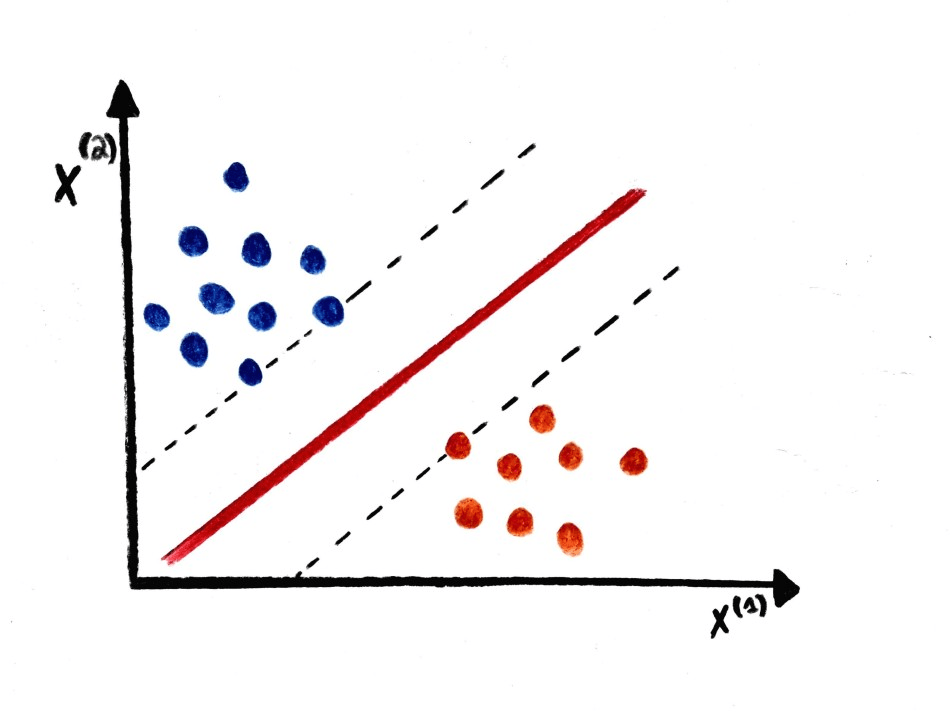
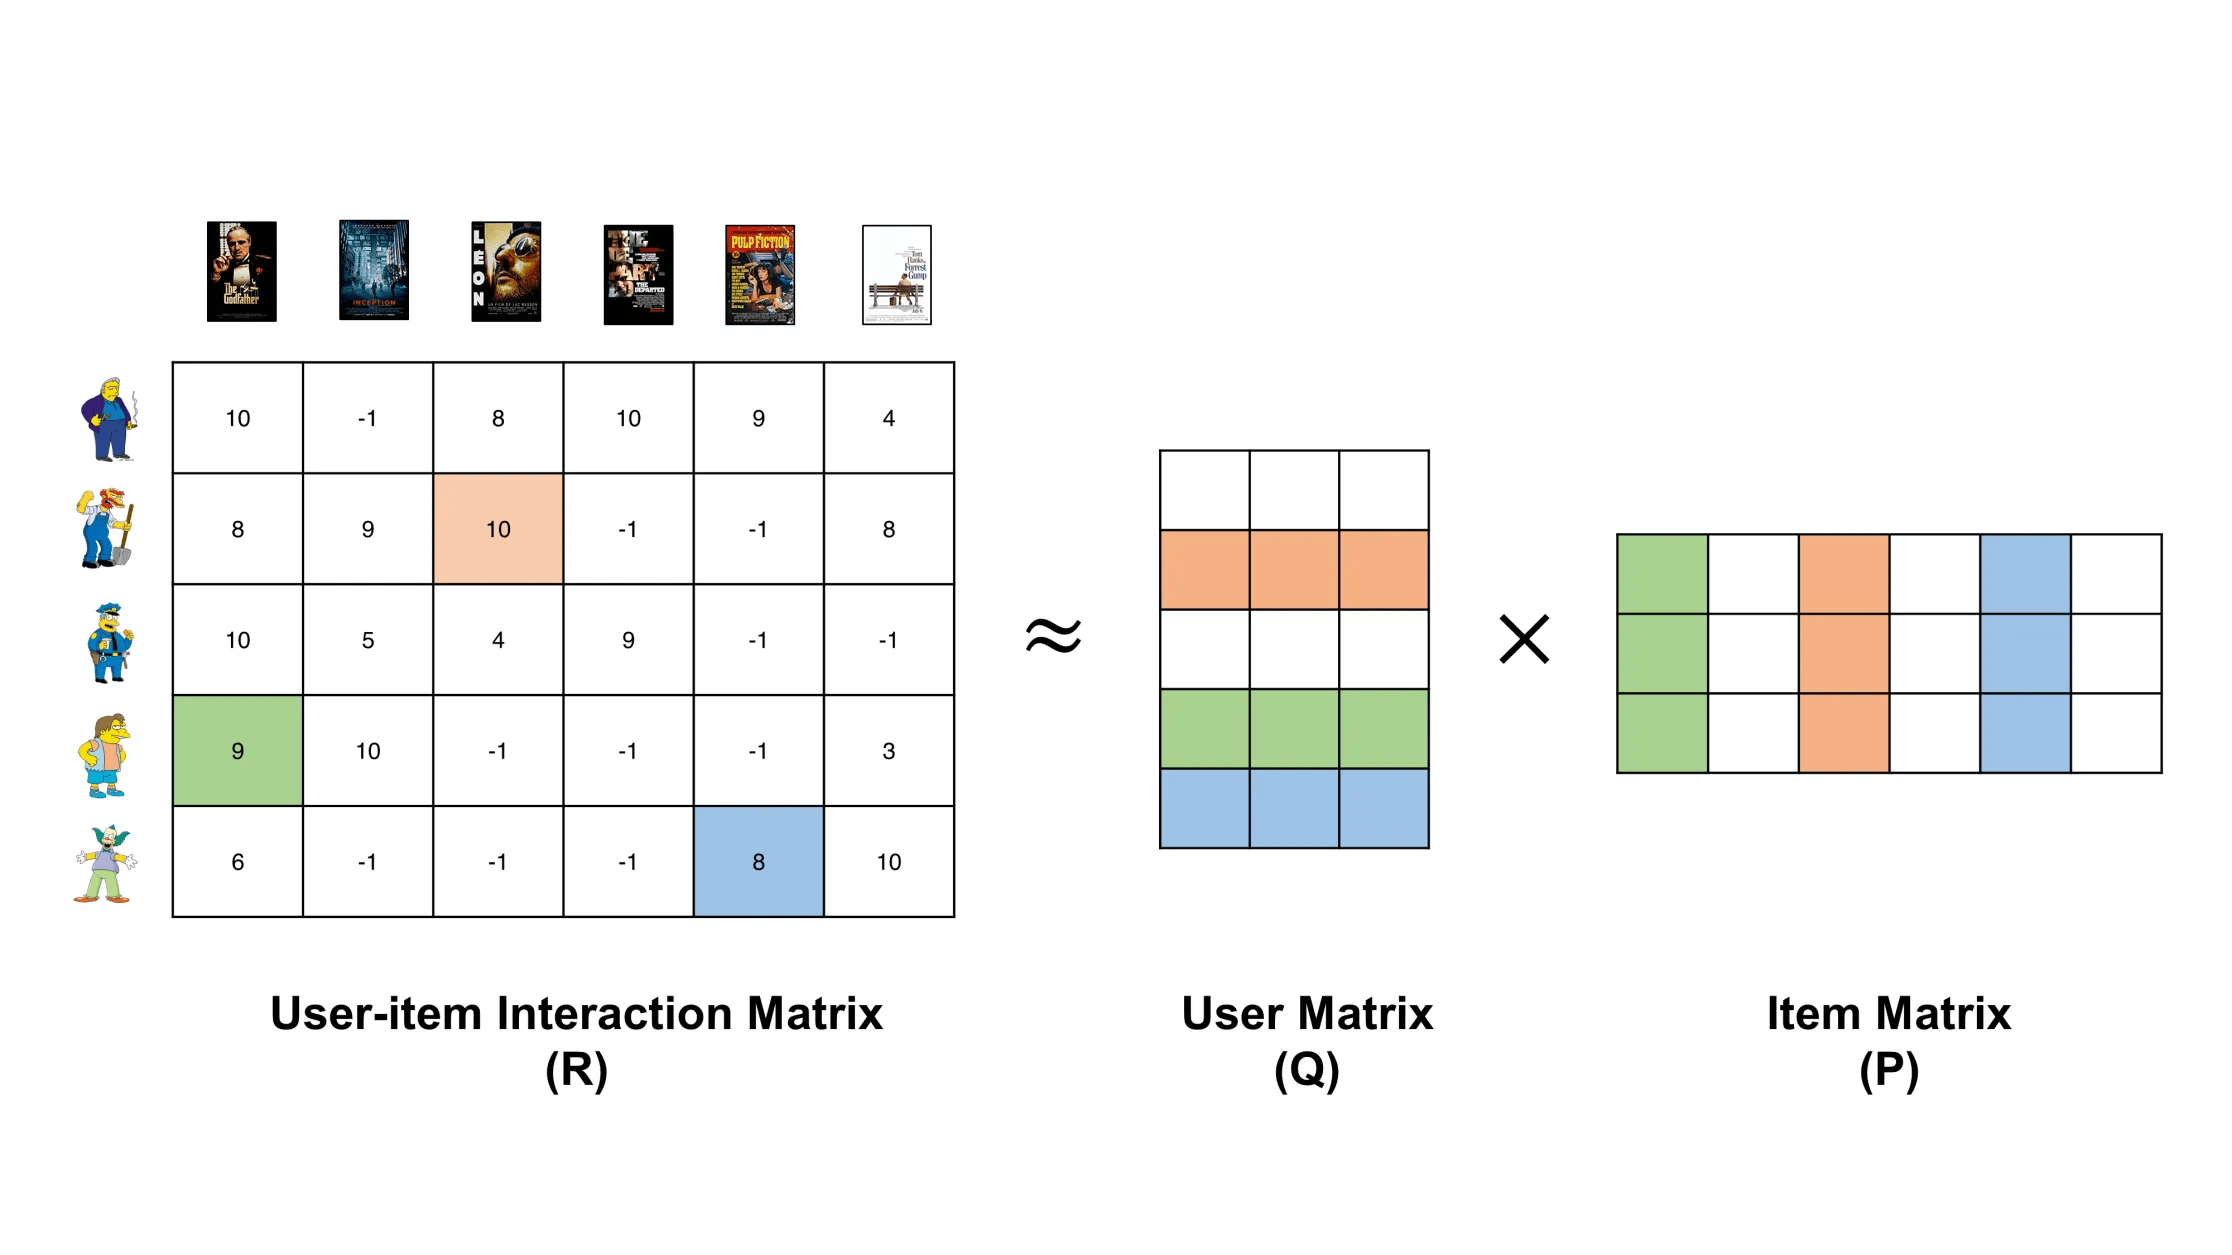
Existe muitos modelos além de regressão linear
Regressão Logística
SVM
Fatorização de Matrizes
Praticamente todos sem solução "fácil"
Visão de minimizar o erro \(L(w)\)
(muitas vezes convexo) cabe em todos
Por que otimização de primeira ordem?
Treinar um modelo de ML normalmente é modelado via optimização irrestrita
Modelos de ML tendem a serem GRANDES
\displaystyle \min_{w \in \mathbb{R}^{d}}~L(w)
\(d\) é GRANDE
\(O(d)\) tempo e espaço por iteração é preferível
Solução exatamente ótima nem sempre é necessária em machine learning
Se não depender do número de dados \(n\), ainda melhor
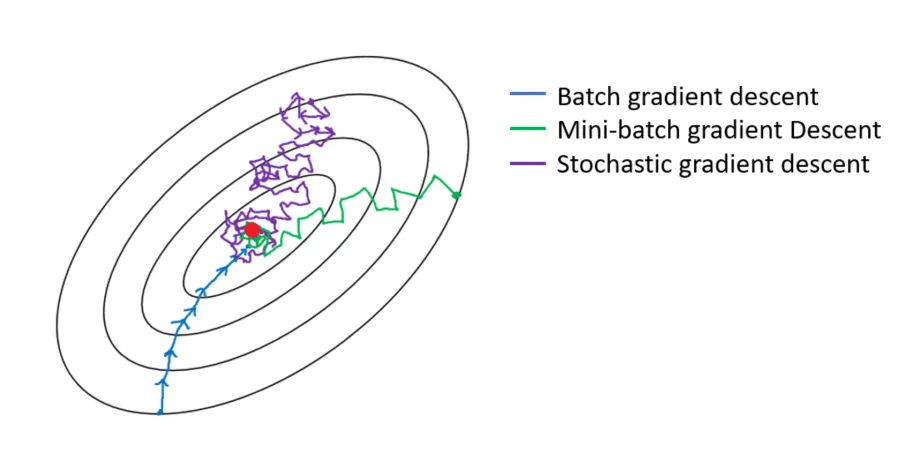
Gradient Descendente (GD)
\displaystyle w_{t+1} = w_t - \eta \nabla L(w_t)
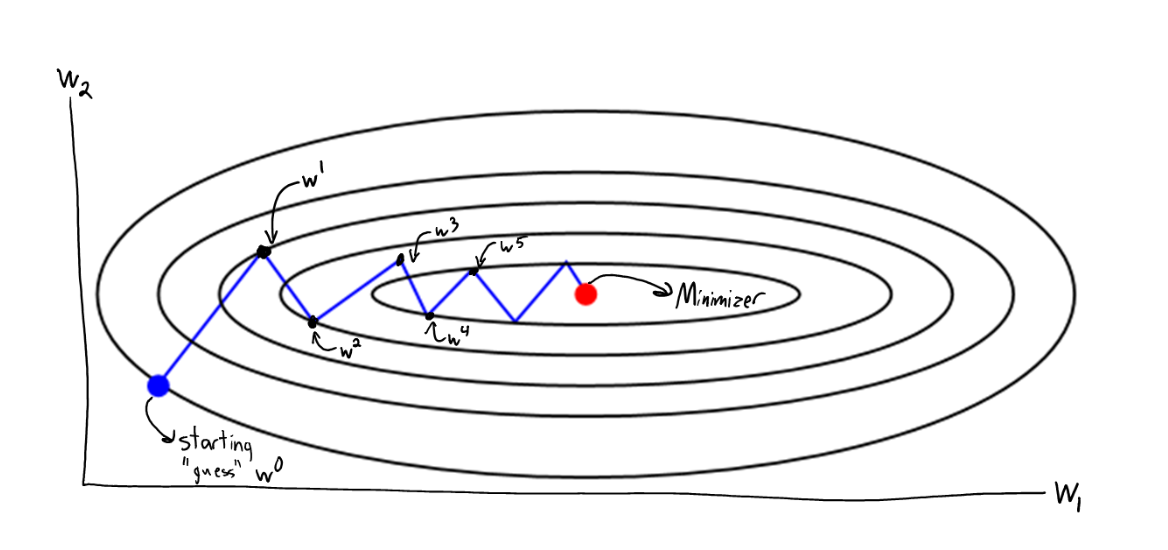
\(O(nd)\) de tempo para computar!
Gradient Descendente Estocástico
Ideia: Ao invés de usar o gradiente de todos os \(n\) pontos, usar gradiente de poucos exemplos aleatórios
Redes Neurais
Além de Regressão Linear e Logística
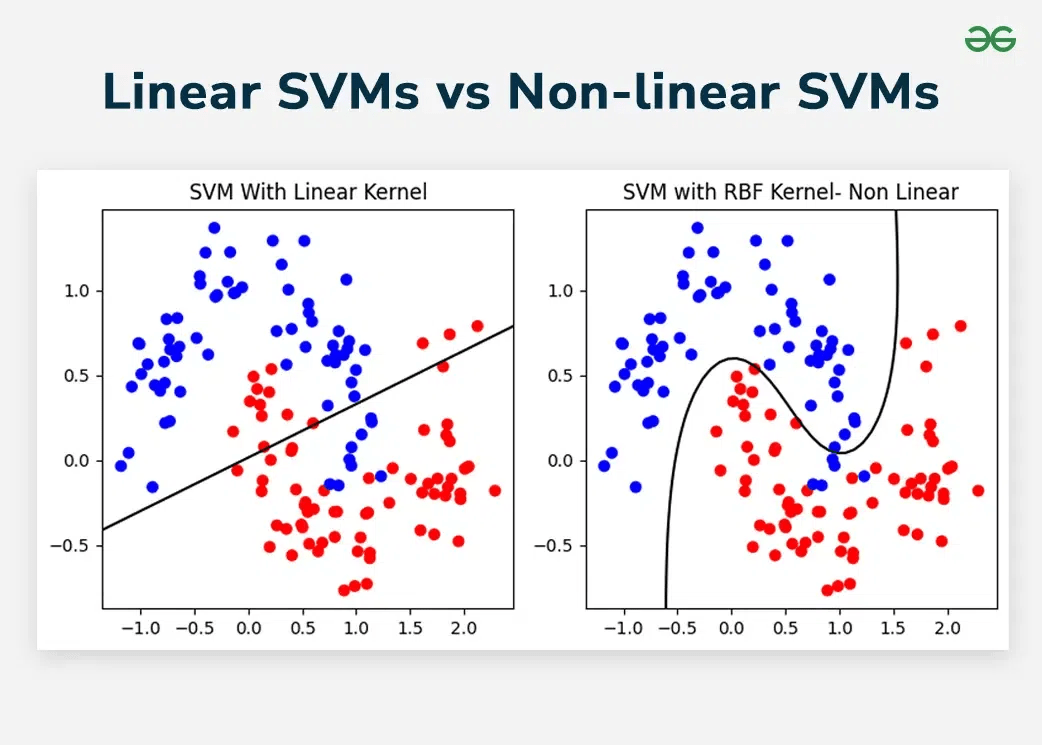
Regrrssão linear/logística funcionam quando os dados são faceis de se prever/separar
Casos mais complexos exigem feature engineering e modelos mais expressivos
Perceptron
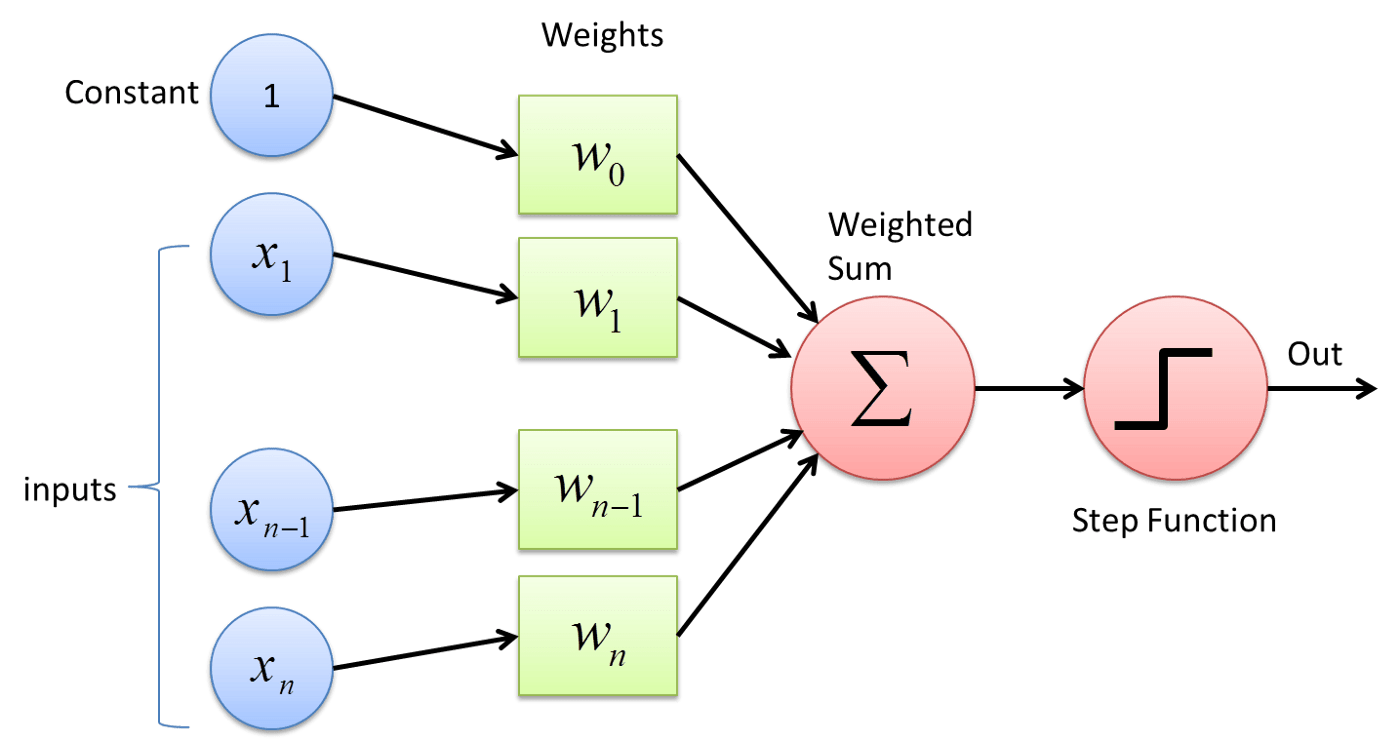
\displaystyle y = \sigma\Bigg(\sum_{i = 1}^d w_i x_i \Bigg)
w^{\mathsf{T}} x
Redes Neurais
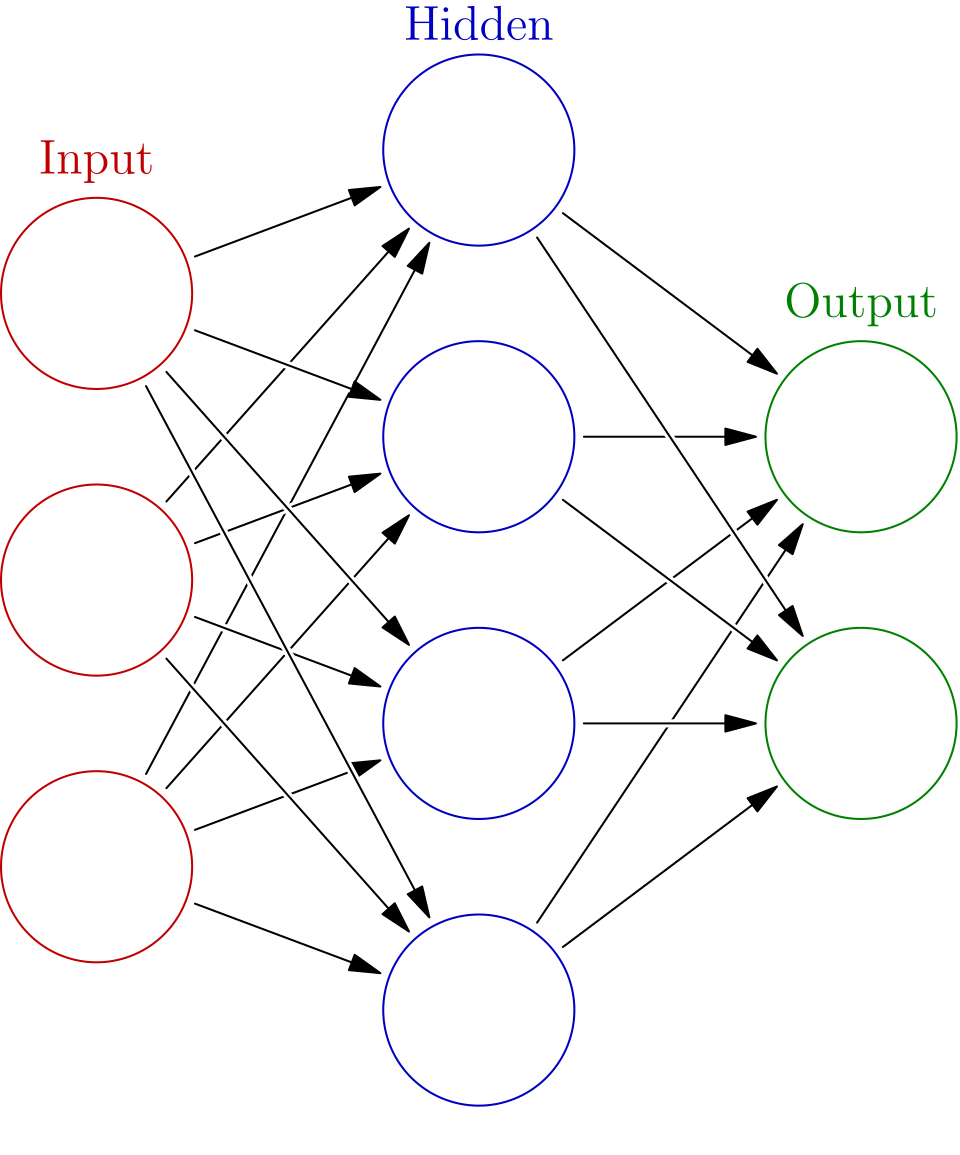
\displaystyle h = \sigma\Big( W^{(1)} x \Big)
\displaystyle y = \sigma\Big( x^{\mathsf{T}} w^{(2)} \Big)
Redes Neurais Profundas
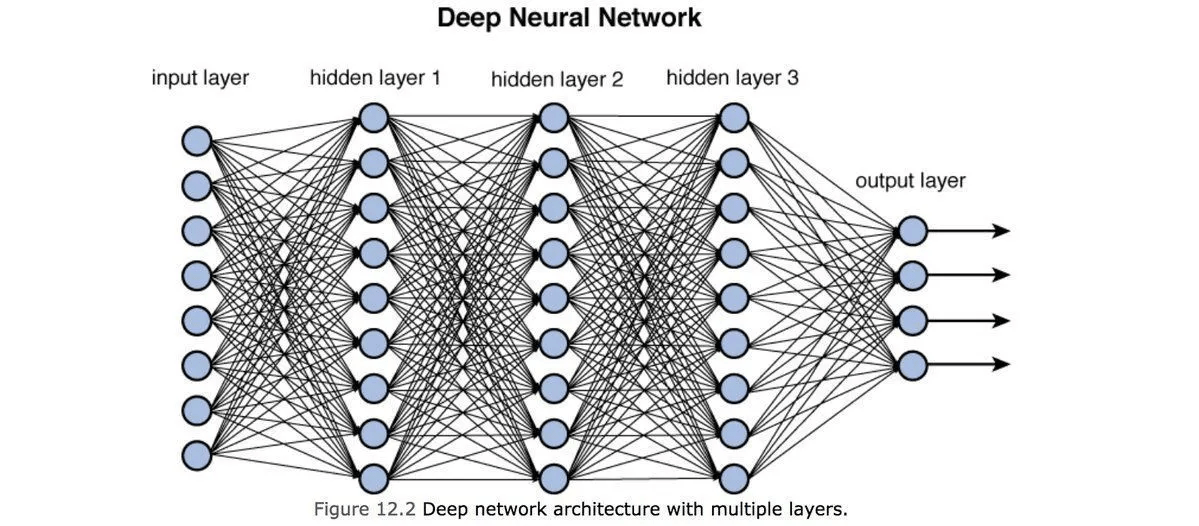
Derivadas e Backpropagation
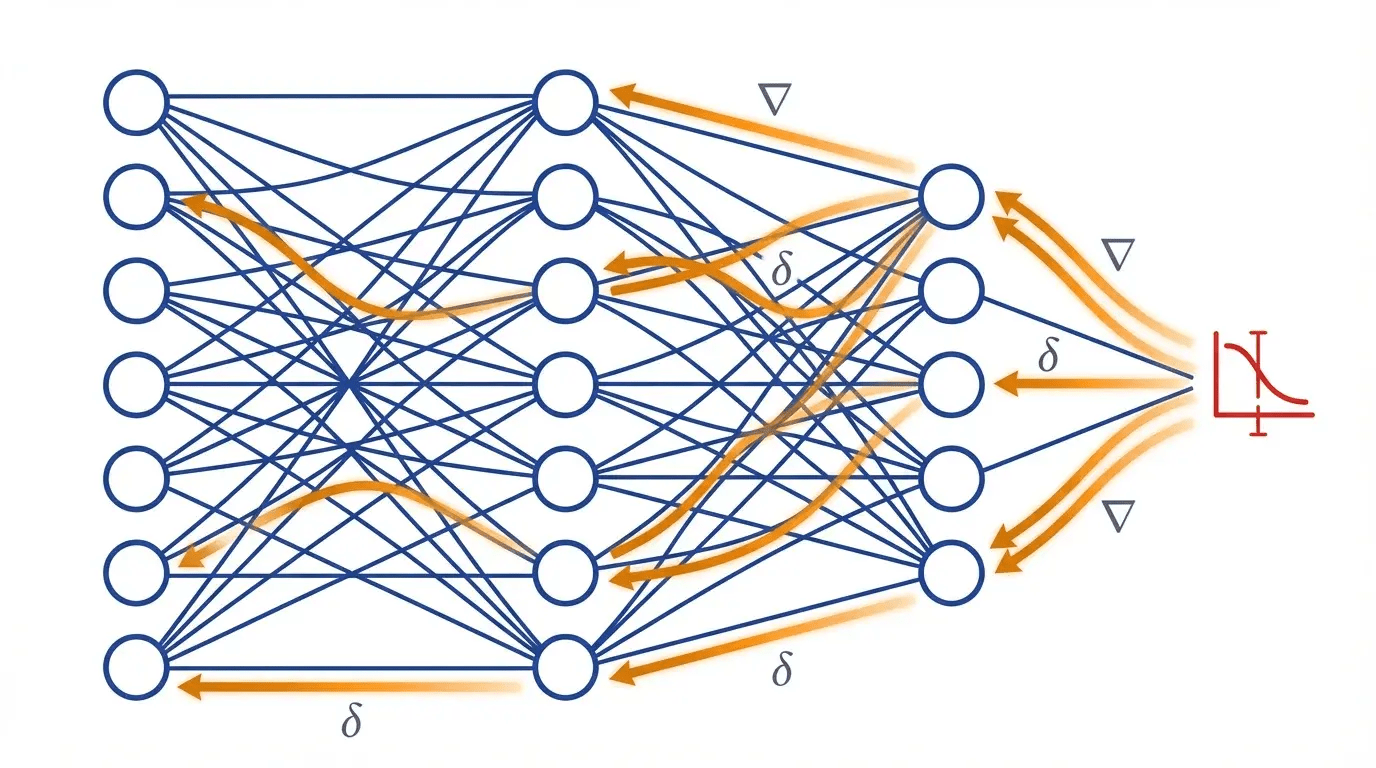
Backpropagation =
regra da cadeia +
reutilização eficiente de derivadas intermediárias
O que redes neurais tem de especial?
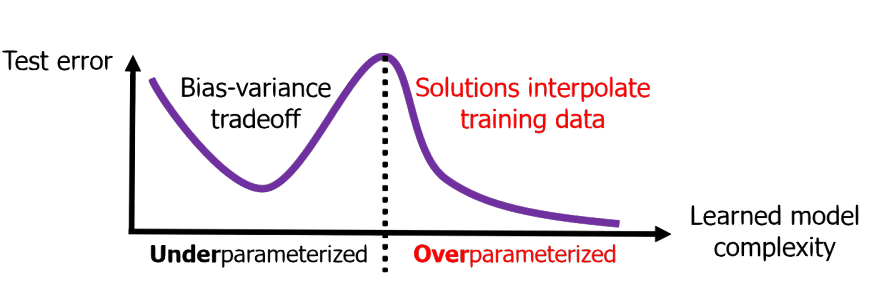
Em ML ouvirmos falar muito sobre overfitting
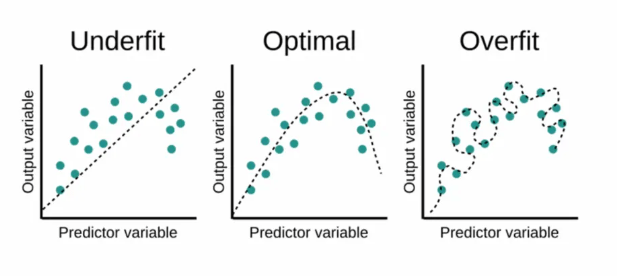
Preve muito bem dados de treino, mas não dados novos
Em teoria, muito parâmetros aumentam a chance de overfitting
Mas redes neurais quebram esse padrão: muitos parâmetros e ainda generalizam bem
Escolhendo o tamanho de passo em (S)GD
\displaystyle w_{t+1} = w_t - \eta \nabla L(w_t)
Como escolhemos o tamanho de passo \(\eta\)?
Teoria nos diz que, sob certas condições, existe um tamanho de passo fixo ótimo
Escolher um e dividir por 2 se muito grande funciona melhor ainda
Na prática, "agendas de passos" e buscas exaustivas são bastante usadas também
Mais do que um tamanho de passo
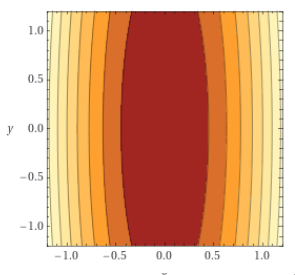
\displaystyle L(x) = x^T A x
\displaystyle A =
\begin{pmatrix}
1000 & 0 \\
0 & 0.001
\end{pmatrix}
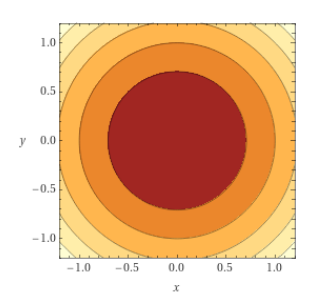
\displaystyle x_{t+1} = x_t -
\begin{pmatrix}
0.001 & 0 \\
0 & 1000
\end{pmatrix}
\nabla f(x_t)
Converge em 1 passo
\(P\)
Conseguimos calcular \(P\) automaticamente?
"Se adaptar à \(L\)"
Precondicionador \(P\)
Métodos Adaptativos
Passos "Adaptivos" para cada parâmetro
Hypergradient
Adam, RMSProp, RProp
Aprox. 2nd Order Methods
Mas o que significa ser adaptativo?
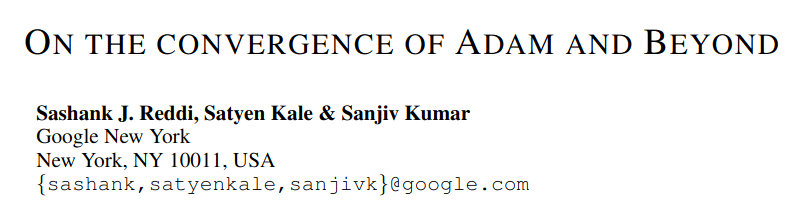
"(...) Nowadays, [adaptive] seems to denote any kind of coordinate-wise learning rates that does not guarantee anything in particular."
Francesco Orabona in "A Modern Introduction to Online Learning", Sec. 4.3
Outras perguntas interessantes
Se o Adam falha em funções simples, por que funciona tão bem em algumas redes neurais?
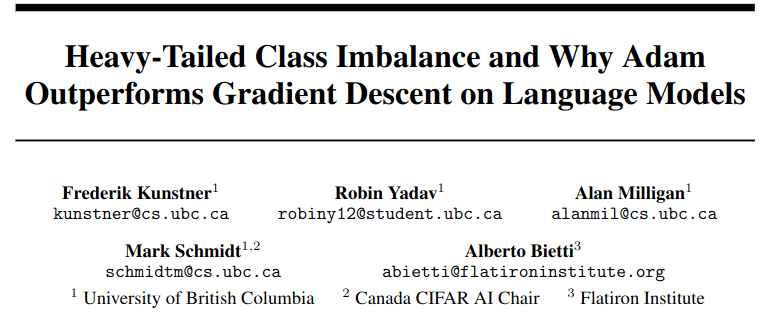
Podem existir (muitos) mínimos em uma rede neural que não generalizam. SGD parece sempre convergir para bons mínimos
Redes neurais vivem na "beira da estabilidade" durante treinamento: curvatura se mantem o inverso do tamanho de passo!
Modelos Gigantes
Outras arquiteturas
Usar todas as conexões entre as camadas cria muitos parâmetros
Ideia: usar padrões de conexão diferente para tarefas distintas
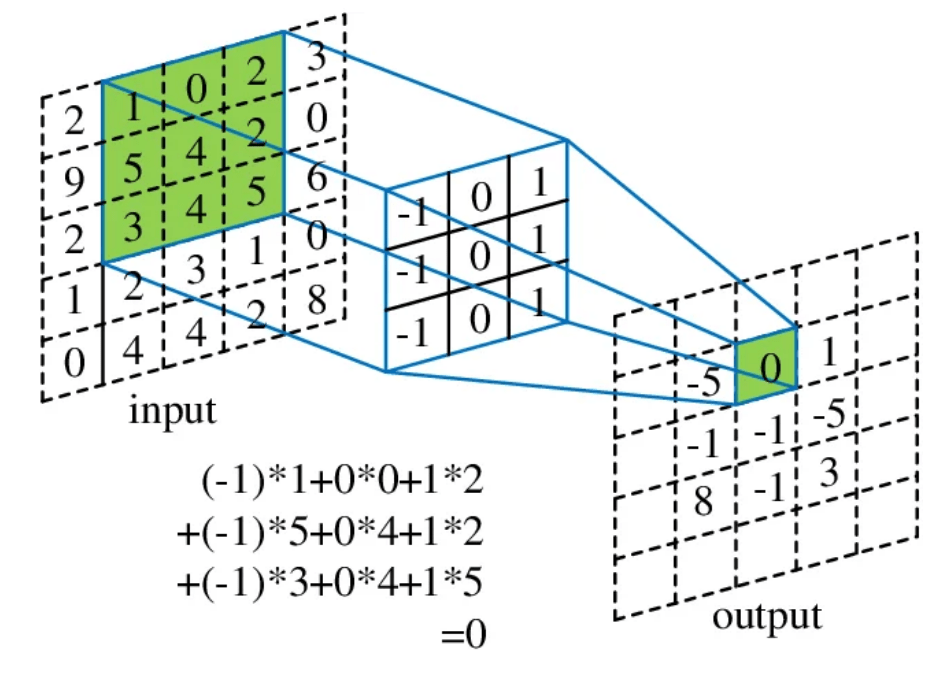
Exemplos de arquiteturas
CNNs - Imagens
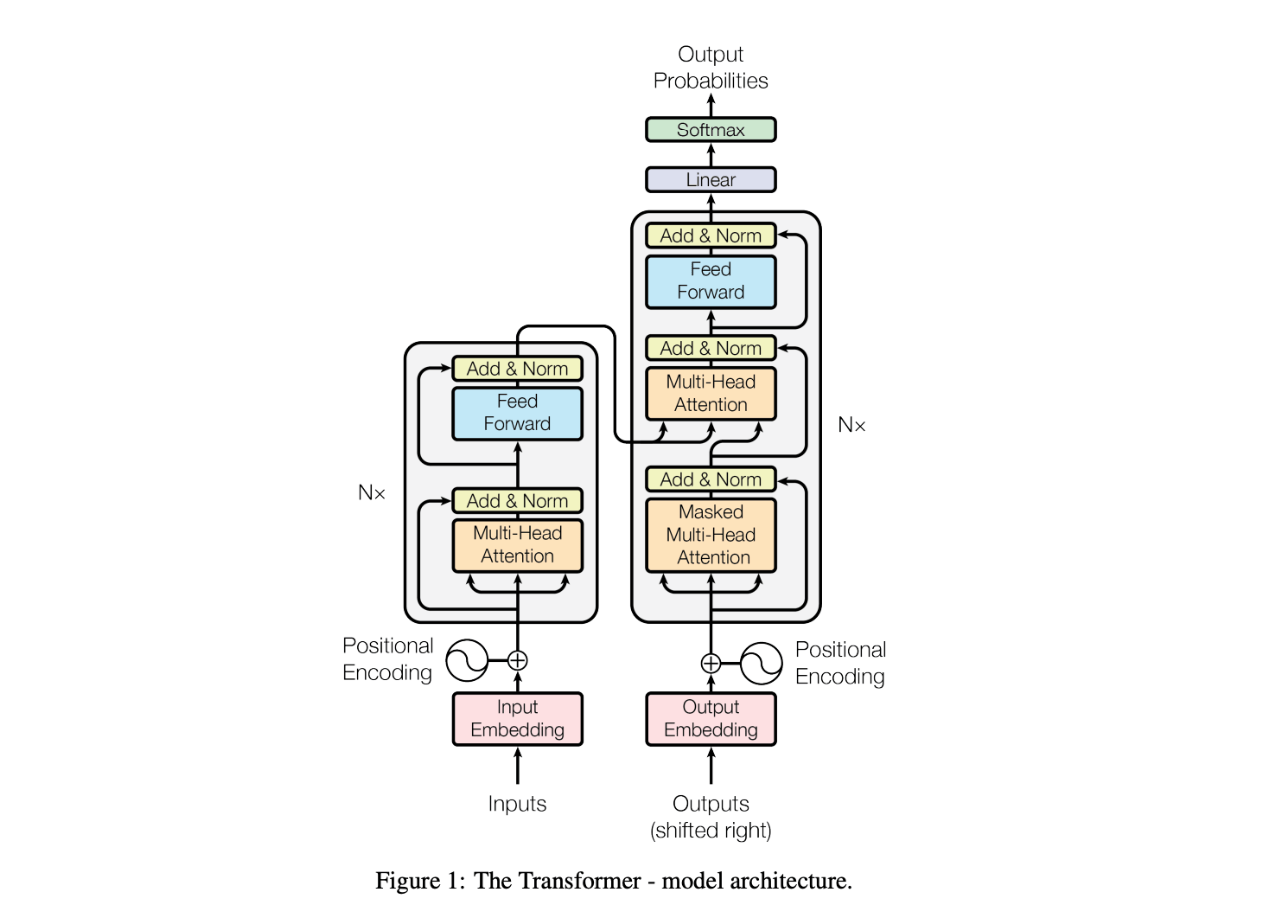
Transformers - Texto
A começo da era de deep learning - AlexNet
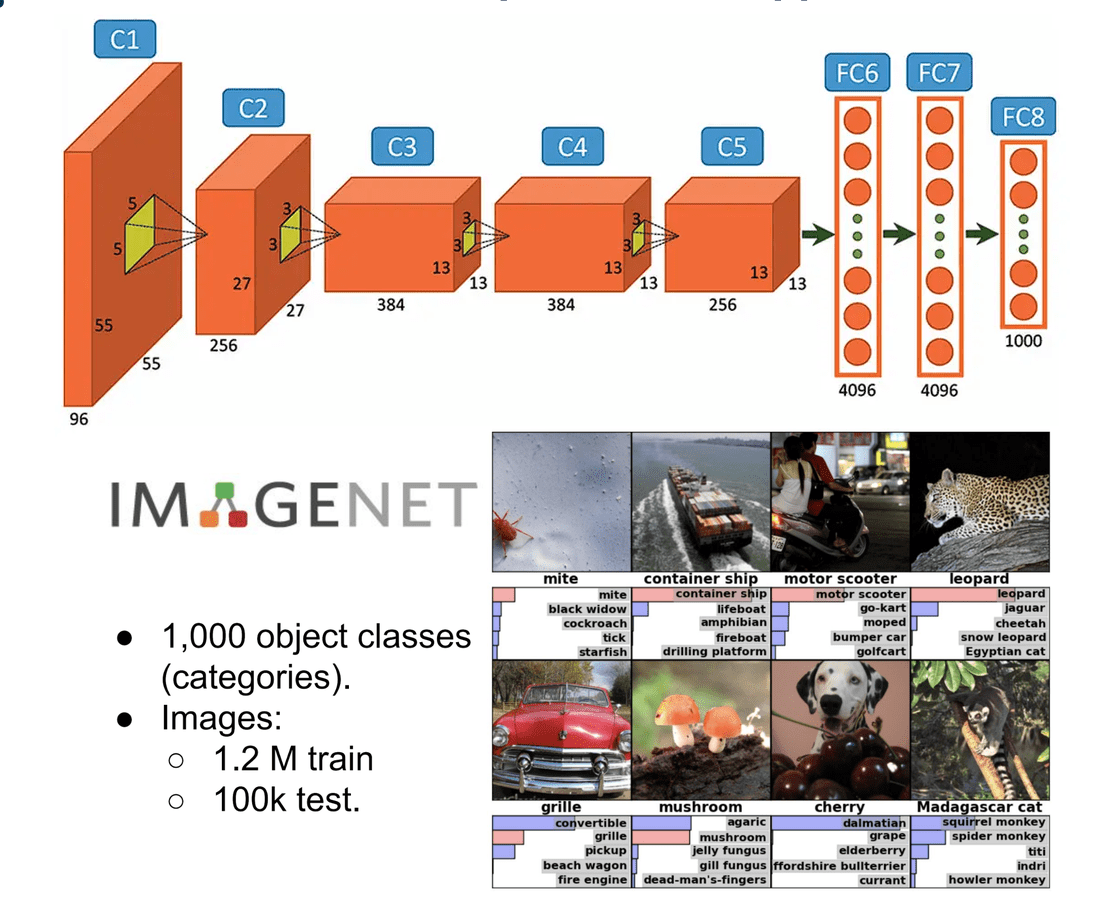
Desempenho revolucionário na competição ImageNet em 2012
AlexNet: 15,3% erro top-5
Segundo lugar: 26,2% erro top 5
Demonstração marcante do potencial de deep learning quando temos muitos dados e poder computacional
Linguagem como um problema de previsão
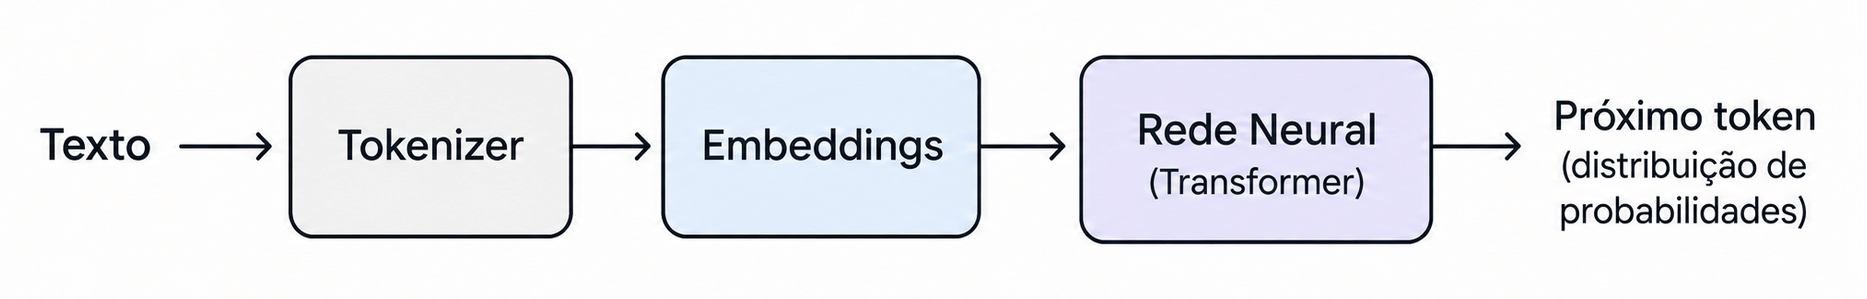
Na faze de treinamento, a rede tenta prever a próxima palavra dos textos:
A resposta da vida, universo, e tudo mais é
42
x_i
y_i
Processo muito paralelizável!
Otimização em escala ainda é bem difícil
Na prática, essas fases de pré-treino são muitas vezes acompanhadas de perto por pessoas
Treino divergiu? Volta pro último check-point e muda alguns hiperparâmetros
Como inicializar a rede? Os ingredientes secretos mudam a de tempos em tempos
Muito da eficiência ditada por melhor engenharia de sistemas paralelos e distribuidos, manejo de cache, etc.
Falta entender melhor treinamento de dragões
De um tutorial da ICML desse ano:

Minha opinião:
Muito de otimização de ML que ainda não entendemos!
Obrigado!
UFABC - Como treinar seu dragao
By Victor Sanches Portella